

Në prag të lançimit të një lënde të re për kursin kemi përgatitur një përkthim të një materiali interesant.
Përmbledhje
Do të flasim për një model mjaft të njohur, nëpërmjet të cilit aplikacionet përdorin disa depo të dhënash, ku çdo depo përdoret për qëllime të veta, si për ruajtjen e formës kanonike të të dhënave (MySQL etj.), për të siguruar funksionalitete të avancuara të kërkimit (ElasticSearch etj.), për cache (Memcached etj.) dhe të tjera. Zakonisht, kur përdoren disa depo të dhënash, njëra prej tyre funksionon si depo kryesore, ndërsa të tjerat si depo përkatëse. Problemi i vetëm është se si të sinkronizohen këto depo të dhënash.
Ne shqyrtuam një sërë modelesh të ndryshme që përpiqeshin të zgjidhnin problemin e sinkronizimit të disa depove, siç janë regjistrimi i dyfishtë, transaksionet e shpërndara etj. Megjithatë, këto qasje kanë kufizime të dukshme në lidhje me përdorimin në jetën reale, besueshmërinë dhe miratimin teknik. Përveç sinkronizimit të të dhënave, disa aplikacione gjithashtu kërkojnë të pasurojnë të dhënat duke thirrur shërbime të jashtme.
Për të zgjidhur këto probleme, u krijua Delta. Delta përfundimisht paraqet një platformë të konsoliduar, të menaxhuar nga ngjarjet për sinkronizimin dhe pasurimin e të dhënave.
Zgjidhjet ekzistuese
Regjistrimi i dyfishtë
Për të sinkronizuar dy depo të dhënash, mund të përdoret regjistrimi i dyfishtë, i cili kryen një regjistrim në një depo dhe menjëherë pas saj regjistron në depo tjetër. Regjistrimi i parë mund të përsëritet, ndërsa i dyti mund të ndërpritet, nëse i pari dështoi pas shterimit të numrit të përpjekjeve. Megjithatë, dy depo të dhënash mund të ndalojnë së sinkronizuari nëse regjistrimi në depo të dytë dështon. Kjo çështje zakonisht zgjidhet duke krijuar një procedurë rikuperimi, e cila mund të ripërsërisë periodikisht të dhënat nga depo e parë në të dytën ose ta bëjë këtë vetëm nëse zbulohet ndonjë ndryshim në të dhëna.
Problemet:
Kryerja e procedurës së rikuperimit është një punë specifike që nuk mund të ripërdoret. Për më tepër, të dhënat ndërmjet depozitave mbeten të pasinkronizuara deri sa procedura e rikuperimit të përfundojë. Zgjidhja bëhet më e komplikuar nëse përdoren më shumë se dy depozita të dhënash. Dhe, përfundimisht, procedura e rikuperimit mund të shtojë ngarkesën në burimin origjinal të të dhënave.
Tabela e logëve të ndryshimeve
Kur ndodhin ndryshime në grupin e tabelave (p.sh., futja, azhurnimi dhe fshirja e një regjistrimi), regjistrimet e ndryshimeve shtohen në tabelën e logëve si pjesë e të njëjtës transaksion. Një rrjedhë tjetër ose proces vazhdimisht kërkon ngjarjet nga tabela e logëve dhe i regjistron ato në një ose më shumë depozita të dhënash, duke i hequr ngjarjet nga tabela e logëve pas konfirmimit të regjistrimit nga të gjitha depozitat.
Problemet:
Ky model duhet të realizohet si një bibliotekë dhe idealisht pa ndryshuar kodin e aplikacionit që e përdor atë. Në një mjedis poliglot, realizimi i kësaj biblioteke duhet të ekzistojë në çdo gjuhë të nevojshme, por sigurimi i koherencës së funksioneve dhe sjelljes ndërmjet gjuhëve është shumë i vështirë.
Një problem tjetër qëndron në marrjen e ndryshimeve të skemës, në ato sisteme që nuk mbështesin ndryshimet tranzaksionale të skemës [1][2], siç është MySQL. Prandaj, modeli për kryerjen e ndryshimit (p.sh., ndryshimi i skemës) dhe regjistrimin e tij tranzaksional në tabelën e logëve të ndryshimeve nuk do të funksionojë gjithmonë.
Transaksionet e Shpërndara
Transaksionet e shpërndara mund të përdoren për të ndarë një transaksion midis disa depozitave të dhënash heterogjene në një mënyrë që operacioni ose regjistrohet në të gjitha depozitë të përdorura, ose nuk regjistrohet në asnjërën prej tyre.
Problemet:
Transaksionet e shpërndara janë një problem shumë i madh për depozitat e ndryshme të dhënash. Në thelb, ato mund të varen vetëm nga më i vogli përbashkët i sistemit që merr pjesë. Për shembull, transaksionet XA bllokojnë ekzekutimin nëse ndodh një dështim gjatë procesit të aplikimit në fazën e përgatitjes. Për më tepër, XA nuk ofron zbulimin e bllokimeve dhe nuk mbështet skema optimistike të menaxhimit të paralelizmit. Përveç kësaj, disa sisteme si ElasticSearch nuk mbështesin XA ose ndonjë model tjetër heterogjen të transaksioneve. Prandaj, sigurimi i atomizmit të shkrimit në teknologjitë e ndryshme të depozitimit mbetet një detyrë shumë e komplikuar për aplikacionet [3].
Delta
Delta u zhvillua për të eliminuar kufizimet e zgjidhjeve ekzistuese për sinkronizimin e të dhënave dhe gjithashtu lejon pasurimin e të dhënave në kohë reale. Qëllimi ynë ishte të abstragojmë të gjitha këto aspekte të komplikuara nga zhvilluesit e aplikacioneve, në mënyrë që ata të mund të përqendrohen plotësisht në realizimin e funksionalitetit të biznesit. Më tej, ne do të përshkruajmë "Movie Search", një rast konkret përdorimi të Delta nga Netflix.
Netflix përdor gjerë arkitekturën mikro-shërbimore dhe çdo mikro-shërbim zakonisht shërben për një lloj të dhënash. Informacioni bazë mbi filmat është i organizuar në një mikro-shërbim të quajtur Movie Service, ndërsa të dhënat e lidhura, si informacioni për producentët, aktorët, ofruesit dhe të tjera, menaxhohen nga disa mikro-shërbime të tjera (ndër to Deal Service, Talent Service dhe Vendor Service).
Përdoruesit e biznesit në Netflix Studios shpesh kanë nevojë të kërkojnë filma sipas kritereve të ndryshme, prandaj është shumë e rëndësishme për ta të kenë mundësinë e kërkimit të të gjitha të dhënave që kanë të bëjnë me filmat.
Para se të krijohej Delta, ekipi i kërkimit të filmave duhet të merrte të dhënat nga disa mikro-shërbime përpara se të indeksonte të dhënat e filmave. Përveç kësaj, ekipi duhej të zhvillonte një sistem që përditësonte periodikisht indeksin e kërkimit, duke kërkuar ndryshime nga mikro-shërbime të tjera, për evenimentet që nuk shkonin me ndryshime fare. Ky sistem shpejt bëhej i komplikuar dhe difficile për t’u mbajtur.
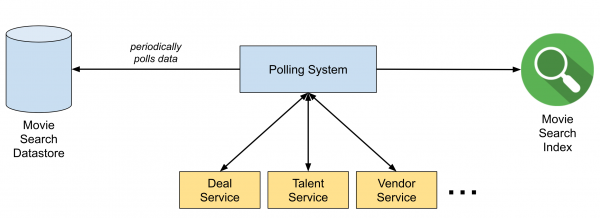
Figura 1. Sistemi i polling para Delta
Pas fillimit të përdorimit të Delta, sistemi u thjeshtua në një sistem të menaxhuar nga ngjarjet, siç ilustrohet në figurën e ardhshme. Ngjarjet CDC (Change-Data-Capture) dërgohen në temat e Keystone Kafka përmes Delta-Connector. Aplikacioni Delta, i ndërtuar me përdorimin e Delta Stream Processing Framework (i bazuar në Flink), merr ngjarjet CDC nga tema, i pasuroc ato duke thirrur mikro-shërbime të tjera, dhe përfundimisht i kalon të dhënat e pasura në indeksin e kërkimit në Elasticsearch. I gjithë procesi ndodh pothuajse në kohë reale, do të thotë, pjesa më e vogël i ndryshimeve regjistrohen në magazinë të dhënash, indekset kërkuese përditësohen.
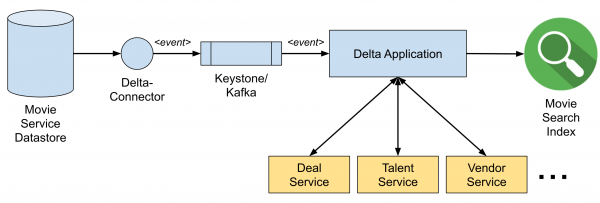
Figura 2. Pipeline e të dhënave duke përdorur Delta
Në seksionet e ardhshme ne do të përshkruajmë funksionimin e Delta-Connector, i cili lidhet me magazinën dhe publikon ngjarjet CDC në nivelin e transportit, i cili përfaqëson infrastrukturën e transferimit të të dhënave në kohë reale, duke drejtuar ngjarjet CDC në temat Kafka. Dhe në fund do të flasim për strukturën e përpunimit të rrjedhave Delta, që zhvilluesit e aplikacioneve mund ta përdorin për logjikën e përpunimit dhe pasurimit të të dhënave.
CDC (Change-Data-Capture)
Ne zhvilluam një shërbim CDC të quajtur Delta-Connector, i cili mund të regjistrojë ndryshimet e komituara nga magazina e dhënave në kohë reale dhe t'i shkruajë ato në rrjedhë. Ndryshimet në kohë reale merret nga regjistri i transaksioneve dhe dumpet e magazinës. Dumpet përdoren sepse regjistrat e transaksioneve zakonisht nuk ruajnë të gjithë historinë e ndryshimeve. Ndryshimet zakonisht serializohen si ngjarje Delta, në mënyrë që marrësi të mos shqetësohet për burimin e ndryshimit.
Delta-Connector mbështet disa funksione të tjera shtesë, si:
- Mundësia për të shkruar në dalje të personalizuara jashtë Kafka.
- Mundësia për të aktivizuar dumpet manuale në çdo kohë për të gjitha tabelat, ndonjë tabelë të caktuar ose për çelësa të caktuar primarë.
- Dumpet mund të merren në blloqe, kështu që nuk është e nevojshme të filloni të gjithçka nga fillimi në rast dështimi.
- Nuk ka nevojë për të vendosur bllokime në tabela, që është shumë e rëndësishme për të siguruar që trafiku i të dhënave në bazën e të dhënave të mos bllokohet kurrë nga shërbimi ynë.
- Disponueshmëri e lartë për shkak të kopjeve rezervë në AWS Availability Zones.
Tani tani mbështesim MySQL dhe Postgres, përfshirë në shpërndarjen në AWS RDS dhe Aurora. Po ashtu mbështesim Cassandra (multi-master). Më shumë detaje rreth Delta-Connector mund të mësoni në këtë .
Kafka dhe niveli i transportit
Niveli i transportit të ngjarjeve Delta është ndërtuar mbi shërbimin e këmbimit të mesazheve të platformës .
Historikisht, publikimi i mesazheve në Netflix është optimizuar për të rritur disponueshmërinë, e jo qëndrueshmërinë (shih ). Kompromisi ka qenë një potencial moskoherencë e të dhënave të brokerit në skenarë të ndryshëm kufitarë. Për shembull, zgjedhje e papastër e liderit është përgjegjëse që marrësi potencialisht të duplikohet ose të humbasë ngjarjet.
Me Delta, ne dëshironim të kishim garanci më të forta për qëndrueshmërinë, për të siguruar dorëzimin e ngjarjeve CDC në depozitat përkatëse. Për këtë, ne ofruam një klasë të parë të klasterit Kafka të projektuar posaçërisht. Mund të shihni disa cilësime të brokerit në tabelën më poshtë:
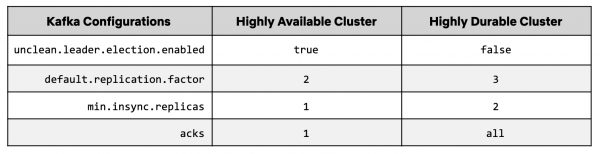
Në klasterët e Keystone Kafka, zgjedhje e papastër e liderit zgjidhja zakonisht është e aktivizuar për të siguruar disponueshmërinë e botuesit. Kjo mund të çojë në humbjen e mesazheve në rast se një riprodhim i pa sinkronizuar zgjidhet si lider. Për një klaster të ri me besueshmëri të lartë Kafka, parametrin zgjedhje e papastër e liderit e kemi çaktivizuar për të parandaluar humbjen e mesazheve.
Po ashtu e kemi rritur faktorin e riprodhimit nga 2 në 3 dhe replicat minimale në sinkronizim nga 1 në 2. Botuesit që shkruajnë në këtë klaster kërkojnë acks nga të gjitha të tjerët, duke siguruar që 2 nga 3 riprodhimet do të kenë mesazhet më të fundit të dërguara nga botuesi.
Kur mes një instancë brokeri ndalon së funksionuari, një instancë e re e zëvendëson atë të vjetrën. Sidoqoftë, brokeri i ri do t'ia dalë që të arrijë replikat e pa sinkronizuara, gjë që mund të marrë disa orë. Për të shkurtuar kohën e rikuperimit të këtij skenari, filluam të përdorim ruajtjen e bllokut të të dhënave (Amazon Elastic Block Store) në vend të disqeve lokale të brokerëve. Kur instancë e re zëvendëson një instancë brokeri që ka përfunduar, ajo bashkoi volumin EBS që kishte instanca e mbyllur dhe fillon të arrijë mesazhet e reja. Ky proces e redukton kohën e eliminimit të prapambetjes nga disa orë në disa minuta, pasi instancës së re nuk i nevojitet më të replikojë nga një gjendje e zbrazët. Në përgjithësi, ciklet e jetës së ruajtjes dhe brokerit ndahen ndjeshëm ndikimin e efektit nga ndryshimi i brokerit.
Për të rritur akoma më shumë garancinë e shpërndarjes së të dhënave, ne përdorëm për të zbuluar ndonjë humbje mesazhesh në kushte ekstreme (p.sh., desinkronizimi i orëve në liderin e seksionit).
Stream Processing Framework
Niveli i përpunimit në Delta është ndërtuar mbi bazën e platformës Netflix SPaaS, e cila ofron integrimin e Apache Flink me ekosistemin e Netflix. Platforma ofron një ndërfaqe përdoruesi që menaxhon shpërndarjen e detyrave Flink dhe orkestrimin e klasterëve Flink mbi platformën tonë të menaxhimit të kontejnerëve Titus. Nderfaqja gjithashtu menaxhon konfigurimet e detyrave dhe lejon përdoruesit të bëjnë ndryshime në konfigurim në mënyrë dinamike pa pasur nevojë të riparaportojnë detyrat Flink.
Delta ofron një kornizë përpunimi të rrjedhës (stream processing framework) të të dhënave të bazuar në Flink dhe SPaaS, e cila përdor një DSL të bazuar në annotime për të abstaraktuar detajet teknike. Për shembull, për të përcaktuar hapin me të cilin do të pasurohen ngjarjet, duke thirrur shërbime të jashtme, përdoruesit duhet të shkruajnë DSL-në e mëposhtme, dhe korniza do të krijojë një model që do të ekzekutohet nga Flink.
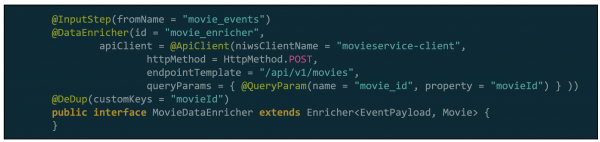
Figura 3. Shembujt e pasurimit në DSL në Delta
Korniza për përpunimin jo vetëm që e shkurtëzon kurbën e të mësuarit, por gjithashtu ofron funksione të zakonshme për përpunimin e rrjedhës, si deduplikimi, skematizimi, si dhe fleksibilitet dhe qëndrueshmëri për t'i zgjidhur problemet e zakonshme në operim.
Delta Stream Processing Framework përbëhet nga dy module kryesore, moduli DSL & API dhe moduli Runtime. Moduli DSL & API ofron DSL dhe UDF (User-Defined-Function) API që përdoruesit të mund të shkruajnë logjikën e tyre të përpunimit (p.sh., filtrimi ose transformimet). Moduli Runtime ofron zbatimin e parserit DSL, i cili ndan përfaqësimin e brendshëm të hapave të përpunimit në modelet DAG. Komponenti i Ekzekutimit interpreton modelet DAG për të inicializuar operatorët faktikë Flink dhe për të filluar aplikacionin Flink në fund. Arkitektura e framework-ut ilustrohet në figurën e mëposhtme.
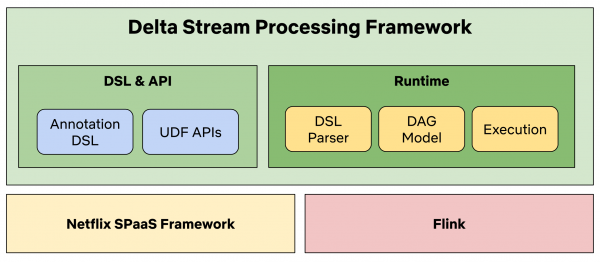
Figura 4. Arkitektura e Delta Stream Processing Framework
Ky qasje ka disa përfitime:
- Përdoruesit mund të përqendrohen në logjikën e tyre të biznesit pa pasur nevojë të thellohen në specifikat e Flink ose strukturën SPaaS.
- Optimizimi mund të bëhet në një mënyrë transparente për përdoruesit, dhe gabimet mund të rregullohen pa pasur nevojë për të bërë ndonjë ndryshim në kodin e përdoruesit (UDF).
- Puna e aplikacioneve Delta është lehtësuar për përdoruesit, pasi platforma ofron fleksibilitet dhe qëndrueshmëri nga hyrja dhe mbledh një sasi të madhe metrikash të hollësishme, të cilat mund të përdoren për alarme.
Përdorimi në prodhim
Delta funksionon në prodhim për më shumë se një vit dhe luan një rol kyç në shumë aplikacione të Netflix Studio. Ajo ndihmoi skuadrat të realizojnë raste përdorimi si indeksoja e kërkimit, ruajtja e të dhënave dhe flukset e punës që menaxhohen nga ngjarjet. Më poshtë është një përmbledhje e arkitekturës së lartë të platformës Delta.
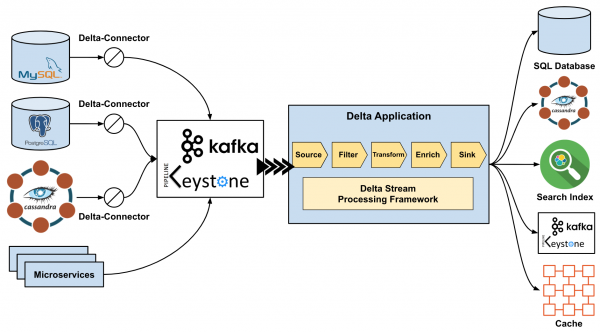
Figura 5. Arkitektura e lartë e Delta.
Faleminderit
Dëshirojmë të falënderojmë personat e mëposhtëm që morën pjesë në krijimin dhe zhvillimin e Delta në Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang dhe Zhenzhong Xu.
Burimet
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Përpunimi i ngjarjeve online. Commun. ACM 62(5): 43–49 (2019). DOI:
: "Data Build Tool për magazinën Amazon Redshift."
Burimi: habr.com
