

Përshëndetje të gjithëve! Unë quhem Oleg Sidorenko, punoj në kompaninë DomKlik si drejtues i ekipit të infrastrukturës. Ne kemi operuar "Kubik" në prodhimin për më shumë se tre vjet, dhe gjatë kësaj kohe kemi kaluar shumë momente të ndryshme interesante me të. Sot do t'ju tregoj se si me një qasje të duhur mund të nxjerrim më shumë performancë nga Kubernetes 'vanilje' për klasterin tuaj. Gati, gati, filluam!
Të gjithë e dini mirë se Kubernetes është një sistem i shkallëzueshëm me kod të hapur për orkestrimin e kontejnerëve; ose, ndryshe, 5 binarë që bëjnë magji duke menaxhuar ciklin e jetës së mikroservicëve tuaj në ambientin e serverit. Për më tepër, është një mjet mjaft fleksibël që mund të ndërtohet si një ndërtues Lego, për maksimumin e personalizimit për detyra të ndryshme.
Dhe gjithçka duket mirë: lëshoni serverët në klaster si dru në oxhak, dhe asnjë shqetësim. Por nëse jeni për ekologjinë, do të mendoni: "Si mund të mbaj zjarrin në sobë dhe të kursej pyllin?". Në fjalë të tjera, si të gjeni mënyra për të përmirësuar infrastrukturën dhe për të ulur shpenzimet.
1. Ndiqni burimet e ekipeve dhe aplikacioneve
Një nga metodat më të zakonshme, por efektive, është vendosja e requests/limits. Ndani aplikacionet sipas namespace-ve, dhe namespace-t sipas ekipeve të zhvillimit. Caktoni aplikacionit para se të bëni deploy vlerat për konsumin e kohës së procesorit, memories dhe ruajtjes efemere.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Me përvojë kemi arritur në përfundimin: nuk ka sens të shtriheni kërkesat nga kufijtë për më shumë se dy herë. Vëllimi i klasterit llogaritet në bazë të kërkesave, dhe nëse do të caktoni ndryshim burimesh tek aplikacionet, për shembull, 5-10 herë, imagjinoni çfarë do të ndodhë me nodën tuaj kur ajo mbushet me pod dhe papritur merr ngarkesë. Asgjë e mirë. Si minimum, throttling, dhe si maksimum, do t’i thoni lamtumirë punonjësit dhe do të merrni një ngarkesë ciklike në nodat e tjera pasi pod-et të fillojnë të migrojnë.
Për më tepër, me anë të limitranges mund të caktoni fillimisht për kontejnerin vlera për burimet — minimale, maksimale dhe me të dhëna:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Mos harrosh të kufizoni burimet e hapësirës emërtimi, në mënyrë që një ekip të mos marrë të gjitha burimet e klasterit:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Siç shihet nga përshkrimi resourcequotas, nëse ekipi ops dëshiron të vendosë pod-e që do konsumonin edhe 10 cpu, planifikuesi nuk do të lejojë këtë të ndodhë dhe do të japë një gabim:
Gabim krijimi: pod-et "nginx-proxy-9967d8d78-nh4fs" janë të ndaluara: tejkalon kuotën: resource-quota, e kërkuar: limits.cpu=5,requests.cpu=5, e përdorur: limits.cpu=77250m,requests.cpu=53850m, e kufizuar: limits.cpu=10,requests.cpu=10Për të zgjidhur një problem të tillë, mund të shkruani një mjet, për shembull, si , i cili di të ruajë dhe komitojë gjendjen e burimeve të ekipeve.
2. Zgjidhni ruajtjen e optimizuar të skedarëve
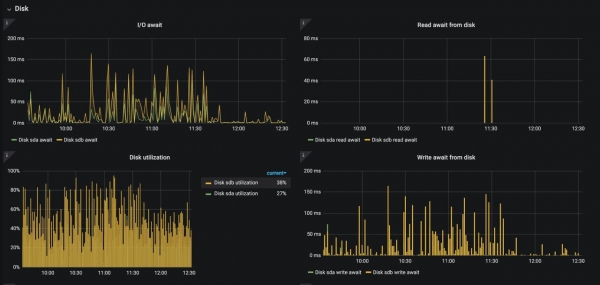
Këtu do të doja të prekja temën e volumeve të përhershëm dhe nëndiskutimin e sistemit të diskut të nodave worker të Kubernetes. Shpresoj që askush të mos përdorë "Kub" në HDD në prodhim, por herë pas here, edhe një SSD i zakonshëm bëhet i pamjaftueshëm. Kemi hasur në një problem të tillë, që log-ët e shkatërronin diskun në operacionet e hyrjes-daljes, dhe këtu nuk ka shumë opsione zgjidhjeje:
Përdorimi i SSD-ve me performancë të lartë ose kalimi në NVMe (nëse ju menaxhoni vetë harduerin tuaj).
Reducimi i nivelit të regjistrimit.
Bërja e "balancimit të mençur" të pod-eve, që dëmtojnë disku (
podAntiAffinity).
Screenshot-i më sipër tregon se çfarë ndodh me diskun gjatë përdorimit të nginx-ingress-controller, kur regjistrimi i access_logs është aktiv (~12 mijë regjistrime/sekun). Një gjendje e tillë, natyrisht, mund të çojë në degradim të të gjitha aplikacioneve në këtë nod.
Sa për PV-të, fatkeqësisht, nuk kam provuar të gjitha Vëllimet përhershme. Përdorni opsionin më të mirë që ju përshtatet. Historikisht, një pjesë e vogël e shërbimeve ka nevojë për vëllime RWX, dhe prej kohësh kemi përdorur ruajtjen NFS për këtë qëllim. E lirë dhe... mjafton. Sigurisht, kemi pasur mjaft probleme me të – pra, e dimë, por kemi mësuar ta optimizojmë, dhe tani nuk kemi më dhimbje koke. Nëse është e mundur, kaloni në ruajtjen objekt S3.
3. Mblidhni imazhe të optimizuara
Më mirë është të përdorë imazhe të optimizuara për kontejnerët, në mënyrë që Kubernetes të mund t'i marrë ato më shpejt dhe t'i ekzekutojë më eficient.
Optimizimi do të thotë që imazhet:
përmbajnë vetëm një aplikacion ose kryejnë vetëm një funksion;
janë të vogla, sepse imazhet e mëdha çohen më dobët në rrjet;
kanë pika për verifikimin e funksionimit dhe gatishmërisë, me të cilat Kubernetes mund të ndërmarrë disa veprime në rast ndërprerjesh;
përdorin sisteme operative miqësore me kontejnerët (si Alpine ose CoreOS), të cilat janë më të qëndrueshme ndaj gabimeve të konfigurimit;
përdorin ndërtimin në shumë etapa, në mënyrë që të mund të publikoni vetëm aplikacionet e kompiluar, jo burimet përkatëse.
Ka shumë vegla dhe shërbime që lejojnë të kontrolloni dhe optimizoni imazhet në kohë reale. Është e rëndësishme t'i mbani gjithmonë të azhurnuara dhe të verifikuara për sigurinë. Në fund merrni:
Uljen e ngarkesës rrjetore në të gjithë klastrin.
Reduktimin e kohës së nisjes së kontejnerit.
Një volum më të vogël të gjithë regjistrit tuaj Docker.
4. Përdorni caches DNS
Nëse flasim për ngarkesa të larta, pa optimizimin e sistemit DNS të klastri, është shumë e vështirë të funksionosh. Disa kohë më parë, zhvilluesit e Kubernetes mbështetën zgjidhjen e tyre kube-dns. Ajo u implementua edhe tek ne, por kjo software nuk u optimizua dhe nuk jepte performancën e kërkuar, edhe pse, siç duket, detyra ishte e thjeshtë. Më pas doli coredns, në të cilin kaluam dhe nuk patëm më ndonjë problem. Më vonë, ai u bë shërbimi DNS për default në K8s. Në një moment, arritëm deri në 40,000 rps në sistemin DNS dhe kjo zgjidhje nuk mjaftonte më. Por, për një rast të lumtur, doli Nodelocaldns, gjithashtu e njohur si node local cache, gjithashtu .
Pse e përdorim këtë? Në bërthamën e Linux ka një defekt, i cili gjatë qasjeve të shumta përmes conntrack NAT me UDP çon në një gjendje garash për të shkruar në tabelat conntrack, dhe një pjesë e trafikut përmes NAT humbasin (çdo qasje përmes Shërbimit është NAT). Nodelocaldns e zgjidh këtë problem duke eliminuar NAT dhe duke e përmirësuar lidhjen në TCP me DNS në rrjedhën kryesore, si dhe duke bërë kešimin lokal të kërkesave DNS për rrjedhat (përfshirë një keš negativ prej 5 sekondash).
5. Shkallëzoni podet horizontalisht dhe verticalisht automatikisht
A mund të thoni me siguri se të gjitha mikroshërbimet tuaja janë gati për rritjen pesë- deri në tri-fish të ngarkesës? Si të alokoni burimet për aplikacionet tuaja? Të mbani disa pode të aktivizuara mbi ngarkesën operative mund të rezultojë e tepërt, ndërsa të mbani në kufijtë e ngushtë - rrezikoni të keni një pushim nga rritja e papritur e trafikut për shërbimin. Një mesatare e artë ndihmon të arrihet me përfshirjen e shërbimeve si dhe .
VPA lejon që automatikisht të rritni requests/limits e konteinerëve tuaj në pod në varësi të përdorimit të vërtetë. Siç mund të jetë e dobishme? Nëse keni pode, të cilat nga ndonjë arsye nuk mund të shkallëzohen horizontalisht (çka nuk është shumë e besueshme), atëherë mund të provoni të besoni në ndryshimin e burimeve të tij nga VPA. Karakteristika e tij është në sistemin e rekomandimeve të bazuara në të dhëna historike dhe aktuale nga metric-server, kështu që, nëse nuk dëshirani të ndryshoni automatikisht requests/limits, atëherë mund të thjesht të ndihmoni të ndiqni burimet e rekomanduara për kontejnerët tuaj dhe të optimizoni cilësimet për kursimin e CPU-së dhe memories në klaster.
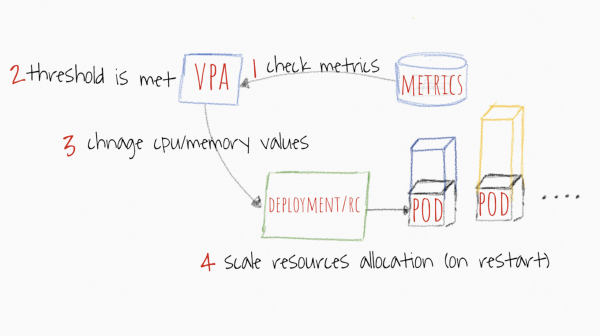 Imazhi është marrë nga https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Planifikuesi në Kubernetes gjithmonë bazohet në requests. Çfarëdo vlerë që i vendosni atje, planifikuesi do të kërkojë një nod të përshtatshëm, duke u nisur nga ajo. Vlerat limits i nevojiten kubletit për të kuptuar kur duhet të ngadalësojë ose të vrasë pod-in. Dhe për saqë parametri i rëndësishëm është vlera e requests, VPA do të punojë me të. Sa herë që jepni shkallëzim vertical për aplikacionin, specifikoni se çfarë duhet të jenë requests. Por çfarë do të ndodhë me limits? Ky parametër do të shkallëzohet gjithashtu proporcionalisht.
Për shembull, këtu janë cilësimet normale të podit:
burimet:
   kërkesat:
     memoria: 250Mi
     cpu: 200m
   kufijtë:
     memoria: 500Mi
     cpu: 350m
Mekanizmi i rekomandimeve përcakton se aplikacioni juaj ka nevojë për 300m CPU dhe 500Mi për të funksionuar normalisht. Ju do të merrni këto cilësime:
burimet:
   kërkesat:
     memoria: 500Mi
     cpu: 300m
   kufijtë:
     memoria: 1000Mi
     cpu: 525m
Siç u përmend më lart, kjo është skalimi proporcional që buron nga raporti i kërkesave/kufijve në manifest:
CPU: 200m → 300m: raporti 1:1.75;
Memoria: 250Mi → 500Mi: raporti 1:2.
Sa i përket HPA, në këtë rast mekanizmi i funksionimit është më transparent. Vendosen kufij të metrikave, për shembull, të procesorit dhe memorisë, dhe nëse mesatarja e të gjitha kopjeve kalon kufirin, aplikacioni shkallëzohet me +1 pod deri sa vlera të bie poshtë kufirit, ose derisa të arrihet numri maksimal i kopjeve.
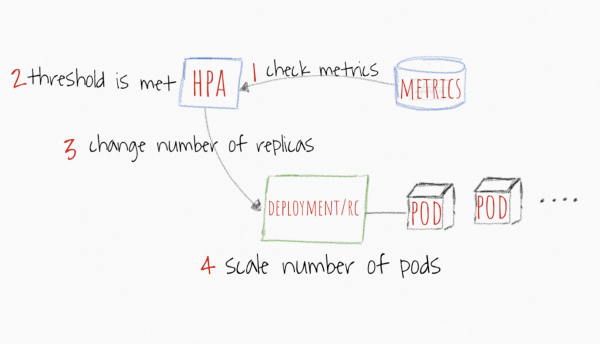 Imazhi është marrë nga https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Përveç metrikave standarde, si procesori dhe memoria, ju mund të konfiguroni kufijtë për metrikat tuaja të personalizuara nga Prometheus dhe të punoni me to, nëse e konsideroni këtë si përcaktimin më të saktë për kur duhet të shkallëzoni aplikacionin tuaj. Pasi aplikacioni të stabilizohet poshtë kufirit të caktuar të metrikës, HPA do të fillojë të shkallëzojë podët poshtë deri në numrin minimal të kopjeve ose deri në një gjendje kur ngarkesa do të kënaqë kufirin e caktuar.
6. Mos harroni për Node Affinity dhe Pod Affinity
Jo të gjitha nodet funksionojnë në pajisje të njëjta, dhe jo të gjitha podët kanë nevojë të ekzekutojnë aplikacione që kërkojnë llogaritje intensive. Kubernetes lejon të përcaktoni specializimin e nodave dhe podëve me anë të Node Affinity dhe Pod Affinity.
Nëse keni nodo që janë të përshtatshme për operacione me intensitet të lartë llogaritjesh, për efikasitet maksimal, është më mirë të lidhni aplikacionet me nodat përkatëse. Përdorni nodeSelector me etiketën e nodit.
Supozoni se keni dy nodet: një me CPUType=HIGHFREQ dhe një numër të madh të bërthamave të shpejta, dhe tjetra me MemoryType=HIGHMEMORY një sasi të madhe memorje dhe performancë më të lartë. Më e lehtë është të caktoni zhvendosjen e podit në nodën HIGHFREQ, duke shtuar në seksionin spec një selector të tillë:
…
nodeSelector:
	CPUType: HIGHFREQ
Një mënyrë më e shtrenjtë dhe specifike për ta bërë këtë është të përdorni nodeAffinity në fushën affinity në seksionin spec. Ka dy mundësi:
requiredDuringSchedulingIgnoredDuringExecution: konfigurimi i fortë (planifikuesi do të zhvendosë podët vetëm në nodat specifike (dhe askund tjetër));preferredDuringSchedulingIgnoredDuringExecution: konfigurimi i butë (planifikuesi do të përpiqet të vendosë në nodet specifike, dhe nëse dështon, do të provojë të vendosë në nodin tjetër të disponueshëm).
Mund të përcaktoni një sintaksë të caktuar për menaxhimin e etiketave të nodit, për shembull, Në, JoNë, Ekziston, NukEkziston, Gt ose Lt. Megjithatë, kujdesuni që metodat e ndërlikuara në lista të gjata etiketash do ta ngadalësojnë vendimmarrjen në situata kritike. Me fjalë të tjera, mos e komplikoni.
Siç u përmend më lart, Kubernetes lejon të përcaktoni lidhjen e pod-ëve të tanishëm. Kështu, mund të bëni që pod të caktuar të funksionojnë së bashku me pod të tjerë në të njëjtën zonë të disponueshmërisë (e rëndësishme për re) ose në nodet.
Në podAffinity fushat affinity në seksionin spec janë të njëjtat fusha si në rastin e nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution dhe preferredDuringSchedulingIgnoredDuringExecution. E vetmja dallim është se matchExpressions do të lidhe pod-et në nodën ku tashmë ekzekutohet një pod me atë etiketë.
Po ashtu, Kubernetes ofron fushën podAntiAffinity, e cila, përkundrazi, nuk lidh pod-in me nodën me pod-të specifike.
Sa për shprehjet nodeAffinity mund të japim këshilla të njëjta: përpiquni të ruani thjeshtësinë dhe logjikën e rregullave, nuk duhet të përpiqeni të mbingarkoni specifikimin e pod-ëve me një grup të ndërlikuar rregullash. Është shumë e lehtë të krijosh një rregull që nuk përputhet me kushtet e klasterit, duke krijuar një ngarkesë të tepërt për planifikuesin dhe duke ulur performancën e përgjithshme.
7. Taints & Tolerations
Ka një tjetër mënyrë për të menaxhuar planifikuesin. Nëse keni një klaster të madh me qindra nod-e dhe mijëra mikroshërbime, atëherë është shumë e vështirë të mos lejoni që disa pod-e të vendosen në nodet e caktuara.
Në këtë ndihmon mekanizmi taints - rregullat ndaluese. Për shembull, mund të ndaloni nodet e caktuara nga ekzekutimi i pod-eve në disa skenarë. Për të aplikuar taint në një nod të caktuar, duhet të përdorni opsionin taint në kubectl. Shkruani çelësin dhe vlerën, dhe pastaj taint si NoSchedule ose NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleËshtë e rëndësishme të theksohet se mekanizmi taint mbështet tre efekte kryesore: NoSchedule, NoExecute dhe PreferNoSchedule.
NoScheduledo të thotë se derisa në specifikimin e pod-it të mos ketë një regjistrim përkatëstolerations, ai nuk mund të vendoset në nodë (në këtë shembullnode10).PreferNoSchedule— version i thjeshtuarNoSchedule. Në këtë rast, planifikuesi do të përpiqet të mos shpërndajë pod-et që nuk kanë regjistrimin përkatëstolerationsnë nodë, por kjo nuk është një kufizim rigoroz. Nëse në klaster nuk ka burime, atëherë pod-et do të fillojnë të vendosen në këtë nodë.NoExecute— kjo efekt aktivizon evakuimin e menjëhershëm të podëve që nuk kanë një regjistrim përkatëstolerations.
Është interesante se kjo sjellje mund të anulohet përmes mekanizmit tolerancave. Kjo është e dobishme kur ka një nodë "të ndaluar" dhe ju nevojitet të vendosni vetëm shërbimet infrastrukturore mbi të. Si ta bëni këtë? Lejoni vetëm ato podë për të cilat ekziston një tolerancë e përshtatshme.
Ja si do të duket specifikimi i podit:
spec:
   tolerations:
     - key: "node-role.kubernetes.io/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Kjo nuk do të thotë se një herë tjetër, gjatë rindezjes së podit, ai do të bjerë pikërisht në këtë nodë, nuk është mekanizmi i Afinitetit të Nodhës dhe nodeSelector. Por duke kombinuar disa tipare, mund të arrini një konfigurim shumë fleksibël të planifikuesit.
8. Konfiguroni prioritetin e shpërndarjes së podëve
Fakti që keni konfigurimin e lidhjes së podëve me nodat, nuk do të thotë që të gjithë podët duhet të përpunohen me të njëjtin prioritet. Për shembull, mund të dëshironi të shpërndani disa podë më herët se të tjerët.
Kubernetes ofron mënyra të ndryshme për të konfiguracionin e prioritetit të podëve (Pod Priority and Preemption). Konfigurimi përbëhet nga disa pjesë: objekti PriorityClass dhe përshkrimi i fushës priorityClassName në specifikimin e podit. Le të shohim një shembull:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Kjo klasë prioriteti duhet të përdoret vetëm për podët shumë të rëndësishëm"
Ne krijojmë PriorityClass, i japim emrin, përshkrimin dhe vlerën e tij. Sa më e lartë vlera, aq më e lartë është prioriteti. Vlera mund të jetë çfarëdo numri të plotë 32-bitësh, më pak ose e barabartë me 1 000 000 000. Vlerat më të larta janë të rezervuara për podët kritikë të sistemit, të cilët zakonisht nuk mund të zënë vend. Zgjedhja do të ndodhë vetëm nëse podi me prioritet të lartë nuk ka vend për t'u shpërndarë, atëherë disa podë nga një nodë e caktuar do të evakuohen. Nëse ky mekanizëm është shumë i ashpër për ju, mund të shtoni opsionin preemptionPolicy: Never, dhe atëherë nuk do të ketë përjashtim, podi do të jetë i pari në radhë dhe do të presë derisa planifikuesi të gjejë për të burime të lira.
Më pas krijojmë një pod, në të cilin specifikojmë emrin priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Është e mundur të krijoni sa më shumë klasa prioritete si të doni, megjithatë rekomandohet të mos shpenzoni tepër mbi këtë (të paktën të kufizoheni në prioritete të ulëta, mesatare dhe të larta).
Në këtë mënyrë, në rast nevoje do të jeni në gjendje të rrisni efikasitetin e përhapjes së shërbimeve kritike, si nginx-ingress-controller, coredns etj.
9. Optimizoni klusterin ETCD
ETCD mund të quhet truri i të gjithë klusterit. Është shumë e rëndësishme të mbani punën e kësaj DB në nivele të larta, pasi pikërisht nga ajo varet shpejtësia e operacioneve në "Kube". Një zgjidhje standarde dhe e mirë do të ishte të mbani klusterin ETCD në nodat master, për të pasur një vonesë minimale deri te kube-apiserver. Nëse kjo nuk është e mundur, vendosni ETCD sa më afër, duke pasur një kapacitet të mirë kalimi midis pjesëmarrësve. Gjithashtu, vini re se sa shumë nodet nga ETCD mund të bien pa dëmtuar klusterin.
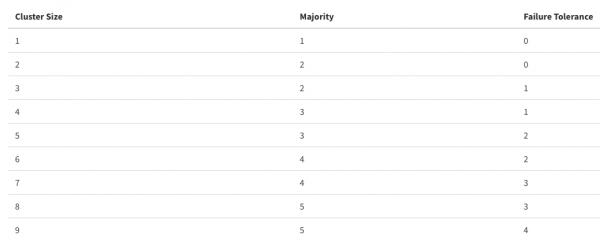
Mbani parasysh se një rritje e tepruar e numrit të pjesëmarrësve në kluster mund të përmirësojë qëndrueshmërinë në dëm të performancës, gjithçka duhet të jetë në masë.
Nëse flasim për konfigurimin e shërbimit, rekomandimet janë pak
Të keni pajisje të mira, sipas madhësisë së klusterit (mund të lexoni ).
Të rregulloni disa parametra, nëse e keni përhapur klusterin midis disa DC-ve ose nëse rrjeti dhe disqet tuaja lënë për të dëshiruar (mund të lexoni ).
Përfundim
Në këtë artikull janë përmendur pikat që ekipi ynë përpiqet të zbatojë. Kjo nuk është një përshkrim hap pas hapi të veprimeve, por opsione që mund të jenë të dobishme për optimizimin e shpenzimeve operative në kluster. Është e qartë se çdo kluster është unik në mënyrën e vet, dhe zgjidhjet për konfigurimin mund të ndryshojnë ndjeshëm, prandaj do të ishte interesante të merrnim feedback nga ju: si kujdeseni për klusterin tuaj Kubernetes, çfarë përdorni për ta përmirësuar funksionimin e tij. Ndani përvojën tuaj në komentet, do të jetë interesante ta dëgjojmë.
Burimi: habr.com
