

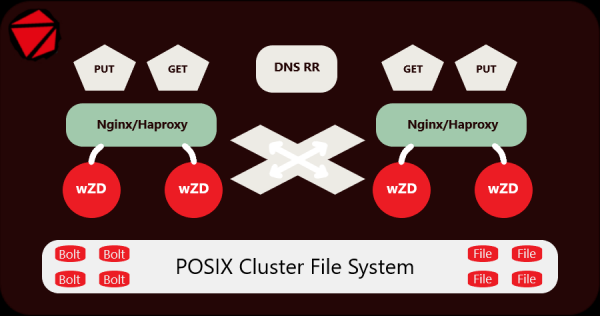
E dashur komunitet, ky artikull do të fokusohet në ruajtjen dhe shpërndarjen efektive të qindra milionë skedarëve të vegjël. Në këtë fazë, po propozohet një zgjidhje përfundimtare për sistemet e skedarëve që janë të pajtueshme me POSIX, me mbështetje të plotë për bllokimet, përfshirë ato klasterike, dhe duket se madje edhe pa ndihmës për zgjidhje.
Prandaj, për këtë qëllim, kam shkruar serverin tim të specializuar.
Në procesin e zbatimit të kësaj detyre arrita të zgjidh problemin kryesor, duke arrijtur gjithashtu një kursim të hapësirës në disk dhe memories operative, të cilat sistemet tona klasterike të skedarëve i konsumonin pa mëshirë. Në fund të fundit, kaq shumë skedarë është e dëmshme për çdo sistem klaster të skedarëve.
Ideja është kështu:
Me fjalë të thjeshta, skedarët e vegjël ngarkohen përmes serverit, ata ruhen drejtpërdrejt në arkiv dhe gjithashtu lexohen prej tij, ndërsa skedarët e mëdhenj vendosen afër. Schemat: 1 dosje = 1 arkiv, kështu kemi disa milionë arkiva me skedarë të vegjël, e jo disa qindra milionë skedarë. Dhe gjithçka është realizuar në mënyrë të plotë, pa ndonjë skript dhe pa shpërndarjen e skedarëve në arkiva tar/zip.
Do të përpiqem të shpjegoj shkurtimisht, paraprakisht kërkoj falje nëse posta do të jetë e gjatë.
E gjithë filloi kur nuk mund të gjeja një server të përshtatshëm në botë që mund të ruante të dhënat, të marra përmes protokollit HTTP, drejtpërdrejt në arkiva, në mënyrë që të mos kishte disavantazhe tipike të arkivave të zakonshëm dhe ruajtjeve objektive. Arsyeja e kërkimeve ishte një klaster Origin i rritur në përmasa të mëdha me 10 serverë, në të cilin kishim grumbulluar tashmë 250,000,000 skedarë të vegjël dhe tendenca e rritjes nuk kishte ndërmend të ndalonte.
Për ata që nuk e duan të lexojnë artikuj dhe preferojnë dokumentacionin e vogël më të thjeshtë:
dhe .
Dhe docker gjithashtu, tani ka një opsion vetëm me nginx brenda për çdo rast:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage \n-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzdPastaj:
Nëse ka shumë skedarë, nevojiten burime të konsiderueshme, dhe, më e keqja, një pjesë e tyre humbet në mënyrë të panevojshme. Për shembull, kur përdoret një sistem skedarësh në klaster (në këtë rast - MooseFS), skedari, pavarësisht nga madhësia reale, gjithmonë zë të paktën 64 KB. Kështu që për skedarët me madhësi 3, 10 ose 30 KB nevojiten 64 KB në disk. Nëse ka një çerek miliard skedarë, humbim nga 2 deri në 10 terabajt. Nuk është e mundur të krijosh skedarë të rinj deri në pafundësi, sepse në MooseFS ka një kufizim: jo më shumë se 1 miliard me një replikë për çdo skedar.
Me rritjen e numrit të skedarëve, nevojitet shumë memorie për metadatë. Gjithashtu, dump-et e shpeshta të mëdha të metadatave kontribuojnë në konsumimin e SSD-ve.
Serveri wZD. Rregullojmë rendin në disqet.
Serveri është shkruar në gjuhën Go. Para së gjithash, më duhej të reduktonja numrin e skedarëve. Si ta bëj këtë? Përmes arkivimit, por në këtë rast pa kompresim, sepse skedarët e mi janë imazhe të ngjeshur. Në ndihmë erdhi BoltDB, të cilën gjithashtu duhej ta hiqja nga mangësitë e saj, siç është reflektuar në dokumentacion.
Përfundimisht, në vend të çerek miliard skedarëve, në rastin tim mbetën vetëm 10 milion arkivash Bolt. Po të kishim mundësinë të ndryshonim strukturën aktuale të mbushjes së skedarëve në direktori, ndoshta do të ishte e mundur ta ulja atë edhe deri në 1 milion skedarë.
Të gjithë skedarët e vegjël paketohet në arkivat Bolt, duke marrë automatikisht emrat e direktorive në të cilat ndodhen, ndërsa të gjithë skedarët e mëdhenj mbeten afër arkivave; nuk ka kuptim t'i paketojmë, kjo është e konfigurable. Të vegjlit - arkivohen, të mëdhenjt - mbeten pa ndryshim. Serveri punon në mënyrë të transparentë si me ato ashtu edhe me këta.
Arkitektura dhe veçoritë e serverit wZD.
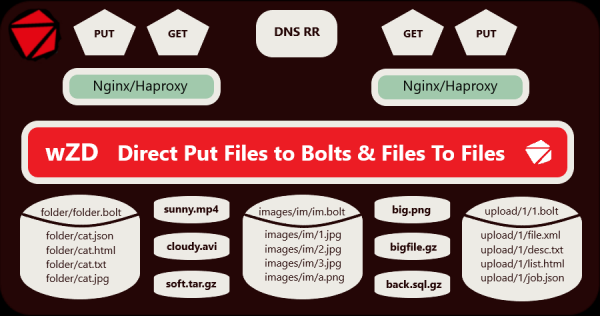
Serveri funksionon nën sistemet operative Linux, BSD, Solaris dhe OSX. E kam testuar vetëm për arkitekturën AMD64 nën Linux, por duhet të jetë e përshtatshme edhe për ARM64, PPC64, MIPS64.
Veçoritë kryesore:
- Multithreading;
- Multi-serverizmi, që siguron qëndrueshmëri dhe balancim ngarkese;
- Transparencë maksimale për përdoruesin ose zhvilluesin;
- Metoda HTTP të mbështetura: GET, HEAD, PUT dhe DELETE;
- Menaxhimi i sjelljes gjatë leximit dhe shk writing, përmes titrave të klientit;
- Mbështetje për hoste virtuale të konfigurueshëm;
- Mbështetje për CRC për integritetin e të dhënave gjatë shk writing / leximit;
- Buffera gjysmë-dinamik për konsum minimal të memories dhe optimizimin e performancës rrjetore;
- Kompaktimi i vonuar i të dhënave;
- Si një opsion, ofrohet një arkivues me shumëThreads wZA për migron e skedarëve pa ndalur shërbimin.
Përvoja reale:
Kam zhvilluar dhe testuar serverin dhe arkivuesin me të dhëna të jetuara për një kohë të gjatë, tani ai funksionon me sukses në një klaster me 250,000,000 skedarë të vegjël (imazhe), të vendosur në 15,000,000 direktorë në disqe SATA të ndara. Klasteri prej 10 serverash është një server Origin, i vendosur pas rrjetit CDN. Për mirëmbajtjen e tij përdoren 2 servera Nginx + 2 servera wZD.
Për ata që vendosin të përdorin këtë server, ka kuptim të planifikoni strukturën e direktorëve para përdorimit, nëse është e aplikueshme. Dëshiroj të theksoj se serveri nuk është i destinuar për të futur gjithçka në një arkiv Bolt.
Testimi i performancës:
Sa më i vogël të jetë madhësia e skedarit të arkivuar, aq më shpejt kryhen operacionet GET dhe PUT. Krahasojmë kohën e plotë të shkruar nga klienti HTTP në skedarë të zakonshëm dhe në arkivat Bolt, po ashtu edhe leximin. Krahasohet puna me skedarë me madhësi 32 KB, 256 KB, 1024 KB, 4096 KB dhe 32768 KB.
Kur punojmë me arkivat Bolt, kontrollohet integriteti i të dhënave të çdo skedari (përdoret CRC), para shkruarjes dhe gjithashtu pas shkruarjes, lexohet në flakë dhe përsëritet, kjo natyrisht sjell vonesa, por më e rëndësishmja — siguria e të dhënave.
Testet e performancës i kam kërkuar në disqe SSD, pasi në disqe SATA testet nuk tregojnë një diferencë të qartë.
Grafikët e rezultateve të testimeve:
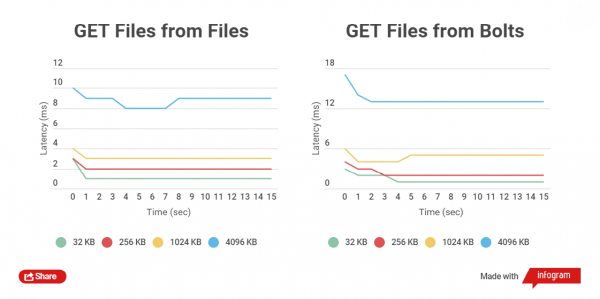
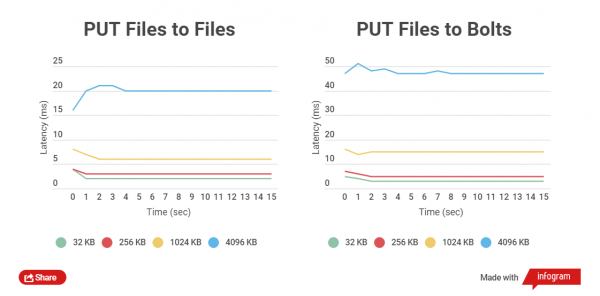
Siç duket, për skedarët e vegjël, ndryshimi në kohën e leximit dhe shkruarjes midis skedarëve të arkivuar dhe të paarkivuar është i vogël.
Një pamje tërheqëse do të marrim kur testojmë leximin dhe shkruarjen e skedarëve me madhësi 32 MB:
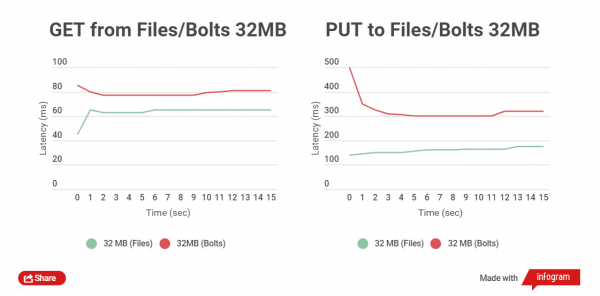
Diferenca në kohën midis leximit të skedarëve — është rreth 5-25 ms. Me shkruarjen, situata është më e keqe, diferenca është rreth 150 ms. Por në këtë rast, nuk ka nevojë të ngarkohet skedarë të mëdhenj, në të vërtetë, nuk ka kuptim, ata mund të jetojnë veçmas nga arkivat.
*Teknikisht, mund të përdoret ky server edhe për detyra që kërkojnë NoSQL.
Metodat kryesore të punës me serverin wZD:
Ngarkimi i një skedari të zakonshëm:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgNgarkimi i skedarit në arkivin Bolt (nëse nuk është tejkaluar parametri serveror fmaxsize, i cili përcakton madhësinë maksimale të skedarit që mund të përfshihet në arkiv, dhe nëse është tejkaluar, skedari do të ngarkohet si zakonisht pranë arkivit):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgShkarkimi i skedarit (nëse në disk dhe në arkiv ka skedarë me emra të njëjtë, atëherë gjatë shkarkimit prioriteti nga e drejta jepet skedarit të paarkivuar):
curl -o test.jpg http://localhost/test/test.jpgShkarkimi i skedarit nga arkivi Bolt (me detyrim):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgPërshkrimi i metodave të tjera ndodhet në dokumentacion.
Serveri për momentin mbështet vetëm protokollin HTTP, me HTTPS nuk funksionon ende. Po ashtu metoda POST nuk mbështetet ( ende nuk është vendosur nëse është e nevojshme apo jo).
Kush do të hulumtojë në kodin burim do të zbulojë aty një ëmbëlsirë, nuk e duan të gjithë, por unë nuk e kam lidhur kodin kryesor me funksionet e framework-ut të internetit, përveç menaxhuesit të ndërprerjeve, kështu që më vonë mund ta rishkruaj shpejt thuajse në çdo motor.
ToDo:
- Zhvillimi i një replikatori dhe distributor të vetin + geo për mundësinë e përdorimit në sisteme të mëdha pa FS klastere (Gjithçka në rregull)
- Mundësia e rikuperimit të plotë të metadatatëve në rast të humbjes së plotë (në rastin e përdorimit të distributorit)
- Protokoll nativ për mundësinë e përdorimit të lidhjeve të përhershme të rrjetit dhe drivere për gjuhë të ndryshme programimi
- Mundësi të zgjeruara për përdorimin e komponentit NoSQL
- Kompresimi i llojeve të ndryshme (gzip, zstd, snappy) për skedarë ose vlera brenda arkivave Bolt dhe për skedarë të zakonshëm
- Kriptimi i llojeve të ndryshme për skedarë ose vlera brenda arkivave Bolt dhe për skedarë të zakonshëm
- Konvertimi vonesë i videove në server, duke përfshirë edhe në GPU
Kam përfunduar, shpresoj që ky server do të jetë i dobishëm për dikë, licenca BSD-3, të drejtat e autorit janë të dyfishta, për shkak se nëse nuk do të ishte kompania ku punoj, nuk do ta kisha shkruar as serverin. Unë jam zhvilluesi i vetëm. Do të jem mirënjohës për çdo bug që gjeni dhe kërkesat për karakteristika.
Burimi: habr.com
