

Duke ClickHouse është një sistem i specializuar, prandaj gjatë përdorimit të tij është e rëndësishme të merren parasysh veçoritë e arkitekturës së tij. Në këtë raport, Aleksei do të flasë për shembuj të gabimeve tipike që ndodhin gjatë përdorimit të ClickHouse, të cilat mund të çojnë në një funksionim të pafavorshëm. Do të tregohen shembuj nga praktika, se si zgjedhja e një skeme të caktuar të përpunimit të të dhënave mund të ndryshojë ndjeshëm performancën.
Përshëndetje të gjithëve! Më quajnë Aleksei, unë punoj me ClickHouse.
Së pari, dua të ju gëzoj, nuk do t'ju tregoj sot se çfarë është ClickHouse. Po të jem i sinqertë, kam mjaft disi lodhur nga kjo. Çdo herë flas për të, dhe besoj se të gjithë tashmë e dinë.
Në vend të kësaj, do të flas për gropat e mundshme, domethënë se si mund të përdoret gabimisht ClickHouse. Në të vërtetë, nuk ka nevojë të frikësoheni, sepse ne e zhvillojmë ClickHouse si një sistem që është i thjeshtë, i përshtatshëm dhe funksionon nga kutia. E vendos dhe gjithçka, pa asnjë problem.
Megjithatë, është e nevojshme të mbani parasysh se ky është një sistem i specializuar dhe është e lehtë të hasni në skenarë të pazakontë të përdorimit që mund ta nxjerrin këtë sistem jashtë zones së tij të rehatisë.
Pra, cilat janë gropat e mundshme? Kryesisht do të flas për gjëra të dukshme. Të gjithë e kuptojnë gjithçka dhe mund të gëzohen se janë kaq të mençur, ndërsa ata që nuk kuptojnë do të mësojnë diçka të re.
Shembulli i parë shumë të thjeshtë, i cili, fatkeqësisht, shpesh ndodh, është një numër i madh i insert-eve me grupe të vogla, domethënë një numër i madh i insert-eve të vogla.
Nëse e shqyrtojmë se si ClickHouse realizon insert, mund të dërgoni një fluks të dhënash deri në një terabajt me një kërkesë. Kjo nuk është problem.
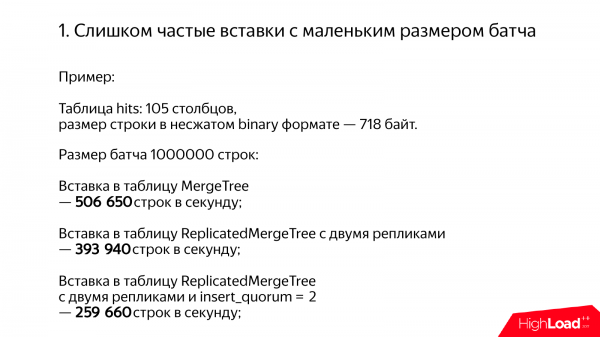
Le të shohim se cila do të ishte tipike për performancën. Për shembull, tabela jonë është me të dhënat nga Yandex.Metrika. Hitet. 105 disa kolona. 700 byte në formën e pa kompresuar. Dhe do të insertojmë në mënyrë të duhur grupe prej një milioni rreshtash.
Po insertojmë në tabelën MergeTree, del gjysmë milioni rreshta në sekondë. Shumë mirë. Në tabelën e replikuar - pak më pak, rreth 400,000 rreshta në sekondë.
Dhe nëse aktivizoni insertimin me kuorum, del pak më pak, por përsëri një performancë të kënaqshme, 250,000 rreshta në sekondë. Insertimi me kuorum është një mundësi e pa dokumentuar në ClickHouse.
* sipas gjendjes në vitin 2020, .
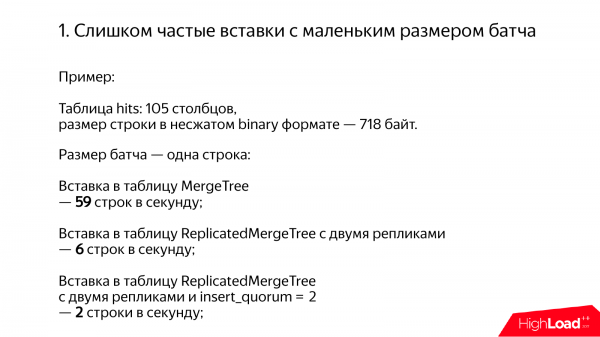
Çfarë do të ndodhte nëse gjithçka bëhet keq? Shtojmë një rresht në tabelën MergeTree dhe përfundojmë me 59 rreshta në sekondë. Kjo është 10,000 herë më e ngadaltë. Në ReplicatedMergeTree – 6 rreshta në sekondë. Dhe nëse aktivizohet edhe quorum-i, atëherë bëhen vetëm 2 rreshta në sekondë. Më duket se kjo është një dështim i plotë. Si është e mundur që të ecësh kaq ngadalë? Madje kam një T-shirt që thotë se ClickHouse nuk duhet ngadalësuar. Por ndonjëherë ndodh.
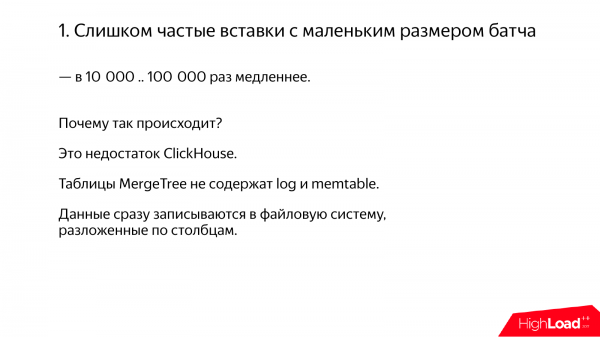
Në të vërtetë – është një disavantazh ynë. Mund të kishim bërë që gjithçka të funksiononte normalisht, por nuk e bëmë. Dhe nuk e bëmë sepse për skenarët tanë – nuk ishte e nevojshme. Kemi pasur tashmë batche. Thjesht na vinin batche, dhe nuk kishte asnjë problem. Shtojmë dhe gjithçka funksionon normal. Por, natyrisht, janë të mundshme skenarë të ndryshëm. Për shembull, kur keni shumë serverë ku gjenerohen të dhënat. Edhe nëse ata nuk e shtojnë të dhënat shpesh, përsëri ndodhin shtime të shpeshta. Dhe duhet ta shmangim këtë ndonjëherë.
Nga një pikëpamje teknike, thelbi është se kur bëni një insert në ClickHouse, të dhënat nuk shkojnë në asnjë memtable. As nuk përdorim një MergeTree me strukturë log, por thjesht MergeTree, sepse nuk kemi as log, as memTable. Thjesht shkruajmë të dhënat në sistemin e skedarëve, tashmë të ndara në kolona. Dhe nëse keni 100 coluna, atëherë duhet të shkruani më shumë se 200 skedarë në një drejtori të veçantë. Gjithçka është mjaft e ngarkuar.
Dhe lind pyetja: "Si të bëjmë siç duhet?", nëse ndodhemi në një situatë ku përsëri duhet të regjistroni të dhënat në ClickHouse.
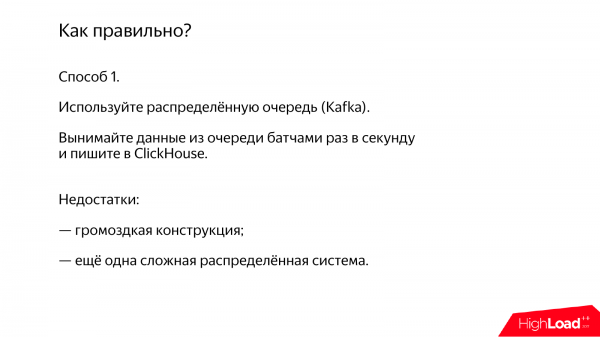
Metoda 1. Kjo është mënyra më e thjeshtë. Përdorni një radhë të shpërndarë. Për shembull, Kafka. Thjesht nxirrni të dhënat nga Kafka, gruponi një herë në sekondë. Dhe gjithçka do të jetë në rregull, regjistroni, gjithçka funksionon mirë.
Disavantazhi është se Kafka është një tjetër sistem i rëndë të shpërndarë. E kuptoj nëse kompania juaj tashmë e ka Kafka. Kjo është mirë, kjo është e përshtatshme. Por nëse nuk e keni, duhet të mendoni disa herë para se të sillni një tjetër sistem të shpërndarë në projektin tuaj. Prandaj, ka kuptim të shqyrtoni alternativa.
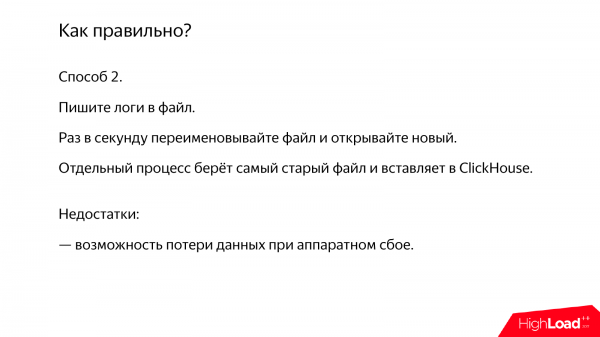
Metoda 2. Kjo është një alternativë retro dhe mjaft e thjeshtë. Keni një server që gjeneron logjet tuaja. Ai thjesht i regjistron logjet në një skedar. Dhe çdo sekondë, për shembull, e rinovojmë atë skedar, ndaj krijojmë një të ri. Një skript i veçantë ose përmes cron-it, ose një demon tjetër merr skedarin më të vjetër dhe e regjistron në ClickHouse. Nëse regjistrohen logjet çdo sekondë, gjithçka do të shkojë mrekullisht.
Por disavantazhi i kësaj metode është se nëse serveri ku gjenerohen logjet zhduket, të dhënat gjithashtu do të zhduken.
Metoda 3. Ka një tjetër mënyrë interesante, e cila është krejtësisht pa skedarë përkohësorë. Për shembull, keni ndonjë aplikacion reklamimi ose ndonjë demon tjetër interesant, i cili gjeneron të dhëna. Dhe ju mund të akumuloni një grup të dhënash direkt në RAM, në buffer. Kur kalon një sasi e mjaftueshme kohore, e ruheni këtë buffer, krijoni një të ri, dhe në një thread të veçantë, atë që është akumuluar tashmë, e dërgoni në ClickHouse.
Nga ana tjetër, të dhënat gjithashtu zhduken kur ndodh kill -9. Nëse serveri juaj bie, atëherë do të humbni këto të dhëna. Një tjetër problem është se nëse nuk mund të regjistroni në bazë, të dhënat do të akumulohen në RAM. Dhe do t'ju mbarojë RAM-i ose thjesht do të humbni të dhëna.
Metoda 4. Një tjetër mënyrë interesante. Keni ndonjë proces serveri. Ai mund të dërgojë të dhënat në ClickHouse menjëherë, por ta bëjë këtë në një lidhje të vetme. Për shembull, dërgoni një kërkesë http me transfer-encoding: chunked me insert-in. Dhe gjeneron chank-e jo shumë shpesh, mund të dërgoni edhe çdo rresht, megjithatë do të ketë overhead mbi framin e këtyre të dhënave.
Megjithatë, në këtë rast, të dhënat do të dërgohen menjëherë në ClickHouse. Dhe ClickHouse vetë do t'i buferizojë ato.
Por gjithashtu lindin probleme. Tani do të humbni të dhënat, përfshirë nëse procesi juaj ndalon dhe, nëse procesi ClickHouse ndalon, sepse do të jetë një insert i papërfunduar. Në ClickHouse, insert-et janë atomike deri në një prag të caktuar numri rreshtash. Në parim, kjo është një mënyrë interesante. Po ashtu mund të përdoret.
Mënyra 5. Ja një tjetër mënyrë interesante. Ky është një server i zhvilluar nga komuniteti për grumbullimin e të dhënave. Nuk e kam shqyrtuar vetë, ndaj nuk mund të garantosh asgjë. Megjithatë, as për ClickHouse nuk ofrohen garanci. Kjo është gjithashtu open source, por nga ana tjetër, mund të jeni mësuar me një standard të caktuar cilësie që ne përpiqemi ta sigurojmë. Për këtë gjë, nuk e di, hyni në GitHub, shikoni kodin. Ndoshta kanë shkruar diçka të mirë.
* në gjendje deri në vitin 2020, gjithashtu duhet të shtohet për shqyrtim .
Mënyra 6. Një tjetër mënyrë është përdorimi i tabelave Buffer. Avantazhi i kësaj metode është se është shumë e lehtë për t'u filluar. Krijoni një tabelë Buffer dhe e shtoni atje.
Por disavantazhi është se problemi nuk zgjidhet plotësisht. Nëse në insertimin e llojit MergeTree duhet të gruposh të dhënat për një batç në sekondë, kur e shton në tabelën buffer, duhet të gruposh të paktën disa mijëra në sekondë. Nëse kalon 10,000 në sekondë, ndodhin probleme. Por nëse e insertoni në grupime, do të keni qindra mijëra rreshta në sekondë. Dhe kjo është në të dhëna mjaft të rënda.
Po ashtu, tabelat buffer nuk kanë log. Dhe nëse me serverin tuaj ndodh ndonjë gjë, të dhënat do të humbasin.
Dhe si një bonus, kohët e fundit kemi shtuar në ClickHouse mundësinë për të marrë të dhëna nga Kafka. Ekziston një motor tabelash - Kafka. Thjesht krijoni atë. Dhe mbi të mund të vendosni pamje të materializuara. Në këtë rast, ai do të nxjerrë të dhënat nga Kafka dhe t'i vendosë në tabelat që ju nevojiten.
Dhe veçanërisht kënaqësia e kësaj mundësie është se nuk e kemi bërë ne. Kjo është një veçori e komunitetit. Dhe kur them "veçori e komunitetit", nuk e them me ndonjë përçmim. E kemi lexuar kodin, kemi bërë rishikime, duhet të funksionojë normalisht.
* në gjendje deri në vitin 2020, u shfaq mbështetje e ngjashme për .
Çfarë tjetër mund të jetë e pakëndshme ose e papritur gjatë insertimit të të dhënave? Nëse bëni një kërkesë për insertim vlerash dhe në vlerat shkruani shprehje të kalkuluara. Për shembull, now() është gjithashtu një shprehje e kalkuluar. Në këtë rast, ClickHouse është i detyruar të ekzekutojë interpretorin e këtyre shprehjeve për çdo rresht, dhe performanca do të bjerë me rregulla. Është më mirë të shmangni këtë.
* për momentin, problemi është zgjidhur plotësisht, nuk ka më regres në performancë kur përdoren shprehjet në VALUES.
Një shembull tjetër është kur mund të ketë disa probleme kur keni të dhëna për një lot që përfshin shumë particione. Në mënyrë standarde, në ClickHouse particionet janë sipas muajve. Dhe nëse po insertoni një grup prej një milioni rreshtash, dhe aty ka të dhëna për disa vjet, atëherë do të keni disa dhjetëra particione. Dhe kjo është ekuivalente me faktin se do të ekzistojnë grupe me disa dhjetëra herë më të vogla, sepse brenda tyre gjithmonë ndahen së pari sipas particioneve.
* së fundmi, në ClickHouse u shtua në mënyrë eksperimentale mbështetje për formatin kompakt të copëzave dhe copëzave në memorie me regjistrin e shkruar përpara, që pothuajse plotësisht zgjidh problemin.
Tani le të shqyrtojmë llojin e dytë të problemit - është tipizimi i të dhënave.
Tipizimi i të dhënave mund të jetë i fortë ose i varg. I vargu është kur thjesht e keni shpallur se të gjitha fushat janë të tipit string. Kjo është një katastrofë. Nuk duhet bërë ashtu.
Le të merremi me se si të bëjmë siç duhet në ato raste kur dëshirojmë të themi se një fushë është string, dhe le të merret ClickHouse vetë me këtë, pa u shqetësuar. Por prapë, ia vlen të bëni disa përpjekje.
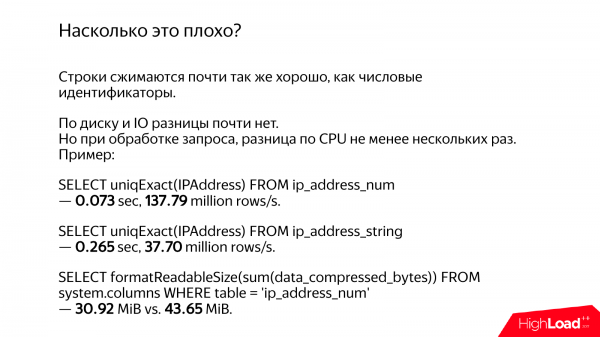
Për shembull, kemi një adresë IP. Në një rast e kemi ruajtur si string. Për shembull, 192.168.1.1. Ndërsa në rastin tjetër - do të jetë një numër i tipit UInt32*. 32 bit janë të mjaftueshme për adresën IPv4.
Së pari, siç është e habitshme, të dhënat do të kompresohen në mënyrë të ngjashme. Do të ketë ndonjë diferencë, sigurisht, por jo kaq e madhe. Pra, nuk ka probleme të veçanta me hyrjen/daljen në disk.
Por ka një ndryshim të rëndësishëm në kohën e procesorit dhe në kohën e ekzekutimit të pyetjes.
Le të llogarisim numrin e adresave IP unike, nëse ato ruhen si numra. Rezultati është 137 milion rreshta në sekondë. Nëse e njëjta në formë string, atëherë 37 milion rreshta në sekondë. Nuk e di pse doli një përshtatje e tillë. Unë vetë i kam ekzekutuar këto pyetje. Megjithatë, është ndoshta rreth 4 herë më e ngadalshme.
Dhe nëse llogarisim diferencën në hapësirën në disk, ka një diferencë gjithashtu. Dhe diferenca është ndoshta rreth një të katërtës, sepse ka mjaft adresash IP unike. Dhe nëse këtu do të ishin rreshta me një numër të vogël të vlerave të ndryshme, ato do të kompresoheshin qetësisht në një volum të ngjashëm sipas fjalorit.
Dhe katërfish diferencë në kohë në rrugë nuk është diçka e zakonshme. Mund të duket se nuk ka rëndësi për ju, por kur shoh një diferencë të tillë, më vjen keq.
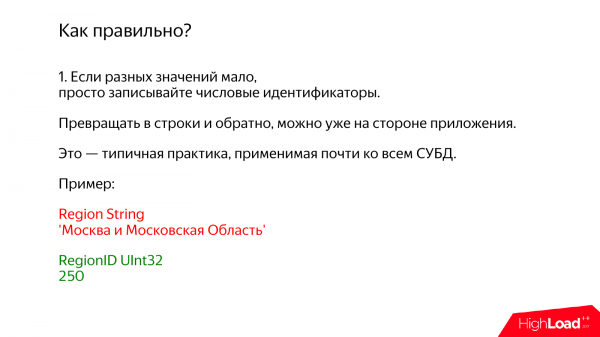
Le të shqyrtojmë raste të ndryshme.
1. Një rast kur keni pak vlera unike të ndryshme. Në këtë rast, përdorim një praktikë të thjeshtë, që ndoshta e dini dhe mund ta përdorni për çdo DBMS. Kjo ka kuptim jo vetëm për ClickHouse. Thjesht regjistroni identifikuesit numerikë në bazën e të dhënave. Ndërsa konvertimi në vargje dhe anasjelltas mund të bëhet në anën e aplikacionit tuaj.
Ja, për shembull, keni një rajon. Dhe përpiqeni ta ruani atë si një varg. Atje do të shkruhet: Moskë dhe MO. Kur shoh se është shkruar "Moskë", nuk është keq, por kur është edhe MO, më duket shumë e trishtueshme. Sa byte është kjo?
Në vend të kësaj, ne thjesht regjistrojmë numrin Ulnt32 dhe 250. Ne kemi 250 në Yandex, ndoshta ju keni ndryshe. Për të qenë të sigurt, po them se në ClickHouse ka një mundësi të ndërtuar për të punuar me bazën e të dhënave gjeografike. Thjesht regjistroni një referencë me rajonet, përfshirë hierarkinë, pra do të ketë dhe Moskën, dhe MO, dhe gjithçka që ju nevojitet. Dhe mund të konvertoni në nivelin e kërkesës.
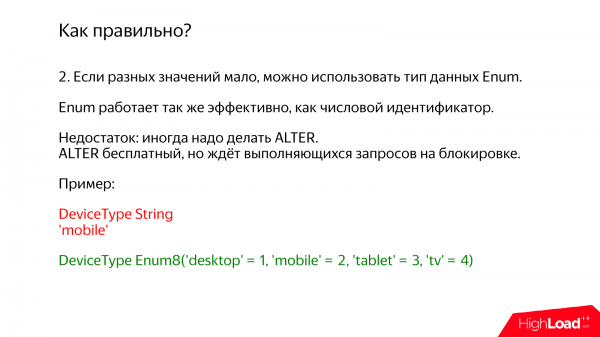
Varianti i dytë është më pak i ngjashëm, por tashmë me mbështetje brenda ClickHouse. Ky është tipi i të dhënave Enum. Thjesht brenda Enum regjistroni të gjitha vlerat që ju nevojiten. Për shembull, lloji i pajisjes dhe aty shkruani: desktop, mobil, tablet, televizor. Në total 4 mundësi.
Mungesa është se duhet herë pas here të bëni alter. Shtuat vetëm një variant. Bëni alter table. Në fakt, alter table në ClickHouse është falas. Sidomos falas për Enum, sepse të dhënat në disk nuk ndryshojnë. Por megjithatë, alter merr një bllokim* në tabelë dhe duhet të presë derisa të realizohen të gjitha selektimet. Dhe vetëm pas kësaj alter do të ekzekutohet, pra, megjithatë disa përshtypje të pakëndshme mbeten.
* në versionet e fundit të ClickHouse, ALTER është bërë plotësisht pa bllokim.
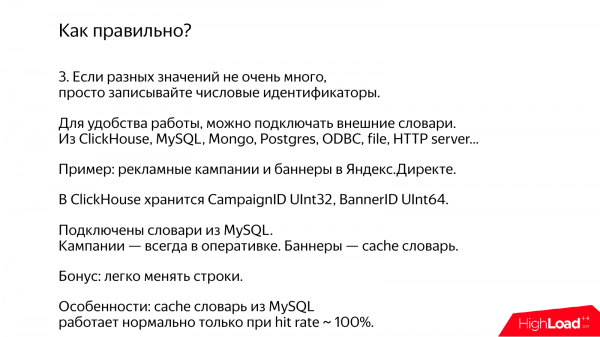
Një variant tjetër mjaft unik për ClickHouse – është lidhja e fjalorëve të jashtëm. Mund të shkruani në ClickHouse numra, dhe referencat tuaja i mbani në ndonjë sistem që ju përshtatet. Për shembull, mund të përdorni: MySQL, Mongo, Postgres. Madje mund të krijoni një mikroshërbim tuaj që do të dërgojë këto të dhëna përmes http. Dhe në nivelin e ClickHouse shkruani një funksion, që do të konvertojë këto të dhëna nga numra në vargje.
Ky është një mënyrë e specializuar, por shumë efektive për të kryer një bashkim me një tabelë të jashtme. Ka dy variante. Në një variant, të dhënat do të jenë plotësisht të ruajtura në memorie dhe të rinovohen me një frekuencë të caktuar. Në variantin tjetër, nëse të dhënat nuk i përshtaten memorisë, ato mund të ruhen pjesërisht.
Ja një shembull. Ekziston Yandex.Direct. Aty ka kompani reklamuese dhe bannera. Ka ndoshta rreth dhjetë milion kompani reklamuese. Ato mund të ruhen në memorie. Ndërsa për bannerat – janë miliarda, dhe ato nuk i përshtaten. Ne përdorim një fjalor të ruajtshëm nga MySQL.
Problemi i vetëm është që fjalori i ruajtshëm do të funksionojë normalisht nëse shkalla e goditjes është afërsisht 100%. Nëse është më e ulët, atëherë gjatë përpunimit të kërkesave për çdo grup të dhënash, do të duhet të merrni realisht çelësat që mungojnë dhe të marrëni të dhënat nga MySQL. Për ClickHouse mund të sigurohem se - po, nuk ngadalëson, për sistemet e tjera nuk do të flas.
Si një bonus, fjalorët janë një mënyrë shumë e thjeshtë për të përditësuar të dhënat në ClickHouse retroaktivisht. Domethënë, nëse kishit një raport mbi kompanitë reklamuese, përdoruesi thjesht ndërron kompaninë reklamuese dhe në të gjitha të dhënat e vjetra, në të gjitha raportet, këto të dhëna gjithashtu ndryshojnë. Nëse shkruani rreshta drejtpërdrejt në tabelë, atëherë përditësimi i tyre do të jetë i pamundur.
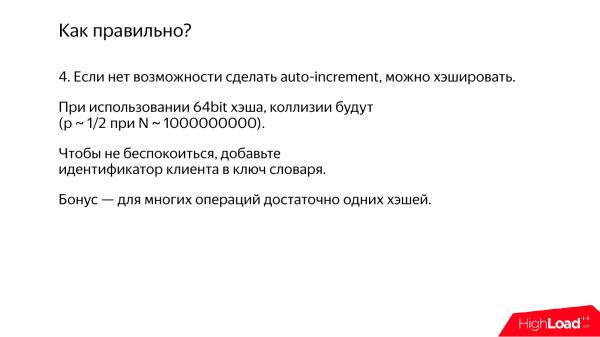
Një mënyrë tjetër, kur nuk e dini nga të merrni identifikuesit për rreshtat tuaj, është thjesht të hash. Dhe varianti më i thjeshtë është të merrni një hash 64-bitësh.
Problemi i vetëm është që nëse hash-i është 64-bitësh, atëherë kolidzionet do të ndodhin almost me siguri. Sepse nëse aty ka një miliard rreshtash, probabiliteti tashmë bëhet i dukshëm.
E nuk do të ishte shumë mirë të hash emrat e kompanive reklamuese në këtë mënyrë. Nëse kompanitë reklamuese të kompanive të ndryshme ngatërrohen, atëherë do të ketë diçka të paqartë.
Dhe është një truk i thjeshtë. E vërteta, nuk është shumë i përshtatshëm për të dhëna serioze, por nëse keni diçka që nuk është shumë serioze, thjesht shtoni identifikuesin e klientit në çelësin e fjalorit. Kështu që do të keni kolizione, por vetëm brenda një klienti. Ky metodë përdoret për kartën e lidhjeve në Yandex.Metrica. Atje kemi URL, ruajmë hash-at. E dimë, sigurisht, që kanë kolizione. Por kur shfaqet faqja, probabiliteti që në një faqe të një përdoruesi disa URL të shqiptuara të lidhen dhe të vihen re është aq i vogël sa mund ta injoroni.
Si një bonus – për shumë operacione, mjaftojnë vetëm hash-at dhe vetë stringat mund të mos ruhen askund.
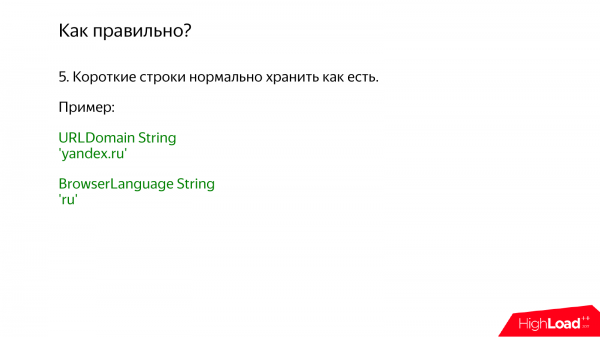
Një rast tjetër, nëse stringat janë të shkurtër, si për shembull, domenet e faqeve. Mund t'i ruani ashtu si janë. Ose, për shembull, gjuha e shfletuesit ru – 2 byte. Për mua, sigurisht, është shumë keq për byte-at, por mos u shqetësoni, 2 byte nuk janë shumë. Ju lutem, ruajtni ashtu si janë, mos u shqetësoni.
Një rast tjetër, kur, përkundrazi, ka shumë stringa dhe në to ka shumë unikë, edhe shumë potencialisht të pakufizuar. Një shembull tipik është frazat e kërkimit ose URL-të. Fraza të kërkimit, përfshirë për shkak të gabimeve të shkruar. Të shohim sa fraza unike kërkohen në një ditë. Dhe rezulton se gjysma e tyre është nga të gjitha ngjarjet. Dhe në këtë rast mund të mendoni se duhet të normalizoni të dhënat, të llogaritni identifikuesit, t'i vendosni në një tabelë të veçantë. Por nuk duhet ta bëni këtë. Thjesht ruani stringat ashtu si janë.
Më mirë – mos shpikni asgjë, sepse nëse i ruani veçmas, do t'ju duhet të bëni join. Dhe ai join – në rastin më të mirë, aksesi rastësor në memorie, nëse madje futet në memorie. Nëse nuk futet, atëherë do të keni probleme.
Por nëse të dhënat ruhen në vend, ato thjesht lexohen në rendin e duhur nga sistemi i skedarëve dhe gjithçka është në rregull.
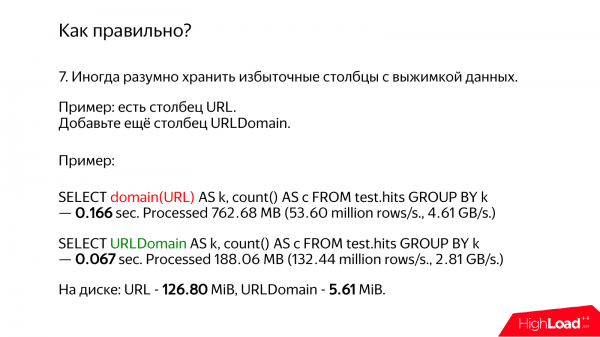
Nëse keni URL ose ndonjë string të gjatë dhe të komplikuar, duhet të mendoni për atë që mund të llogaritni ndonjë përmbledhje paraprakisht dhe ta regjistroni në një kolonë të veçantë.
Për URL, për shembull, mund të ruani veçmas domenin. Dhe nëse ju nevojitet me të vërtetë domeni, thjesht përdorni këtë kolonë, ndërsa URL do të qëndrojnë dhe ju as nuk do t'i prekni.
Le të shohim se cila është diferenca. Në ClickHouse ka një funksion të specializuar që llogarit domenin. Ai është shumë i shpejtë, ne e kemi optimizuar. Dhe, për ta thënë hapur, ai madje nuk i përputhet RFC, por megjithatë llogarit gjithçka që na nevojitet.
Në një rast, ne do të nxjerrim thjesht URL-të dhe do të llogarisim domenin. Kjo rezulton në 166 milisekonda. Nëse e marrim një domen të gatshëm, rezultati është vetëm 67 milisekonda, pra pothuajse tre herë më shpejt. Dhe kjo është më e shpejtë jo për shkak se na duhen llogaritje të ndonjë lloji, por sepse lexojmë më pak të dhëna.
Megjithatë, për një kërkesë që është më e ngadalshme, rezulton të ketë më shumë shpejtësi gigabajtësh për sekondë. Sepse ajo lexon më shumë gigabajtë. Këto janë të dhëna krejtësisht të panevojshme. Kërkesa duket se punon më shpejt, por përfundon në një kohë më të gjatë.
Dhe kur shohim hapësirën e të dhënave në disk, rezulton se URL-ja është 126 megabajtë, ndërsa domeni vetëm 5 megabajtë. Pra, është 25 herë më pak. Por megjithatë, kërkesa përfundohet vetëm 4 herë më shpejt. Kjo është për shkak se të dhënat janë të ngrohta. Nëse do të ishin të ftohta, atëherë me siguri do të ishin 25 herë më shpejt për shkak të hyrjes dhe daljes nga disku.
Për më tepër, nëse vlerësojmë se sa më i vogël është domin nga URL-ja, rezulton diku rreth 4 herë. Por për çudi, të dhënat në disk zënë 25 herë më pak. Pse? Për shkak të kompresimit. Të dy, URL-ja dhe domeni kompresohen. Por shpesh URL-ja përmban shumë ‘zhurmë’.
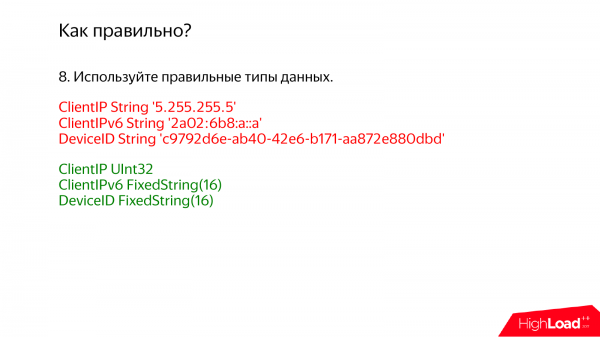
Dhe, sigurisht, është e rëndësishme të përdoren llojet e duhura të të dhënave, të cilat janë të dizajnuara posaçërisht për vlerat e nevojshme ose që i përshtaten. Nëse jeni në IPv4, ruani UInt32*. Nëse jeni në IPv6, atëherë FixedString(16), sepse adresa IPv6 është 128 bit, pra ruani drejtpërdrejt në format bina.
Çfarë të bëni nëse ndonjëherë keni adresa IPv4 dhe ndonjëherë IPv6? Po, mund të ruani të dyja. Një kolumnë për IPv4 dhe një tjetër për IPv6. Sigurisht, ka mundësinë për të shfaqur IPv4 në IPv6. Kjo gjithashtu do të funksionojë, por nëse ju nevojitet shpesh adresa IPv4 në kërkesa, do të ishte mirë ta vendosni në një kolumnë të veçantë.
* tani në ClickHouse ekzistojnë lloje të veçanta të të dhënave IPv4, IPv6, të cilat ruajnë të dhënat po aq efektivisht sa numrat, por i paraqesin ato po aq lehtësisht sa zinxhirë.
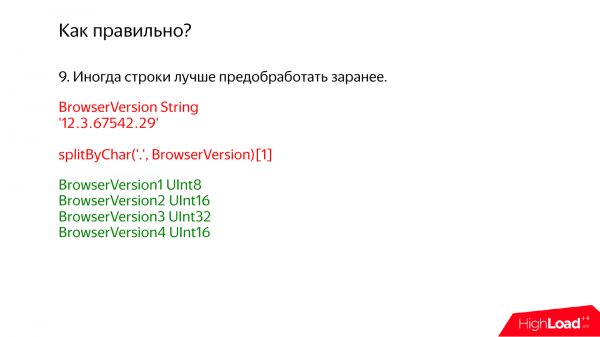
Është gjithashtu e rëndësishme të theksohet se duhet të paraprocesoni të dhënat paraprakisht. Për shembull, nëse ju vijnë disa log-e të papërpunuara. Dhe, ndoshta, nuk duhet t'i fusni menjëherë në ClickHouse, megjithëse është shumë tërheqëse të mos bëni asgjë dhe gjithçka të funksionojë. Por duhet gjithsesi të kryeni ato llogaritje që është e mundur.
Për shembull, versioni i shfletuesit. Në një departament fqinj, për të cilin nuk dua të tregoj me gishta, atje versioni i shfletuesit ruhet kështu, domethënë si një varg: 12.3. Dhe pastaj, për të bërë një raport, ata e marrin këtë varg dhe e ndajnë në një masiv, dhe pastaj në elementin e parë të masivit. Natyrisht, gjithçka ngadalësohet. E pyeta se pse e bëjnë kështu. Ata më thanë se nuk e pëlqejnë optimizimin e parakohshëm. Dhe unë nuk e pëlqej parakohshmërinë e pesimizmit.
Prandaj, në këtë rast, do të ishte më e saktë të ndaheshin në 4 kolona. Mos kini frikë këtu, sepse kjo është ClickHouse. ClickHouse është një bazë të dhënash kolonore. Dhe sa më tepër kolona të vogla e të sakta, aq më mirë. Nëse do të keni 5 BrowserVersion, bëni 5 kolona. Kjo është normale.
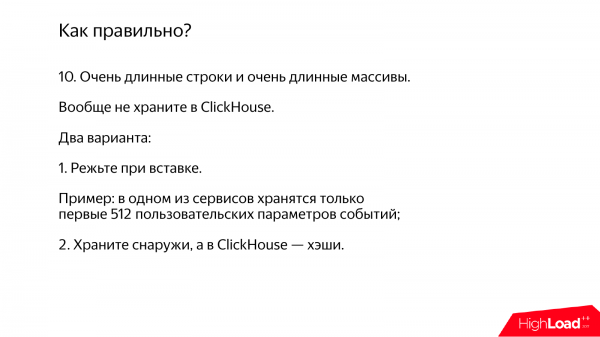
Tani le të shqyrtojmë se çfarë të bëni nëse keni shumë vargje shumë të gjata, shumë masa të gjata. Nuk është e nevojshme t'i ruani ato në ClickHouse fare. Në vend të kësaj, mund të ruani vetëm disa identifikues në ClickHouse. Dhe këto vargje të gjata vendosini në një sistem tjetër.
Për shembull, në një nga shërbimet tona analitike ka disa parametra ngjarjesh. Dhe nëse në ngjarje vijnë shumë parametra, ne thjesht ruajmë 512-të e para që na bien përpara. Sepse 512 nuk është shumë.
Dhe nëse nuk mund të përcaktoni llojet tuaja të të dhënave, atëherë mund ta regjistroni gjithashtu të dhënat në ClickHouse, por në një tavë të përkohshme lloj Log, e specializuar për të dhëna të përkohshme. Pas kësaj, mund të analizoni se çfarë shpërndarje vlerash keni aty, se çfarë ka dhe të formoni llojet e sakta.
* tani në ClickHouse ka një lloj të dhënash i cili lejon ruajtjen e efektshme të vargjeve me më pak shpenzime pune.
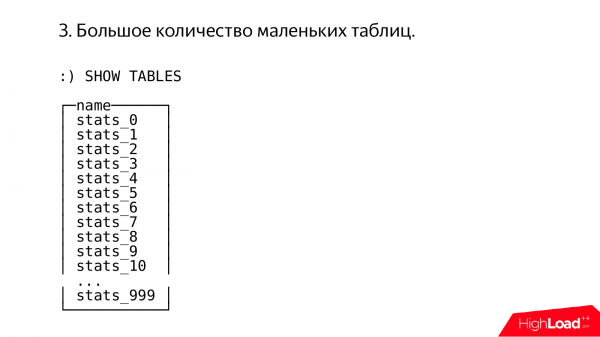
Tani le të shqyrtojmë edhe një rast tjetër interesant. Ndodhin ndonjëherë që gjërat të funksionojnë siç s'kanë, unë hyj brenda dhe shoh kështu. Dhe menjëherë paraqitet idea se kjo është bërë nga ndonjë admin shumë me përvojë dhe inteligjent, i cili ka një përvojë të madhe në konfigurimin e MySQL versionit 3.23.
Këtu ne shohim një mijë tabela, në secilën nga të cilat është regjistruar mbetja nga ndarja e diçkaje të paqartë me një mijë.
Në parim, unë respektoj përvojën e të tjerëve, duke kuptuar gjithashtu se çfarë vuajtjesh mund të ketë sjellë kjo përvojë.
Dhe arsyet janë më shumë më pak të qarta. Këto janë stereotype të vjetra që mund të jenë grumbulluar gjatë punës me sisteme të tjera. Për shembull, në tabelat MyISAM nuk ka çelës primar klaster. Dhe ky lloj ndarjeje të dhënash mund të jetë një përpjekje desperate për të marrë funksionalitetin e njejtë.
Arsye tjetër është se operacionet si alter mbi tabela të mëdha janë të vështira. Të gjitha do të bllokohen. Megjithatë, në versionet moderne të MySQL, kjo problematikë nuk është më aq e rëndësishme.
Ose, për shembull, mikroshardimi, por për këtë më vonë.
Në ClickHouse nuk është e nevojshme të bëni kështu, sepse, në radhë të parë, çelësi primar është klaster, të dhënat janë të renditura sipas çelësit primar.
Dhe ndonjëherë më pyesin: «Si ndryshon performanca e kërkesave në interval në ClickHouse nga madhësia e tabelës?». Unë them se nuk ndryshon fare. Për shembull, nëse keni një tabelë me një miliard rreshta dhe lexoni një interval një milion rresh, gjithçka është në rregull. Nëse tabela ka një trilion rreshta dhe ju lexoni një milion rreshta, atëherë do të jetë pothuajse e njëjtë.
Dhe, në radhë të dytë, gjëra si partitë manuale nuk kërkohen. Nëse hyni dhe shikoni çfarë është në sistemin e skedarëve, do të shihni se tabela është një gjë mjaft e rëndësishme. Dhe brenda saj ka diçka si partitë. Pra, ClickHouse e bën gjithçka për ju dhe nuk keni nevojë të vuani.
Alter në ClickHouse është falas, nëse alteroni shtimin/zhbjerjen e kolonave.
Dhe nuk ia vlen të krijoni tabela të vogla, sepse nëse keni 10 rreshta ose 10,000 rreshta në tabelë, kjo është krejtësisht e parëndësishme. ClickHouse është një sistem që optimizon throughput, jo latency, prandaj nuk ka kuptim të përpunoni 10 rreshta.
Është e drejta të përdorni një tabelë të madhe. Largoni stereotype të vjetra, gjithçka do të shkojë mirë.
Si bonus, në versionin tonë të fundit kemi shtuar mundësinë për të krijuar një çelës të rastësishëm të ndarjeve për të kryer operacione të ndryshme mirëmbajtjeje mbi ndarjet e veçanta.
Për shembull, ju nevojiten shumë tabela të vogla, për shembull, kur ka nevojë për trajtimin e disa të dhënave ndërmjetëse, ju vijnë copëza dhe ju duhet të bëni transformime mbi to përpara se t'i shkruani në tabelën përfundimtare. Për këtë rast ka një motor të shkëlqyer për tabela – StripeLog. Është diçka si TinyLog, vetëm më e mirë.
* tani në ClickHouse ka edhe .
Një tjetër antipattern – është mikroshardimi. Për shembull, ju duhet të shardoni të dhënat dhe keni 5 serverë, kurse nesër do të keni 6 serverë. Dhe ju mendoni, si ta rishpërndani këto të dhëna. Dhe në vend të kësaj, ju i ndani jo në 5 sharda, por në 1,000 sharda. Dhe më pas ju tregoni çdo një nga këto mikrosharda në një server të veçantë. Dhe ju do të përfundoni, për shembull, me 200 ClickHouse në një server, për shembull. Instance të veçanta në porte të veçanta ose baza të veçanta të të dhënave.
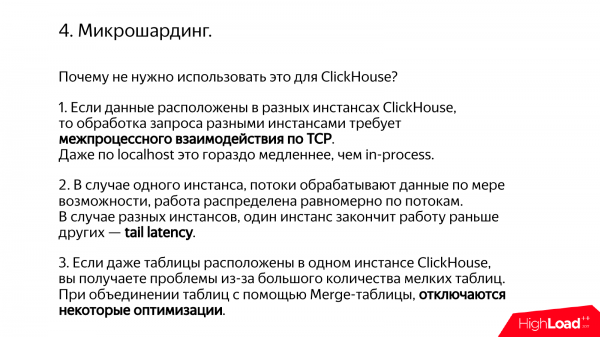
Por në ClickHouse kjo nuk është shumë mirë. Sepse edhe një instance ClickHouse përpiqet të përdorë të gjitha burimet e disponueshme të serverit për të trajtuar një kërkesë të vetme. Që është, keni një server ndonjëherë dhe atje, për shembull, 56 bërthamë procesori. Ju e ekzekutoni një kërkesë që zgjat një sekondë, dhe ajo do të përdorë 56 bërthama. Por nëse keni vendosur 200 ClickHouse në një server, atëherë ndodhet që do të startojnë 10,000 thread-e. Në përgjithësi, gjithçka do të shkojë shumë keq.
Arsyet e tjera janë se shpërndarja e punës midis këtyre instanceve do të jetë e patëbarabartë. Disa përfundojnë më herët, disa më vonë. Nëse gjithë kjo do të ndodhte në një instance, ClickHouse do ta merrte vetë përsipër si të shpërndante të dhënat në mënyrë të saktë nëpër thread-e.
Dhe një arsye tjetër është se do të keni ndërveprim ndërprocesor përmes TCP. Të dhënat do të duhet të serializohen, deserializohen dhe kjo është një sasi e madhe mikroshardesh. Do të funksionojë thjesht në mënyrë joefikase.
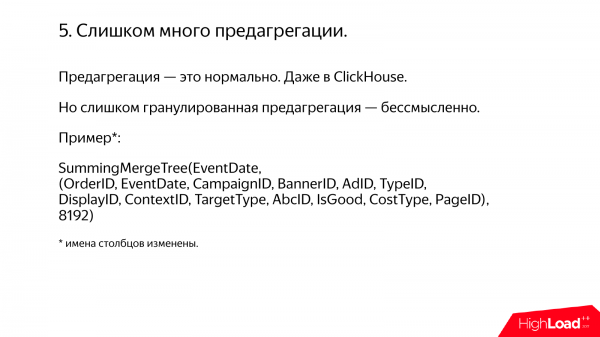
Një tjetër antipattern, ndonëse është e vështirë ta quash të tillë. Kjo është një sasi e madhe paragrege.
Në përgjithësi, paragrege – është mirë. Keni pasur një miliard rreshta, e keni agreguar dhe tani keni 1,000 rreshta, dhe tani kërkesa ekzekutohet menjëherë. Gjithçka është e shkëlqyer. Kështu mund të bëni. Dhe për këtë, madje edhe në ClickHouse ka një tip të veçantë tabele AggregatingMergeTree, e cila bën agregimin inkremental ndërsa ose bëni inserte të dhënash.
Por ndodhin raste kur ju mendoni se do të agregojmë të dhënat kështu dhe përsëri do të agregojmë të dhënat. Dhe në një departament fqinj, nuk kam dëshirë të flas se cili, përdorin tabela SummingMergeTree për të bërë përllogaritje sipas çelësit primar, dhe si çelës primar përdorin rreth 20 kolona të ndryshme. Unë për hir të konspiracionit kam ndryshuar emrat e disa kolonave, por përllogarisni se kështu është.
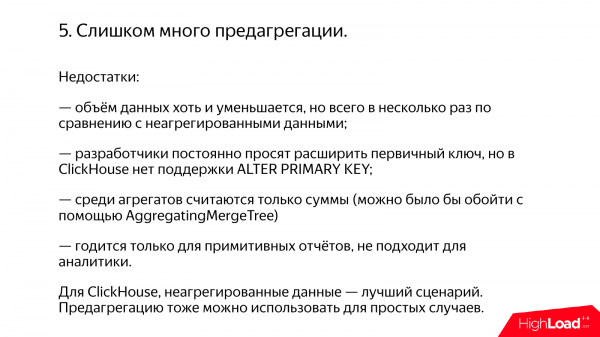
Dhe çfarë probleme shfaqen? Së pari, volumi i të dhënave nuk zvogëlohet shumë. Për shembull, zvogëlohet në tre herë. Tre herë – do të ishte një çmim i mirë për të lejuar mundësi të pakufizuara për analiza që shfaqen, nëse të dhënat tuaja nuk janë agreguar. Nëse të dhënat janë të agreguara, atëherë në vend të analizave, do të merrni vetëm statistika të mjerueshme.
Dhe çfarë veçanërisht nervon? Ato që njerëzit nga departamenti fqinj vijnë dhe kërkojnë ndonjëherë të shtojnë një kolonë tjetër në çelësin primar. Pra, ne kemi agreguar të dhënat kështu, por tani duam pak më shumë. Por në ClickHouse nuk ka ndryshim të çelësit primar. Pra, duhet të shkruajmë disa skripte në C++. Dhe unë nuk i pëlqej skriptet, për shkak se janë në C++ ose jo.
Dhe nëse shikoni për çfarë është krijuar ClickHouse, të dhënat e paagreguara janë pikërisht skenari për të cilin është krijuar. Nëse e përdorni ClickHouse për të dhënat e paagreguara, atëherë po bëni gjithçka siç duhet. Nëse po agregoni, atëherë ndonjëherë mund të falet.
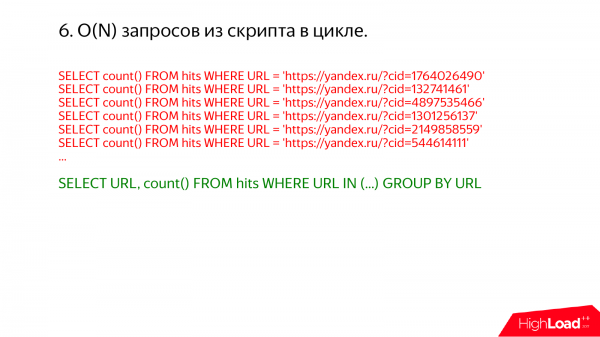
Një rast tjetër interesant është ky i kërkesave në një cikël të pafund. Herë pas here hyj në një server prodhimi dhe shoh për proceset. Dhe çdo herë zbuloj se ndodhin gjëra të tmerrshme.
Për shembull, këto. Këtu menjëherë është e qartë se mund të ishte bërë gjithçka në një kërkesë. Thjesht shkruani atje url in dhe listën.
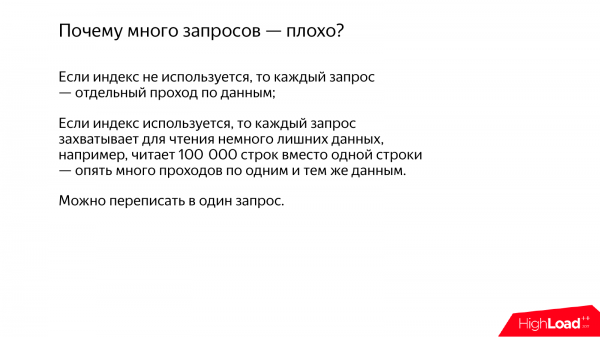
Pse shumë nga këto kërkesa në një cikël të pafund janë të këqija? Nëse indeksi nuk përdoret, do të keni shumë kalime për të njëjtat të dhëna. Por nëse indeksi përdoret, për shembull, keni një çelës primar sipas ru dhe shkruani url = diçka. Dhe mendoni se do të lexohet saktësisht nga tabela një url, do të jetë gjithçka në rregull. Por në të vërtetë nuk është. Sepse ClickHouse bën gjithçka në grupe.
Kur ai duhet të lexojë një gamë të caktuar të të dhënave, lexon pak më shumë, sepse indeksi në ClickHouse është i rrallë. Ky indeks nuk lejon të gjesh një rresht të veçantë në tabelë, vetëm një gamë të caktuar. Të dhënat kompresohen në blloqe. Për të lexuar një rresht, duhet të marrësh tërë një bllok dhe ta dekompresosh. Dhe nëse bën shumë kërkesa, do të kesh shumë përputhje të tilla, dhe shumë punë do të kryhet përsëri e përsëri.
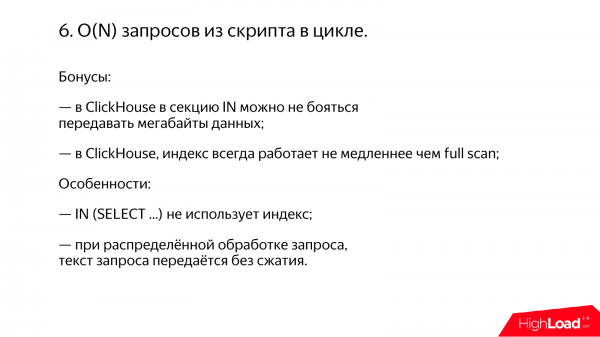
Dhe si një bonus mund të vëreni se në ClickHouse nuk duhet të keni frikë të dërgoni madje megabajt dhe madje qindra megabajt në seksionin IN. E mbaj mend nga praktika jonë, se nëse në MySQL dërgojmë shumë vlera në seksionin IN, për shembull, dërgojmë aty 100 megabajt të disa numrave, MySQL konsumon 10 gigabajt memorie dhe më shumë nuk ndodh asgjë, gjithçka funksionon keq.
Dhe e dyta – është se në ClickHouse, nëse kërkesat tuaja përdorin indeksin, atëherë kjo është gjithmonë jo më ngadalë se skenimi i plotë, domethënë, nëse duhet të lexosh pothuajse të gjithë tabelën, do të shkojë radhazi dhe do të lexojë të gjithë tabelën. Në përgjithësi, ai do të merret me të vetë.
Por megjithatë ka disa vështirësi. Për shembull, që IN me nënkërkesë nuk përdor indeksin. Por kjo është problemi ynë dhe duhet ta rregullojmë. Nuk ka asgjë themelore këtu. Do ta rregullojmë.
Dhe një gjë tjetër interesante – është se nëse keni një kërkesë shumë të gjatë dhe përpunimi i kërkesave është i shpërndarë, atëherë kjo kërkesë shumë e gjatë do të dërgohet në çdo server pa kompresim. Për shembull, 100 megabajt dhe 500 serverë. Dhe, për pasojë, do të transmetohen 50 gigabajt për rrjet. Do të dërgohet dhe pastaj gjithçka do të ekzekutohet me sukses.
* tashmë e përdor; gjithçka e riparuar, siç ishte premtuar.
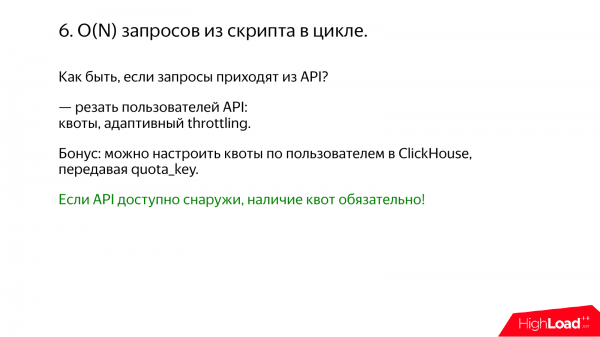
Dhe një rast mjaft i zakonshëm është nëse kërkesat vijnë nga API. Për shembull, ju keni krijuar një shërbim tuajin. Dhe nëse shërbimi juaj është i nevojshëm për dikë, atëherë keni hapur API dhe tashmë brenda dy ditësh shihni se po ndodh diçka e paqartë. Të gjitha janë të mbingarkuara dhe disa kërkesa të tmerrshme po vijnë, të cilat kurrë nuk duhet të ishin.
Dhe zgjidhja është një. Nëse keni hapur API, atëherë do t'ju duhet ta kufizoni atë. Për shembull, të vendosni kuota të ndryshme. Nuk ka mundësi të tjera normale. Nëse jo, menjëherë do të shkruajnë një skript dhe do të keni probleme.
Në ClickHouse ka një mundësi të veçantë – është numërimi i kuotave. Madje, mund të kaloni çelësin tuaj të kuotave. Kjo, për shembull, është identifikuesi i brendshëm i përdoruesit. Dhe kuotat do të llogariten në mënyrë të pavarur për secilin prej tyre.
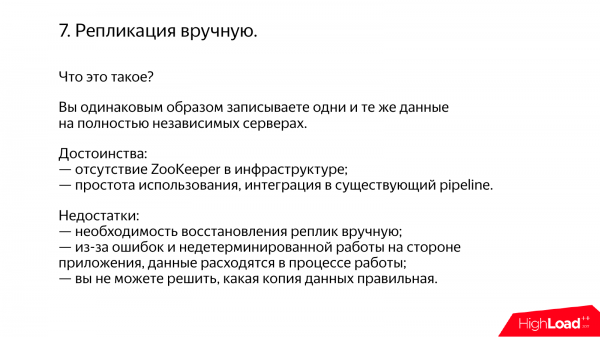
Tani ka një gjë tjetër interesante. Kjo është replikimi me manual.
Di shumë raste kur, pavarësisht se ClickHouse ka mbështetje të integruar për replikimin, njerëzit replikojnë ClickHouse manualisht.
Cili është parimi? Keni një pipeline për procesimin e të dhënave. Dhe ai punon në mënyrë të pavarur, për shembull, në qendrat e të dhënave të ndryshme. Regjistroni të dhëna të njëjta në ClickHouse në mënyrë të njëjtë. Sidoqoftë, praktika tregon se të dhënat ende do të shpërndahen për shkak të disa veçorive në kodin tuaj. Shpresoj që jo në kodin tuaj.
Dhe periodikisht do të duhet ta sinkronizoni manualisht. Për shembull, një herë në muaj administratoret bëjnë rsync.
Në të vërtetë, është shumë më e thjeshtë të përdorni replikimin e integruar në ClickHouse. Por këtu mund të ketë disa kundërshtime, sepse për këtë duhet të përdorni ZooKeeper. Nuk do të flas ndonjë gjë të keqe për ZooKeeper, në parim, sistemi funksionon, por ka raste kur njerëzit nuk e përdorin për shkak të frikës nga Java, sepse ClickHouse është një sistem i shkëlqyer i shkruar në C++, të cilin mund ta përdorni dhe gjithçka do të shkojë mrekullisht. Ndërsa ZooKeeper është në Java. Dhe ndonjëherë nuk dëshiron ta shikosh, por mund të përdorësh replikimin me manual.
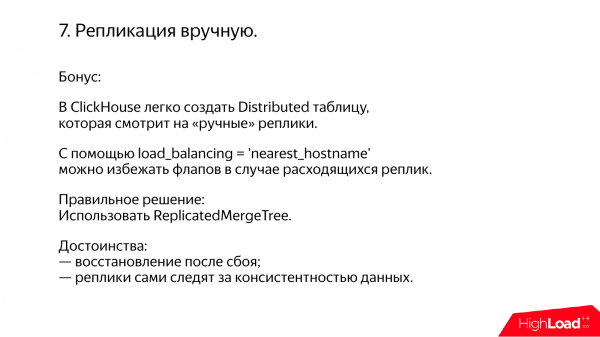
ClickHouse është një sistem praktik. Ai merr parasysh nevojat tuaja. Nëse keni replikim manual, mund të krijoni një tabelë të Distribuar që shikon replikat tuaja manuale dhe automatikisht bën failover mes tyre. Dhe ka madje një opsion të veçantë që lejon shmangien e flukseve, edhe nëse replikat tuaja shpërndahen sistematikisht.
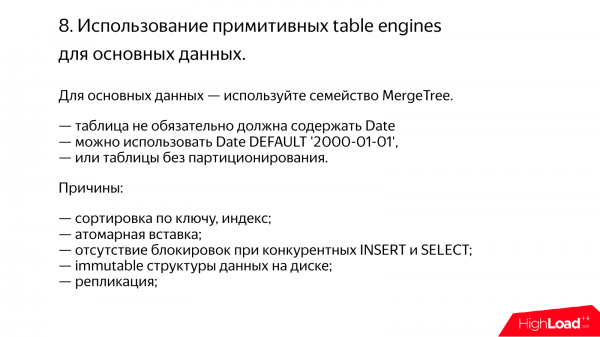
Më pas mund të ketë probleme nëse përdorni mjete tabelash primitive. ClickHouse është një ndërtues i tillë, në të cilin ka shumë engine tabelash të ndryshme. Për të gjitha rastet serioze, siç shkruhet në dokumentacion, përdorni tabelat e familjes MergeTree. Ndërsa të gjitha të tjerat – janë kështu, për raste të veçanta ose për teste.
Në tabelën MergeTree nuk është e nevojshme të keni ndonjë datë dhe orë. Mund ta përdorni gjithsesi. Nëse nuk ka datë dhe orë, shkruani se default është viti 2000. Kjo do të funksionojë dhe nuk do të kërkojë burime.
Në versionin e ri të serverit, ju mund të specifikoni madje që të keni një ndarje të personalizuar pa çelësin e ndarjes. Kjo do të jetë e njëjtë.
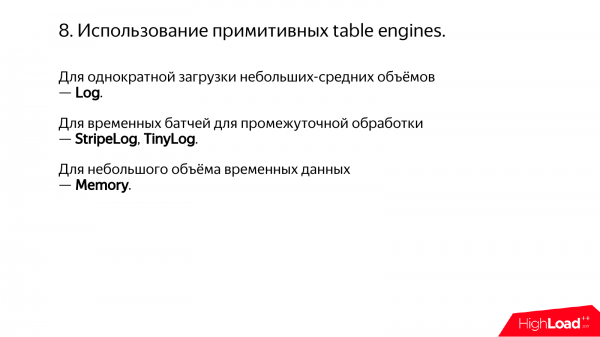
Nga ana tjetër, mund të përdorni engine të thjeshtë tabelash. Për shembull, ngarkoni të dhënat një herë dhe shihni, provoni dhe fshini. Mund të përdorni Log.
Ose ruajtja e volumit të vogël për përpunim të përkohshëm – kjo është StripeLog ose TinyLog.
Memory mund të përdoret, nëse volumi i të dhënave është i vogël dhe thjesht të provoni diçka në RAM.
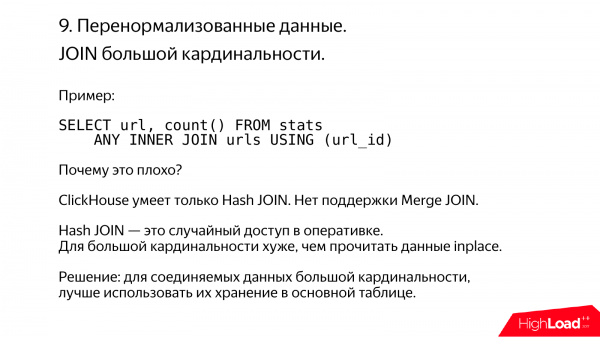
ClickHouse nuk e pëlqen shumë të dhënat e tepruar normalizuar.
Ja një shembull tipik. Kjo është një sasi e madhe URL-sh. I keni vendosur ato në një tabelë fqinje. Dhe pastaj vendosët të bëni JOIN me to, por kjo nuk do të funksionojë në përgjithësi, sepse ClickHouse mbështet vetëm Hash JOIN. Nëse nuk ka mjaft RAM për shumë të dhëna që duhet të bashkohen, atëherë JOIN nuk do të funksionojë.
Nëse të dhënat kanë kardinalitet të madh, atëherë mos u shqetësoni, ruani ato në një format denormalizuar, URL-të direkt në tabelën kryesore.
* tani në ClickHouse ka edhe merge join dhe ai funksionon në kushte kur të dhënat për intermediary nuk përputhen në RAM. Por kjo nuk është efikase dhe rekomandimi mbetet në fuqi.
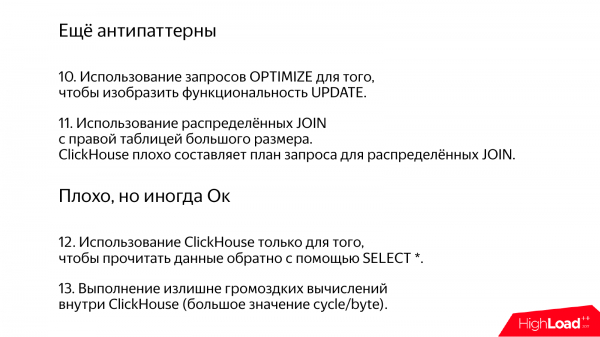
Edhe disa shembuj të tjerë, por tashmë dyshoj nëse ata janë antipattern.
Në ClickHouse ka një disavantazh të njohur. Ai nuk mbështet azhurnime. Në një farë kuptimi, kjo është edhe e mirë. Nëse keni disa të dhëna të rëndësishme, për shembull, llogaritarinë, askush nuk do të mund t'i dërgojë, sepse nuk ka azhurnime.
* mbështetje për azhurnim dhe fshirje në regjimin batch është shtuar prej kohësh.
Por ka disa mënyra speciale, që lejojnë azhurnimet siç do të ishin në sfond. Për shembull, tabelat e tipit ReplaceMergeTree. Ato bëjnë azhurnime gjatë bashkimeve në sfond. Mund ta forconi këtë nëpërmjet optimize table. Por mos e bëni këtë shumë shpesh, sepse do të përbëjë ripërpunim të plotë të ndarjes.
JOIN të shpërndara në ClickHouse – gjithashtu nuk trajtohen mirë nga planifikuesi i kërkesave.
E keqe, por ndonjëherë është në rregull.
Përdorimi i ClickHouse vetëm për të lexuar të dhënat përmes select.
Nuk e doja të rekomandoj të përdorësh ClickHouse për llogaritje të mëdha. Por nuk është pikërisht kështu, sepse ne tashmë po largohemi nga kjo rekomandim. Dhe së fundmi, kemi shtuar mundësinë për të aplikuar modele të mësimit të makinerisë në ClickHouse – Catboost. Dhe kjo më shqetëson, sepse mendoj: "Çfarë tmerri. Sa shumë cikle për bajt del?!". Më vjen shumë keq t’i harxhoj ciklet për bajta.
Por mos ki frikë, instaloj ClickHouse, gjithçka do të shkojë mirë. Nëse ndodh ndonjë gjë, kemi një komunitet. Me të vërtetë, komuniteti – jeni ju. Dhe nëse keni ndonjë problem, mund të hyni në bisedën tonë, dhe shpresoj që do t'ju ndihmojnë.
Pyetje
Faleminderit për prezantimin! Ku mund të ankohem për rënien e ClickHouse?
Mund të ankohesh personalisht tek unë në këtë moment.
Sapo kam filluar të përdor ClickHouse. Menjëherë e kam rrëzuar interfacin cli.
Të lumtë.
Pak më vonë e kam rrëzuar serverin me një selektor të vogël.
Ke talent.
Kam hapur një bug në GitHub, por e kanë injoruar.
Të shohim.
Aleksej më çoi me mashtrim në prezantim, duke më premtuar se do të tregonte se si e comproni të dhënat brenda.
Shumë thjeshtë.
Këtë e kuptova që dje. Më shumë konkretësi.
Nuk ka ndonjë hile të tmerrshme. Thjesht është kompresim me blloqe. Në mënyrë default përdoret LZ4, mund të aktivizosh ZSTD*. Blloqet janë nga 64 kilobajt deri në 1 megabajt.
*ka gjithashtu mbështetje për kodekët e specializuar të kompresimit, të cilat mund të përdoren në zinxhir me algoritme të tjera.
A janë të dhënat në blloqe thjesht të papërpunuara?
Jo krejtësisht të papërpunuara. Ka lista. Nëse ke një kolonë numerike, atje numrat janë renditur radhazi në një listë.
Kuptohet.
Aleksej, shembulli që ishte me uniqExact mbi IP-të, pra, ajo që uniqExact llogaritet më ngadalë mbi stringje sesa mbi numra dhe kështu me radhë. Dhe nëse ne përdorim një ndërrim dhe do të kthejmë në momentin e leximit? Pra, ju duket se thatë se në disk nuk dallon shumë. Nëse ne lexojmë stringje nga disku, kthejmë, a do të kemi më shpejt agregatët apo jo? Apo ndoshta gjithsesi do të fitojmë pak këtu? Më duket se e keni testuar këtë, por për ndonjë arsye nuk e keni përmendur në benchmarking.
Mendoj se do të jetë më i ngadalshëm se sa pa kast. Në këtë rast, duhet të shpërndajmë adresën IP nga stringu. Sigurisht, në ClickHouse, shpërndarja e adresave IP është optimizuar gjithashtu. Ne kemi punuar shumë për këtë, por atje ju keni numrat të shkruar në formën e dhjetë mijëshit. Shumë e pakëndshme. Nga ana tjetër, funksioni uniqExact do të punojë më ngadalë mbi stringje jo vetëm sepse janë stringje, por gjithashtu për shkak se zgjidhet një specializim tjetër i algoritmit. Stringjet thjesht përpunohen ndryshe.
Dhe nëse marrim një tip më primitiv të të dhënave? Për shembull, shkruam user id, që kemi brenda, e shkruam si string, dhe pastaj e kastojmë, do të jetë më argëtuese apo jo?
Kam dyshime. Mendoj se do të jetë edhe më trishtues, sepse të shpërndash numrat është një problem serioz. Më duket se ky kolegu kishte madje një referat mbi temën se sa e vështirë është të shpërndash numrat në formën e dhjetë mijëshit, ndoshta jo.
Alexey, faleminderit shumë për referatin! Dhe gjithashtu faleminderit shumë për ClickHouse! Kam një pyetje në lidhje me planet. A ka ndonjë plan për një karakteristikë që lejon përditësimin e fjalorëve jo plotësisht?
Pra, një ri-ngarkim të pjesshëm?
Po, po. Një mundësi për të caktuar aty një fushë MySQL, pra, për të përditësuar pas, që të ngarkohet vetëm këto të dhëna, nëse fjalori është shumë i madh.
Një karakteristikë shumë interesante. Dhe, më duket, ndonjë njeri e kishte propozuar atë në bisedën tonë. Ndoshta ishit ju.
Nuk mendoj se isha unë.
Shkëlqyeshëm, tani del se janë dy kërkesa. Dhe mund të filloni ngadalë. Por menjëherë dëshiroj t'ju paralajmëroj se kjo karakteristikë është mjaft e thjeshtë për t'u zbatuar. Pra, në ide, duhet thjesht të shkruani numrin e versionit në tabelë dhe pastaj të shkruani: versioni është më i vogël se kaq. Dhe kjo do të thotë se, shumë për fat, ne do t'ua propozojmë këtë entuziastëve. A jeni entuziast?
Po, por fatkeqësisht, jo në C++.
A e dinë kolegët tuaj të shkruajnë në C++?
Do të gjej dikë.
Shkëlqyeshëm*.
* mundësia u shtua dy muaj pas referatit – e zhvilloi autori i pyetjes dhe dërgoi kërkesën e tij për tërheqje .
Faleminderit!
Përshëndetje! Faleminderit për raportin! Ju përmendët se ClickHouse konsumon shumë mirë të gjitha burimet që ka në dispozicion. Dhe folësi pranë Luksoft përmendi zgjidhjen e tij për Postën e Rusisë. Ai tha se u pëlqeu shumë ClickHouse, por nuk e përdorën atë kundër konkurentit të tyre kryesor pikërisht sepse konsumonte gjithë procesorin. A ka ndonjë mundësi për ta kufizuar ClickHouse-n që të mos konsumojë gjithçka që i ofrohet?
Po, është e mundur dhe shumë e lehtë. Nëse dëshironi që të konsumoni më pak bërthama, thjesht shkruani set max_threads = 1. Dhe gjithçka, do të ekzekutojë kërkesën në një bërthamë. Madje mund të tregoni përdoruesve të ndryshëm këtë konfigurim të ndryshëm. Prandaj, nuk ka probleme. Dhe ju lutem, përcillni kolegëve nga Luksoft që nuk është mirë që nuk gjetën këtë përbërës në dokumentacion.
Aleks, përshëndetje! Doja të pyesja një pyetje të tillë. Nuk është hera e parë që dëgjoj se shumë fillojnë ta përdorin ClickHouse si depo për log-et. Në raportin tuaj thatë se nuk duhet ta bëjmë këtë, pra nuk është mirë të ruajmë rreshta të gjatë. Çfarë mendoni për këtë?
Së pari, log-et zakonisht nuk janë rreshta të gjatë. Natyrisht, ndodhin përjashtime. Për shembull, ndonjë shërbim i shkruar në java hedh një exception, dhe ai regjistrohet. Dhe kështu në një cikël të pafund, dhe skadon hapësira në diskun e fortë. Zgjidhja është shumë e thjeshtë. Nëse rreshtat janë shumë të gjatë, thjesht prisni ato. Po çfarë do të thotë të gjatë? Dhjetëra kilobyte – është e keqe*.
* në versionet e reja të ClickHouse, është përfshirë "granulimi adaptiv i indeksit", që zgjidh shumicën e problemeve të ruajtjes së rreshtave të gjatë.
Dhe një kilobyte – është në rregull?
Në rregull.
Përshëndetje! Faleminderit për raportin! Unë tashmë e kam pyetur për këtë në chat, por nuk e mbaj mend nëse kam marrë përgjigje. A është planifikuar të zgjerohet ndonjëherë seksioni WITH në mënyrën e CTE?
Tani për tani jo. Seksioni WITH për ne është paksa jo serioz. Ajo është si një funksion i vogël.
E kuptova. Faleminderit!
Faleminderit për raportin! Shumë interesante! Një pyetje globale. A është planifikuar të bëhet, ndoshta, një modifikim për fshirjen e të dhënave në formën e disa zëvendësimeve?
Patjetër. Kjo është detyra jonë e parë në listën tonë. Ne tani jemi duke menduar aktivisht se si të bëjmë gjithçka siç duhet. Dhe është koha për të filluar të godasim tastierën*.
* keni shtypur butonat në tastierë dhe keni bërë gjithçka.
A do të ketë ndikim në performancën e sistemit apo jo? A do të jetë futja po aq e shpejtë si tani?
Ndoshta vetë deletes, vetë updates do të jenë shumë të rënda, por kjo nuk do të ndikoje aspak në performancën e selects dhe performancën e inserts.
Dhe një pyetje e vogël. Në prezantim përmendët për primary key. Pra, kemi partiocionim që është mujor me default, e saktë? Dhe kur vendosim një interval datash që bie brenda një muaji, atëherë lexojmë vetëm këtë partiocion, e saktë?
Po.
Një pyetje e tillë. Nëse nuk mund të dallojmë ndonjë primary key, a është e saktë të bëhet pikërisht në fushën "Data" për të pasur një riorganizim më të vogël të këtyre të dhënave në sfond që të rregullohen më mirë? Nëse nuk keni kërkesa në interval dhe as nuk mund të zgjidhni ndonjë çelës primar, a vlen të futni datën në çelësin primar?
Po.
Ndoshta ka kuptim të vendosni në çelësin primar një fushë për të cilën të dhënat do të comprimojnë më mirë, nëse janë të renditura sipas kësaj fushe. Për shembull, identifikuesi i përdoruesit. Përdoruesi, për shembull, viziton të njëjtin website. Në këtë rast vendosni id-në e përdoruesit dhe kohën. Dhe kështu të dhënat tuaja do të comprimojnë më mirë. Sa i përket dates, nëse me të vërtetë nuk keni dhe kurrë nuk keni kërkesa në interval për datat, atëherë mund të mos e vendosni datën në çelësin primar.
Mirë, shumë faleminderit!
Burimi: habr.com
