

Kërkimi i varësive funksionale në të dhëna zbatohet në drejtim të ndryshëm të analizës së të dhënave: menaxhimi i bazave të të dhënave, pastrimi i të dhënave, inxhinieria revers e bazave të të dhënave dhe eksplorimi i të dhënave. Ne tashmë kemi publikuar për vetë varësitë. Anastasia Birillo dhe Nikita Bobrov. Këtë herë, Anastasia — një diplomante e Qendrës për Shkencat e Kompjuterit të këtij viti — ndan zhvillimin e këtij punimi brenda NIR, që ajo e mbrojti në qendër.
Zgjedhja e detyrës
Gjatë studimeve në qendrën CS, fillova të studioj në thellësi bazat e të dhënave, në veçanti, kërkimin e varësive funksionale dhe diferenciale. Kjo temë ishte e lidhur me temën e kursit tim në universitet, kështu që gjatë punës mbi kursin fillova të lexoj artikuj për varësi të ndryshme në bazat e të dhënave. Kam shkruar një përmbledhje të kësaj fushe — një nga punimet e mia të para. në gjuhën angleze dhe e dërgova në konferencën SEIM-2017. Ishte një kënaqësi e madhe kur mësova se ishte pranuar, dhe vendosa të thellohem në temë. Koncepti vetë nuk është i ri — u aplikua për herë të parë në vitet '90, por ende gjen përdorim në shumë fusha.
Në semestrin e dytë të studimeve në qendër, fillova një projekt kërkimor për përmirësimin e algoritmeve të kërkimit të varësive funksionale. Punova mbi të sëbashku me doktorantin e SPbGU, Nikita Bobrov, në bazën e JetBrains Research.
Kostoja kompjuterike e kërkimit të varësive funksionale.
Problemi kryesor — kostoja kompjuterike. Numri maksimal i varësive minimale dhe jo-triviale është i kufizuar me vlerën  index
 — numri i atributeve të tabelës. Koha e ekzekutimit të algoritmeve varet jo vetëm nga numri i atributeve, por edhe nga numri i rreshtave. Në vitet '90, algoritmet për kërkimin e varësive funksionale në një PC të zakonshëm mund të përpunonin grupe të dhënash që përmbanin deri në 20 atribute dhe dhjetra mijëra rreshta, për disa orë. Algoritmet moderne, që punojnë në procesorë me shumë bërthama, zbulojnë varësi për grupe të dhënash që përmbajnë qindra atribute (deri në 200) dhe qindra mijëra rreshta, afërsisht në të njëjtin kohë. Megjithatë, kjo nuk është e mjaftueshme: një kohë e tillë është e papranueshme për shumicën e aplikacioneve reale. Prandaj, ne zhvilluam qasje për të përshpejtuar algoritmet ekzistuese.
Skemat e ruajtjes për ndërprerjen e particioneve.
Në pjesën e parë të punës, ne zhvilluam skemat e caching për klasën e algoritmeve që përdorin metodën e ndërprerjes së particioneve. Një particion për një atribut përfaqëson një grup listash, ku secila listë përmban numrat e rreshtave me vlera të njëjta për këtë atribut. Çdo listë e tillë quhet klaster. Shumë algoritme bashkëkohore përdorin partitë për të përcaktuar nëse mbahen varësi apo jo, dhe ata specifikojnë lemën: Varësia  ruhet nëse
 . Këtu
 përcaktohet particioni dhe përdoret koncepti i madhësisë së particionit - numri i klastereve në të. Algoritmet që përdorin partitë, kur varësia është shkelur, shtojnë atributet shtesë në pjesën e majtë të varësisë, pas së cilës e ripërcaktojnë atë duke kryer operacionin e ndërprerjes së particioneve. Ky operacion në artikuj quhet specializim. Por ne vërejtem se partitë për varësi që do të mbahen vetëm pas disa raundesh specializimi, mund të përdoren aktivisht, çka mund të reduktojë ndjeshëm kohën e punës së algoritmeve, pasi operacioni i ndërprerjes është i shtrenjtë.
Prandaj ne propozoi një heuristikë, e cila bazohet në Entropinë e Shannon-it dhe pasigurinë e Ginny-t, si dhe në metrikën tonë që e quam Entropi e Kundërt. Ajo është një modifikim i vogël i Entropisë së Shannon-it dhe rritet ndërsa rritet unikësia e grupit të dhënave. Heuristika e propozuar duket si më poshtë:

Këtu  — niveli i unikësisë së particionit që sapo është llogaritur
 , ndërsa
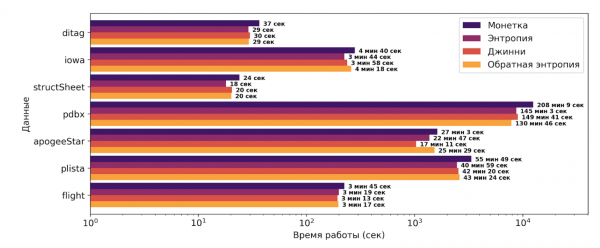
 është një metrikë mediane për shkallën e unikateve për atribute të veçanta. Si metrikë unikate janë provuar të tre metrikat e përmendura më lart. Gjithashtu, mund të vihet re se në heuristikë ka dy modifikatorë. I pari tregon se sa afër është ndarja aktuale me çelësin primar dhe lejon që të cache-ojmë më shumë ato ndarjet që janë larg çelësit potencial. Modifikatori i dytë lejon të monitorohet ngarkesa e cache-it dhe kështu inkurajon shtimin e më shumë ndarjesh në cache kur ka hapësirë të lirë. Zgjidhja e suksesshme e këtij problemi ka lejuar të përshpejtohet algoritmi PYRO me 10-40% varësisht nga dataset-i. Duhet vlerësuar se algoritmi PYRO është më i suksesshmi në këtë fushë.
Në diagramin më poshtë mund të shihni rezultatet e aplikimit të heuristikës së propozuar në krahasim me qasjen bazë të cache-it, e cila bazohet në hedhjen e një monedhe. Osi X është logaritmik.
Mënyra alternative e ruajtjes së ndarjeve
Thenë ne propozuam një mënyrë alternative për ruajtjen e ndarjeve. Ndarjet përfaqësojnë një grup klasteresh, ku secili përmban numrat e tuple-ve me vlera të njëjta për atribute të caktuara. Këta klasterë mund të përmbajnë sekuenca të gjata numrash të tuple-ve, për shembull, nëse të dhënat në tabelë janë të renditura. Prandaj, ne propozuam një skemë kompresimi për ruajtjen e ndarjeve, e cila është ruajtja intervalore e vlerave në klasterët e ndarjeve:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Intervalli~e~parë}, underbrace{7, 8}_{Intervalli~i~dytë}, 10}}\ downarrow{Kompresimi}\ pi(X) = {{underbrace{$, 1, 5}_{Intervalli~e~parë}, underbrace{7, 8}_{Intervalli~i~dytë}, 10}}$$display$$
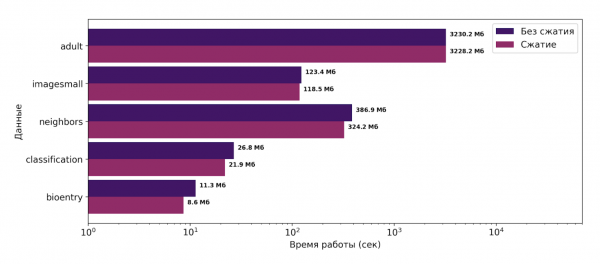
Kjo metodë arriti të zvogëlojë konsumimin e memories gjatë punës së algoritmit TANE nga 1 deri në 25%. Algoritmi TANE është një algoritëm klasik për zbuluar FD-të, ai përdor ndarjet gjatë procesit të tij. Për praktikën, u zgjodh konkretisht algoritmi TANE, pasi implementimi i ruajtjes intervalore ishte shumë më i lehtë se, për shembull, në PYRO, për të vlerësuar nëse qasja e propozuar funksionon. Rezultatet e marra paraqiten në diagramin më poshtë. Osi X është logaritmik.
Konferenca ADBIS-2019
Sipas rezultatave të studimit në Shtator 2019, unë kam prezantuar një artikull në konferencën 23rd European Conference on Advances in Databases and Information Systems (ADBIS-2019). Gjatë fjalës së tij, punimin e përmendi Bernhard Thalheim, një personazh i rëndësishëm në fushën e bazave të të dhënave. Rezultatet e kërkimeve shërbyen si bazë për disertacionin tim në masterin e matematikës dhe mekanikës në SPbGU, gjatë të cilit të dy qasjet e sugjeruara (kapja në cache dhe kompresimi) u implementuan në të dy algoritmet: TANE dhe PYRO. Në këtë rast, rezultatet treguan se qasjet e propozuara janë universale, pasi në të dy algoritmet me të dy qasjet u vërejt një reduktim të dukshëm të memories së përdorur, si dhe një reduktim të ndjeshëm të kohës së ekzekutimit të algoritmeve.
Burimi: habr.com
