

Duke vazhdojmë temën e regjistrimit të flukseve të mëdha të të dhënave, e ngritur , në këtë do të shqyrtojmë mënyrat me të cilat mund të ulet "masa fizike" e të dhënave të ruajtura në PostgreSQL, dhe ndikimi i tyre në performancën e serverit.
Bëhet fjalë për konfigurimet TOAST dhe-alignimin e të dhënave. "Në mesatarë" këto metoda do të kursejnë jo shumë burime, por — krejtësisht pa modifikimin e Kodit të aplikacionit.
Megjithatë, përvoja jonë ka rezultuar mjaft produktive në këtë drejtim, pasi depozita e pothuajse çdo monitorimi nga natyra e saj është pjesërisht append-only nga pikëpamja e të dhënave të regjistruara. Dhe nëse ju intereson se si mund të mësoni bazën për të shkruar në disk në vend të 200MB/s gjysmë më pak — ju lutemi ndiqni më poshtë.
Sekretet e vogla të të dhënave të mëdha
Në përputhje me profilin e punës , ai rregullisht merr nga log-et paketa teksti.
Dhe pasi , të cilat Baza të Dhënash ne monitorojmë — është një produkt me shumë komponente me struktura të komplikuara të të dhënave, atëherë edhe kërkesat për të arritur performancën maksimale po rezultojnë mjaft . Pra, edhe volumi i çdo instancë të veçantë të kërkesës ose planit rezultues të ekzekutimit në log-un që vjen tek ne është "në mesatarë" mjaft i madh.
Le të shohim strukturën e njërit nga tabelat, në të cilën ne shkruajmë të dhënat "e papërpunuara" — domethënë këtu është teksti origjinal nga regjistrimi i logut:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- çelësi i seksionit
    date
, data -- më e rëndësishmja
    text
, PRIMARY KEY(pack, recno)
);
Një tabelë tipike e tillë (e seksionuar pa dyshim, prandaj kjo është një model seksioni), ku më e rëndësishmja është—tekstin. Ndonjëherë mjaft voluminoze.
Le të kujtojmë se "masa fizike" e një regjistrimi në PG nuk mund të zërë më shumë se një faqe të dhënash, por "masa logjike" — është një çështje krejt tjetër. Për të shkruar një vlerë voluminoze në fushë (varchar/text/bytea) përdoret :
PostgreSQL përdor një madhësi page fikse (zakonisht 8 KB) dhe nuk lejon që tuple të zënë më shumë se një faqe. Prandaj, ruajtja e vlerave të mëdha të fushave nuk është e mundur. Për të kapërcyer këtë kufizim, vlerat e mëdha të fushave kompresohen dhe/ose ndahen në disa rreshta fizikë. Kjo ndodh pa u vënë re nga përdoruesi dhe ndikon minimalisht në pjesën më të madhe të kodit të serverit. Ky metodë njihet si TOAST …
Në fakt, për çdo tabelë me «fusha potencialisht të mëdha» automatikisht të çdo regjistrimi «të madh» me segmente prej 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Domethënë, nëse na duhet të shkruajmë një rresht me një vlerë «të madhe» data, regjistrimi real do të ndodhi jo vetëm në tabelën kryesore dhe PK-në e saj, por edhe në TOAST dhe PK-në e tij.
Të zvogëlojmë ndikimin e TOAST
Por shumica e regjistrimeve tona nuk janë kaq të mëdha, në 8KB duhet të përfshihen — si mund ta kursejmë këtë?..
Këtu vjen në ndihmë atributi i kolonës së tabelës:
- EXTENDED lejon si kompresimin ashtu edhe ruajtjen e veçantë. Ky është opsioni standard për shumicën e llojeve të të dhënave që janë të përputhshme me TOAST. Fillimisht bëhet një përpjekje për të realizuar kompresimin, pastaj — ruajtja jashtë tabelës, nëse rreshti është ende shumë i madh.
- MAIN lejon kompresimin, por jo ruajtjen e veçantë. (Në të vërtetë, ruajtja e veçantë do të kryhet për këto kolona, por vetëm si një masë ekstreme, kur nuk ka mënyrë tjetër për të zvogëluar rreshtin në mënyrë që të përfshihej në faqe.)
Në të vërtetë, kjo është pikërisht ajo që na nevojitet për tekstin — të kompresojmë sa më shumë të jetë e mundur dhe nëse nuk është e mundur — ta transferojmë në TOAST. Kjo mund të bëhet direkt "në flakë", me një komandë:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Si të vlerësojmë efektin
Duke qenë se çdo ditë fluksi i të dhënave ndryshon, nuk mund të krahasojmë numrat absolutë, por në relative, sa më pak pjesë e kemi shkruar në TOAST — aq më mirë. Por këtu ka një rrezik — sa më shumë të jetë "sasia fizike" e çdo regjistrimi të veçantë, aq më "e gjerë" bëhet indeksi, sepse duhet të mbulojë më shumë faqe të dhënash.
Seksioni para ndryshimeve:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Seksioni pas ndryshimeve:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Në të vërtetë, ne filluam të shkruajmë në TOAST dy herë më rrallë, e cila jo jo diskun, por po CPU:
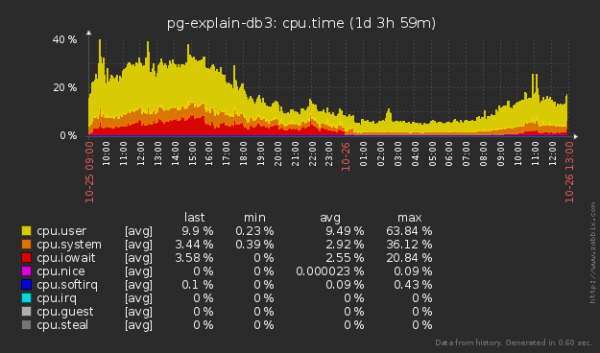
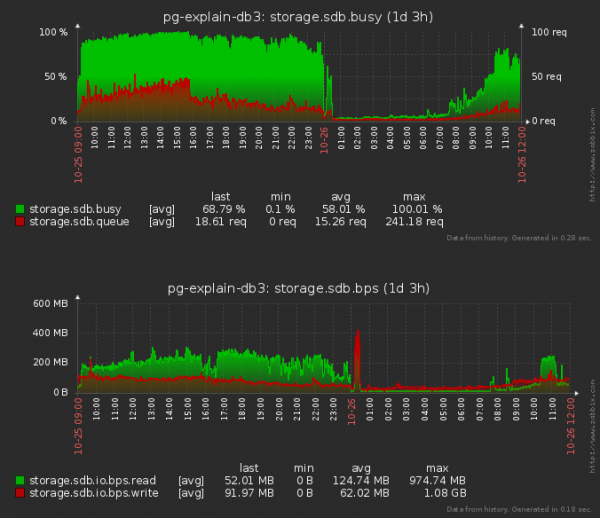
Dua të theksoj se tani ne po "lexojmë" dhe diskun më pak, jo vetëm "shkruajmë" - sepse kur shtojmë një shënim në ndonjë tabelë, na nevojitet "leximi" gjithashtu i një pjese të pemës për çdo indeks për të përcaktuar pozicionin e saj të ardhshëm në to.
Kujt i përshtatet PostgreSQL 11
Pas përditësimit në PG11 vendosëm të vazhdojmë "tuning" TOAST dhe vëmendëm se që nga kjo version u bë i disponueshëm për konfigurimin e parametrave :
Kodi i përpunimit TOAST aktiveohet vetëm kur vlera e rreshtit që duhet të ruhet në tabelë është më e madhe se TOAST_TUPLE_THRESHOLD bajt (zakonisht 2 KB). Kodi TOAST do të kompresojë dhe/ose do të transferojë vlerat e fushës jashtë tabelës derisa vlera e rreshtit të bëhet më e vogël se TOAST_TUPLE_TARGET bajt (vlerë që ndryshon, gjithashtu zakonisht 2 KB) ose do të jetë e pamundur të zvogëlohet.
Ne vendosëm që të dhënat tona zakonisht janë ose "në të vërtetë të shkurtra" ose menjëherë "të gjata", prandaj vendosëm të kufizohemi në vlerën më minimale të mundshme:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Le të shohim se si ndikuan konfigurimet e reja në ngarkesën e diskut pas riparimit:
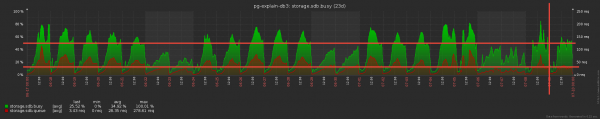
Mjaft mirë! Mesatarja e radhës ndaj diskut u reduktua përafërsisht 1.5 herë, dhe "zënia" e diskut - rreth 20%! Por ndoshta, ndonjëherë ka pasur ndikim në CPU?
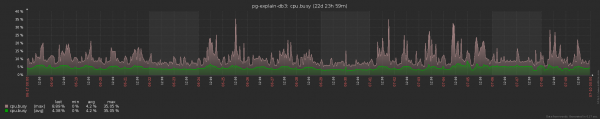
Të paktën, nuk ka përmirësuar për keq. Megjithatë, është e vështirë të gjykohet, për shkak se kështu volumet nuk mund të ngjallin mesataren e ngarkesës së CPU mbi 5%.
Ndryshimi i rendit të shuma… ndryshon!
Siç dihet, një qindarkë ruan një rubel, dhe me volumet tona të ruajtjes për rreth 10TB/muaj madje edhe një optimizim i vogël mund të sillte një profit të mirë. Prandaj, ne e kemi përqendruar vëmendjen tonë në strukturën fizike të të dhënave tona - konkretisht "mbushja" e fushave brenda shënimit të çdo tabele.
Sepse për shkak të kjo drejtpërdrejt :
Shumë arkitektura parashikojnë rreshtimin e të dhënave sipas kufijve të fjalëve makinerike. Për shembull, në një sistem 32-bit x86 numerat e plotë (tipi integer, zë 4 bajt) do të rreshtohen në kufirin e fjalëve 4-bajtëshe, ashtu si numrat me pikë të dyfishtë (tipi double precision, 8 bajt). Ndërsa në një sistem 64-bit, vlerat double do të rreshtohen në kufirin e fjalëve 8-bajtëshe. Kjo është një tjetër arsye për moskompatibilitet.
Për shkak të rregullimit, madhësia e rreshtit të tabelës varet nga rendi i vendosjes së fushave. Në përgjithësi, ky efekt nuk është shumë i dukshëm, por në disa raste ai mund të çojë në një rritje të konsiderueshme të madhësisë. Për shembull, nëse fusha të tipit char(1) dhe integer vendosen ndaras, zakonisht do të humbin 3 byte më kot.
Le të fillojmë me modele sintetike:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 byte

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 byte
Nga ku erdhën disa byte të tepruar në rastin e parë? E thjeshtë — smallint me 2 byte rregullohet në kufirin me 4 byte para fushës tjetër, ndërsa kur është e fundit — nuk ka nevojë për rregullim.
Në teori — gjithçka është mirë dhe fushat mund të riorganizohen siç dëshirohen. Le të kontrollojmë me të dhëna reale për shembullin e një nga tabelave, sekzioni ditor të cilit i nevojiten 10-15GB.
Struktura fillestare:
CREATE TABLE public.plan_20190220
(
-- Trashëguar nga tabela plan:  pack uuid NOT NULL,
-- Trashëguar nga tabela plan:  recno smallint NOT NULL,
-- Trashëguar nga tabela plan:  host uuid,
-- Trashëguar nga tabela plan:  ts timestamp with time zone,
-- Trashëguar nga tabela plan:  exectime numeric(32,3),
-- Trashëguar nga tabela plan:  duration numeric(32,3),
-- Trashëguar nga tabela plan:  bufint bigint,
-- Trashëguar nga tabela plan:  bufmem bigint,
-- Trashëguar nga tabela plan:  bufdsk bigint,
-- Trashëguar nga tabela plan:  apn uuid,
-- Trashëguar nga tabela plan:  ptr uuid,
-- Trashëguar nga tabela plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sekcioni pas ndërrimit të rendit të kolonave — saktësisht të njëjtat fusha, vetëm rendi tjetër:
CREATE TABLE public.plan_20190221
(
-- Trashëguar nga tabela plan:  dt date NOT NULL,
-- Trashëguar nga tabela plan:  ts timestamp with time zone,
-- Trashëguar nga tabela plan:  pack uuid NOT NULL,
-- Trashëguar nga tabela plan:  recno smallint NOT NULL,
-- Trashëguar nga tabela plan:  host uuid,
-- Trashëguar nga tabela plan:  apn uuid,
-- Trashëguar nga tabela plan:  ptr uuid,
-- Trashëguar nga tabela plan:  bufint bigint,
-- Trashëguar nga tabela plan:  bufmem bigint,
-- Trashëguar nga tabela plan:  bufdsk bigint,
-- Trashëguar nga tabela plan:  exectime numeric(32,3),
-- Trashëguar nga tabela plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Vëllimi total i sekcionit përcaktohet nga numri i "fakteve" dhe varet vetëm nga proceset e jashtme, prandaj le të ndajmë madhësinë e heap (pg_relation_size) për numrin e shënimeve në të — pra do të marrim përmasën mesatare të shënimit të ruajtur real:
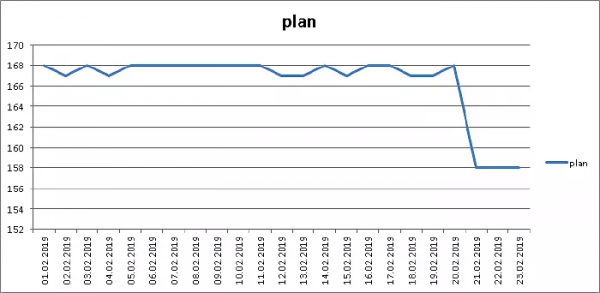
Minus 6% të volumit, shkëlqyer!
Por, natyrisht, gjërat nuk janë aq rozë — sepse në indekset nuk mund të ndryshojmë rendin e fushave, dhe prandaj «në përgjithësi» (pg_total_relation_size)…
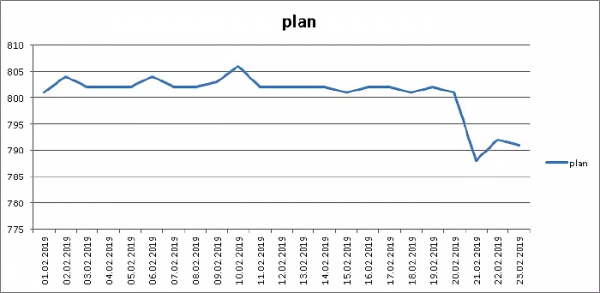
… megjithatë, edhe këtu kemi kursyer 1.5%, pa ndryshuar asnjë rresht kodi. Po, vërtet!
Dua të theksoj se varianti i dhënë më lart i renditjes së fushave — nuk është fakt se është më optimal. Sepse disa blloqe fushash nuk dua t'i «çaj» për arsye estetike — për shembull, një çift (pack, recno), i cili është PK për këtë tabelë.
Në tërësi, përcaktimi i «renditjes minimale» të fushave — është një detyrë mjaft e thjeshtë «kërkuese». Prandaj ju mund të merrni rezultate even më të mira me të dhënat tuaja se sa ne — provoni!
Burimi: habr.com
