

Kur kur flasim për steganografinë, njerëzit imagjinojnë terroristë, pedofilë, spiunë, në më të mirën rast, kriptoanarkistë dhe shkencëtarë të tjerë. Dhe me të vërtetë, kush tjetër ka nevojë për të fshijë diçka nga sytë e jashtëm? Cila mund të jetë dobi për një njeri të zakonshëm nga kjo?
Duket se ka disa. Kjo është arsyeja pse sot do të kompresojmë të dhënat duke përdorur metoda steganografie. Në fund, lexuesi madje do të jetë në gjendje të përdorë fotografitë e tij të çmuara në JPEG për të rritur numrin e gigabajteve të lira në sistemin e skedarëve.
Çfarë?
Nëse lexuesi e mban mend, steganografia është algoritme të çuditshme, që lejojnë fshehjen e një informacioni brenda të tjerit. Me fjalë të thjeshta: imazhi + skedari == përafërsisht i njëjti imazh, por jo plotësisht (në vend të imazheve mund të jetë çfarëdo, por zakonisht është më e qartë). Në të njëjtën kohë, nuk duhet të ketë një mënyrë të thjeshtë për të përcaktuar nëse ka diçka brenda apo jo.
Por nëse nuk mund të dallosh një nga tjetra, a ka vërtet ndonjë diferencë? Nga pikëpamja e konsumatorit, përdoruesi nuk shqetësohet për saktësinë matematike (të reflektuar nga një grup specifik bitësh), vetëm për atë që perceptohet.
Për shembull, të shohim tre imazhe të një qeni të bukur:
Kujdes, JPEG!
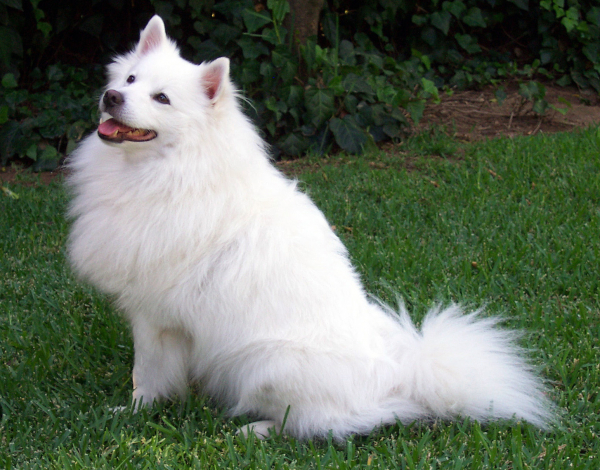
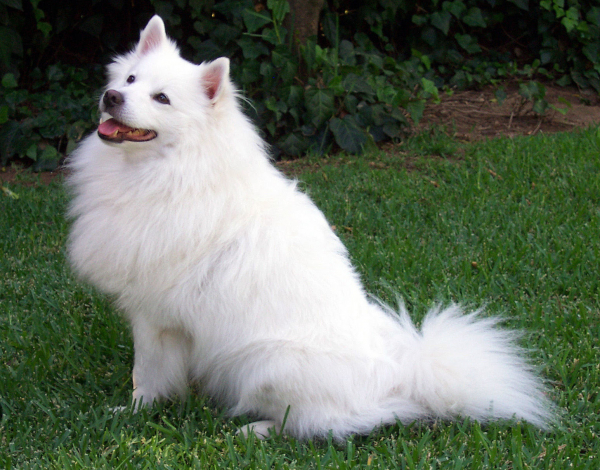
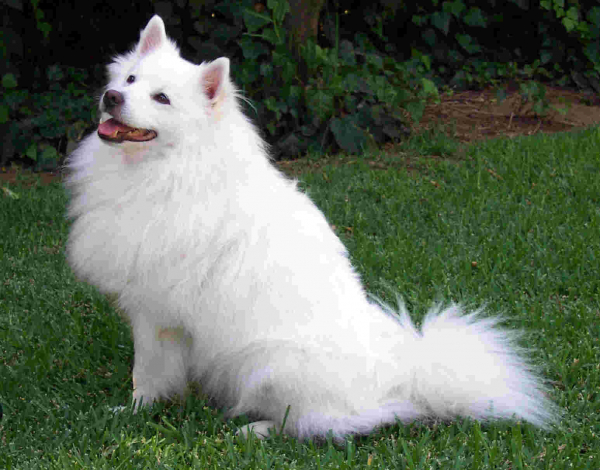
Pavarësisht ndryshimit kolosal në madhësi, pak njerëz do të zgjedhin versionin e tretë. Nga ana tjetër, ndryshimi midis dy fotografive të para nuk është aq i dukshëm, dhe sasia e informacionit në to (nga pikëpamja ime) mund të barazohet.
Ky princip vetë është i vjetër dhe për shumë vite është shfrytëzuar aktivisht nga metodologjitë e kompresimit të informacionit me humbje. Por të prishësh nuk është ndërtim, ne na intereson ana më së avancuar e çështjes. A është e mundur të futësh informacion të shtuar madhësie N në një skedar në një mënyrë që madhësia e tij të rritet me M < N, dhe ndryshimet të mos jenë të dukshme për përdoruesin?
Sigurisht që është e mundur. Por duhet të bëjmë disa ndalesa menjëherë:
- Së pari, metoda duhet të jetë universale dhe të japë rezultat pozitiv në shumicën e të dhënave hyrëse. Kështu, në mesatare, për një hyrje të rastësishme, duhet të ndodhë një zvogëlim i faktik i sasisë së informacionit të ruajtur. “Në mesatare” do të thotë se raste të kundërta mund të ndodhin, por nuk duhet të dominojnë.
- Për më tepër, madhësia e enës së kompresuar para integrimit të informacionit duhet të jetë më e madhe se ajo e modifikimit të kompresuar në mënyrë të ngjashme. Thjesht të integroni në BMP imazhin përmes metodës LSB me shumë bita nuk është kompresim steganografik, pasi, kur kalon përmes ndonjë DEFLATE, imazhi origjinal me siguri do të jetë dukshëm më i vogël.
- Në të tretë, duhet të kryhen dhe të krahasohen rezultatet në lidhje me të dhënat e kompresuara me metoda klasike. Kjo do të lejojë eliminimin e efektit probabilistik të ndryshimit të tepërt dhe të realizohet një kompresim më efikas në rastin e përgjithshëm.
Ku?
Përdorimi i steganografisë nënkupton se, përveç informacionit që do të kompresohet, na nevojiten enë në të cilat do të integrohet. Sasia maksimale e informacionit të integrueshëm varet shumë nga veçori të veçanta, por është shumë më e lehtë të shkallëzohet me sasinë e tyre. Prandaj, formati i enëve duhet të jetë i zakonshëm, në mënyrë që përdoruesi të ketë një sasi të mjaftueshme për të marrë ndonjë përfitim nga procesi i 'kompresimit'.
Në këtë kontekst, kandidatët e mirë bëhen skedarë grafikë, audio dhe video. Por, për shkak të larmisë së formateve të ndryshme, kodeve etj., në praktikë, na mbetet të zgjedhim nga një numër të vogël mundësish.
Duke marrë parasysh gjithçka, zgjedhja ime ra në JPEG. Ai është praktikisht në të gjithë, përdoret gjerësisht si në raste personale ashtu edhe për qëllime biznesi, duke qenë praktikisht formati de-fakto për shumicën e imazheve.
Kur? Si?
Më pas pasojnë skemat dhe përshkrimet teknike dhe afërore pa shpjegime të veçanta, kështu që ata që dëshirojnë mund t'i kalojnë ato, duke e kaluar në seksionin 'Teknologji të Larta'.
Karakteristikat e Përgjithshme
Për të integruar të dhëna diku, së pari duhet të përcaktojmë se ku. Në sistemin e skedarëve mund të ndodhen një numër i pakufizuar fotosh të ndryshme, nga të cilat përdoruesi mund të dëshirojë të përdorë vetëm disa. Ky grup i dëshiruar enësh do quhet bibliotekë.
Kjo formohet në dy raste: para kompresimit dhe para shpërndarjes. Në rastin e parë, mund të përdorim thjesht një grup emrash (ose më mirë, një shprehje të rregullt për ta), por në rastin e dytë kërkohet diçka më të besueshme: përdoruesi mund të kopjojë dhe të zhvendosë ato brenda sistemit të skedarëve, duke mos lejuar që të identifikohen siç duhet. Prandaj, është e nevojshme të ruajnë hash-a të tyre (md5 mjafton) pas kryerjes së të gjitha modifikimeve.
Kërkimi fillestar me anë të shprehjes së rregullt nuk ka kuptim të bëhet në të gjithë FS-në, është mjaft për të treguar një direktori rrënjësore. Ajo do të ruajë gjithashtu një skedar të veçantë-arkiv, në të cilin do të jenë ato hash-a, së bashku me një informacion tjetër meta, të nevojshëm për rikthimin e informacionit të kompresuar.
Të gjitha këto janë të aplikueshme njësoj për çdo implementim të çdo algoritmi të kompresimit të të dhënave steganografike. Proceset e kompresimit dhe rikthimit të të dhënave mund të quhen paketim dhe shpërndarje.
F5
Tani që e kuptuam qartë se çfarë bëjmë dhe përse, mbetet të përshkruajmë algoritmin e arritjes së qëllimit. Le të rikujtojmë procesin e kodimit të skedarit JPEG (falë Wikipedisë së Bibliotekës Kombëtare të Baumanit):
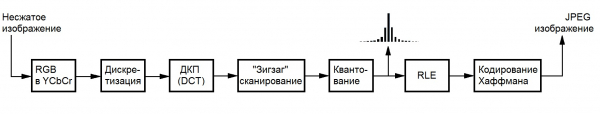
Duke e shqyrtuar atë, është më mirë të bëjmë disa vërejtje menjëherë:
- Madhësia e skedarit JPEG mund të konsiderohet optimale, pa e provuar ta kompresoni me ndonjë program si WinRAR;
- Mund të modifikohet vetëm informacioni i ruajtur (atë, që është në dalje të transformimit diskret të kosinëve, DCT), për të siguruar një performancë të pranueshme.
- Për të mos humbur të dhëna në masa të dukshme për përdoruesin, kërkohet të bëhen minimum modifikimesh në çdo imazh të veçantë;
Për këto kushte i përshtatet një familje e tërë algoritmash, me të cilën mund të njihet . Algoritmi më i avancuar ndër ta është nga Andreas Westfeld, që punon me koeficientët DCT të komponentës së ndriçimit (sytë e njeriut janë më pak të ndjeshëm ndaj ndryshimeve të saj). Skema e tij e përgjithshme kur punon me një skedar JPEG ekzistues paraqitet si në vijim:
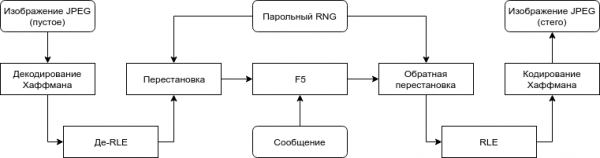
Bloku F5 përdor një metodë të avancuar të inkorporimit, e bazuar në kodimin e matricave. Më shumë rreth saj dhe algoritmit të vet mund të mësoni përmes lidhjes së sipërme, por ajo që na intereson kryesisht është fakti se me ndihmën e tij mund të bëni më pak ndryshime gjatë inkorporimit të të njëjtit sasi informacioni, sa më i madh të jetë rasti i përdorur, ndërsa për të realizuar vetë algoritmin kërkohen vetëm operacione të thjeshta (de)kodimi të Huffman dhe RLE.
Ndryshimet vetë kryhen mbi koeficientët e plotë dhe reduktohen në zvogëlimin e vlerës së tyre absolute me një njësi, e cila e bën, në përgjithësi, të mundur përdorimin e F5 për kompresimin e të dhënave. E vërteta është se koeficienti i zvogëluar në vlerën absolute, shumë pranë gjasave do të zërë më pak bit pas përfundimit të kodimit Huffman për shkak të shpërndarjes statistikore të vlerave në JPEG.
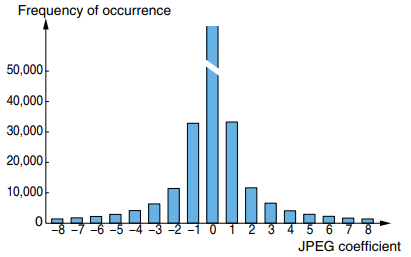
Në rastin e krijimit të zeros (e njohur si reduktim), numri i informacionit të ruajtur do të pakësohet me madhësinë e saj, duke qenë se koeficienti i mëparshëm, i vetëdijshëm, do të bëhet pjesë e sekuencës RLE të koduar të zeros:
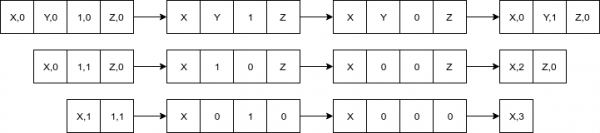
Modifikime
Mbrojtja e të dhënave dhe kompresimi i tyre janë detyra ortogonale, prandaj është e mundur të injorohet ri-zhvendosja sekrete të fjalëkalimit nga algoritmi origjinal. Për më tepër, na nevojitet të dimë saktësisht se si të nxjerrim të dhënat, prandaj të gjitha informacionet e nevojshme për këtë (cilat konteinerë janë përdorur, në cilën rend dhe etj.) duhet të shkruhen në një skedar të veçantë dhe të jenë të hapura për lexim të lirë nga arkivuesi.
Algoritmi origjinal është i dizajnuar për të transferuar mesazhe sekrete, prandaj punon njëherësh vetëm me një konteiner, duke supozuar se përdoruesi do të ndajë atë në pjesë sipas nevojës, nëse ndonjëherë do të shfaqet. Për më tepër, për inkorporimin e pavarur në çdo konteiner, është e nevojshme të dihet paraprakisht sa bit të dhënash të vendosen në çdo një. Prandaj, koeficientët e secilës element të bibliotekës duhet të mblidhen në një të madhe abstrakte dhe të punohet me të sipas algoritmit origjinal.
Duke origjinali F5 lejon përdorimin e deri në 12% të madhësisë së kontejnerit, një modifikim i tillë do të rrisë gjithashtu kapacitetin maksimal: "deri në 12%" të madhësisë së të gjithë bibliotekës është më e madhe ose e barabartë me shumën "deri në 12%" të çdo prej elementeve të saj.
Skema totale e kodifikuar duket si më poshtë:
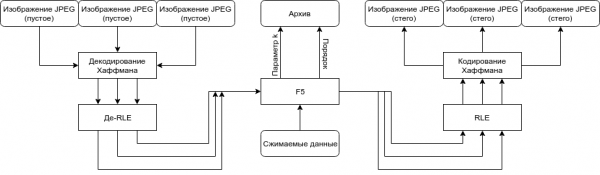
Algoritmi i vetë
Tani është koha për të përshkruar algoritmin nga fillimi deri në fund, për të mos mbajtur lexuesin në të(paktën).
- Përdoruesi përcakton të dhënat binarë të kompresuar M dhe bibliotekën L me ndihmën e një shprehje të rregullt dhe drejtorisë rrënjësore të kërkimit;
- Në renditjen e ndjekjes në sistemin e skedarëve, elementët e bibliotekës formojnë MC:
- Nga të dhënat e skedarit dekodohet një seri koeficientësh C;
- MC <- MC | C;
- Përcaktohet parametri k bazuar në barazimin e frikshëm:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Merrni radhazi
n = (1 << k) - 1bitët më të rinj të elementeve jo-zero nga MC dhe shkruhen nëa:- Kalkulohet funksioni magjik i hash-it
f, që shfaq një fjalë n-bitanë një k-bits; - Nëse
s == 0, atëherë nuk ka nevojë për asnjë ndryshim dhe algoritmi kalon te koeficientët e tjerë; - Ulet vlera absolute e koeficientit që përkon me
s-bitin e -ë në fjalëa; - Nëse si rezultat i uljes ka ndodhur një shkurtim (koeficienti është bërë 0), atëherë përsëritni hapin nga fillimi;
- Kalkulohet funksioni magjik i hash-it
- Të gjithë koeficientët kodifikohen me RLE dhe Huffman, shkruhen në skedarët burim;
- Në skedarin e arkivës shkruhet parametri k;
- Nga çdo skedar L, në rendin e gjetjes së tyre origjinale, llogaritet hash-i MD5 dhe shkruhet në skedarin e arkivës.
Teknologji të larta
Forma naive e algoritmit dhe implementimet në gjuhë të tjera të nivelit të lartë (sidomos, ato me grumbullim të plehrave) do të jepnin një performancë të tmerrshme, prandaj të gjitha këto kompleksitete unë i realizova në C të pastër dhe kryeva një sërë optimizimesh si për shpejtësinë e ekzekutimit ashtu edhe për kujtesën (nuk mund ta besoni sa shumë peshojnë këto figura pa kompresim edhe deri në DCT). Por edhe kështu, fillimisht shpejtësia e ekzekutimit la shumë për të dëshiruar, prandaj nuk do ta përshkruaj të gjithë procesin dhe metodat e përdorura.
Kros-platforma është arritur duke përdorur një kombinim bibliotekash libjpeg, pcre dhe tinydir, për të cilat falenderojmë. Defaulti është të kompiloni përmes një make, prandaj përdoruesit e Windows duan të instalojnë një Cygwin, ose të kuptojnë me Visual Studio dhe bibliotekat vetë.
Zbatimi është i disponueshëm në formën e një utilitari konsolë dhe libërkosh. Më shumë rreth përdorimit të fundit ata që dëshirojnë mund të informohen në ridhimin në depo në GitHub, lidhjen e së cilës do ta bashkangjis në fund të postimit. Tani, le të kalojmë në përshkrimin dhe demonstrimin e funksionit.
Si të përdorni?
Me kujdes. Imazhet e përdorura mund të lëvizin, riemërohen dhe kopjohen sipas dëshirës. Megjithatë, duhet të jeni jashtëzakonisht të kujdesshëm dhe të mos ndryshoni përmbajtjen e tyre. Ndryshimi i një blloku do të çojë në shkeljen e hashes dhe pamundësinë e rikuperimit të informacionit.
Le të themi se pas kompaktimit morëm një skedar ekzekutues f5ar. Mund të analizoni madhësinë e librit për të llogaritur mundësitë e përdorimit të saj me ndihmën e flagut -a: .\/f5ar -a [folderi i kërkimit] [shprehje rregullore për Perl]. Kompresimi bëhet me komandën .\/f5ar -p [folderi i kërkimit] [shprehje rregullore për Perl] [skedari i kompresuar] [emri i arkivit], ndërsa dekompresimi me anë të .\/f5ar -u [skedari i arkivit] [emri i skedarit të rikuperuar].
Demonstrimi i funksionimit
Për të treguar efikasitetin e metodës, kam ngarkuar një koleksion prej 225 fotografive të papaguara të qenve nga shërbimi . Çdo njëra prej tyre ka pak më shumë cilësi sesa fotografitë e zakonshme të përdoruesve, por megjithatë. Çdo njëra prej tyre është rikoduara me ndihmën e libjpeg, për të zbutur ndikimin e veçorive të kodimit të librit në madhësinë totale. Për të treguar shembullin më të keq të të dhënave që mund të kompresohen me ndihmën e dd është krijuar një skedar rastësor 36-metror (pak më shumë se 5% e madhësisë totale) me shpërndarje të barabartë.
Processi i testimit është mjaft i thjeshtë:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ .\/f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Duke lexuar skedarin e kompresuar... ok
Duke inisializuar arkivin... ok
Duke analizuar kapacitetin e librit... përfunduar në 16.8s
Kapaciteti i garantuar i identifikuar është 48439359 bytes
Kapaciteti i mundshëm i identifikuar është deri në 102618787 bytes
Duke kompresuar... përfunduar në 32.6s
Duke ruajtur arkivin... ok

$ .\/f5ar -u dogs/dogs.f5ar e dekompresuar
Duke inicializuar arkivin... ok
Duke lexuar skedarin e arkivit... ok
Duke mbushur arkivin me skedarë... përfunduar në 1.2s
Duke dekompresuar... përfunduar në 17.5s
Duke shkruar të dhënat e nxjerra... ok

$ sha1sum binary_data e dekompresuar
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 e dekompresuar
$ du -sh dogs/
563M dogs/
Ose një screenshot për adhuruesit
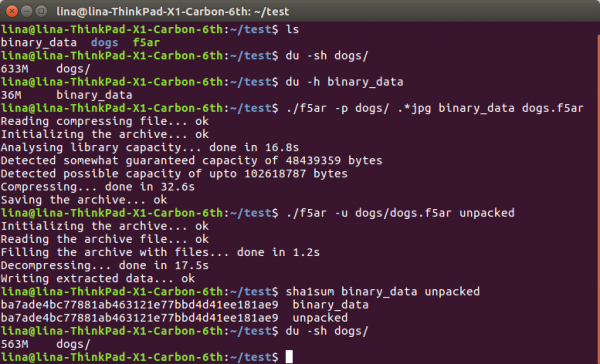
Siç duket, nga 633 + 36 == 669 megabajt të të dhënave në diskun e ngurtë, ne erdhëm në 563 më të këndshëm, që na jep një raport kompresimi ~1,188. Kjo ndryshim radikal shpjegohet nga humbjet tejet të vogla, të ngjashme me ato që arrihen gjatë optimizimit të skedarëve JPEG me metoda klasike (si tinyjpg). Sigurisht, me përdorimin e kompresimit steganografik, informacioni nuk humbet thjesht, por përdoret për kodimin e të dhënave të tjera. Më shumë se kaq, numri i koeficientëve të 'optimizuar' falë përdorimit të F5 është shumë më i vogël, sesa gjatë optimizimit tradicional.
Çfarëdo modifikimesh që të jenë, ato nuk duken aspak për syrin. Nën spoilerin më poshtë, lexuesi mund të vlerësojë ndryshimin si me sy ashtu dhe duke zbritur vlerat e komponentës së ndryshuar nga origjinali (sa më e zbehtë të jetë ngjyra, aq më pak është ndryshimi):
Linke për imazhe, që nuk kanë gjetur vend në habrastorage
Origjinali —
Modifikuar —
Ndryshimi —
Në përfundim
Shpresoj se kam arritur të bind lexuesin se të tilla metoda janë të mundshme dhe meritojnë të ekzistojnë. Megjithatë, blerja e një disku të ngurtë ose e një канali shtesë (për transmetim në rrjet) mund të duket një zgjidhje shumë më e thjeshtë se sa të përpiqesh të ekonomizosh në këtë mënyrë. Në njërën anë, kjo është e vërtetë, zhvillimi ekstensiv shpesh është më i lehtë dhe më i besueshëm. Por nga ana tjetër, nuk duhet harruar zhvillimi intensiv. Sepse nuk ka garanci që nesër do të mundesh të shkosh në dyqan dhe të blesh një disk të ngurtë me një mijë terabajta, ndërsa përdorimi i atyre që tashmë i ke në shtëpi është gjithmonë një mundësi.
->
Burimi: habr.com
