

Përkthimi i artikullit është përgatitur para fillimit të kursit .
Si të kurseni në shpenzimet cloud kur punoni me Kubernetes? Nuk ka një zgjidhje të vetme të saktë, por në këtë artikull përmenden disa mjete që do t'ju ndihmojnë të menaxhoni më efikasisht burimet dhe të reduktoni shpenzimet për hesapin në cloud.
E shkrova këtë artikull duke pasur parasysh Kubernetes për AWS, por ai do të jetë i aplikueshëm (më gati) po ashtu edhe për ofruesit e tjerë të cloud. Supozoj që klasteri juaj(i) tashmë ka konfigurimin e automatizimit të shkallëzimit.). Shkathtësia për të fshirë burimet dhe të zvogëlojë shpërndarjen do të kursejë vetëm nëse gjithashtu redukton numrin e nodëve të punës (instanceve EC2).
Në këtë artikull do të shqyrtohen:
- pastrimi i burimeve të pambuluara ()
- zvogëlimi i shkallëzimit në orët jo-punë ()
- përdorimi i shkallëzimit horizontal (HPA),
- reduktimi i mbivendosjes së burimeve (, VPA)
- përdorimi i instancave Spot
Pastrim i burimeve të pambuluara
Të punosh në një ambient që ndryshon shpejt është e shkëlqyer. Ne duam që organizatat teknike . Një dorëzim më i shpejtë i softuerit gjithashtu do të thotë më shumë ndarje PR, ambiente shikimi paraprak, prototipa dhe zgjidhje analitikë. Çdo gjë është e instaluar në Kubernetes. Kush ka kohë për të pastruar shpërndarjet testuese me dorë? Lehtë harrohet të fshihet një eksperiment i bërë para një jave. Fatura për cloud në fund do të rritet për shkak se harrohet të mbyllen:
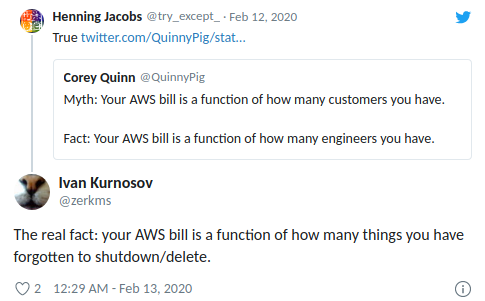
(Henning Jacobs:
E vërteta:
(citon) Cory Quinn:
Mit: Fatura juaj AWS është një funksion varësie nga numri i përdoruesve tuaj.
Fakt: Fatura juaj AWS është një funksion varësie nga numri i inxhinierëve tuaj.
Ivan Kurnosov (në përgjigje):
Fakti i vërtetë: Fatura juaj AWS është një funksion varësie nga sa gjëra keni harruar të fikni/fshini.)
(kube-janitor) ndihmon për të pastruar klasterin tuaj. Konfigurimi i janitor është fleksibël si për përdorim global ashtu edhe lokal:
- Rregullat e përgjithshme për të gjithë klasterin mund të përcaktojnë maksimumin e kohës së jetës (TTL - kohë deri në përfundim) për shpërndarjet PR/testuese.
- Burime të veçanta mund të annotohen me janitor/ttl, për shembull, për fshirjen automatike të spike/prototipit brenda 7 ditësh.
Rregullat e përbashkëta përcaktohen në skedarin YAML. Rruga e tij jepet përmes parametrin --rules-file në kube-janitor. Ja një shembull rregulli për të fshirë të gjitha hapësirat emërore me -pr- në emër brenda dy ditësh:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
Shembulli tjetër rregullon përdorimin e etiketës application në blloqet Deployment dhe StatefulSet për të gjitha Deployments/StatefulSets e reja në vitin 2020, por në të njëjtën kohë lejon kryerjen e testeve pa këtë etiketë për një javë:
- id: require-application-label
  # fshij deployments dhe statefulsets pa etiketën "application"
  resources:
    - deployments
    - statefulsets
  # shiko http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Ekzekutimi i një demostratore të kufizuar në kohë për 30 minuta në klasterin ku funksionon kube-janitor:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Një burim tjetër i kostove në rritje janë volumat e përhershme (AWS EBS). Kur fshihen Kubernetes StatefulSet, volumat e tij të përhershëm (PVC - PersistentVolumeClaim) nuk fshihen. Vëllimet e papërdorura EBS mund të sjellin lehtësisht kosto prej qindra dollarësh në muaj. Kubernetes Janitor ka një funksion për të pastruar PVC-të e papërdorura. Për shembull, ky rregull do të fshijë të gjitha PVC-të që nuk janë montuar nga moduli dhe për të cilat nuk ka referim nga StatefulSet ose CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor mund t'ju ndihmojë të mbani klasterin tuaj në "pastër" dhe të parandaloni koston që rëndohet ngadalë në llogaritë e llogarive në cloud. Për udhëzime për instalimin dhe konfigurimin ndiqni në .
Shkurtimi i dimensioneve në kohë të papunë
Sistemet testuese dhe ndërmjetësisht zakonisht kërkohen vetëm për të punuar gjatë orarit të punës. Disa aplikacione prodhuese, siç janë blloqet e prapavijës / mjetet e administratorit, gjithashtu kërkojnë vetëm një disponueshmëri të kufizuar dhe mund të mbyllen gjatë natës.
(kube-downscaler) lejon përdoruesve dhe operatorëve të zvogëlojnë shkallën e sistemit gjatë kohës që është jashtë funksionit. Deployment-et dhe StatefulSets mund të zvogëlohen deri në zero replika. CronJobs mund të ndërpriten. Kubernetes Downscaler konfigurohet për të gjithë klasterin, një ose disa hapësira emri, ose burime të veçanta. Mund të vendoset ose 'koha e papërshkruar', ose përkundrazi 'koha e punës'. Për shembull, për të zvogëluar sa më shumë shkallën gjatë natës dhe fundjavave:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # mos çaktivizoni komponentët e infrastrukturës
  - --exclude-namespaces=kube-system,infra
  # mos çaktivizoni kube-downscaler, si dhe lëreni Postgres Operator, që të menaxhohen bazat e të dhënave të përjashtuara
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Ja grafik i zvogëlimit të nyjeve punuese të klasterit gjatë fundjavave:
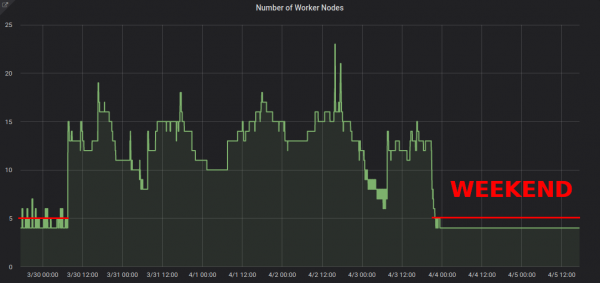
Zvoglimi i shkallës nga ~13 në 4 nyje punuese, sigurisht që ndihmon në ndryshimin e faturës në AWS.
Por çfarë nëse duhet të punoj gjatë 'kohës së papërshkruar' të klasterit? Deployment-et e caktuara mund të përjashtohen përfundimisht nga zvoglimi duke shtuar anotimin downscaler/exclude: true. Deployment-et mund të përjashtohen përkohësisht me anë të anotimit downscaler/exclude-until me një timestamp absolut në formatin GGGG-MM-DD HH:MM (UTC). Nëse është e nevojshme, e gjithë klasteri mund të rikthehet në shkallë duke kërkuar një pod me anotimin downscaler/force-uptime, për shembull, duke ekzekutuar një strehë nginx:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # fshini deployment-in pas një ore
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Shikoni , nëse jeni të interesuar për instrukcione për vendosjen dhe opsione të tjera.
Përdorni shkallëzimin horizontal
Shumë aplikacione/faqe kanë të bëjnë me një schemë dinamik të ngarkesës: disa herë modulat e tyre qëndrojnë, dhe disa herë ato punojnë me kapacitet të plotë. Të punosh me një park të përhershëm pod-esh për të përballuar ngarkesën maksimale nuk është ekonomik. Kubernetes mbështet shkallëzimin automatike horizontale përmes burimit (HPA). Përdorimi i CPU shpesh është një tregues i mirë për shkallëzimin:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando krijoi një komponent për lidhjen e thjeshtë të metrikave të personalizuara për shkallëzim: (kube-metrics-adapter) është një adaptues metrikash universale për Kubernetes, i cili mund të mbledhë dhe ofrojë metrika të personalizuara dhe të jashtme për shkallëzimin horizontal të kontejnerëve. Ai mbështet shkallëzimin bazuar në metrikat Prometheus, radhët SQS dhe konfigurime të tjera. Për shembull, për të shkallëzuar një shpërndarje për metrikën e personalizuar të paraqitur nga aplikacioni vetë në formatin JSON në /metrics përdorni:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.../
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Konfigurimi i shkallëzimit horizontal me HPA duhet të jetë një nga veprimet standarde për të përmirësuar efikasitetin për shërbimet pa marrë parasysh gjendjen. Spotify ka një prezantim me përvojën dhe rekomandimet e tyre për HPA: .
Reduktimi i rezervës së tepërt të burimeve
Ngarkesat e punës në Kubernetes përcaktojnë nevojat e tyre për CPU/memorie përmes "kërkesave për burime". Burimet e CPU matur në bërthama virtuale ose më shpesh në "milikoresh" (millicores), për shembull, 500m nënkupton 50% vCPU. Burimet e memories maten në byte dhe mund të përdoren sufiks standard, për shembull, 500Mi, që do të thotë 500 megabajt. Kërkesat për burime "bllokojnë" sasinë në nodet e punës, domethënë, një modul me kërkesë CPU prej 1000m në një nod me 4 vCPU do të lërë vetëm 3 vCPU të disponueshëm për module të tjera.
Slack (rezerva e tepërt) — është diferenca midis burimeve të kërkuara dhe përdorimit real. Për shembull, një pod që kërkon 2 GiB memorie, por përdor vetëm 200 MiB, ka ~ 1.8 GiB "të tepërt" të memories. Tepërta kushton para. Mund të vlerësohet në mënyrë të përafërt se 1 GiB memorie të tepërt kushton ~ 10 dollarë në muaj.
(kube-resource-report) tregon rezervat e tepërta dhe mund të ndihmojë në identifikimin e potencialit për kursim:
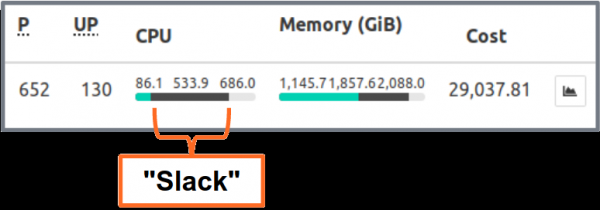
tregon tepërtin e grumbulluar nga aplikacioni dhe ekipi. Kjo lejon të gjejmë vendet ku kërkesat për burime mund të reduktohen. Raporti HTML i gjeneruar ofron vetëm një pamje të përdorimit të burimeve. Duhet të shikoni përdorimin e procesorit/memories me kalimin e kohës për të përcaktuar kërkesat e duhura për burime. Ja një grafik Grafana për një shërbim "tipik" me ngarkesë të madhe CPU: të gjitha podet përdorin ndjeshëm më pak se 3 bërthamë të kërkuara të CPU:
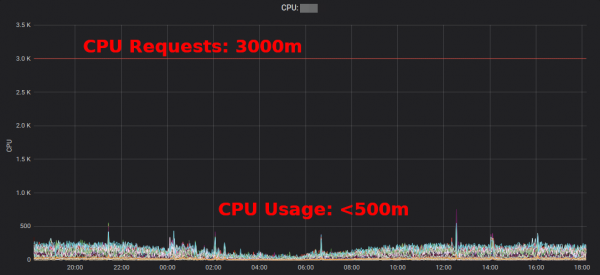
Reducimi i kërkesës së CPU nga 3000m në ~400m liron burime për ngarkesa të tjera dhe lejon zvogëlimin e klasterit.
"Përdorimi mesatar i CPU i instancave EC2 shpesh variaton në përqindje njësh," . Ndërsa për EC2 , ndryshimi i disa kërkesave të burimeve Kubernetes në skedarin YAML bëhet lehtë dhe mund të sjellë kursime të mëdha.
Por a duam me të vërtetë që njerëzit të ndryshojnë vlerat në skedarët YAML? Jo, makinat mund ta bëjnë këtë shumë më mirë! Kubernetes (VPA) pikërisht këtë bën: përshtat kërkesat e burimeve dhe kufizimet sipas ngarkesës. Ja një shembull grafiku të kërkesave të CPU nga Prometheus (vija e hollë blu), të përshtatura nga VPA me kalimin e kohës:
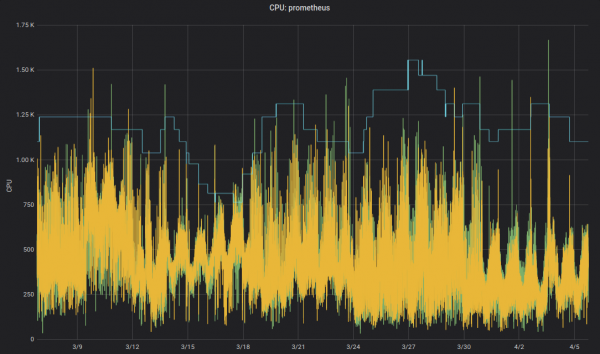
për komponentët e infrastrukturës. Aplikacionet jo kritike gjithashtu mund të përdorin VPA.
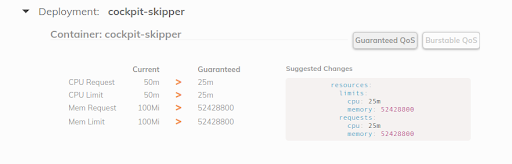
nga Fairwind — është një mjet që krijon VPA për çdo implementim në hapësirën e emrave, dhe pastaj shfaq rekomandimin VPA në panelin e saj. Ai mund të ndihmojë zhvilluesit të vendosin kërkesat e duhura për procesor/memorie për aplikacionet e tyre:
Kam shkruar një post të vogël në vitin 2019, dhe së fundmi në .
Përdorimi i instancave EC2 Spot
Së fundi, po aq e rëndësishme, shpenzimet e AWS EC2 mund të reduktohen duke përdorur instancat Spot si nyje të Kubernetes. . Instancat Spot janë të disponueshme me një zbritje deri në 90% krahasuar me çmimet për kërkesë. Të drejtuarit e Kubernetes në EC2 Spot është një kombinim i shkëlqyer: ju nevojitet të specifikoni disa lloje të ndryshme instancash për një disponueshmëri më të lartë, duke i dhënë mundësinë të merrni një nyje më të madhe për të njëjtën çmim ose më të ulët, dhe kapaciteti i shtuar mund të përdoret nga ngarkesat e punës me konteinerë të Kubernetes.
Si të drejtoni Kubernetes në EC2 Spot? Ka disa opsione: të përdorni një shërbim të palës së tretë, si SpotInst (tani quhet "Spot", mos më pyesni pse), ose thjesht të shtoni një Spot AutoScalingGroup (ASG) në klasterin tuaj. Për shembull, ja një fragmet i CloudFormation për "ASG të optimizuar për kapacitet" me disa lloje instancash:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Disa shënime mbi përdorimin e Spot me Kubernetes:
- Ju duhet të trajtoni përfundimet e Spot, për shembull duke e anuluar nyjën në momentin e ndalimit të instancës.
- Zalando përdor autoskalamimin zyrtar të klasterit me prioritetet e grupit të nyjeve.
- Nyjet Spot të pranojnë "regjistrimet" e ngarkesave për t'u drejtuar në Spot.
CV
Shpresoj se do të gjeni disa nga mjetet e paraqitura të dobishme për të ulur faturën tuaj të llogarive në cloud. Ju mund të gjeni pjesën më të madhe të përmbajtjes së artikullit gjithashtu në .
Cilat janë praktikat tuaja më të mira për të kursyer shpenzimet për cloud në Kubernetes? Ju lutem, më njoftoni në .
Faktikisht, më pak se 3 CPU virtuale do të mbeten të përdorshëm, pasi kapaciteti i nodit zvogëlohet për shkak të burimeve sistemore të rezervuara. Kubernetes bën dallimin midis kapacitetit fizik të nodit dhe burimeve 'të alokuara' ().
Shembull llogaritjeje: një instancë m5.large me 8 GiB RAM kushton ~84 dollarë në muaj (eu-central-1, On-Demand), pra bllokimi 1/8 i nodit është rreth ~10 dollarë në muaj.
Ka shumë mënyra për të ulur faturën tuaj EC2, për shembull, instancat e rezervuara, plani i kursimeve etj. — nuk do t'i trajtoj këto tema këtu, por duhet patjetër t'i hulumtoni!
Burimi: habr.com
