

Përshëndetje të gjithëve. Ne po zhvillojmë një produkt për analizën e trafikut offline. Në projekt ka një detyrë që lidhet me analizën statistike të rrugëve të lëvizjes së vizitorëve nëpër zona.
Në kuadër të kësaj detyre, përdoruesit mund t'i drejtojnë sistemit kërkesa të tilla si:
- sa vizitorë kanë kaluar nga zona "A" në zonën "B";
- sa vizitorë kanë kaluar nga zona "A" në zonën "B" përmes zonës "C", e më pas përmes zonës "D";
- sa kohë ka zgjatur kalimi i një vizitori të një lloji të caktuar nga zona "A" në zonën "B."
dhe një sërë kërkesash analitike të ngjashme.
Lëvizja e vizitorëve nëpër zona paraqet një grafik të orientuar. Pas leximit në internet, zbulova se bazat e të dhënave grafike përdoren gjithashtu për raportet analitike. Më erdhi një dëshirë të shoh se si do të përballen me kërkesat e tilla bazat e të dhënave grafike (TL;DR; keq).
Kam zgjedhur për përdorim bazën e të dhënave , si një përfaqësues të shkëlqyer të bazave të të dhënave grafike open-source, e cila mbështetet në një grup teknologjish të pjekura, të cilat (sipas mendimit tim) do të siguronin performancë të arsyeshme operative:
- backend i magazinës BerkeleyDB, Apache Cassandra, Scylla;
- indeksat kompleksë mund të ruhen në Lucene, Elasticsearch, Solr.
Autorët e JanusGraph thonë se ajo përshtatet si për OLTP, ashtu edhe për OLAP.
Kam punuar me BerkeleyDB, Apache Cassandra, Scylla dhe ES, përveç kësaj, këto produkte përdoren shpesh në sistemet tona, kështu që e shikoja me optimizëm testimin e kësaj baze të dhënash grafike. Më duket i çuditshëm zgjedhja e BerkeleyDB, në vend të RocksDB, por ndoshta kjo lidhet me kërkesat për transaksione. Megjithatë, për përdorim të shkallëzueshëm dhe produktor, ofrohet përdorimi i backend-it në Cassandra ose Scylla.
Nuk e kam marrë parasysh Neo4j, sepse për klasterizimin e saj kërkohet version komercial, prandaj produkti nuk është i hapur.
Bazat e të dhënave grafike thonë: "Nëse diçka duket si grafik — trajtoje atë si grafik!" — bukuri!
Së pari vizatova një grafik, i cili është bërë sipas kanoneve të bazave të të dhënave grafike:
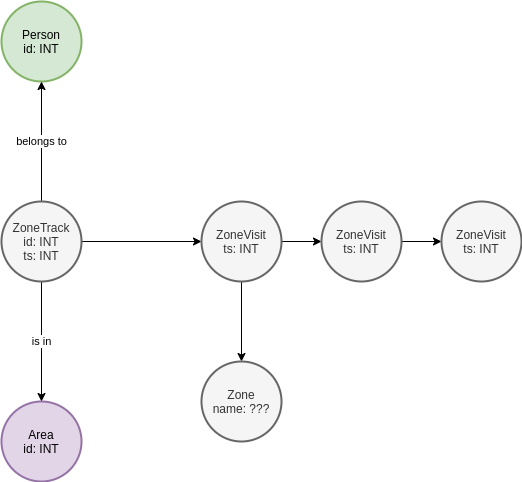
Ka një entitet Zone, që është përgjegjës për zonën. Nëse ZoneStep i përket kësaj Zone, atëherë ai i referohet asaj. Në entitetin Area, ZoneTrack, Person kujdes mos e injoroni, ato i përkasin domainit dhe në kuadër të testit nuk merren parasysh. Pra, një kërkesë për një strukturë grafike do të dukej así:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
Çfarë në shqip do të dukej kështu: gjeni Zone me ID=0, merrni të gjitha majat që kanë një skaj (ZoneStep) nga ajo, shkoni përpara pa u kthyer pas derisa të gjeni ZoneStep, nga e cila dalin skaj për një Zone me ID=19, numëroni numrin e atyre zinxhirëve.
Nuk pretendoj të kem njohuri për të gjitha hollësitë e kërkimit në grafë, por kjo kërkesë u gjenerua mbi bazën e kësaj libri ().
Kam ngarkuar 50 mijë këngë me gjatësi nga 3 deri në 20 pika në bazën grafike JanusGraph, duke përdorur backend-in BerkeleyDB, krijova indekse sipas .
Skripti për ngarkim në Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
U përdor një VM me 4 núcleo dhe 16 GB RAM në SSD. JanusGraph u implementua duke përdorur këtë komandë:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestNë këtë rast, të dhënat dhe indokset që përdoren për kërkimin e saktë ruhen në BerkeleyDB. Pas ekzekutimit të kërkesës që u përmend më parë, mora një kohë që kapte disa dhjetëra sekonda.
Duke ekzekutuar 4 skriptet e mësipërme paralelisht, më arriti të shndërroja DB-në në një kungull me një rrjedhë të këndshme stektrajesh Java (dhe të gjithë ne e duam të lexojmë stektra Java) në log-at e Docker.
Pas mendimeve, vendosa të thjeshtoj skemën e grafit në këtë mënyrë:
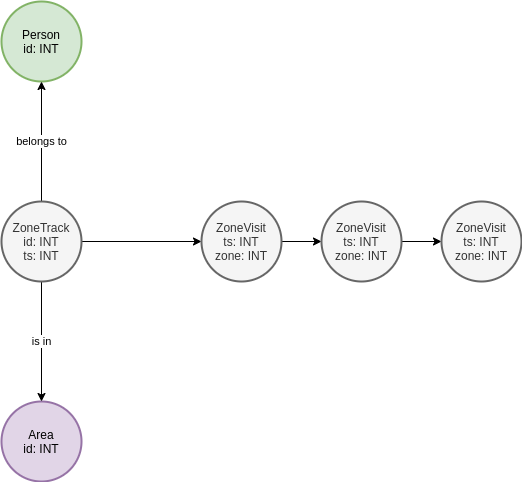
Duke vendosur se kërkimi sipas atribueteve të entitetit do të ishte më i shpejtë se kërkimi sipas skajve. Si rezultat, kërkesa ime u shndërrua në këtë:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()Çfarë në shqip do të duket kështu: gjeni ZoneStep me ID=0, shkojeni përpara pa u kthyer pas derisa të gjeni ZoneStep me ID=19, numëroni numrin e atyre zinxhirëve.
Scripti i ngarkesës, që u përmend më lart, e thjeshtova gjithashtu, për të shmangur lidhjet e padobishme, duke u kufizuar në atributet.
Kërkesa ende zgjatej disa sekonda, që ishte krejtësisht e papranueshme për detyrën tonë, pasi për qëllime AdHoc kërkesat e rastësishme nuk ishin aspak të përshtatshme.
Kam provuar të zhvendos JanusGraph duke përdorur Scylla, si implementimi më i shpejtë i Cassandra, por kjo gjithashtu nuk solli ndonjë ndryshim të dukshëm në performancë.
Prandaj, pavarësisht nga fakti se "duket si grafik", nuk arrita të bëj që baza e të dhënave grafike ta përpunonte këtë shpejt. E imagjinoj se ndoshta nuk di diçka dhe mund ta bëjë JanusGraph këtë kërkesë për disa pjesë të sekondës, megjithatë, nuk më doli.
Pasi ishte e nevojshme të zgjidhja problemin, fillova të mendoj për JOIN dhe Pivot tabelash, që nuk frymëzonte optimizëm në aspektin e elegancës, por mund të ishte një opsion i punueshëm në praktikë.
Në projektin tonë tashmë përdoret Apache ClickHouse, kështu që vendosa të kontrolloj hulumtimet e mia në këtë bazë të të dhënave analitike.
E vendosa ClickHouse sipas një recete të thjeshtë:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Krijova një DB dhe një tabelë të tillë:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
E mbusha atë me të dhëna duke përdorur skriptin e mëposhtëm:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Pasi inserimet bëhen në grupe, mbushja ishte shumë më e shpejtë sesa për JanusGraph.
Krijova dy kërkesa duke përdorur JOIN. Për të kaluar nga pika A në pikën B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Për të kaluar përmes 3 pikave:
SELECT s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FROM
  (SELECT s1.person AS person,
          s1.zone AS s1z,
          s1.when AS s1w,
          s2.zone AS s2z,
          s2.when AS s2w
   FROM
     (SELECT *
      FROM steps
      WHERE (area = 0)
        AND (zone = 0)) AS s1 ANY INNER JOIN
     (SELECT *
      FROM steps AS s2
      WHERE (area = 0)
        AND (zone = 3)) AS s2 USING person
   WHERE s1.when <= s2.when) p ANY INNER JOIN
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 19)) AS s3 USING person
WHERE p.s2w <= s3.when
Kërkesat, sigurisht, duken mjaft frikësuese, për përdorim real kërkohet të bëhet një lidhje programore-gjenerues. Megjithatë, ato funksionojnë dhe funksionojnë shpejt. Të dy kërkesat ekzekutohen për më pak se 0.1 sekondë. Ja një shembull i kohës së ekzekutimit të kërkesës për count(*) kalimin në 3 pika:
SELECT count(*)
FROM
(
    SELECT
        s1.person AS person,
        s1.zone AS s1z,
        s1.when AS s1w,
        s2.zone AS s2z,
        s2.when AS s2w
    FROM
    (
        SELECT *
        FROM steps
        WHERE (area = 0) AND (zone = 0)
    ) AS s1
    ANY INNER JOIN
    (
        SELECT *
        FROM steps AS s2
        WHERE (area = 0) AND (zone = 3)
    ) AS s2 USING (person)
    WHERE s1.when <= s2.when
) AS p
ANY INNER JOIN
(
    SELECT *
    FROM steps
    WHERE (area = 0) AND (zone = 19)
) AS s3 USING (person)
WHERE p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 rresht në grup. Kohë e kaluar: 0.068 sek. U procesuan 250.03 mijë rreshta, 8.00 MB (3.69 milion rreshta/s., 117.98 MB/s.)Vërejtje në lidhje me IOPS. Gjatë mbushjes së të dhënave, JanusGraph gjeneronte një numër të lartë IOPS (1000-1300 për katër rrjedha të mbushjes së të dhënave), ndërsa IOWAIT ishte mjaft e lartë. Në të njëjtën kohë, ClickHouse generonte një ngarkesë minimale në sistemin e diskëve.
Përfundim
Ne vendosëm të përdorim ClickHouse për të shërbyer për këtë lloj kërkesash. Ne gjithmonë mund të optimalizojmë më tej kërkesat, duke përdorur pamje të materializuara dhe paralelizim, duke kryer përpunimin e parakohshëm të rrjedhës së ngjarjeve me Apache Flink para se t'i ngarkojmë ato në ClickHouse.
Performanca është aq e mirë, saqë ndoshta nuk do të duhet të mendojmë për pivotet e tabelave me mjete programore. Më parë, na duhej të bënim pivotet e të dhënave që nxirreshin nga Vertica përmes eksportimit në Apache Parquet.
Fatkeqësisht, përpjekja e radhës për të përdorur një DB grafike nuk dha rezultate. Nuk e gjetëm JanusGraph me një ekosistem miqësor që lejon që të kuptohet shpejt produkti. Për më tepër, konfigurimi i serverit përdor metodologjinë tradicionale Java, e cila do ta bëjë të portretizuarit e njohur me Java të qajnë me lot gjaku:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary is here to replace Gryo and Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo and Graphson, latest versions
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Older serialization versions for backwards compatibility:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Mundi arritur të "vë" rastësisht BerkeleyDB versionin e JanusGraph.
Dokumentacioni është mjaft i pafavorshëm sa i përket indekseve, pasi menaxhimi i indekseve kërkon të bëhet një magji e çuditshme me Groovy. Për shembull, krijimi i indekut duhet të bëhet duke shkruar kod në konsolën Gremlin (e cila, për të thënë të drejtën, nuk funksionon nga kutia). Nga dokumentacioni zyrtar i JanusGraph:
graph.tx().rollback() // Kurrë mos krijoni indekse të reja ndërsa një transaksion është aktiv
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

// Prisni që indeksi të bëhet i disponueshëm
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
// Rindizni të dhënat ekzistuese
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Pasthënie
Në një farë mënyre, eksperimentimi i mësipërm është një krahasim i ngrohtë me të butë. Kur mendojmë, DB grafike kryen operacione të tjera për të arritur të njëjtat rezultate. Megjithatë, në kuadër të testeve kam kryer gjithashtu një eksperiment me një kërkesë të këtij lloji:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
e cila pasqyron aksesueshmërinë hap pas hapi. Megjithatë, dhe me të dhëna të tilla, DB grafike tregonte rezultate që tejkalonin disa sekonda... Kjo, sigurisht, lidhet me faktin që kishte rrugë të këtij lloji 0 -> X -> Y ... -> 1, të cilat gjithashtu i kontrollonte motori grafik.
Edhe për një kërkesë të këtij lloji:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()nuk kam arritur të marr një përgjigje me performancë me një kohë përpunimi më pak se një sekondë.
Moral i përrallës është se një ide e bukur dhe modelimi paradigmatik nuk çojnë në rezultatin e dëshiruar, i cili demonstrohet me një efikasitet shumë më të lartë në shembullin e ClickHouse. Varianti i dhënë në këtë artikull është një antipatern e qartë për DB grafike, megjithëse duket si një qasje e përshtatshme për modelim në paradigmat e tyre.
Burimi: habr.com
