

Pasqyra e fjalimeve të mia në Highload++ dhe DataFest Minsk 2019.
Për shumë njerëz, sot posta është një pjesë e pandashme e jetës në internet. Me të, ne kryejmë korrespondencën biznesore, ruajmë informacione të ndryshme të rëndësishme lidhur me financat, rezervimin e hoteleve, përpunimin e porosive dhe shumë të tjera. Në mes të vitit 2018, ne formuluam strategjinë e produktit për zhvillimin e postës. Si duhet të jetë posta moderne?
Posta duhet të jetë e zgjuar, domethënë, të ndihmojë përdoruesit të orientohen në volumin në rritje të informacionit: të filtrojë, strukturojë dhe ta ofrojë atë në mënyrën më të përshtatshme. Ajo duhet të jetë e dobishme, duke lejuar zgjidhjen e detyrave të ndryshme direkt në kutinë postare, për shembull, pagesën e gjobave (një funksion që, për fat të keq, e përdor). Dhe, natyrisht, posta duhet të sigurojë mbrojtje informacioni, duke bllokuar spam-in dhe duke mbrojtur nga hakimet, pra, të jetë e sigurtë.
Këto drejtime përcaktojnë një seri detyrash kyçe, shumë prej të cilave mund të zgjidhen në mënyrë efikase me ndihmën e mësimit të makinave. Ja disa shembuj të veçorive që janë zhvilluar brenda kuadrit të strategjisë — një për çdo drejtim.
- Përgjigjja e zgjuar. Në postë ka një funksion përgjigjeje të zgjuar. Rrjeti nervor analizon tekstin e letrës, kupton kuptimin dhe qëllimin e saj, dhe si rezultat ofron tre opsione më të përshtatshme për përgjigje: pozitive, negative dhe neutrale. Kjo ndihmon të kursehet ndjeshëm kohë kur përgjigjemi në letra, si dhe shpesh përgjigjemi në mënyrë jo standarde dhe argëtuese për veten.
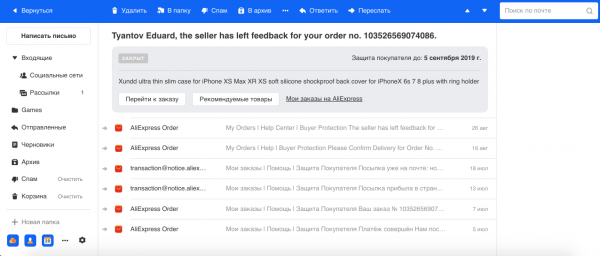
- Grupimi i letrave, që i përkasin porosive në dyqanet online. Ne shpesh blejmë në internet, dhe në përgjithësi, dyqanet mund të dërgojnë disa letra për çdo porosi. Për shembull, nga AliExpress, shërbimi më i madh, vijnë shumë letra për një porosi, dhe ne kemi llogaritur se në raste ekstremet e numri i tyre mund të arrijë deri në 29. Prandaj, me ndihmën e modelit të Njohjes së Entiteteve të Emëruara, ne identifikojmë numrin e porosisë dhe informacionin tjetër nga teksti dhe grupojmë të gjitha letrat në një temë. Po ashtu, ne tregojmë informacionin kryesor rreth porosisë në një panel të veçantë, që e bën punën me këtë lloj letre më të lehtë.

- AntifishikimiPërgjimi është një lloj i veçantë mashtrimi, përmes të cilit keqbërësit përpiqen të fitojnë informacion financiar (duke përfshirë informacionin mbi kartat bankare të përdoruesit) dhe kredencialet. Këto mesazhe imitohen nga ato reale, të dërguara nga shërbimi, përfshirë edhe vizualisht. Prandaj, përmes Computer Vision ne njohim logo dhe stilin e dizajnit të mesazheve të kompanive të mëdha (për shembull, Mail.ru, Sber, Alfa) dhe e marrim parasysh këtë së bashku me tekstin dhe karakteristika të tjera në klasifikatorët tanë të spamit dhe phishingut.
Mësimi makinerik
Pak për mësimin makinerik në postë në përgjithësi. Posta është një sistem me ngarkesë të lartë: nëpër serverat tanë kalojnë mesatarisht 1.5 miliard mesazhe në ditë për 30 milion përdorues DAU. Rreth 30 sisteme mësimi makinerik kërkojnë të shërbejnë të gjitha funksionet dhe karakteristikat e nevojshme.
Çdo mesazh kalon nëpër një konvej super klasifikimi. Së pari, ne filtrojmë spam-in dhe lëmë mesazhet e mira. Përdoruesit shpesh nuk e vërejnë punën e anti-spamit, sepse 95-99% e spam-it nuk arrin as në dosjen përkatëse. Njohja e spam-it është një pjesë shumë e rëndësishme e sistemit tonë dhe më e komplikuara, pasi në fushën e anti-spamit ka një adaptim të vazhdueshëm midis sistemeve mbrojtëse dhe sulmuese, që paraqet një sfidë të vazhdueshme inxhinierike për ekipin tonë.
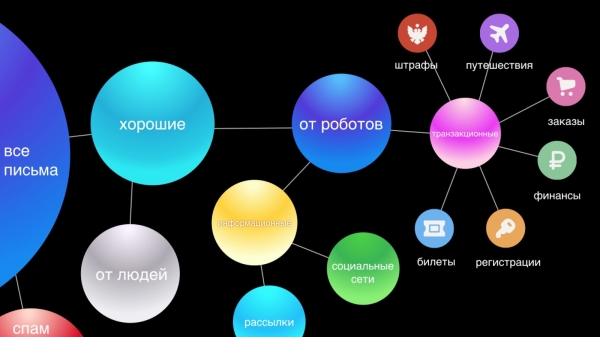
Më pas, ndarim mesazhet nga njerëzit dhe robotët. Mesazhet nga njerëzit janë më të rëndësishmet, prandaj për to ofrojmë funksione si Smart Reply. Mesazhet nga robotët ndahen në dy pjesë: transaksionale — ato janë mesazhe të rëndësishme nga shërbimet, për shembull, konfirmimet e blerjeve ose rezervimeve të hotelit, financat, dhe informative — këto janë reklamat e biznesit, zbritjet.
Ne mendojmë se mesazhet transaksionale janë po aq të rëndësishme sa bisedat personale. Ato duhet të jenë në dorë, sepse shpesh është e nevojshme të gjenden shpejt informacionet për një porosi ose rezervimin e një bilete avioni, dhe ne humbim kohë në kërkimin e këtyre mesazheve. Prandaj, për lehtësi, ne automatikisht i ndajmë ato në gjashtë kategori kryesore: udhëtime, porosi, financa, bileta, regjistrime dhe, në fund, ndëshkime.
Informacionet e email-it janë grupi më i shumëllojshëm dhe ndoshta më pak i rëndësishëm që nuk kërkon një reagim të menjëhershëm, pasi asgjë thelbësore nuk do të ndryshojë në jetën e përdoruesit nëse ai nuk e lexon një email të tillë. Në ndërfaqen tonë të re, ne i grumbullojmë ato në dy grupe: rrjetet sociale dhe dërgesat, duke pastruar vizualisht kutinë dhe duke lënë në shikim vetëm email-et e rëndësishme.
Eksplorimi
Një numër i madh sistemesh sjell shumë vështirësi në eksploatimin e tyre. Modelet me kalimin e kohës degradohen, ashtu si çdo software: shenjat prishen, makinat shkojnë në defekt, Kodi errësirave grumbullohet. Gjithashtu, të dhënat vazhdimisht ndryshojnë: shtohen të reja, transformohet modeli i zakonshëm i sjelljes së përdoruesve, etj. Prandaj, një model pa mbështetje të duhur me kalimin e kohës do të funksionojë gjithnjë e më keq.
Nuk duhet harruar as që sa më thellë të depërtojë mësimi i makinerive në jetën e përdoruesve, aq më shumë ndikim ata ushtrojnë në ekosistem, dhe, si rezultat, aq më shumë humbje financiare ose fitime mund të marrin aktorët e tregut. Prandaj, në një numër gjithnjë e më të madh fushash, aktorët adaptohen për të punuar me algoritmet e ML (shembuj klasikë — reklama, kërkimi dhe anti-spam i përmendur më parë).
Po ashtu, detyrat e mësimit të makinerive kanë një veçori: çdo ndryshim, madje edhe më i vogli, në sistem mund të prodhojë shumë punë me modelin: punë me të dhënat, ri-mësim, vendosje, që mund të zgjasë javë ose muaj. Prandaj, sa më shpejt të ndryshojë mjedisi në të cilin operojnë modelet tuaja, aq më shumë përpjekje kërkon mbështetja e tyre. Ekipa mund të krijojë shumë sisteme dhe të gëzohet për këtë, dhe pastaj të shpenzojë pothuajse të gjitha burimet në mbështetje të tyre, pa mundësi për të bërë diçka të re. Ne ndodhi një herë të përballemi me një situatë të tillë në ekipin tonë të anti-spamit. Dhe arritëm në përfundimin e qartë se mbështetja duhet automatizuar.
Automatizimi
Çfarë mund të automatizohet? Në të vërtetë, pothuajse gjithçka. Kam identifikuar katër drejtime që përkufizojnë infrastrukturën e mësimit të makinerive:
- mbledhja e të dhënave;
- ri-mësimi;
- vendosja;
- testimi & monitorimi.
Nëse ambienti është i paqëndrueshëm dhe ndryshon vazhdimisht, infrastruktura rreth modelit bëhet shumë më e rëndësishme se vetë modeli. Mund të jetë një klasifikues linear tradicional, por nëse e ushqejmë atë me karakteristika të sakta dhe krijojmë një reagim të mirë nga përdoruesit, ai do të funksionojë shumë më mirë se modelet më të avancuara teknologjike me gjitha mundësitë e reja.
Cikli i reagimit
Ky cikël përfshin mbledhjen e të dhënave, ri-trajnim dhe shpërndarje - në thelb, gjithë ciklin e azhurnimit të modelit. Pse është kjo e rëndësishme? Shikoni grafikun e regjistrimeve në postë:
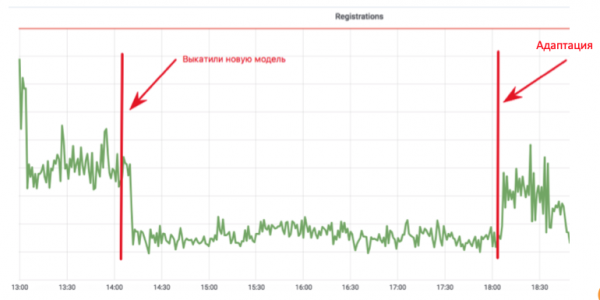
Një zhvillues i mësimit të makinerive ka implementuar një model anti-bot që nuk lejon botët të regjistrohen në postë. Grafiku bie deri në një pikë ku mbeten vetëm përdoruesit e vërtetë. E gjithë kjo është e shkëlqyer! Por kalojnë katër orë, dhe botët e përshtatin skenarin e tyre, dhe çdo gjë kthehet në normalitet. Në këtë implementim, zhvilluesi kaloi një muaj duke shtuar karakteristika dhe duke ri-trajnuar modelin, por spammer-at arritën të adaptohen brenda katër orësh.
Për të mos u ndjerë aq dhejë dhe për të mos pasur nevojë të rindërtojmë gjithçka, duhet të mendojmë fillimisht se si do të duket cikli i reagimit dhe çfarë do të bëjmë nëse ambienti ndryshon. Le të fillojmë me mbledhjen e të dhënave - kjo është karburanti për algoritmet tona.
Grumbullimi i të dhënave
Është e qartë se për rrjetet neurale moderne, sa më shumë të dhëna, aq më mirë, dhe ato, në thelb, generohet nga përdoruesit e produktit. Ne mund të ndihmohemi nga përdoruesit në etiketimin e të dhënave, por nuk duhet abuzuar me këtë, sepse në një moment përdoruesit do të lodhen duke trajnuar modelet tuaja dhe do të kalojnë në një produkt tjetër.
Një nga gabimet më të zakonshme (këtu po referohem te Andrew Ng) është orientimi i tepruar ndaj metrikave në setin testues, dhe jo ndaj reagimit nga përdoruesi, që në të vërtetë është matësi kryesor i cilësisë së punës, pasi ne krijojmë produkt për përdoruesin. Nëse përdoruesit nuk e kuptojnë ose nuk i pëlqen funksionimi i modelit, atëherë gjithçka është e kota.
Prandaj, përdoruesi gjithmonë duhet të ketë mundësinë të votojë, duhet t'i japim atij një mjet për reagimin. Nëse ne mendojmë se një mesazh që erdhi në kutinë postare është në lidhje me financat, duhet ta etiketojmë atë si "financa" dhe të skicojmë një buton që përdoruesi mund ta shtypë dhe të thotë se kjo nuk është financa.
Cilësia e reagimit
Le të flasim për cilësinë e feedback-ut të përdoruesve. Së pari, ju mund të keni kuptime të ndryshme për të njëjtin koncept me përdoruesin. Për shembull, ju dhe menaxherët e produkteve mund ta konsideroni "financën" si letra nga banka, ndërsa përdoruesi mendon se letra nga gjyshja për pensionin është gjithashtu e lidhur me financat. Së dyti, ka përdorues që godasin butonat pa ndonjë logjikë. Së treti, përdoruesi mund të jetë thellësisht i përhershëm në përfundimet e tij. Një shembull i shkëlqyer nga praktika jonë është implementimi i klasifikuesit , një lloj shumë qesharak i spam-it, kur përdoruesit u propozohet të marrin disa milion dollarë nga një të afërm të papritur në Afrikë. Pas implementimit të këtij klasifikuesi, ne kontrolluam klikimet "Nuk është spam" në këto letra, dhe doli se 80% e tyre ishin spam nigerian të shijshëm, gjë që tregon se përdoruesit mund të jenë jashtëzakonisht besnikë.
Dhe mos harrojmë se jo vetëm njerëzit mund të klikojnë në butona, por edhe disa bota që bëjnë sikur janë shfletues. Prandaj, feedback-u i papërpunuar nuk është i përshtatshëm për mësim. Çfarë mund të bëjmë me këtë informacion?
Ne aplikojmë dy qasje:
- Feedback nga ML i lidhur. Për shembull, ne kemi një sistem anti-bot online, i cili, siç e përmenda, merr një vendim të shpejtë bazuar në një numër të kufizuar karakteristikash. Dhe ka një sistem të dytë, të ngadalshëm, që punon post faktum. Ai ka më shumë të dhëna për përdoruesin, për sjelljen e tij, etj. Si pasoje, merret vendimi më i zgjedhur, si rezultat ka saktësi dhe plotesi më të lartë. Mund të dërgoni diferencën në punën e këtyre sistemeve në të parin si të dhëna për mësim. Kështu, sistemi më i thjeshtë do të përpiqet gjithmonë të afrojë performancën e sistemit më të komplikuar.
- Klasifikimi i klikimeve. Thjesht mund të klasifikojmë çdo klikim të përdoruesit, të vlerësojmë vlefshmërinë e tij dhe mundësinë e përdorimit. Kështu veprojmë në anti-spamin e postës, duke përdorur karakteristikat e përdoruesit, historinë e tij, karakteristikat e dërguesit, tekstin e vetë mesazhit dhe rezultatet e punës së klasifikatorëve. Në fund, arrijmë një sistem automatik që vlerëson feedback-un e përdoruesit. Dhe, pasi duhet ta stërvitim më pak shpesh, puna e tij mund të bëhet themelore për të gjitha sistemet e tjera. Përparësia kryesore në këtë model ka precision, sepse stërvitja e modelit me të dhëna të pasakta ka pasoja.
Ndërsa po pastrkojmë të dhënat dhe po stërvitim sistemet tona ML, nuk duhet të harrojmë për përdoruesit, sepse për ne mijëra, miliona gabime në grafik janë statistikë, por për përdoruesin çdo defekt është një tragjedi. Përveç faktit që përdoruesi duhet të jetojë me gabimin tuaj në produkt, ai pas feedback-ut pret që situata e tillë të përjashtohet në të ardhmen. Prandaj, gjithmonë duhet t'u japim përdoruesve jo vetëm mundësinë për të votuar, por edhe të korrigjojnë sjelljen e sistemeve ML, duke krijuar, për shembull, heuristika personale për secilin klikim, për rastin e postës, kjo mund të jetë mundësia për të filtruar mesazhe të ngjashme nga dërguesi dhe subjekti për këtë përdorues.
Gjithashtu, duhet të bazojmë modelin në raportet e ndonjë raporti ose kërkesave në mbështetje, në një mënyrë gjysmë automatike ose manuale, për të ndihmuar që përdoruesit e tjerë të mos vuajnë nga probleme të ngjashme.
Heuristika për stërvitje
Me këto heuristika dhe ndihma ka dy probleme. E para është se numri që rritet gjithmonë i ndihmave është i vështirë për t'u mbajtur, pa përmendur cilësinë dhe funksionimin e tyre në afat të gjatë. Problemi i dytë është se gabimi mund të mos jetë i shpeshtë, dhe disa klikime për të stërvitur modelin mund të mos mjaftojnë. Siç dukej, këta dy efekti që nuk lidhen mund të eliminohen në mënyrë të ndjeshme nëse aplikohet qasja e mëposhtme.
- Krijojmë një ndihmë të përkohshme.
- Dërgojmë të dhënat nga ajo në model, ai rregullisht stërvitet, përfshirë të dhënat e marra. Këtu, sigurisht, është e rëndësishme që heuristika të ketë një saktësi të lartë, për të mos ulur cilësinë e të dhënave në setin e trajnimit.
- Pastaj vendosim monitorimin për aktivizimin e kostilit, dhe nëse pas një kohe, kostili nuk aktivizohet më dhe plotësisht mbulohet nga modeli, atëherë mund ta heqim atë pa ndonjë hezitim. Tani kjo problem nuk ka gjasë të përsëritet.
Prandaj, një ushtri kostilesh është shumë e dobishme. E rëndësishme është që shërbimi i tyre të jetë urgjent dhe jo i përhershëm.
Rifitimi
Rifitimi është një proces i shtimit të të dhënave të reja, të marra si rezultat i reagimeve nga përdoruesit ose sisteme të tjera, dhe trajnimi i modelit ekzistues mbi to. Ka disa probleme që mund të lindin gjatë rifitimit:
- Modeli mund thjesht të mos mbështesë rifitimin dhe të mësojë vetëm nga e para.
- Askund në librin e natyrës nuk është shkruar se rifitimi patjetër do të përmirësojë cilësinë e punës në prodhim. Shpesh ndodh për të kundërtën, që do të thotë se është e mundur vetëm përkeqësimi.
- Ndryshimet mund të jenë të paparashikueshme. Ky është një aspekt mjaft delikat që ne e kemi zbuluar për veten. Edhe nëse modeli i ri në testin A/B tregon rezultate të ngjashme me ata aktual, kjo nuk do të thotë se do të funksionojë identikisht. Performanca e tyre mund të ndryshojë në ndonjë përqindje të vogël, e cila mund të sjellë gabime të reja ose të rikthejë gabime të vjetra që janë korrigjuar. Me gabimet aktuale, si ne ashtu edhe përdoruesit, tashmë dimë të jetojmë, dhe kur ndodhin shumë gabime të reja, përdoruesi gjithashtu mund të mos kuptojë se çfarë po ndodh, sepse ai pret sjellje të parashikueshme.
Prandaj, gjëja më e rëndësishme gjatë rifitimit është të garantosh përmirësimin e modelit, ose të paktën të mos e përkeqësosh atë.
E para që na vjen në mendje kur flasim për rifitimin, është qasja e Mësimit Aktiv. Çfarë do të thotë kjo? Për shembull, një klasifikues përcakton nëse një mesazh i përket financave, dhe përreth kufijve të vendosjes së vendimeve shtojmë një mostër nga shembuj të markuar. Kjo funksionon mirë, për shembull, në reklamim, ku ka shumë reagime dhe mund të trajnohet modeli në mënyrë online. Por nëse ka pak reagime, atëherë ne kemi një mostër shumë të shtrembëruar në lidhje me shpërndarjen e të dhënave në prodhim, mbi të cilën nuk mund të vlerësojmë sjelljen e modelit gjatë eksploatimit.
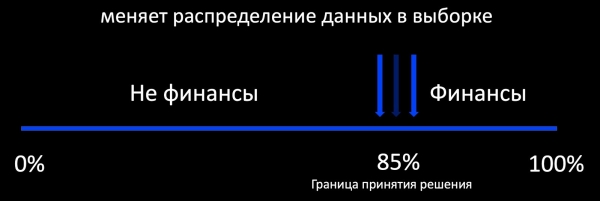
Në të vërtetë, qëllimi ynë është të ruajmë modelet e vjetra, ato të njohura, dhe të fitojmë të reja. Këtu kushtet është pasardhësia. Modeli, të cilin shpesh e lançojmë me shumë vështirësi, tashmë funksionon, kështu që mund të orientohemi nga performanca e tij.
Në postë përdoren modele të ndryshme: pemë, lineare, rrjeta nervore. Për secilën, ne krijojmë algoritmin tonë të përshtatjes. Gjatë procesit të përshtatjes, ne fitojmë jo vetëm të dhëna të reja, por shpesh ndodhin edhe karakteristika të reja që do t'i marrim parasysh në të gjithë algoritmet më poshtë.
Modelet lineare
Supozoni se kemi regresion logjistik. Ndërtojmë loss-in e modelit nga komponentët e mëposhtëm:
- LogLoss mbi të dhënat e reja;
- regularizojmë peshat e karakteristikave të reja (mos e preki të vjetrat);
- mësojmë edhe nga të dhënat e vjetra, për të ruajtur modelet e vjetra;
- dhe, ndoshta, më e rëndësishme: aplikojmë Harmonic Regularization, e cila garanton që pesha të mos ndryshojë shumë në krahasim me modelin e vjetër sipas normës.
Duke marrë parasysh se çdo komponent i humbjes ka koeficientë, ne mund t'i përshtatim vlerat optimale për detyrën tonë në kros-validim ose në bazë të kërkesave të produktit.
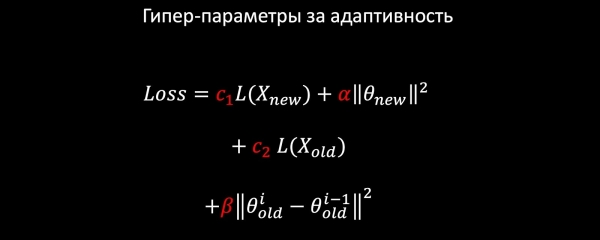
Pemët
Të kalojmë te pemët e vendimeve. Ne kemi filluar algoritmin e mëposhtëm për përshtatjen e pemëve:
- Në prodhim punon një pyll me 100—300 pemë, i trajnuar në grupin e vjetër të të dhënave.
- Në fund të fshijmë M = 5 pemë dhe shtojmë 2M = 10 të reja, të trajnuara mbi gjithë grupin e të dhënave, por me peshë të lartë për të dhënat e reja, që natyrshëm garanton një ndryshim inkremental të modelit.
E qartë se me kalimin e kohës numri i pemëve rritet ndjeshëm, dhe është e nevojshme t'i pakësojmë ato herë pas here për të qëndruar brenda afateve të caktuara. Për këtë, përdorim Knowledge Distillation (KD), që është tani gjithandej. Një përmbledhje e parimit të funksionimit të tij.
- Ne kemi modelin aktual "të komplikuar". E nisëm atë në grupin e të dhënave për trajnim dhe marrim shpërndarjen e mundësive të klasave në daljen.
- Më pas, e mësojmë modelin e nxënësit (në këtë rast, një model me numër më të vogël pemësh) të përsërisë rezultatet e punës së modelit, duke përdorur shpërndarjen e klasave si variablin e synuar.
- Është e rëndësishme të theksohet se ne nuk përdorim asnjë markup të dataset-it, dhe prandaj mund të përdorim të dhëna të rastësishme. Natyrisht, ne përdorim një mostër të dhënash nga dega e prodhimit si një mostër trajnimi për modelin e nxënësit. Kështu, seti i trajnimit na lejon të sigurojmë saktësinë e modelit, ndërsa mostra e rrjedhës garanton një performancë të ngjashme në shpërndarjen e prodhimit, duke kompensuar devijimin e mostrës së trajnimit.
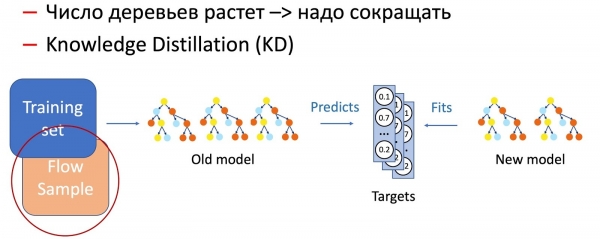
Kombinimi i këtyre dy metodave (shtimi i pemëve dhe reduktimi periodik i numrit të tyre përmes Knowledge Distillation) siguron hyrjen e modeleve të reja dhe vazhdimësinë të plotë.
Përmes KD ne gjithashtu bëjmë diferencimin e operacioneve me karakteristikat e modelit, për shembull, duke hequr karakteristika dhe punuar me mungesa. Në rastin tonë, ne kemi një sërë karakteristikash statistikore të rëndësishme (sipërmarrësit, hash-eve tekstuale, URL-ve, etj.) që ruhen në një bazë të dhënash që kanë prirjen për t'u ndalur. Ky zhvillim natyrisht, modeli nuk është i pregatitur, pasi situatat e ndalimit nuk përjetohen në setin e trajnimit. Në raste të tilla, ne kombinojmë teknikat KD dhe augmentimin: gjatë trajnimit për një pjesë të të dhënave, ne heqim ose nullojmë karakteristikat e nevojshme, ndërsa etiketat (daljet e modelit aktual) i marrim nga origjinali, modeli-nxënës mëson të përsërisë këtë shpërndarje.
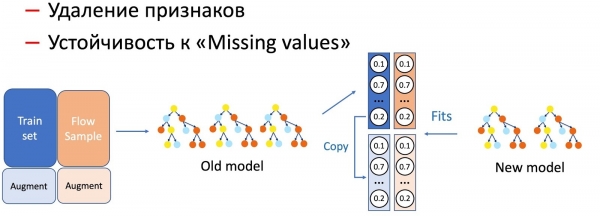
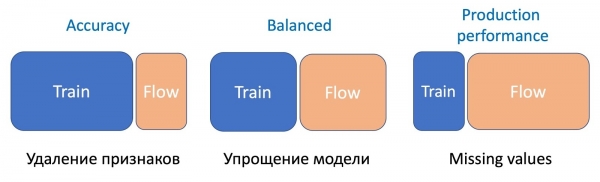
Vërejmë se sa më serioze të jetë manipulimi i modeleve, aq më shumë në përqindje kërkohet mostra e rrjedhës.
Për heqjen e karakteristikave, operacioni më i thjeshtë, kërkohet vetëm një pjesë e vogël e rrjedhës, pasi ndryshohet vetëm disa karakteristika, dhe modeli aktual është mësuar në të njëjtin set — ndryshimi është minimal. Për thjeshtimin e modelit (reduktimi i numrit të pemëve disa herë) kërkohet tashmë 50 nga 50. Dhe për mungesat e karakteristikave statistikore të rëndësishme, të cilat kanë një ndikim të konsiderueshëm në performancën e modelit, kërkohet edhe më shumë rrjedhë për të barazuar punën e modelit të ri të qëndrueshëm ndaj mungesave në të gjitha llojet e letrave.
FastText
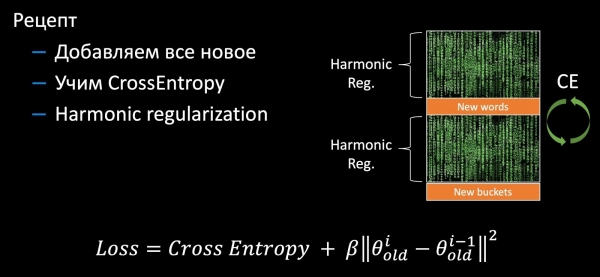
Të kalojmë te FastText. Kujtoj se përfaqësimi (Embedding) i fjalës përbëhet nga shuma e embedding-ut të vetë fjalës dhe të gjitha N-gramet e saj letrare, zakonisht trigramet. Pasi që trigramet mund të jenë mjaft të shumta, përdoret Bucket Hashing, pra transformimi i gjithë hapësirës në një hashmap të fikstë. Si rezultat, matrica e peshave merr dimensionet e shtresës së brendshme mbi numrin e fjalëve + baketet.
Gjatë ri-trajnimit shfaqen karakteristika të reja: fjalët dhe trigramet. Në ri-trajnimin standard nga Facebook nuk ndodh asgjë thelbësore. Vetëm pesha të vjetra trajnohen me entropinë e kryqëzuar mbi të dhëna të reja. Në këtë mënyrë, karakteristikat e reja nuk përdoren, natyrisht, ky qasje ka të gjitha disavantazhet e përmendura më parë, të lidhura me parashikueshmërinë e modelit në prodhim. Prandaj, ne e përmirësuam disi FastText-in. Shtojmë të gjitha peshat e reja (fjalët dhe trigramet), ri-trajnojmë të gjithë matricën me entropi të kryqëzuar dhe shtojmë rregullimin harmonik në përputhje me modelin linear, i cili garanton një ndryshim të papërfillshëm të peshave të vjetra.
CNN
Me rrjetet konvencionale është pak më e komplikuar. Nëse në CNN trajnoni shtresat e fundit, natyrisht, mund të aplikoni rregullimin harmonik dhe të garantoni vazhdimësinë. Por në rastin kur kërkohet ri-trajnim i gjithë rrjetit, atëherë një rregullim të tillë nuk mund ta vendosni në të gjitha shtresat. Megjithatë, ka një opsion për mësimin e embedding-ëve komplementarë përmes Triplet Loss ().
Triplet Loss
Në shembullin e detyrës së anti-phishing, do të analizojmë në terma të përgjithshëm Triplet Loss. Marrim logon tonë, si dhe shembuj pozitivë dhe negativë të logove të kompanive të tjera. Minimizohet distanca midis të parëve dhe maksimumizohet distanca midis të dytëve, duke bërë këtë me një hap të vogël për të siguruar një kompaktesë më të madhe të klasave.
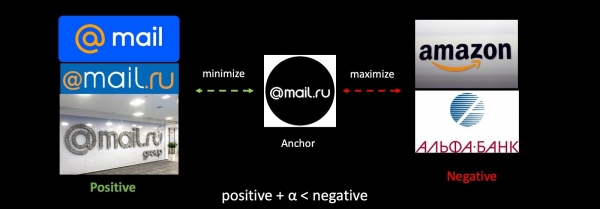
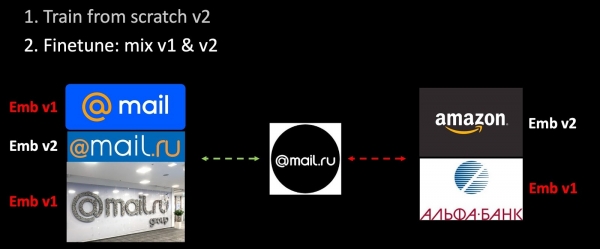
Nëse ne ri-trajnojmë rrjetin, atëherë ne e ndryshojmë plotësisht hapësirën metrike, dhe ajo bëhet plotësisht e papajtueshme me të mëparshmen. Kjo është një problem serioz në detyrat që përdorin vektorët. Për ta zgjidhur këtë problem, ne do të përziem gjatë trajnimit embedding-et e vjetra.
Kemi shtuar të dhëna të reja në setin e trajnimit dhe po e trajnojmë nga e para versionin e dytë të modelit. Në fazën e dytë ne po e përfundojmë rrjetin tonë (Finetuning): fillimisht përfundohet shtresa e fundit, dhe pastaj e gjithë rrjeti lirohet. Gjatë procesit të formimit të tripleteve, vetëm një pjesë e embedDing-eve llogaritet me modelin e trajnuar, ndryshe pjesa tjetër llogaritet me modelin e vjetër. Kështu, gjatë procesit të ndërtrajnimit ne sigurojmë përshtatshmërinë e hapësirave metrikore v1 dhe v2. Një variant i veçantë i rregullimit harmonik.
Arktitektura erës
Nëse e shqyrtojmë sistemin tërësisht me shembullin e anti-spam-it, modelet nuk janë të izoluar, por të ndërlidhura njëra me tjetrën. Merrni imazhe, tekst dhe karakteristika të tjera, me ndihmën e CNN dhe Fast Text merrni embedDing-e. Më pas, mbi embedDing-et aplikohet klasifikuesi, i cili jep skoret për klasa të ndryshme (tipet e letrave, spam, prania e logos). Skoret dhe karakteristikat tashmë kalojnë në pyllin e pemëve për të marrë vendimin përfundimtar. Klasifikues të veçantë në këtë skemë lejojnë të interpretojmë më mirë rezultatet e punës së sistemit dhe të përmirësojmë komponentet në rast të problemeve, sesa të paraqesim të dhënat e tëra si janë në pemët e vendimeve.
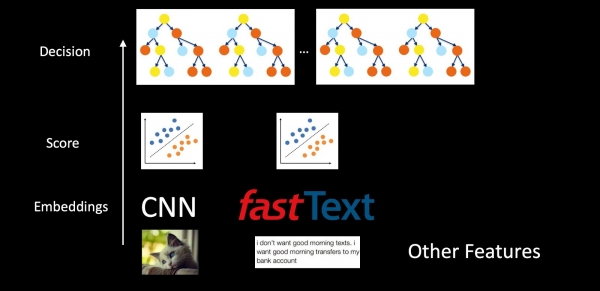
Në fund ne garantuam vazhdimësinë në çdo nivel. Në nivelin e poshtëm në CNN dhe Fast Text përdorim rregullimin harmonik, për klasifikuesit në mes — gjithashtu rregullim harmonik dhe kalibrim të skoreve për të siguruar përputhshmërinë e shpërndarjes së probabilitetit. Ndërsa mbushja e pemëve trajnohet në mënyrë incrementale ose me ndihmën e Knowledge Distillation.
Në përgjithësi, mbështetja e një sistemi të tillë të ndërlidhur të mësimit të makinerive zakonisht paraqet sfida, pasi çdo komponent në nivelin e poshtëm çon në përditësimin e gjithë sistemit lart. Por, pasi në konfigurimin tonë çdo komponent ndryshon pak dhe është kompatibil me të kaluarin, e gjithë sistemi mund të përditësohet në pjesë pa pasur nevojë të ri-trajnohet e gjithë struktura, gjë që e lejon ta mbajmë atë pa kosto të larta.
Deploy
Kemi trajtuar mbledhjen e të dhënave dhe ri-trajnimin e tipeve të ndryshme të modeleve, prandaj kalojmë në implementimin e tyre në ambientin e prodhimit.
A/B-testimi
Si e thashë më herët, gjatë procesit të grumbullimit të të dhënave, zakonisht marrim një mostër të shtrembëruar, për të cilën nuk është e mundur të vlerësojmë performancën e modelit në prodhim. Prandaj, gjatë implementimit, është thelbësore të krahasohet modeli me versionin e mëparshëm, për të kuptuar se si po shkojnë realisht ndodhitë, duke kryer teste A/B. Në të vërtetë, procesi i lansimit dhe analizimi i grafikëve është mjaft rutinë dhe i përshtatet automatikimit shumë mirë. Ne e lançojmë modelet tona gradualisht për 5%, 30%, 50% dhe 100% të përdoruesve, duke mbledhur të gjitha metrikat e disponueshme për përgjigjet e modelit dhe feedbackun e përdoruesve. Në rast të ndonjë shpërthimi të rëndësishëm, ne e kthejmë automatikisht modelin, ndërsa për rastet e tjera, pasi të kemi mbledhur një numër të mjaftueshëm klikimesh nga përdoruesit, marrim vendim për të rritur përqindjen. Në fund, ne e çojmë modelin e ri deri në 50% të përdoruesve plotësisht automatikisht, ndërsa personi e aprovon lansimin për audiencën e gjithë përmbajtjes, edhe pse ky hap gjithashtu mund të automatizohet.
Megjithatë, procesi i testeve A/B ofron mundësi për optimizim. E gjithë çështja është se çdo test A/B është mjaft i gjatë (në rastin tonë zgjat nga 6 deri në 24 orë, në varësi të numrit të feedbackut), që e bën atë mjaft të shtrenjtë dhe me burime të kufizuara. Përveç kësaj, kërkohet një përqindje e mjaftueshme e fluksit për testin, për të përshpejtuar kohën e përgjithshme të testit A/B (të grumbullosh një mostër statistike të rëndësishme për të vlerësuar metrikat me një përqindje të vogël mund të marrë shumë kohë), që e bën numrin e vendeve të A/B testeve jashtëzakonisht të kufizuar. Sigurisht, na duhet të sjellim në test vetëm modelet më premtuese, të cilat ne i marrim mjaft gjatë procesit të rikualifikimit.
Për të zgjidhur këtë çështje, ne kemi trajnuar një klasifikues të veçantë, që parashikon suksesin e testit A/B. Për këtë, si karakteristika përdorim statistikën e marrjes së vendimeve, Precision, Recall dhe metrika të tjera në grupin e trajnimet, në mostrat e rezervuara dhe në mostrat nga fluksi. Gjithashtu, krahasojmë modelin me atë aktual në prodhim, me heuristat, dhe marrim parasysh kompleksitetin (Complexity) e modelit. Duke përdorur të gjitha këto karakteristika, klasifikuesi i trajnuar mbi historinë e testeve vlerëson modelet kandidate, në rastin tonë këto janë pyjet e pemëve, dhe merr vendim se cili prej tyre të dërgohet në testin A/B.
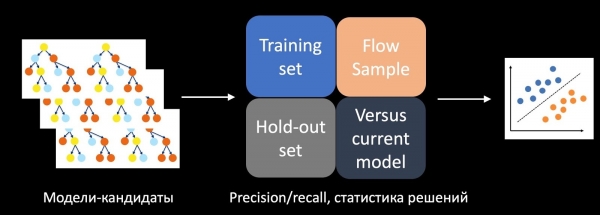
Në momentin e implementimit, ky qasje lejo të rritet disa herë numri i testeve A/B të suksesshme.
Testimi & monitorimi
Testimi dhe monitorimi, çuditërisht, nuk dëmtojnë shëndetin tonë; përkundrazi, e përmirësojnë dhe na ndihmojnë të heqim qafe stresin e tepërt. Testimi lejon parandalimin e dështimeve, ndërsa monitorimi – zbardhjen e tyre në kohë, për të zvogëluar ndikimin mbi përdoruesit.
Këtu është e rëndësishme të kuptojmë se herët apo vonë, sistemi juaj gjithmonë do të gabojë – kjo është e lidhur me ciklin e zhvillimit të çdo programi. Në fillim të zhvillimit të sistemit, ka shumë gabime derisa gjithçka të stabilizohet dhe të përfundojë faza kryesore e inovacioneve. Por me kalimin e kohës, entropia merr mbizotërimin dhe gabimet shfaqen sërish – për shkak të degradimit të komponenteve përreth dhe ndryshimeve në të dhëna, siç thashë në fillim.
Këtu do të doja të theksoja se çdo sistem mësimi makinerik duhet të shqyrtohet nga këndvështrimi i përfitimit të tij gjatë gjithë ciklit të jetës. Më poshtë në grafik tregohet një shembull i funksionimit të një sistemi për kapjen e spamit të rrallë (në grafik, linja është afër zeros). Njëherë, për shkak të një karakteristike të keqakumuluar, ai u çmend. Çuditërisht, nuk kishte monitorim për aktivizim anormal, e në rezultat, sistemi filloi të ruajë e-maile në folderin "spam" në pragun e vendimmarrjes në një sasi të madhe. Pavarësisht nga përmirësimi i pasojave, sistemi tashmë kishte gabuar aq shumë herë sa nuk do ta mbulonte shpenzimin dhe për pesë vjet. Kjo është një dështim i plotë nga pikëpamja e ciklit të jetës së modelit.
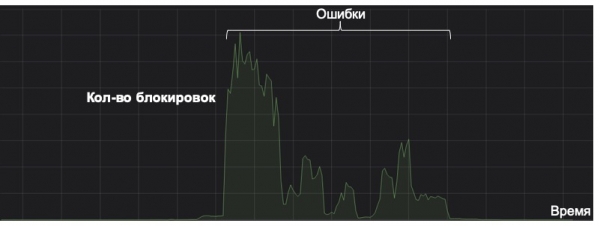
Prandaj, një gjë e tillë e thjeshtë si monitorimi mund të bëhet kyç në jetën e modelit. Përveç metrikave standarde dhe të qarta, ne shqyrtojmë shpërndarjen e përgjigjeve dhe skorëve të modelit, si dhe shpërndarjen e vlerave të karakteristikave kyçe. Me ndihmën e divergjencës KL, ne mund të krahasojmë shpërndarjen aktuale me atë historike ose vlerat në testin A/B me rrjedhën e tjera, që na lejon të vërejmë anomali në model dhe të rikthejmë ndërrimet në kohë.
Në shumicën e rasteve, ne e nisëm versionin tonë të parë të sistemeve duke përdorur heuristika të thjeshta ose modele, të cilat më vonë i përdorim për monitorim. Për shembull, ne monitorojmë modelin NER në krahasim me regex për dyqanet specifike online, dhe nëse mbulimi i klasifikuesit bie në krahasim me to, ne shqyrtojmë arsyet. Një tjetër përdorim i dobishëm i heuristikave!
Përfundime
Le të kalojmë përsëri përmes mendimeve kyçe të artikullit.
- Fibdaek. Kemi gjithmonë parasysh përdoruesin: si do të jetojë ai me gabimet tona, si do të mund t'i raportojë ato. Mos harro, që përdoruesit nuk janë burim i sishtëm i feedback-ut për të stërvitur modelet, dhe është e nevojshme të filtrohet përmes sistemeve mbështetëse ML. Nëse nuk ka mundësi për të mbledhur sinjal nga përdoruesi, ne kërkojmë burime alternative feedback-u, për shembull, sisteme të lidhura.
- Rifitimi. Këtu e rëndësishme është vazhdimësia, prandaj mbështetemi në modelin aktual të prodhimit. Modelet e reja i stërvitim kështu që ato të mos shfaqin ndryshime të mëdha nga të mëparshmet përmes rregullimit harmonik dhe trukesh të ngjashme.
- Deploy. Autodeploy sipas metrikeve redukton ndjeshëm kohën e zbatimit të modeleve. Monitorimi i statistikave dhe shpërndarjes së vendimeve, numri i gabimeve nga përdoruesit është obligativ për një gjumë të qetë dhe fundjava produktive.
Shpresoj që ajo që lexuat do t'ju ndihmojë të përmirësoni më shpejt sistemet tuaja ML, të përshpejtoni daljen e tyre në treg dhe t'i bëni ato më të besueshme, duke reduktuar nivelet e stresit nga puna.
Burimi: habr.com
