

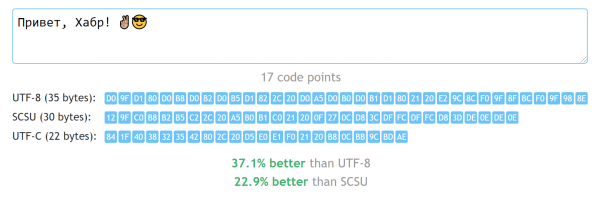
Nëse jeni zhvillues dhe duhet të zgjidhni një kodim, pothuajse gjithmonë zgjedhja e duhur është Unicode. Mënyra konkrete e përfaqësimit varet nga konteksti, por në shumicën e rasteve edhe këtu ka një përgjigje universale — UTF-8. Ai është i mirë sepse ju lejon të përdorni të gjitha simbolet e Unicode pa shpenzuar tepër shumë byte në shumicën e rasteve. Megjithatë, për gjuhët që nuk përdorin vetëm alfabetin latin, “jo shumë” do të thotë të paktën dy byte për simbol. A mund të bëhet më mirë, pa u kthyer te kodimet parahistorike që na kufizojnë në vetëm 256 simbole të disponueshme?
Më poshtë po ju prezantoj përpjekjen time për t’iu përgjigjur kësaj pyetjeje dhe një zbatim të një algoritmi relativisht të thjeshtë, që lejon ruajtjen e vargjeve në shumicën e gjuhëve të botës pa shtuar atë tepricë që ekziston në UTF-8.
Diskleimer. Që në fillim do të bëj disa sqarime të rëndësishme: zgjidhja e përshkruar nuk propozohet si zëvendësim universal për UTF-8, ajo është e përshtatshme vetëm për një numër të kufizuar rastesh (për to më poshtë) dhe në asnjë mënyrë nuk duhet përdorur për ndërveprim me API të palëve të treta (të cilat as që dinë për të). Në shumicën e rasteve, për ruajtje kompakte të vëllimeve të mëdha të të dhënave tekstuale, janë më të përshtatshëm algoritmet e kompresimit me përdorim të përgjithshëm (për shembull, deflate). Për më tepër, tashmë gjatë krijimit të zgjidhjes sime gjeta një standard ekzistues brenda vetë Unicode që zgjidh të njëjtën detyrë — ai është disi më kompleks (dhe jo rrallë më i dobët), por gjithsesi është një standard i pranuar, jo një zgjidhje e improvizuar. Edhe për të do të flas.
Për Unicode dhe UTF-8
Për të filluar — disa fjalë se çfarë janë në të vërtetë Unicode dhe UTF-8.
Siç dihet, dikur kodimet 8-bitëshe ishin shumë të përhapura. Me to gjithçka ishte e thjeshtë: 256 simbole mund të numëroheshin me vlera nga 0 deri në 255, dhe numrat nga 0 deri në 255 përfaqësohen natyrshëm me një byte. Nëse kthehemi te fillesat, atëherë kodimi ASCII madje kufizohet në 7 bite, prandaj biti më i lartë në paraqitjen e tij me byte është zero, dhe shumica e kodimeve 8-bitëshe janë në përputhje me të (ato ndryshojnë vetëm në pjesën “e sipërme”, ku biti më i lartë është një).
Çfarë e dallon Unicode nga ato kodime dhe pse me të lidhen disa formate konkrete njëherësh — UTF-8, UTF-16 (BE dhe LE), UTF-32? Le ta shqyrtojmë me radhë.
Standardi bazë i Unicode përshkruan vetëm përputhjen midis simboleve (dhe në disa raste edhe midis përbërësve të veçantë të simboleve) dhe numrave të tyre. Dhe numrat e mundshëm në këtë standard janë shumë të shumtë — nga 0x00 në 0x10FFFF (1 114 112 gjithsej). Nëse do të donim të ruanim një numër nga ky interval në një variabël, as 1 dhe as 2 bajt nuk do të mjaftonin. Dhe meqë procesorët tanë nuk janë fort të optimizuar për punë me numra trebajtësh, do të detyroheshim të përdornim plot 4 bajt për një simbol të vetëm! Kjo është pikërisht UTF-32, por për shkak të këtij “shpenzimi” të tepruar ky format nuk është i përhapur.
Për fat të mirë, simbolet brenda Unicode nuk janë renditur rastësisht. I gjithë grupi i tyre ndahet në 17 “plane”, secila prej të cilave përmban 65536 (0x10000) «pika kodi”. Koncepti i “pikës së kodit” këtu është thjesht numri i simbolit, që i është caktuar nga Unicode. Por, siç u përmend më sipër, në Unicode janë të numëruar jo vetëm simbolet e veçanta, por edhe përbërësit e tyre dhe shenjat shërbyese (madje ndonjëherë një numri nuk i korrespondon asgjë — ndoshta vetëm përkohësisht, por për ne kjo nuk ka shumë rëndësi), prandaj është më e saktë të flitet gjithmonë për vetë numrat, jo për simbolet. Megjithatë, më poshtë për shkurtësi do ta përdor shpesh fjalën “simbol”, duke pasur parasysh termin “pikë kodi”.
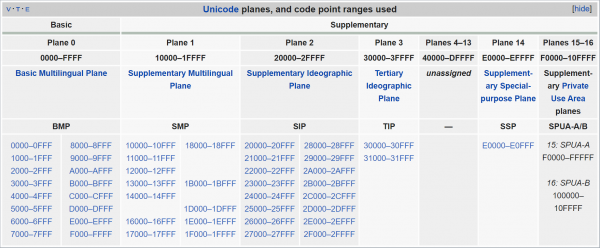
Planet e Unicode. Siç shihet, pjesa më e madhe (planet nga 4 deri në 13) ende nuk është përdorur.
Më e mira është se e gjithë pjesa kryesore ndodhet në planin zero, i cili quhet "Basic Multilingual Plane". Nëse një varg përmban tekst në një nga gjuhët moderne (përfshirë kinezishten), nuk do të dilni jashtë këtij plani. Por as pjesa tjetër e Unicode nuk mund të lihet mënjanë — për shembull, emoji-t ndodhen kryesisht në fund të planit pasues, "Supplementary Multilingual Plane" (i cili shtrihet nga 0x10000 në 0x1FFFF). Prandaj UTF-16 vepron kështu: të gjitha simbolet që bien në Basic Multilingual Plane, kodohen «siç janë», me numrin dybajtësh që u korrespondon. Megjithatë, një pjesë e numrave në këtë interval nuk përfaqësojnë fare karaktere të caktuara, por tregojnë se pas kësaj dysheje bajtësh duhet të merret në shqyrtim edhe një tjetër — duke kombinuar vlerat e këtyre katër bajtëve, marrim një numër që mbulon të gjithë intervalin e lejuar të Unicode. Ky paraqitje quhet «çifte surrogate» — ndoshta keni dëgjuar për to.
Kështu, UTF-16 kërkon dy ose (në raste shumë të rralla) katër bajtë për një «pikë kodi». Kjo është më mirë sesa të përdoren vazhdimisht katër bajtë, por alfabeti latin (dhe simbolet e tjera ASCII) me këtë kodim shpenzon gjysmën e hapësirës për zero. UTF-8 synon ta korrigjojë këtë: ASCII në të zë, si më parë, vetëm një bajt; kodet nga 0x80 në 0x7FF — dy bajtë; nga 0x800 në 0xFFFF — tre, ndërsa nga 0x10000 në 0x10FFFF — katër. Nga njëra anë, alfabeti latin përfitoi: u rikthye përputhshmëria me ASCII dhe shpërndarja u bë më e njëtrajtshme, e «shtrirë» nga 1 deri në 4 bajtë. Por alfabetet jo latine, për fat të keq, nuk fitojnë asgjë krahasuar me UTF-16, madje shumë prej tyre tani kërkojnë tre bajtë në vend të dyve — intervali që mbulohet nga shkrimi dybajtësh është ngushtuar 32 herë, nga 0xFFFF në 0x7FF, dhe në të nuk futen më as kinezishtja, as, për shembull, gjeorgjishtja. Cirilikja dhe edhe pesë alfabete të tjera — ura — patën fat, 2 bajtë për simbol.
Pse ndodh kështu? Le të shohim se si UTF-8 i paraqet kodet e karaktereve:
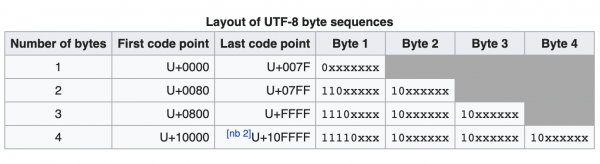
Për paraqitjen e drejtpërdrejtë të numrave këtu janë përdorur bitët e shënuar me simbolin x. Shihet se në shkrimin dybajtësh ka vetëm 11 bitë të tillë (nga 16). Bitët udhëheqës këtu kanë vetëm funksion shërbyes. Në rastin e shkrimit katërbajtësh, për numrin e pikës së kodit janë caktuar vetëm 21 bitë nga 32 — në dukje, këtu do të mjaftonin edhe tre bajtë (që japin gjithsej 24 bitë), por shënuesit shërbyes zënë tepër shumë.
A është kjo keq? Në fakt, jo edhe aq. Nga njëra anë, nëse na shqetëson shumë hapësira e zënë, kemi algoritme kompresimi që e eliminojnë lehtësisht gjithë entropinë dhe tepricën e panevojshme. Nga ana tjetër, qëllimi i Unicode ishte të ofronte një kodim sa më universal. Për shembull, një varg i koduar në UTF-8 mund t’ia besojmë kodit që më parë punonte vetëm me ASCII, pa u shqetësuar se ai do të ndeshë aty një simbol nga diapazoni ASCII që në të vërtetë nuk ekziston aty (sepse në UTF-8 të gjithë bajtat që fillojnë me bit zero janë pikërisht ASCII). Dhe nëse papritur duam të presim një bisht të vogël nga një varg i madh, pa e dekoduar nga fillimi (ose të rikuperojmë një pjesë të informacionit pas një segmenti të dëmtuar) — nuk është e vështirë të gjejmë zhvendosjen ku fillon një simbol (mjafton të anashkalohen bajtat që kanë prefiksin bitor 10).
Atëherë pse të shpikim diçka të re?
Megjithatë, herë pas here ka situata kur algoritmet e kompresimit si deflate nuk zbatohen mirë, ndërsa ruajtja kompakte e vargjeve mbetet e dëshirueshme. Personalisht u ndesha me një detyrë të tillë, duke menduar për ndërtimin e për një fjalor të madh që përfshin fjalë në gjuhë të ndryshme. Nga njëra anë, çdo fjalë është shumë e shkurtër, prandaj kompresimi i saj nuk do të ishte efikas. Nga ana tjetër, implementimi i pemës që po shqyrtoja ishte ndërtuar mbi parimin që çdo bajt i vargut të ruajtur krijonte një nyje të veçantë të pemës, ndaj minimizimi i numrit të tyre ishte shumë i dobishëm. Në bibliotekën time (si edhe në , mbi të cilën ajo bazohet) ky problem zgjidhet thjesht — vargjet e paketuara në -fjalor ruhen aty në . Por, siç kuptohet lehtë, kjo funksionon mirë vetëm për një alfabet të kufizuar — një varg në kinezisht nuk mund të futet më në një fjalor të tillë.
Veçmas dua të theksoj edhe një nuancë tjetër të pakëndshme që shfaqet kur përdoret UTF-8 në një strukturë të tillë të dhënash. Në figurën më sipër shihet se kur një simbol shkruhet me dy bajta, bitet që i përkasin numrit të tij nuk vendosen njëri pas tjetrit, por ndërpriten nga një palë bitesh 10 në mes: 110xxxxx 10xxxxxx. Për shkak të kësaj, kur në kodin e simbolit mbushen 6 bitet më të ulëta të bajtit të dytë (domethënë ndodh kalimi 10111111 → 10000000), atëherë ndryshon edhe bajti i parë. Si rezultat, shkronja «п» përfaqësohet nga bajtat 0xD0 0xBF, ndërsa «р» që vjen pas saj është tashmë 0xD1 0x80. Në pemën e prefikseve kjo çon në ndarjen e nyjës prind në dy pjesë — njëra për prefiksin 0xD0, dhe tjetra për 0xD1 (edhe pse i gjithë alfabeti cirilik mund të kodohej vetëm me bajtin e dytë).
Çfarë arrita të krijoj
Kur u përballa me këtë detyrë, vendosa të ushtrohesha pak me manipulimin e biteve dhe njëkohësisht të njihesha më mirë me strukturën e Unicode në përgjithësi. Si rezultat doli formati i kodimit UTF-C («C» nga compact), i cili përdor jo më shumë se 3 bajt për një pikë kodi dhe shumë shpesh lejon të përdoret vetëm një bajt shtesë për gjithë vargun që po kodohet. Kjo bën që, për shumë alfabete jo-ASCII, ky kodim të jetë 30-60% më kompakt se UTF-8.
I kam përgatitur shembujt e implementimit të algoritmeve të kodimit dhe dekodimit në formën e , të cilat mund t’i përdorni lirisht në kodin tuaj. Megjithatë, dua të theksoj se në njëfarë kuptimi ky format mbetet një «zgjidhje artizanale», dhe nuk rekomandoj ta përdorni pa e kuptuar qartë pse ju nevojitet. Në fund të fundit, ky është më shumë një eksperiment sesa një «përmirësim serioz i UTF-8». Megjithatë, kodi aty është shkruar me kujdes, në mënyrë koncize, me shumë komente dhe me mbulim testesh.
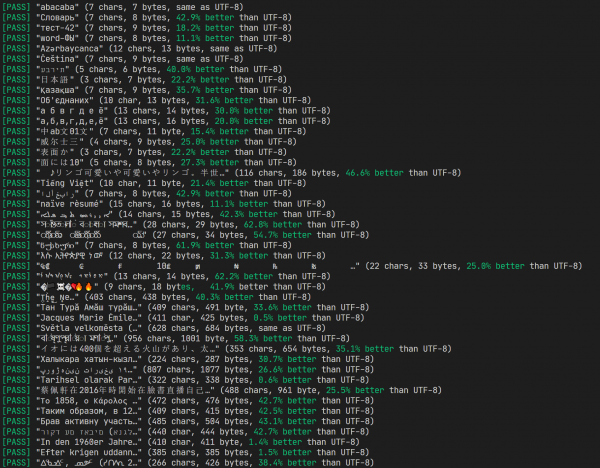
Rezultati i ekzekutimit të testeve dhe krahasimi me UTF-8
Gjithashtu kam krijuar një , ku mund të vlerësoni funksionimin e algoritmit, ndërsa më poshtë do të tregoj më hollësisht për parimet e tij dhe procesin e zhvillimit.
Heqim bitët e tepërt
Si bazë mora, sigurisht, UTF-8. Gjëja e parë dhe më e dukshme që mund të ndryshohet aty është ulja e numrit të biteve shërbyes në çdo bajt. Për shembull, bajti i parë në UTF-8 gjithmonë fillon ose me 0, ose me 11 — ndërsa prefiksi 10 gjendet vetëm te bajtet pasuese. Le ta zëvendësojmë prefiksin 11 në 1, ndërsa te bajtet pasuese t’i heqim fare prefikset. Çfarë do të dalë?
0xxxxxxx — 1 bajt
10xxxxxx xxxxxxxx — 2 bajte
110xxxxx xxxxxxxx xxxxxxxx — 3 bajte
Ndal, po ku shkoi shkrimi me katër bajte? Ai nuk nevojitet më — me shkrimin në tre bajte tani kemi në dispozicion 21 bit dhe kjo mjafton me tepricë për të gjithë numrat deri në 0x10FFFF.
Çfarë sakrifikuam këtu? Më kryesorja — zbulimin e kufijve të simboleve nga një pozicion arbitrar në buffer. Nuk mund të tregojmë një bajt çfarëdo dhe prej tij të gjejmë fillimin e simbolit pasues. Ky është një kufizim i formatit tonë, por në praktikë nevoja për këtë lind rrallë. Zakonisht mund ta përshkojmë buffer-in që nga fillimi (sidomos kur bëhet fjalë për vargje të shkurtra).
Situata me mbulimin e gjuhëve me 2 bajte është përmirësuar gjithashtu: tani formati dybajtësh jep një diapazon prej 14 bitësh, pra kode deri në 0x3FFF. Kinezët nuk kanë shumë fat (hieroglifet e tyre ndodhen kryesisht në intervalin nga 0x4E00 në 0x9FFF), por për gjeorgjianët dhe shumë popuj të tjerë gjërat janë bërë më të mira — gjuhët e tyre gjithashtu futen në 2 bajte për simbol.
Vendosim gjendjen e enkoderit
Tani le të mendojmë për vetitë e vetë vargjeve. Në fjalor zakonisht gjenden fjalë të shkruara me simbole të të njëjtit alfabet, dhe kjo vlen edhe për shumë tekste të tjera. Do të ishte mirë ta përcaktonim këtë alfabet një herë, e më pas të tregonim vetëm numrin e shkronjës brenda tij. Le të shohim nëse mund të na ndihmojë vendosja e simboleve në tabelën Unicode.
Siç u tha më sipër, Unicode ndahet në plane me nga 65536 kode secili. Por kjo nuk është një ndarje shumë e dobishme (siç u përmend, më shpesh ndodhemi në planin zero). Më interesant është ndarja në blloqe. Këto intervale nuk kanë më gjatësi fikse dhe mbartin më shumë kuptim — si rregull, secili bashkon simbolet e një alfabeti.
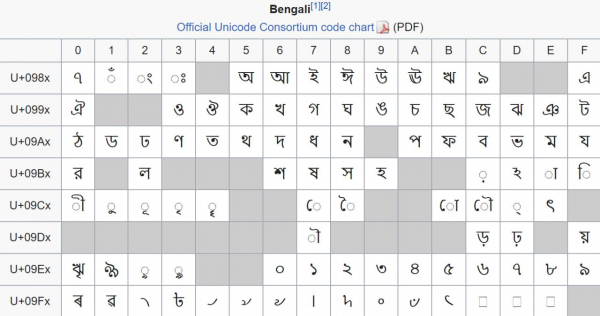
Blloku që përmban simbolet e alfabetit bengalez. Fatkeqësisht, për arsye historike, ky është një shembull i paketimit jo shumë të dendur — 96 simbole janë shpërndarë në mënyrë kaotike në 128 pika kodi të bllokut.
Fillimet e blloqeve dhe madhësitë e tyre janë gjithmonë shumëfish i 16 — kjo është bërë thjesht për lehtësi. Përveç kësaj, shumë blloqe fillojnë dhe mbarojnë me vlera shumëfish i 128 apo edhe 256 — për shembull, кирилица bazë zë 256 bajte nga 0x0400 në 0x04FF. Kjo është mjaft e përshtatshme: nëse ruajmë një herë prefiksin 0x04, atëherë më pas çdo simbol кирилик mund të shkruhet me një bajt. Vërtet, kështu humbasim mundësinë për t'u kthyer te ASCII (dhe te çdo simbol tjetër në përgjithësi). Prandaj veprojmë kështu:
- Dy bajte
10yyyyyy yxxxxxxxjo vetëm që tregojnë simbolin me numrinYyyyyy yxxxxxxx, por edhe ndryshojnë alfabetin aktual nëyyyyyy y0000000(d.m.th. ruajmë të gjithë bitët, përveç 7 bitëve); - Një bajt
0xxxxxxxështë simbol i alfabetit aktual. Mjafton ta mbledhim me zhvendosjen që ruajtëm në hapin 1. Për sa kohë që alfabetin nuk e kemi ndryshuar, zhvendosja është zero, kështu që përputhshmërinë me ASCII e kemi ruajtur.
Në mënyrë të ngjashme për kodet që kërkojnë 3 bajte:
- Tre bajte
110yyyyy yxxxxxxx xxxxxxxxtregojnë simbolin me numrinyyyyyy yxxxxxxx xxxxxxxx, ndryshojnë alfabetin aktual nëyyyyyy y0000000 00000000(ruajtëm gjithçka, përveç 15 bitëve), dhe vendosin një flamur që tani jemi në regjimin të gjatë në regjim (kur alfabeti kthehet sërish në dybajtësh, këtë flamur do ta çaktivizojmë); - Dy bajte
0xxxxxxx xxxxxxxxnë regjimin e gjatë ky është simboli i alfabetit aktual. Po ashtu, e mbledhim me zhvendosjen nga hapi 1. I vetmi ndryshim është se tani lexojmë nga dy bajte (sepse kemi kaluar në këtë regjim).
Tingëllon mirë: tani, për sa kohë që duhet të kodojmë simbole nga i njëjti diapazon 7-bitësh i Unicode, harxhojmë 1 bajt shtesë në fillim dhe vetëm nga një bajt për çdo simbol.
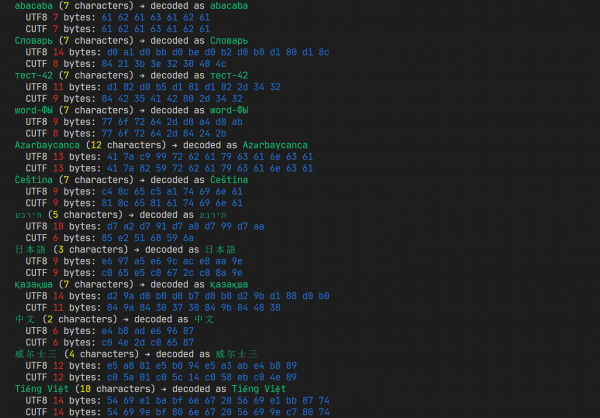
Puna e njërit prej versioneve të hershme. Tashmë jo rrallë e kalon UTF-8, por ka ende vend për përmirësim.
Çfarë u përkeqësua? Së pari, u shfaq gjendja, përkatësisht zhvendosja e alfabetit aktual dhe flamuri i regjimit të gjatë. Kjo na kufizon më shumë: tani të njëjtat simbole mund të kodohen ndryshe në kontekste të ndryshme. Kërkimi i nënvargjeve, për shembull, tashmë duhet të bëhet duke e marrë parasysh këtë, e jo thjesht duke krahasuar bajtet. Së dyti, sapo e ndryshuam alfabetin, kodimi i simboleve ASCII u bë më i papërshtatshëm (dhe kjo nuk është vetëm latinishtja, por edhe pikësimi bazë, përfshirë hapësirat) — ato kërkojnë rikthim të alfabetit në 0, pra sërish një bajt shtesë (dhe më pas edhe një tjetër për t'u kthyer te alfabeti ynë kryesor).
Një alfabet është mirë, dy janë më mirë
Le të provojmë t’i ndryshojmë pak prefikset tona bit, duke i shtuar edhe një tjetër tre të përshkruara më sipër:
0xxxxxxx — 1 bajt në regjim normal, 2 në të gjatë
11xxxxxx — 1 bajt
100xxxxx xxxxxxxx — 2 bajte
101xxxxx xxxxxxxx xxxxxxxx — 3 bajte
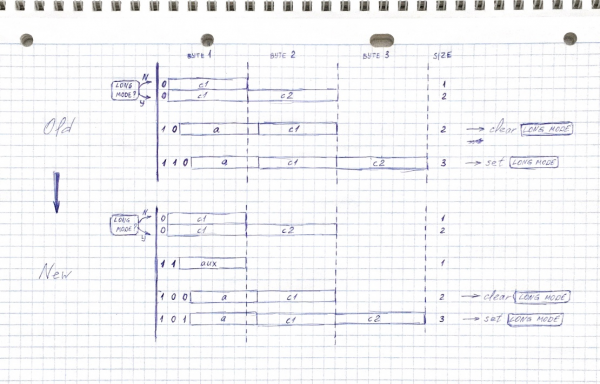
Tani, në shkrimin dybajtësh ka një bit më pak të disponueshëm — futen code point-et deri te 0x1FFF, e jo 0x3FFF. Megjithatë, kjo është ende dukshëm më shumë se në kodet dybajtëshe të UTF-8, shumica e gjuhëve të zakonshme ende përfshihen, humbja më e dukshme është se mbetën jashtë dhe , japonezët janë të mërzitur.
Po çfarë është kodi i ri 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) alfabet. Kur ndërrojmë alfabetin aktual, një pjesë e alfabetit të vjetër bëhet ndihmës. Për shembull, kaluam nga ASCII në cirilik — tani “në rezervë” kemi 64 simbole, që përmbajnë latinishten, shifrat, hapësirën dhe presjen (futjet më të shpeshta në tekstet jo-ASCII). U kthyem sërish te ASCII — dhe alfabet ndihmës do të bëhet pjesa kryesore e cirilikut.
Falë qasjes në dy alfabete, mund të përpunojmë më shumë tekste me kosto minimale për kalimin mes alfabeteve (shenjat e pikësimit shpesh do të sjellin kthim në ASCII, por pas kësaj shumë simbole jo-ASCII do t’i marrim tashmë nga alfabeti shtesë, pa kaluar sërish).
Bonus: duke e shënuar alfabetin shtesë me prefiksin 11xxxxxx dhe duke zgjedhur zhvendosjen e tij fillestare të barabartë me 0xC0, marrim përputhshmëri të pjesshme me CP1252. Me fjalë të tjera, shumë (por jo të gjitha) tekste të Evropës Perëndimore të koduara në CP1252 do të duken njësoj edhe në UTF-C.
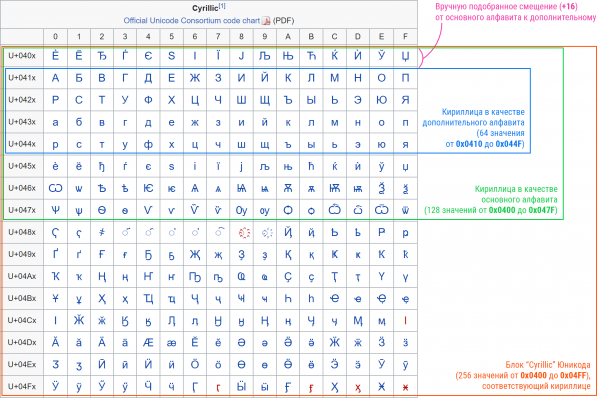
Këtu, megjithatë, lind një vështirësi: si ta marrim alfabetin ndihmës nga ai kryesor? Mund të lëmë të njëjtën zhvendosje, por, për fat të keq, këtu struktura e Unicode tashmë punon kundër nesh. Shumë shpesh pjesa kryesore e alfabetit nuk ndodhet në fillim të bllokut (për shembull, shkronja e madhe ruse «А» ka kodin 0x0410, megjithëse blloku cirilik fillon me 0x0400). Kështu, duke rezervuar 64 simbolet e para, mund të humbasim qasjen te pjesa fundore e alfabetit.
Për ta zgjidhur këtë problem, kalova manualisht nëpër disa blloqe që u korrespondojnë gjuhëve të ndryshme dhe përcaktova për to zhvendosjen e alfabetit ndihmës brenda atij kryesor. Latinishten, si përjashtim, madje e riorganizova sipas modelit të base64.
Prekjet përfundimtare
Le të mendojmë në fund se ku tjetër mund të përmirësojmë diçka.
Vërejmë se formati 101xxxxx xxxxxxxx xxxxxxxx lejon kodimin e numrave deri në 0x1FFFFF, ndërsa Unicode përfundon më herët, te 0x10FFFF. Me fjalë të tjera, pika e fundit e kodit do të paraqitet si 10110000 11111111 11111111. Prandaj, mund të themi se nëse bajti i parë ka formën 1011xxxx (ku xxxx është më i madh se 0), atëherë ai shënon diçka tjetër. Për shembull, aty mund të shtohen edhe 15 simbole të tjera, gjithmonë të disponueshme për kodim me një bajt, por unë vendosa të veproj ndryshe.
Le të shohim ato blloqe të Unicode që tani kërkojnë tre bajte. Kryesisht, siç u përmend tashmë, këto janë ideogramet kineze, por me to është e vështirë të bëhet diçka, sepse janë 21 mijë. Por aty kanë përfunduar edhe hiragana me katakanën, dhe ato nuk janë aq shumë, më pak se dyqind. Dhe, meqë përmendëm japonezët, aty gjenden edhe emoji (në fakt ato janë të shpërndara në shumë vende të Unicode, por blloqet kryesore në intervalin 0x1F300 – 0x1FBFF). Nëse mendon se sot ekzistojnë emoji që përbëhen nga disa pika kodi njëherësh (për shembull, emoji përbëhet plot nga 7 kode!), atëherë bëhet edhe më e dhimbshme të shpenzosh nga tre bajte për secilën (7×3 = 21 bajte për një simbol të vetëm, tmerr fare).
Prandaj zgjedhim disa intervale të veçanta që u korrespondojnë emoji-ve, hiraganës dhe katakanës, i rinumërojmë në një listë të vetme të pandërprerë dhe i kodojmë me dy bajte në vend të treve:
1011xxxx xxxxxxxx
Shkëlqyeshëm: emoji i përmendur më sipër , i cili përbëhet nga 7 pika kodi, në UTF-8 zë 25 bajte, ndërsa ne e futëm në 14 (saktësisht nga dy bajte për çdo pikë kodi). Meqë ra fjala, Habr refuzoi ta përpunonte (si në editorin e vjetër, ashtu edhe në të riun), ndaj m'u desh ta fus si figurë.
Le të përpiqemi të zgjidhim edhe një problem tjetër. Siç kujtojmë, alfabeti bazë është në thelb 6 bitët e sipërm, të cilët i mbajmë mend dhe ia ngjisim kodit të çdo simboli të radhës që dekodojmë. Në rastin e hieroglifeve kineze, të cilat ndodhen në bllokun 0x4E00 – 0x9FFF, kjo është ose biti 0, ose 1. Kjo nuk është shumë e përshtatshme: do të na duhet ta ndërrojmë vazhdimisht alfabetin midis këtyre dy vlerave (domethënë të shpenzojmë nga tre bajte). Por vëmë re se në modalitetin e gjatë nga vetë kodi mund të zbresim numrin e simboleve që i kodojmë me modalitetin e shkurtër (pas të gjitha marifeteve të përshkruara më sipër, kjo është 10240) — atëherë intervali i hieroglifeve do të zhvendoset te 0x2600 – 0x77FF, dhe në këtë rast në të gjithë këtë interval 6 bitët e sipërm (nga 21) do të jenë të barabartë me 0. Kështu, sekuencat e hieroglifeve do të përdorin nga dy bajte për hieroglif (çka është optimale për një interval kaq të madh), pa shkaktuar ndërrime të alfabetit.
Zgjidhje alternative: SCSU, BOCU-1
Njohësit e Unicode, vetëm duke lexuar titullin e artikullit, me shumë gjasë do të nxitojnë të kujtojnë se drejtpërdrejt mes standardeve të Unicode ekziston (SCSU), i cili përshkruan një mënyrë kodimi mjaft të ngjashme me atë të përshkruar në artikull.
E pranoj sinqerisht: për ekzistencën e tij mësova vetëm pasi isha zhytur thellë në shkrimin e zgjidhjes sime. Po ta kisha ditur që në fillim, me gjasë do të isha përpjekur të shkruaja implementimin e tij në vend që të shpikja qasjen time.
Është interesante që SCSU përdor ide shumë të ngjashme me ato te të cilat arrita vetë (në vend të konceptit të «alfabeteve» aty përdoren «dritare», dhe ato janë më të shumta se në zgjidhjen time). Në të njëjtën kohë, ky format ka edhe mangësi: ai është pak më afër algoritmeve të kompresimit sesa kodimit. Në veçanti, standardi ofron shumë mënyra paraqitjeje, por nuk thotë si të zgjidhet varianti optimal — për këtë, enkoderi duhet të përdorë disa heuristika. Si rrjedhojë, një enkoder SCSU që jep kompresim të mirë do të jetë më kompleks dhe më i rëndë se algoritmi im.
Për krahasim, unë portova në JavaScript një implementim relativisht të thjeshtë të SCSU-së — për nga vëllimi i kodit doli i krahasueshëm me UTF-C tim, por në një sërë rastesh tregoi rezultat dhjetëra për qind më të dobët (ndonjëherë mund ta tejkalojë edhe ai, por jo me shumë). Për shembull, tekstet në hebraisht dhe greqisht UTF-C i kodoi madje 60% më mirë se SCSU (me shumë gjasa për shkak të alfabeteve të tyre kompakte).
Veçmas do të shtoj se, përveç SCSU, ekziston edhe një mënyrë tjetër për paraqitje kompakte të Unicode — , por ai synon përputhshmërinë me MIME (gjë që mua nuk më nevojitej) dhe përdor një qasje disi tjetër ndaj kodimit. Efikasitetin e tij nuk e kam vlerësuar, por më duket se vështirë se do të jetë më i lartë se ai i SCSU-së.
Përmirësime të mundshme
Algoritmi që kam paraqitur nuk është universal by design (këtu, ndoshta, qëllimet e mia dallohen më shumë se kudo nga ato të konsorciumit Unicode). E kam përmendur tashmë se ai u zhvillua kryesisht për një detyrë të vetme (ruajtjen e një fjalori shumëgjuhësh në një pemë prefikse), dhe disa nga veçoritë e tij mund të mos përshtaten mirë për detyra të tjera. Por fakti që nuk është standard mund të jetë edhe plus — mund ta përshtatni lehtësisht sipas nevojave tuaja.
Për shembull, në mënyrë krejt të qartë mund të hiqet prania e gjendjes dhe kodimi të bëhet stateless — thjesht duke mos përditësuar variablat zbritje, auxOffs dhe is21Bit në enkoder dhe dekoder. Në këtë rast nuk do të jetë e mundur të paketohen me efikasitet sekuencat e simboleve të të njëjtit alfabet, por do të ketë garanci që i njëjti simbol kodohet gjithmonë me të njëjtat bajte, pavarësisht nga konteksti.
Përveç kësaj, koduesi mund të përshtatet për një gjuhë të caktuar duke ndryshuar gjendjen e parazgjedhur — për shembull, duke u orientuar te tekstet ruse, të vendosen në fillim të enkoderit dhe dekoderit offs = 0x0400 dhe auxOffs = 0. Veçanërisht kjo ka kuptim pikërisht në rastin e modalitetit stateless. Në përgjithësi, kjo do t'i ngjajë përdorimit të kodimit të vjetër 8-bitësh, vetëm se nuk ju privon nga mundësia për të futur simbole nga i gjithë Unicode sipas nevojës.
Një mangësi tjetër, e përmendur më herët, është se në një tekst voluminoz të koduar në UTF-C nuk ka një mënyrë të shpejtë për të gjetur kufirin e simbolit më të afërt me një bajt arbitrar. Duke prerë nga buffer-i i koduar 100 bajtet e fundit, fjala vjen, rrezikoni të merrni mbeturina me të cilat nuk mund të bëni asgjë. Kodimi nuk është menduar për ruajtjen e logeve shumë-gigabajtëshe, por në përgjithësi kjo mund të rregullohet. Bajti 0xBF nuk duhet të shfaqet kurrë si bajti i parë (por mund të jetë i dyti ose i treti). Prandaj, gjatë kodimit mund të futet sekuenca 0xBF 0xBF 0xBF çdo, të themi, 10 KB — atëherë, kur të jetë e nevojshme të gjendet kufiri, do të mjaftojë të skanohet pjesa e zgjedhur derisa të gjendet një marker i tillë. Menjëherë pas të fundit 0xBF do të ketë me siguri fillimin e simbolit. (Gjatë dekodimit, kjo sekuencë prej tre bajtesh, natyrisht, duhet të shpërfillet.)
Në përfundim
Nëse keni lexuar deri këtu — urime! Shpresoj që, ashtu si unë, të keni mësuar diçka të re (ose t'ju jenë rifreskuar disa njohuri të vjetra) rreth mënyrës si funksionon Unicode.
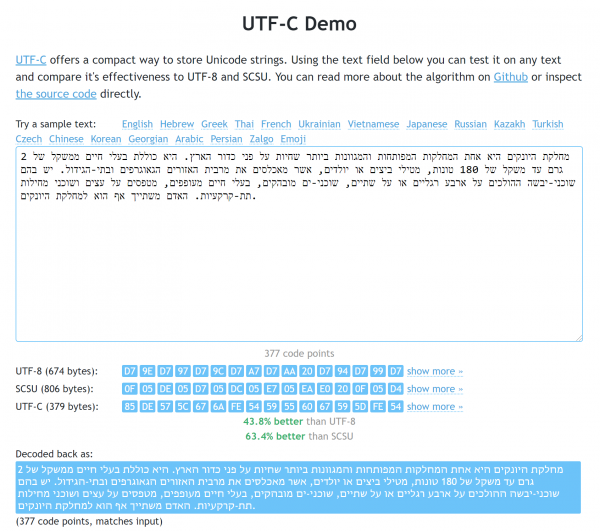
Faqe demonstrimi. Me shembullin e hebraishtes duken qartë përparësitë si ndaj UTF-8, ashtu edhe ndaj SCSU.
Nuk duhet t'i shihni kërkimet e përshkruara më sipër si cenim të standardeve. Megjithatë, në përgjithësi jam i kënaqur me rezultatet e punës sime, ndaj kam kënaqësi t'i : për shembull, biblioteka JS në formë të minifikuar zë vetëm 1710 bajte (dhe, sigurisht, nuk ka varësi). Siç e përmenda më sipër, me funksionimin e saj mund të njiheni në (aty gjendet edhe një grup tekstesh me të cilat mund ta krahasoni me UTF-8 dhe SCSU).
Në fund, dua të theksoj edhe një herë rastet kur përdorimi i UTF-C nuk rekomandohet:
- Nëse vargjet tuaja janë mjaft të gjata (nga 100-200 simbole). Në këtë rast, ia vlen të mendoni për përdorimin e algoritmeve të kompresimit si deflate.
- Nëse ju nevojitet ASCII transparency, domethënë është e rëndësishme për ju që në sekuencat e koduara të mos shfaqen kode ASCII që nuk kanë qenë në vargun burimor. Kjo nevojë mund të shmanget nëse, gjatë ndërveprimit me API të palëve të treta (për shembull, kur punoni me DB), rezultatin e kodimit e dërgoni si një grup abstrakt bajtesh, dhe jo si vargje. Përndryshe, rrezikoni të përballeni me dobësi të paparashikuara.
- Nëse dëshironi të keni mundësinë të gjeni shpejt kufijtë e simboleve sipas një zhvendosjeje arbitrare (për shembull, nëse dëmtohet një pjesë e vargut). Kjo është e mundur, por vetëm duke skanuar vargun nga fillimi (ose duke përdorur përmirësimin e përshkruar në seksionin e mëparshëm).
- Nëse ju duhet të kryeni shpejt operacione mbi përmbajtjen e vargjeve (t'i renditni, të kërkoni nënvargje në to, t'i bashkoni). Për këtë, vargjet duhen fillimisht të dekodohen, prandaj UTF-C në këto raste do të jetë më i ngadalshëm se UTF-8 (por më i shpejtë se algoritmet e kompresimit). Meqenëse i njëjti varg kodohet gjithmonë njësoj, krahasimi i saktë nuk kërkon dekodim; ai mund të bëhet bajt pas bajti.
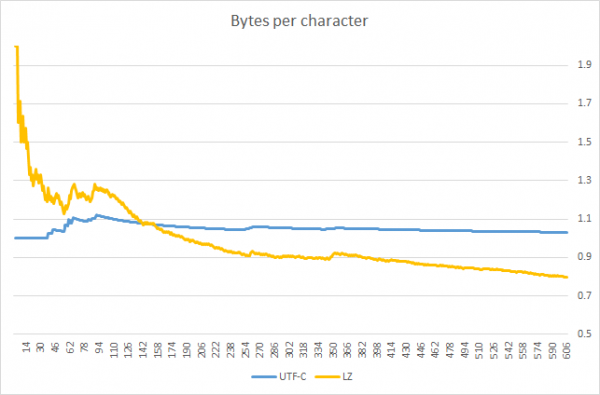
Përditësim: përdorues publikoi një grafik që thekson kufirin e zbatueshmërisë së UTF-C. Aty shihet se UTF-C është më efikas se një algoritëm kompresimi për përdorim të përgjithshëm (një variant i LZW) për aq kohë sa vargu që paketohet është më i shkurtër se ~140 simbole (megjithatë, po theksoj se krahasimi është bërë mbi një tekst të vetëm; për gjuhë të tjera rezultati mund të ndryshojë).
Burimi: habr.com
