

Hyrje
Mirëmëngjesi. Tashmë po punojmë për gjashtë muaj me një skenar (më saktësisht një grup skenarësh) që gjeneron raporte mbi gjendjen e makinave virtuale (dhe jo vetëm). Vendosa të ndaj përvojën e krijimit dhe kodin vetë. Shpresoj në kritika dhe se ky material mund të jetë i dobishëm për dikë.
Formimi i nevojës
Ne kemi shumë makina virtuale (rreth 1500 VM të shpërndara në 3 vCenter). Krijohen të reja dhe hiqen të vjetra mjaft shpesh. Për të ruajtur rendin, janë shtuar disa fusha të personalizuara në vCenter, për të ndarë VM-të në Nën-sistemet, për të treguar nëse ato janë testuese, si dhe kush i krijoi dhe kur. Faktori njerëzor ka sjellë në atë që më shumë se gjysma e makinave i janë lënë fushave të paplotësuara, që e ka vështirësuar punën. Çdo gjashtë muaj, dikush ka nervozuar, ka filluar punën për përditësimin e këtyre të dhënave, por rezultati ka pushuar së qenë aktual pas dy javësh.
Të sqaroj menjëherë, të gjithë e kuptojnë se duhet të jenë kërkesa për krijimin e makinave, procesi për krijimin e tyre, etj., etj. Dhe të gjithë ndjekin këtë proces pa asnjë përjashtim dhe është gjithçka në rregull. Fatkeqësisht, nuk është kështu te ne, por kjo nuk është tema e artikullit 🙂
Në përgjithësi, u mor vendim për të automatizuar kontrollin e saktësisë së plotësimit të fushave.
Vendosëm se një email i përditshëm me një listë të makinave me plotësim të gabuar për të gjithë inxhinierët e përgjegjshëm dhe shefat e tyre do të ishte një fillim i mirë.
Në këtë moment, një nga kolegët kishte zbatuar një skenar në PowerShell, i cili çdo ditë sipas orarit merrte informacion mbi të gjitha makinat e të gjitha vCenter-ve dhe krijonte 3 dokumente csv (çdo një për vCenter-in e vet), që shkarkoheshin në një disk të përbashkët. U mor vendim që të merret ky skenar si bazë dhe të shtohen kontrollime me ndihmën e gjuhës R, për të cilën kishte një përvojë të caktuar.
Gjatë procesit të punës, zgjidhja u pasurua me informimin përmes postës, një baze të dhënash me tabelën kryesore dhe atë historike (për të cilat do të flasim më vonë), si dhe analizën e logjeve të vSphere për të gjetur krijuesit e vërtetë të vm-ve dhe kohën e krijimit të tyre.
Për zhvillimin u përdorën IDE-të RStudio Desktop dhe PowerShell ISE.
Skenari niset nga një makinë virtuale të zakonshme Windows.
Përshkrimi i logjikës së përgjithshme.
Logjika e përgjithshme e skenarëve doli si më poshtë.
- Mblidhni të dhënat për makinat virtuale me një script PowerShell, të cilin e thërrasim përmes R, dhe bashkojmë rezultatin në një csv. Ndërveprimi i kundërt mes gjuhëve është bërë në mënyrë të ngjashme. (mund të ishte dërguar të dhënat drejtpërdrejt nga R në PowerShell si variabla, por kjo është e komplikuar, dhe gjithashtu duke pasur csv ndërmjetës është më e lehtë për të bërë debug dhe për të ndarë me dikë rezultatet ndërmjetëse).
- Së bashku me R, formulojmë parametrat e lejuar për fushat, të cilat ne i kontrollojmë. — Formulojmë një dokument word, i cili do të përmbajë vlerat e këtyre fushave për t'i futur në një letër informacioni, e cila do të jetë përgjigje ndaj pyetjeve të kolegëve "Po mirë, si duhet ta plotësoj këtë?".
- Ngarkojmë të dhënat për të gjitha VM-të nga csv me R, formulojmë një dataframe, heqim fushat që nuk na duhen dhe formulojmë një dokument informativ xlsx, i cili do të përmbajë informacion të përmbledhur për të gjitha VM-të, të cilin e postojmë në një burim të përbashkët.
- I aplicojmë të gjitha kontrollet e saktësisë përmbushjes së fushave dataframe-it për të gjitha VM-të dhe formulojmë një tabelë, që përmban vetëm VM-të me fusha të mbushura gabimisht (dhe vetëm këto fusha).
- Listën e marrë të VM-ve e dërgojmë në një script tjetër PowerShell, që do të shikojë log-et e vCenter për ngjarjet e krijimit të VM-ve, çka do të lejojë të përcaktojmë kohën e supozuar të krijimit të VM-ve dhe krijuesin e supozuar. Kjo për rastet kur askush nuk pranon se çka është makina. Ky script nuk punon shpejt, veçanërisht nëse ka shumë log-e, kështu që shohim vetëm dy javët e fundit, dhe gjithashtu përdorim një workflow që lejon kërkimin e informacionit për disa VM menjëherë. Në shembullin e scriptit ka komente të detajuara për këtë mekanizëm. Rezultatin e mbledhim në csv, të cilin e ngarkojmë përsëri në R.
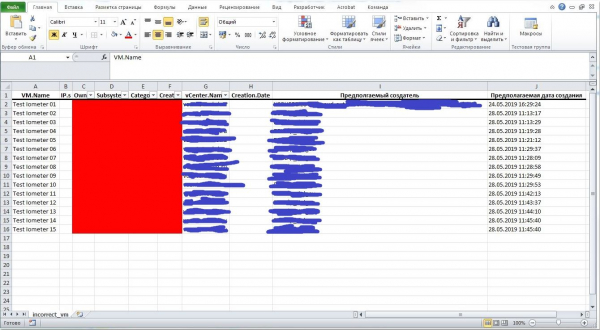
- Formulojmë një dokument xlsx të formatizuar bukur, në të cilin do të jenë të shënuara me ngjyrë të kuqe fushat e mbushura gabimisht, janë aplikuar filtra për disa kolona, si dhe janë shënuar kolona shtesë që përmbajnë krijuesit e supozuar dhe kohën e krijimit të VM-ve.
- Ne formojmë një email, ku vendosim dokumentin që përshkruan vlerat e pranueshme për fushat, si dhe një tabelë me VM-të e mbushura gabimisht. Në tekst përmendim numrin total të VM-ve të krijuara gabim, lidhjen me burimin e përgjithshëm dhe një imazh motivues. Nëse nuk ka VM të mbushura gabim — dërgojmë një email tjetër me një imazh motivues më të gëzueshëm.
- Regjistrojmë të dhënat për të gjitha VM-të në bazën e të dhënave SQL Server duke marrë parasysh mekanizmin e implementuar të tabelave historike (një mekanizëm shumë interesant — për të cilin do të flasim më shumë më poshtë)
Saktësisht skriptet
Skedari kryesor me kodin në R
# Путь к рабочей директории (нужно для корректной работы через виндовый планировщик заданий)
setwd("C:ScriptsgetVm")
#### Подгружаем необходимые пакеты ####
library(tidyverse)
library(xlsx)
library(mailR)
library(rmarkdown)
##### Определяем пути к исходным файлам и другие переменные #####
source(file = "const.R", local = T, encoding = "utf-8")
# Проверяем существование файла со всеми ВМ и удаляем, если есть.
if (file.exists(filenameVmCreationRules)) {file.remove(filenameVmCreationRules)}
#### Создаём вордовский документ с допустимыми полями
render("VM_name_rules.Rmd",
output_format = word_document(),
output_file = filenameVmCreationRules)
# Проверяем существование файла со всеми ВМ и удаляем, если есть
if (file.exists(allVmXlsxPath)) {file.remove(allVmXlsxPath)}
#### Забираем данные по всем машинам через PowerShell скрипт. На выходе получим csv.
system(paste0("powershell -File ", getVmPsPath))
# Полный df
fullXslx_df <- allVmXlsxPath %>%
read.csv2(stringsAsFactors = FALSE)
# Kontrolloni saktësinë e fushave të plota
full_df <- fullXslx_df %>%
mutate(
# Së pari hiqni të gjitha hapësirat dhe tabulat e tepërta, pastaj merrni parasysh ndarësin e presjes, pastaj kontrolloni për përfshirje në vlerat e lejuara,
isSubsystemCorrect = Subsystem %>%
gsub("[[:space:]]", "", .) %>%
str_split(., ",") %>%
map(function(x) (all(x %in% AllowedValues$Subsystem))) %>%
as.logical(),
isOwnerCorrect = Owner %in% AllowedValues$Owner,
isCategoryCorrect = Category %in% AllowedValues$Category,
isCreatorCorrect = (!is.na(Creator) & Creator != ''),
isCreation.DateCorrect = map(Creation.Date, IsDate)
)
# Kontrolloni ekzistencën e skedarit me të gjitha VM-të dhe hiqni, nëse ekziston.
if (file.exists(filenameAll)) {file.remove(filenameAll)}
#### Formoni një skedar xslx me raportin ####
# Të dhënat e përgjithshme në një fletë të veçantë
full_df %>% write.xlsx(file=filenameAll,
sheetName=names[1],
col.names=TRUE,
row.names=FALSE,
append=FALSE)
#### Formoni një skedar xslx me fushat e mbushura gabimisht ####
# Formoni df
incorrect_df <- full_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Creator,
Category,
Creation.Date,
isOwnerCorrect,
isSubsystemCorrect,
isCategoryCorrect,
isCreatorCorrect,
vCenter.Name) %>%
filter(isSubsystemCorrect == F |
isOwnerCorrect == F |
isCategoryCorrect == F |
isCreatorCorrect == F)
# Kontrolloni ekzistencën e skedarit me të gjitha VM-të dhe hiqni, nëse ekziston.
if (file.exists(filenameIncVM)) {file.remove(filenameIncVM)}
# Ruani listën e VM-ve me fusha të paplotësuara në csv
incorrect_df %>%
select(VM.Name) %>%
write_csv2(path = filenameIncVM, append = FALSE)
# Filtroni për ta futur në email
incorrect_df_filtered <- incorrect_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
)
# Llogaritni numrin e rreshtave
numberOfRows <- nrow(incorrect_df)
#### Начало условия ####
# Дальше либо у нас есть неправильно заполненные поля, либо нет.
# Если есть - запускаем ещё один скрипт
if (numberOfRows > 0) {
# Kontrolloni ekzistencën e skedarit me krijuesit dhe hiqni, nëse ekziston.
if (file.exists(creatorsFilePath)) {file.remove(creatorsFilePath)}
# Ekzekutoni një skript PowerShell, i cili do të gjejë krijuesit e VM-ve të gjetura. Në daljen do të marrim një csv.
system(paste0("powershell -File ", getCreatorsPath))
# Lexoni skedarin me krijuesit
creators_df <- creatorsFilePath %>%
read.csv2(stringsAsFactors = FALSE)
# Filtroni për ta futur në email, shtoni të dhënat nga tabela me krijuesit
incorrect_df_filtered <- incorrect_df_filtered %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
) %>%
left_join(creators_df, by = "VM.Name") %>%
rename(`Krijuesi i supozuar` = CreatedBy,
`Data e supozuar e krijimit` = CreatedOn)
# Formoni trupin e email-it
emailBody <- paste0(
'<html>
<h3>Mirëmëngjes, kolegë të nderuar.</h3>
<p>Informacionin e plotë dhe aktual mbi makinat virtuale mund ta shikoni në diskun H: këtu:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Po ashtu, në aneks është lista e VM-ve me <strong>fusha të pasakta</strong> Në total janë <strong>', numberOfRows,'</strong>.</p>
<p>Tabela ka dy kolona shtesë. <strong>Krijuesi i supozuar</strong> dhe <strong>Data e supozuar e krijimit</strong>, të cilat nxirren nga log-ët e vCenter gjatë dy javëve të fundit</p>
<p>Kërkim për krijuesit e makinave për të sqaruar të dhënat dhe për të plotësuar fushat siç duhet. Rregullat për plotësimin e fushave janë gjithashtu në aneks</p>
<p><img src="data/meme.jpg"></p>
</html>'
)
# Kontrollojmë ekzistencën e skedarit
if (file.exists(filenameIncorrect)) {file.remove(filenameIncorrect)}
# Krijojmë një tabelë të bukur me formate etj.
source(file = "email.R", local = T, encoding = "utf-8")
#### Krijojmë një letër për makinat me plotësim të dobët ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "VM me fusha të pasakta",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
attach.files = c(filenameIncorrect, filenameVmCreationRules),
debug = FALSE)
#### Më pas do të vijë blloku, nëse nuk ka probleme me VM ####
} else {
# Krijojmë trupin e letrës
emailBody <- paste0(
'<html>
<h3>Mirëdita, kolegë të nderuar</h3>
<p>Informacionin e plotë dhe aktual mbi makinat virtuale mund ta shikoni në diskun H: këtu:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Po ashtu, në këtë moment, të gjitha fushat e VM-ve janë plotësuar siç duhet</p>
<p><img src="data/meme_correct.jpg"></p>
</html>'
)
#### Krijojmë një letër pa VM me plotësim të dobët ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "Informacion i përmbledhur",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
debug = FALSE)
}
####### Shkruajmë të dhënat në DB #####
source(file = "DB.R", local = T, encoding = "utf-8")
Skripta që merr listën e VM-ve në PowerShell
# Данные для подключения и другие переменные
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"

$filename = "C:ScriptsgetVmdataallvmall-vm-$(get-date -f yyyy-MM-dd).csv"

$destinationSMB = "server.rumyfolder$vm"
$IP0=""
$IP1=""
$IP2=""
$IP3=""
$IP4=""
$IP5=""

# Подключение ко всем vCenter, что содержатся в переменной. Будет работать, если логин и пароль одинаковые (например, доменные)
Connect-VIServer -Server $vCenterNames -User $vCenterUsername -Password $vCenterPassword

write-host ""

# Создаём функцию с циклом по всем vCenter-ам
function Get-VMinventory {

# В этой переменной будет списко всех ВМ, как объектов
$AllVM = Get-VM | Sort Name
$cnt = $AllVM.Count
$count = 1

# Начинаем цикл по всем ВМ и собираем необходимые параметры каждого объекта
   foreach ($vm in $AllVM) {
   $StartTime = $(get-date)

     $IP0 = $vm.Guest.IPAddress[0]
     $IP1 = $vm.Guest.IPAddress[1]
     $IP2 = $vm.Guest.IPAddress[2]
     $IP3 = $vm.Guest.IPAddress[3]
     $IP4 = $vm.Guest.IPAddress[4]
     $IP5 = $vm.Guest.IPAddress[5]

     If ($IP0 -ne $null) {If ($IP0.Contains(":") -ne 0) {$IP0=""}}
     If ($IP1 -ne $null) {If ($IP1.Contains(":") -ne 0) {$IP1=""}}
     If ($IP2 -ne $null) {If ($IP2.Contains(":") -ne 0) {$IP2=""}}
     If ($IP3 -ne $null) {If ($IP3.Contains(":") -ne 0) {$IP3=""}}
     If ($IP4 -ne $null) {If ($IP4.Contains(":") -ne 0) {$IP4=""}}
     If ($IP5 -ne $null) {If ($IP5.Contains(":") -ne 0) {$IP5=""}}

     $cluster = $vm | Get-Cluster | Select-Object -ExpandProperty name
     $Bootime = $vm.ExtensionData.Runtime.BootTime
     $TotalHDDs = $vm.ProvisionedSpaceGB -as [int]
     $CreationDate = $vm.CustomFields.Item("CreationDate") -as [string]
     $Creator = $vm.CustomFields.Item("Creator") -as [string]
     $Category = $vm.CustomFields.Item("Category") -as [string]
     $Owner = $vm.CustomFields.Item("Owner") -as [string]
     $Subsystem = $vm.CustomFields.Item("Subsystem") -as [string]

     $IPS = $vm.CustomFields.Item("IP") -as [string]

     $vCPU = $vm.NumCpu
     $CorePerSocket = $vm.ExtensionData.config.hardware.NumCoresPerSocket
     $Sockets = $vCPU/$CorePerSocket

     $Id = $vm.Id.Split('-')[2] -as [int]

     # Собираем все параметры в один объект
     $Vmresult = New-Object PSObject
     $Vmresult | add-member -MemberType NoteProperty -Name "Id" -Value $Id
     $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
     $Vmresult | add-member -MemberType NoteProperty -Name "Cluster" -Value $cluster
     $Vmresult | add-member -MemberType NoteProperty -Name "Esxi Host" -Value $VM.VMHost
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 1" -Value $IP0
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 2" -Value $IP1
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 3" -Value $IP2
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 4" -Value $IP3
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 5" -Value $IP4
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 6" -Value $IP5
     $Vmresult | add-member -MemberType NoteProperty -Name "vCPU" -Value $vCPU
     $Vmresult | Add-Member -MemberType NoteProperty -Name "CPU Sockets" -Value $Sockets
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Core per Socket" -Value $CorePerSocket
     $Vmresult | add-member -MemberType NoteProperty -Name "RAM (GB)" -Value $vm.MemoryGB
     $Vmresult | add-member -MemberType NoteProperty -Name "Total-HDD (GB)" -Value $TotalHDDs
     $Vmresult | add-member -MemberType NoteProperty -Name "Power State" -Value $vm.PowerState
     $Vmresult | add-member -MemberType NoteProperty -Name "OS" -Value $VM.ExtensionData.summary.config.guestfullname
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Boot Time" -Value $Bootime
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Status" -Value $vm.ExtensionData.Guest.ToolsStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version" -Value $vm.ExtensionData.Guest.ToolsVersion
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version Status" -Value $vm.ExtensionData.Guest.ToolsVersionStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Running Status" -Value $vm.ExtensionData.Guest.ToolsRunningStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "Creation Date" -Value $CreationDate
     $Vmresult | add-member -MemberType NoteProperty -Name "Creator" -Value $Creator
     $Vmresult | add-member -MemberType NoteProperty -Name "Category" -Value $Category
     $Vmresult | add-member -MemberType NoteProperty -Name "Owner" -Value $Owner
     $Vmresult | add-member -MemberType NoteProperty -Name "Subsystem" -Value $Subsystem
     $Vmresult | add-member -MemberType NoteProperty -Name "IP's" -Value $IPS
     $Vmresult | add-member -MemberType NoteProperty -Name "vCenter Name" -Value $vm.Uid.Split('@')[1].Split(':')[0]

# Считаем общее и оставшееся время выполнения и выводим на экран результаты. Использовалось для тестирования, но по факту оказалось очень удобно.
     $elapsedTime = $(get-date) - $StartTime
     $totalTime = "{0:HH:mm:ss}" -f ([datetime]($elapsedTime.Ticks*($cnt - $count)))

     clear-host
     Write-Host "Processing" $count "from" $cnt
     Write-host "Progress:" ([math]::Round($count/$cnt*100, 2)) "%"
     Write-host "You have about " $totalTime "for cofee"
     Write-host ""

     $count++

# Выводим результат, чтобы цикл "знал" что является результатом выполнения одного прохода
     $Vmresult
   }

}

# Вызываем получившуюся функцию и сразу выгружаем результат в csv
$allVm = Get-VMinventory | Export-CSV -Path $filename -NoTypeInformation -UseCulture -Force

# Пытаемся выложить полученный файл в нужное нам место и, в случае ошибки, пишем лог.
try
    {
        Copy-Item $filename -Destination $destinationSMB -Force -ErrorAction SilentlyContinue
    }
catch
    {
        $error | Export-CSV -Path $filename".error" -NoTypeInformation -UseCulture -Force
    }
Skripta në PowerShell, që nxjerr nga logët krijuesit e makinave virtuale dhe datat e krijimit të tyre
# Путь к файлу, из которого будем доставать список VM
$VMfilePath = "C:ScriptsgetVmcreators_VMcreators_VM_$(get-date -f yyyy-MM-dd).csv"
# Путь к файлу, в который будем записывать результат
$filePath = "C:ScriptsgetVmdatacreatorscreators-$(get-date -f yyyy-MM-dd).csv"

# Создаём вокрфлоу
Workflow GetCreators-Wf
{
    # Параметры, которые можно будет передать при вызове скрипта
    param([string[]]$VMfilePath)

# Параметры, которые доступны только внутри workflow
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"
$daysToLook = 14
$start = (get-date).AddDays(-$daysToLook)
$finish = get-date
# Значения, которые будут вписаны в csv для машин, по которым не будет ничего найдено
$UnknownUser = "UNKNOWN"
$UnknownCreatedTime = "0000-00-00"

# Определяем параметры подключения и выводной файл, которые будут доступны во всём скрипте.
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )

# Получаем список VM из csv и загружаем соответствующие объекты
$list = Import-Csv $VMfilePath -UseCulture | select -ExpandProperty VM.Name

# Цикл, который будет выполняться параллельно (по 5 машин за раз)
foreach -parallel ($row in $list)
  {
    # Это скрипт, который видит только свои переменные и те, которые ему переданы через $Using
    InlineScript {

    # Время начала выполнения отдельного блока
        $StartTime = $(get-date)

        Write-Host ""
        Write-Host "Processing $Using:row started at $StartTime"
        Write-Host ""

        # Подключение оборачиваем в переменную, чтобы информация о нём не мешалась в консоли
        $con = Connect-VIServer -Server $Using:vCenterNames -User $Using:vCenterUsername -Password $Using:vCenterPassword

        # Получаем объект vm
        $vm = Get-VM -Name $Using:row

      # Ниже 2 одинаковые команды. Одна с фильтром по времени, вторая - без. Можно пользоваться тем,
      $Event = $vm | Get-VIEvent -Start $Using:start -Finish $Using:finish -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}
      # $Event = $vm | Get-VIEvent -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}

      # Заполняем параметры в зависимости от того, удалось ли в логах найти что-то
      If (($Event | Measure-Object).Count -eq 0){
         $User = $Using:UnknownUser
         $Created = $Using:UnknownCreatedTime
         $CreatedFormat = $Using:UnknownCreatedTime
      } Else {
         If ($Event.Username -eq "" -or $Event.Username -eq $null) {
            $User = $Using:UnknownUser
         } Else {
         $User = $Event.Username
         } # Else
            $CreatedFormat = $Event.CreatedTime
            # Один из коллег отдельно просил, чтобы время было в таком формате, поэтому дублируем его. А в БД пойдёт нормальный формат.
            $Created = $Event.CreatedTime.ToString('yyyy-MM-dd')
         } # Else

      Write-Host "Creator for $vm is $User. Creating object."

      # Создаём объект. Добавляем параметры.
      $Vmresult = New-Object PSObject
      $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedBy" -Value $User
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOn" -Value $CreatedFormat
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOnFormat" -Value $Created
      # Выводим результаты
      $Vmresult

    } # Inline

} # ForEach

}

$Creators = GetCreators-Wf $VMfilePath
# Записываем результат в файл
$Creators | select 'VM Name', CreatedBy, CreatedOn | Export-Csv -Path $filePath -NoTypeInformation -UseCulture -Force

Write-Host "CSV generetion finisghed at $(get-date). PROFIT"
Merita të veçantë meritohet biblioteka , e cila e bëri ngarkesën e email-it më të dukshme të formatizuar (siç e do drejtoria), dhe jo thjesht një tabelë csv.
Krijimi i një dokumenti të bukur xlsx me listën e makinave të mbushura gabim
# Создаём новую книгу
# Возможные значения : "xls" и "xlsx"
wb<-createWorkbook(type="xlsx")

# Стили для имён рядов и колонок в таблицах
TABLE_ROWNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE)
TABLE_COLNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE) +
  Alignment(wrapText=TRUE, horizontal="ALIGN_CENTER") +
  Border(color="black", position=c("TOP", "BOTTOM"),
         pen=c("BORDER_THIN", "BORDER_THICK"))

# Создаём новый лист
sheet <- createSheet(wb, sheetName = names[2])

# Добавляем таблицу
addDataFrame(incorrect_df_filtered,
             sheet, startRow=1, startColumn=1,  row.names=FALSE, byrow=FALSE,
             colnamesStyle = TABLE_COLNAMES_STYLE,
             rownamesStyle = TABLE_ROWNAMES_STYLE)

# Меняем ширину, чтобы форматирование было автоматическим
autoSizeColumn(sheet = sheet, colIndex=c(1:ncol(incorrect_df)))

# Добавляем фильтры
addAutoFilter(sheet, cellRange = "C1:G1")

# Определяем стиль
fo2 <- Fill(foregroundColor="red")
cs2 <- CellStyle(wb,
                 fill = fo2,
                 dataFormat = DataFormat("@"))

# Находим ряды с неверно заполненным полем Владельца и применяем к ним определённый стиль
rowsOwner <- getRows(sheet, rowIndex = (which(!incorrect_df$isOwnerCorrect) + 1))
cellsOwner <- getCells(rowsOwner, colIndex = which( colnames(incorrect_df_filtered) == "Owner" ))
lapply(names(cellsOwner), function(x) setCellStyle(cellsOwner[[x]], cs2))

# Находим ряды с неверно заполненным полем Подсистемы и применяем к ним определённый стиль
rowsSubsystem <- getRows(sheet, rowIndex = (which(!incorrect_df$isSubsystemCorrect) + 1))
cellsSubsystem <- getCells(rowsSubsystem, colIndex = which( colnames(incorrect_df_filtered) == "Subsystem" ))
lapply(names(cellsSubsystem), function(x) setCellStyle(cellsSubsystem[[x]], cs2))

# Аналогично по Категории
rowsCategory <- getRows(sheet, rowIndex = (which(!incorrect_df$isCategoryCorrect) + 1))
cellsCategory <- getCells(rowsCategory, colIndex = which( colnames(incorrect_df_filtered) == "Category" ))
lapply(names(cellsCategory), function(x) setCellStyle(cellsCategory[[x]], cs2))

# Создатель
rowsCreator <- getRows(sheet, rowIndex = (which(!incorrect_df$isCreatorCorrect) + 1))
cellsCreator <- getCells(rowsCreator, colIndex = which( colnames(incorrect_df_filtered) == "Creator" ))
lapply(names(cellsCreator), function(x) setCellStyle(cellsCreator[[x]], cs2))

# Сохраняем файл
saveWorkbook(wb, filenameIncorrect)
Në përfundim del pak a shumë kështu:
Ishte gjithashtu një nuancë interesante në konfigurimin e Windows scheduller. Nuk mund të gjendej dot përputhja e duhur e parametrave të të drejtave dhe konfigurimeve, që gjithçka të niste ashtu siç duhet. Në fund u gjet një bibliotekë R, e cila krijon vetë një detyrë për të ekzekutuar skriptin R dhe madje nuk harron për skedarin e logëve. Më pas mund të rregullojmë detyrën manualisht.
Një copë kod në R me dy shembuj, që krijon një detyrë në planifikuesin e Windows
library(taskscheduleR)
myscript <- file.path(getwd(), "all_vm.R")

## ekzekutojmë skriptin pas 62 sekondash
taskscheduler_create(taskname = "getAllVm", rscript = myscript,
                     schedule = "ONCE", starttime = format(Sys.time() + 62, "%H:%M"))

## ekzekutojmë skriptin çdo ditë në 09:10
taskscheduler_create(taskname = "getAllVmDaily", rscript = myscript,
                     schedule = "WEEKLY",
                     days = c("MON", "TUE", "WED", "THU", "FRI"),
                     starttime = "02:00")

## fshijmë detyrat
taskscheduler_delete(taskname = "getAllVm")
taskscheduler_delete(taskname = "getAllVmDaily")

# Shikojmë logët (4 rreshtat e fundit)
tail(readLines("all_vm.log"), sep ="n", n = 4)
Dhe përveç kësaj për bazën e të dhënave
Pas konfigurimit të skriptit filluan të shfaqen pyetje të tjera. Shembuj, dëshirohej të gjendej data kur VM u fshi, por logët në vCenter ishin fshirë tashmë. Duke qenë se skripti ruan skedarët në një dosje çdo ditë dhe nuk i pastron (i pastrojmë me duar, kur e kujtojmë), mund të shikojmë skedarët e vjetër dhe të gjejmë skedarin e parë, në të cilin nuk gjendet kjo VM. Por kjo nuk është perfekte.
Deshiroj të krijoj një DB historike.
Në ndihmë erdhi funksionaliteti i MS SQL SERVER - tavolina temporale e versionit sistemor. Zakonisht përkthehet si tavola me kohë (jo tavola të përcaktuara).
Mund të lexoni më në detaje në .
Po thjesht, krijojmë një tavolinë, i themi se do të ketë versionim dhe SQL Server krijon 2 kolona shtesë datetime në këtë tavolinë (datën e krijimit të regjistrimit dhe datën e mbarimit të jetës së regjistrimit) dhe një tavolinë shtesë, në të cilën do të regjistrohen ndryshimet. Si rezultat, marrim informacion të saktë dhe, me kërkesa të thjeshta, shembujt e të cilave janë dhënë në dokumentacion, mund të shohim ose ciklin e jetës së një makine virtuale të caktuar, ose gjendjen e të gjitha VM-ve në një moment të caktuar.
Nga pikëpamja e performancës - transaksioni i regjistrimit në tavolinën kryesore nuk do të përfundojë derisa të përfundojë transaksioni i regjistrimit në tavolinën temporale. Kështu, në tavolinat me një numër të madh operacionesh regjistrimi, ky funksionalitet duhet të zbatohet me kujdes, por në rastin tonë kjo është me të vërtetë një gjë shumë interesante.
Për të bërë që mekanizmi të funksionojë në mënyrë korrekte, më duhet të shkruaj një pjesë të vogël kodi në R, e cila do të krahasojë tavolinën e re me të dhënat për të gjitha VM-të me ato që ruhen në DB dhe do të regjistrojë vetëm rreshtat e ndryshuar. Kodi nuk është shumë i komplikuar, përdor bibliotekën compareDF, por edhe atë do ta sjell më poshtë.
Kodi në R për regjistrimin e të dhënave në DB
# Подцепляем пакеты
library(odbc)
library(compareDF)

# Формируем коннект
con <- dbConnect(odbc(),
                 Driver = "ODBC Driver 13 for SQL Server",
                 Server = DBParams$server,
                 Database = DBParams$database,
                 UID = DBParams$UID,
                 PWD = DBParams$PWD,
                 Port = 1433)

#### Проверяем есть ли таблица. Если нет - создаём. ####

if (!dbExistsTable(con, DBParams$TblName)) {
  #### Создаём таблицу ####
  create <- dbSendStatement(
    con,
    paste0(
      'CREATE TABLE ',
      DBParams$TblName,
      '(
    [Id] [int] NOT NULL PRIMARY KEY CLUSTERED,
    [VM.Name] [varchar](255) NULL,
    [Cluster] [varchar](255) NULL,
    [Esxi.Host] [varchar](255) NULL,
    [IP.Address.1] [varchar](255) NULL,
    [IP.Address.2] [varchar](255) NULL,
    [IP.Address.3] [varchar](255) NULL,
    [IP.Address.4] [varchar](255) NULL,
    [IP.Address.5] [varchar](255) NULL,
    [IP.Address.6] [varchar](255) NULL,
    [vCPU] [int] NULL,
    [CPU.Sockets] [int] NULL,
    [Core.per.Socket] [int] NULL,
    [RAM..GB.] [int] NULL,
    [Total.HDD..GB.] [int] NULL,
    [Power.State] [varchar](255) NULL,
    [OS] [varchar](255) NULL,
    [Boot.Time] [varchar](255) NULL,
    [VMTools.Status] [varchar](255) NULL,
    [VMTools.Version] [int] NULL,
    [VMTools.Version.Status] [varchar](255) NULL,
    [VMTools.Running.Status] [varchar](255) NULL,
    [Creation.Date] [varchar](255) NULL,
    [Creator] [varchar](255) NULL,
    [Category] [varchar](255) NULL,
    [Owner] [varchar](255) NULL,
    [Subsystem] [varchar](255) NULL,
    [IP.s] [varchar](255) NULL,
    [vCenter.Name] [varchar](255) NULL,
    DateFrom datetime2 GENERATED ALWAYS AS ROW START NOT NULL,
    DateTo datetime2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (DateFrom, DateTo)
        ) ON [PRIMARY]
        WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = ', DBParams$TblHistName,'));'
    )
  )

  # Отправляем подготовленный запрос
  dbClearResult(create)

} # if

#### Начало работы с таблицей ####

# Обозначаем таблицу, с которой будем работать
allVM_db_con <- tbl(con, DBParams$TblName)

#### Сравниваем таблицы ####

# Собираем данные с таблицы (убираем служебные временные поля)
allVM_db <- allVM_db_con %>%
  select(c(-"DateTo", -"DateFrom")) %>%
  collect()

# Создаём таблицу со сравнением объектов. Сравниваем по Id
# Удалённые объекты там будут помечены через -, созданные через +, изменённые через - и +
ctable_VM <- fullXslx_df %>%
  compare_df(allVM_db,
             c("Id"))

#### Удаление строк ####

# Выдираем Id виртуалок, записи о которых надо удалить
remove_Id <- ctable_VM$comparison_df %>%
  filter(chng_type == "-") %>%
  select(Id)

# Проверяем, что есть записи (если записей нет - и удалять ничего не нужно)
if (remove_Id %>% nrow() > 0) {

  # Конструируем шаблон для запроса на удаление данных
  delete <- dbSendStatement(con,
                        paste0('
                               DELETE
                               FROM ',
                               DBParams$TblName,
                               ' WHERE "Id"=?
                               ') # paste
                        ) # send

  # Создаём запрос на удаление данных
  dbBind(delete, remove_Id)

  # Отправляем подготовленный запрос
  dbClearResult(delete)

} # if

#### Добавление строк ####

# Выделяем таблицу, содержащую строки, которые нужно добавить.
allVM_add <- ctable_VM$comparison_df %>%
  filter(chng_type == "+") %>%
  select(-chng_type)

# Проверяем, есть ли строки, которые нужно добавить и добавляем (если нет - не добавляем)
if (allVM_add %>% nrow() > 0) {
  # Пишем таблицу со всеми необходимыми данными
  dbWriteTable(con,
               DBParams$TblName,
               allVM_add,
               overwrite = FALSE,
               append = TRUE)

} # if

#### Не забываем сделать дисконнект ####
dbDisconnect(con)
Përveç kësaj
Si rezultat i zbatimit të skriptit, për disa muaj u organizua dhe mbështetet rendi. Ndonjëherë VM-të e plota shfaqen, por skripti shërben si një kujtesë e mirë dhe është e rrallë që një VM të futet në listë dy zile rresht.
Po ashtu është bërë një përgatitje për analizën e të dhënavehistorike.
E kuptojmë që shumë nga kjo mund të realizohet jo "në mënyrë të improvizuar", por me software përkatës, por detyra ishte interesante dhe, mund të thuhet, fakultative.
R sërish tregoi se është një gjuhë universale e shkëlqyer, e cila është shumë e përshtatshme jo vetëm për zgjidhjen e çështjeve statistikore, por gjithashtu shërben si një "prikë" e shkëlqyer midis burimeve të tjera të të dhënave.
Burimi: habr.com
