

Në kohën tonë, është e pamundur të imagjinohet një projekt mbi Kubernetes pa stakun ELK, me anë të të cilit ruhen logjet e aplikacioneve dhe të komponentëve sistemikë të klasterit. Në praktikën tonë, ne përdorim stakun EFK me Fluentd në vend të Logstash.
Fluentd është një kolektor logjash modern, shumëfunksional, që po fiton gjithnjë e më shumë popullaritet dhe është bashkuar me Fondin e Komunitetit Cloud Native Computing, për shkak të së cilës drejtimi i zhvillimit të tij është orientuar për t'u përdorur në bashkëpunim me Kubernetes.
Fakti i përdorimit të Fluentd në vend të Logstash nuk ndryshon thelbin e kompleksit programor, megjithatë, për Fluentd karakterizohen nuanca të veçanta, të cilat rrjedhin nga shumëfunksionaliteti i tij.
Për shembull, duke filluar të përdorim EFK në një projekt të ngarkuar me intensitet të lartë në regjistrin e logjeve, ne u përballëm me faktin se disa mesazhe në Kibana shfaqen disa herë. Në këtë artikull do t'ju tregojmë arsyen për këtë fenomen dhe si ta zgjidhni problemin.
Problemi i dyfishimit të dokumenteve
Në projektet tona, Fluentd është vendosur si DaemonSet (çdo instancë startohet automatikisht në çdo nod të klasterit Kubernetes) dhe ndjek logjet stdout të kontejnerëve në /var/log/containers. Pas mbledhjes dhe përpunimit, logjet në formën e dokumenteve JSON dërgohen në ElasticSearch, e ngritur në formë klasteri ose standalone, në varësi të masave të projektit dhe kërkesave për performancën dhe qëndrueshmërinë. Për ndërfaqen grafike përdoret Kibana.
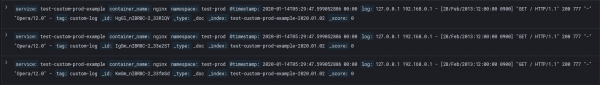
Kur përdorim Fluentd me plugin buffer, ne u përballëm me një situatë ku disa dokumente në ElasticSearch kanë përmbajtje tërësisht identike dhe dallohet vetëm përmes identifikuesit. Për të verifikuar se kjo është vërtet një përsëritje e mesazhit, mund të shohim shembuj nga logu i Nginx. Në skedarin e logut, ky mesazh ekziston si një instancë:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Megjithatë, në ElasticSearch egzistojnë disa dokumente që përmbajnë këtë mesazh:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}
Megjithatë, mund të ketë më shumë se dy përsëritje.
Gjatë regjistrimit të këtij problemi në log-et e Fluentd, mund të vëreni një numër të madh paralajmërimesh të këtij përmbajtjeje:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] dështoi të shuhte tamponin. riaktivizimi=4 sekonda_tjeter_riaktivizimi=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="nuk mund të dërgoni log-et në klasterin Elasticsearch ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"maskuar"}): arriti kohën e leximit"Këto paralajmërime ndodhin kur ElasticSearch nuk mund të kthejë një përgjigje për kërkesën brenda kohës së vendosur nga parametri request_timeout, duke e bërë të pamundshme pastrimin e fragmentit të tamponit të dërguar. Pas kësaj, Fluentd përpiqet të dërgojë përsëri fragmentin e tamponit në ElasticSearch dhe pas një numri të rastësishëm përpjekjesh, operacioni përfundon me sukses:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] riaktivizimi ishte i suksesshëm. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] riaktivizimi ishte i suksesshëm. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] riaktivizimi ishte i suksesshëm. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] riaktivizimi ishte i suksesshëm. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] riaktivizimi ishte i suksesshëm. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Megjithatë, ElasticSearch e percepton secilin nga fragmentet e tamponit të dërguar si unik dhe u jep atyre vlera unike të fushës _id gjatë indeksimit. Kështu krijohen kopjet e mesazheve.
Në Kibana, kjo duket kështu:
Zgjidhja e problemit
Ekzistojnë disa mundësi për zgjidhjen e këtij problemi. Një prej tyre është mekanizmi i gjenerimit të një hashi unik për çdo dokument, i integruar në plumbin fluent-plugin-elasticsearch. Nëse përdoret ky mekanizëm, ElasticSearch do të njohë kopjet në fazën e dërgimit dhe nuk do të lejojë dublikimin e dokumenteve. Por nuk mund të injorohet fakti se ky metodë zgjidh problemin pasojat dhe nuk e eliminon gabimin për mungesën e kohës së pritjes, prandaj ne u tërhoqëm nga përdorimi i tij.
Ne përdorim një plumb mbushës në daljen e Fluentd për të parandaluar humbjen e logeve në rast të problemeve të përkohshme me rrjetin ose rritjes së intensitetit të shkrimit të logeve. Nëse për ndonjë arsye ElasticSearch nuk mund të regjistrojë menjëherë dokumentin në indeks, dokumenti shkon në një radhë që ruhet në disk. Prandaj, në rastin tonë, për të eliminuar burimin e problemit që çon në shfaqjen e gabimit të përmendur më sipër, është e nevojshme të vendosen vlera të sakta për parametrat e mbushjes, të cilat do të sigurojnë që tamponi i daljes së Fluentd të ketë përmasa të mjaftueshme dhe të pastrohet brenda kohës së caktuar.
Vlen të theksohet se vlerat e parametrave, rreth të cilave do të flitet më poshtë, janë individuale për çdo rast konkret të përdorimit të mbushjes në plumbat e daljes, pasi varen nga shumë faktorë: intensiteti i shkrimeve të logeve nga shërbimet, performanca e sistemit të diskut, ngarkesa e kanaleve të rrjetit dhe kapaciteti i tij. Prandaj, për të marrë cilësimet e përshtatshme për çdo rast, pa qenë të tepruara, duke shmangur kalimin e gjatë në errësirë, mund të përdoren informacionet diagnostikues që Fluentd shkruan në logun e tij gjatë funksionimit për të marrë relativisht shpejt vlera të sakta.
Në momentin e shpërthimit të problemit, konfigurimi dukej si më poshtë:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
Gjatë zgjidhjes së problemit, u përcaktuan manualisht vlerat e parametrave të mëposhtëm:
chunk_limit_size — madhësia e chmod-it, në të cilat ndahen mesazhet në tampon.
- flush_interval — intervali i kohës, pas të cilit ndodh pastrimi i tamponit.
- queue_limit_length — numri maksimal i copëzave në radhë.
- request_timeout — koha për të cilën vendoset lidhja midis Fluentd dhe ElasticSearch.
Shuma totale e tamponit mund të llogaritet duke shumëzuar parametrat queue_limit_length dhe chunk_limit_size, që mund të interpretohet si «numri maksimal i copëzave në radhë, secili prej të cilëve ka një vëllim të caktuar». Nëse madhësia e tamponit është e pamjaftueshme, në log do të shfaqet paralajmërimi i mëposhtëm:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] dështoi në shkrimin e të dhënave në tampon për shkak të veprimit të mbipastrimit action=:blockKjo do të thotë se tamponi nuk arrin të pastrohet brenda kohës së caktuar dhe të dhënat që hyjnë në tamponin e mbushur bllokohen, duke çuar në humbjen e disa logëve.
Mund të rritet tamponi në dy mënyra: duke rritur ose madhësinë e çdo copëz në radhë, ose numrin e copëzave që mund të jenë në radhë.
Nëse vendosni madhësinë e copëzës chunk_limit_size më shumë se 32 megabajt, ElasticSearch nuk do ta pranojë atë, sepse paketa hyrese do të jetë shumë e madhe. Prandaj, nëse është e nevojshme të rritet tamponi për më shumë, është më mirë të rritet gjatësia maksimale e radhës queue_limit_length.
Kur tamponi të ndalojë së mbipastruari dhe të mbetet vetëm mesazhi për mungesë kohë - ndalimi, mund të filloni të rrisni parametrin request_timeout. Megjithatë, kur vendosni një vlerë më shumë se 20 sekonda, në log-et e Fluentd do të fillojnë të shfaqen paralajmërimet e mëposhtme:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] pastrimi i tamponit zuri më shumë kohë se slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Ky mesazh nuk ndikon në funksionimin e sistemit dhe tregon se koha e pastrimit të tamponit zuri më shumë se sa është vendosur nga parametrin slow_flush_log_threshold. Kjo është informacion ndihmës dhe ne e përdorim atë në përcaktimin e vlerës së parametrin request_timeout.
Algoritmi i përgjithshëm i përcaktimit duket si më poshtë:
- Vendosni vlerën e request_timeout që garanton të jetë më e madhe se e nevojshme (qindra sekonda). Gjatë konfigurimit, kriteri kryesor për saktësinë e vendosjes së këtij parametri do të jetë zhdukja e paralajmërimeve për mungesë kohe.
- Pritni mesazhe për tejkalimin e pragut slow_flush_log_threshold. Në tekstin e paralajmërimit, në fushën elapsed_time do të shkruhet koha reale e pastrimit të tamponit.
- Vendosni vlerën request_timeout më të lartë se vlera maksimale elapsed_time e marrë gjatë periudhës së monitorimit. Ne llogarisim vlerën e request_timeout si elapsed_time + 50%.
- Për të hequr paralajmërimet për pastrimin e gjatë të buffer-it nga log, mund të rritet vlera slow_flush_log_threshold. Ne llogarisim këtë vlerë si elapsed_time + 25%.
Vlerat përfundimtare të këtyre parametrave, siç u vërejt më parë, janë individuale për çdo rast. Duke ndjekur algoritmin e lartpërmendur, ne garantojmë eliminimin e gabimit që çon në përsëritjen e mesazheve.
Tabela më poshtë tregon si ndryshon numri i gabimeve në ditë që çojnë në dublikimin e mesazheve, gjatë procesit të përshtatjes së vlerave të parametrave të përmendur më lart:
node-1
node-2
node-3
node-4
Para/Pas
Para/Pas
Para/Pas
Para/Pas
dështoi të pastrojë buffer-in
1749/2
694/2
47/0
1121/2
ri-rendi i suksesshëm
410/2
205/1
24/0
241/2
Vlen të theksohet se konfigurimet e marra mund të humbasin aktualitetin e tyre gjatë rritjes së projektit dhe, për rrjedhojë, rritjes së numrit të log-eve. Një shenjë fillestare e mungesës së kohës së caktuar është rikthimi në log-un Fluentd të mesazheve për pastrimin e gjatë të buffer-it, që do të thotë tejkalimi i pragut slow_flush_log_threshold. Nga ky moment ka një rezervë të vogël deri në tejkalimin e parametrave request_timeout, prandaj është e nevojshme të reagoni në kohë ndaj këtyre mesazheve dhe të kryeni përsëri procesin e përcaktimit të konfigurimeve optimale të përshkruara më sipër.
Përfundim
Rregullimi i delikates për buffer-in e daljes së Fluentd është një nga etapet kryesore të konfigurimit të stekës EFK, që përcakton stabilitetin e tij dhe saktësinë e dislokimit të dokumenteve në indekset. Duke u orientuar nga algoritmi i përshkruar për konfigurimin, mund të jeni të sigurt se të gjithë log-et do të regjistrohen në indeksin ElasticSearch në rendin e duhur, pa përsëritje dhe humbje.
Lexoni gjithashtu artikuj të tjerë në blogun tonë:
Burimi: habr.com
