

Ekipa ofron i inxhinierit Rahul Bhatia nga kompania Clairvoyant mbi format e skedarëve në të dhënat e mëdha, funksionet më të zakonshme të formateve Hadoop dhe cilin format është më i mirë për t'u përdorur.
Pse na nevojiten formate të ndryshme skedarësh
Një pikë e rëndësishme e ngadalësimit në performancën e aplikacioneve që mbështesin HDFS, si MapReduce dhe Spark, është koha e kërkimit, leximit dhe shkrimit të të dhënave. Këto probleme përkeqësohen nga vështirësitë në menaxhimin e grupeve të mëdha të të dhënave, nëse kemi një skemë të evolucionit të saj, ose janë të pranishme disa kufizime mbi ruajtjen.
Përpunimi i të dhënave të mëdha rrit ngarkesën mbi subsistemin e ruajtjes — Hadoop ruan të dhënat në mënyrë të tepërt për të arritur qëndrueshmërinë. Përveç disqeve, ngarkohen procesori, rrjeti, sistemi i hyrjes-daljes dhe kështu me radhë. Ndërsa rritet volumi i të dhënave, rritet gjithashtu kostoja e përpunimit dhe ruajtjes së tyre.
Format e ndryshme të skedarëve në janë krijuar për të adresuar këto çështje. Zgjedhja e formatit të duhur të skedarëve mund të sjellë disa avantazhe të rëndësishme:
- Koha më e shpejtë e leximit.
- Koha më e shpejtë e shkrimit.
- Skedarë të ndashëm.
- Mbështetje për evolucionin e skemave.
- Mbështetje e avancuar për kompresim.
Disa formate skedarësh janë të destinuara për përdorim të përgjithshëm, të tjera për variante të më specifikuara, dhe disa janë të dizajnuara me karakteristika të caktuara të të dhënave në mendje. Pra, zgjedhja është të vërtetë mjaft e madhe.
Formati i skedarëve Avro
Për për serializimin e të dhënave shumë përdorin Avro — ky është format i bazuar në stringje, pra formati me stringje, për ruajtjen e të dhënave në Hadoop. Ai ruan skemën në formatin JSON, duke e lehtësuar leximin dhe interpretimin e saj nga çdo program. Të dhënat vetë janë në formatin binar, kompakt dhe efikas.
Sistemi i serializimit Avro është neutral ndaj gjuhëve. Skedarët mund të përpunohen nga gjuhë të ndryshme, për momentin këto janë C, C++, C#, Java, Python dhe Ruby.
Një karakteristikë kyçe e Avro është mbështetje e besueshme për skema të të dhënave që ndryshojnë me kalimin e kohës, pra evolucionin e tyre. Avro kupton ndryshimet në skemë — fshirja, shtimi ose ndryshimi i fushave.
Avro mbështet struktura të ndryshme të të dhënave. Për shembull, mund të krijoni një rekord që përmban një pjesë, lloj enumerues dhe një nën-rekord.
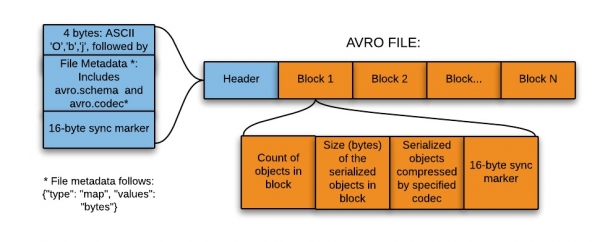
Ky ky format është perfekt për regjistrimin në zonën e uljes (kalimi) të liqenit të të dhënave (, ose data lake — një koleksion instancash për ruajtjen e llojeve të ndryshme të të dhënave përveç burimeve të dhënash direkt).
Pra, për regjistrimin në zonën e uljes të liqenit të të dhënave, ky format është më i përshtatshmi për arsye të mëposhtme:
- Të dhënat nga kjo zonë zakonisht lexohen tërësisht për përpunim të mëtejshëm nga sistemet poshtë — dhe formati bazuar në rreshta në këtë rast është më efikas.
- Sistemet poshtë mund të nxjerrin lehtësisht skemat e tabelave nga skedarët — nuk është e nevojshme të ruani skemat ndaras në një meta-ruajtje të jashtme.
- Çdo ndryshim në skemën origjinale përpunohen lehtësisht (evolucioni i skemës).
Formati i skedarëve Parquet
Parquet është një format skedari me burim të hapur për Hadoop, i cili ruan strukturat e të dhënave të mbjella në një format të thjeshtë kolone.
Në krahasim me qasjen tradicionale në rreshta, Parquet është më efikas në aspektin e ruajtjes dhe performancës.
Kjo është veçanërisht e dobishme për pyetje që lexojnë kolona specifike nga një tabelë të gjerë (me shumë kolona). Falë formatit të skedarëve, lexohen vetëm kolonat e nevojshme, duke minimizuar hyrjet dhe daljet.
Një sqarim i shkurtër: për të kuptuar më mirë formatin e skedarit Parquet në Hadoop, le të shikojmë çfarë është një format i bazuar në kolona — domethënë një format kolone. Në një format të tillë ruhen së bashku vlera të njëjtë për çdo kolonë.
, regjistrimi përmban fushat ID, Emri dhe Departamenti. Në këtë rast, të gjitha vlerat e kolonës ID do të ruhen së bashku, ashtu si vlerat e kolonës Emri e kështu me radhë. Tabela do të duket pak a shumë kështu:
ID
Emri
Departamenti
1
emp1
d1
2
emp2
d2
3
emp3
d3
Në formatin e rreshtit, të dhënat do të ruhen si më poshtë:
1
emp1
d1
2
emp2
d2
3
emp3
d3
Në formatin e kolone të skedarëve, të njëjtat të dhëna do të ruhen kështu:
1
2
3
emp1
emp2
emp3
d1
d2
d3
Formati kolone është më efikas kur keni nevojë të kërkoni disa kolona nga tabela. Ai do të lexojë vetëm kolonat e nevojshme, sepse ato ndodhen afër njëra-tjetrës. Kështu, operacionet e hyrjes dhe daljes minimizohen.
Për shembull, ju nevojitet vetëm kolona EMRI. Në Çdo regjistrim në grupin e dhënave duhet ngarkuar, analizuar sipas fushave dhe pastaj të nxirren të dhënat NAME. Formati kolonar lejon që të kaloni direkt te kolona Name, pasi të gjitha vlerat për këtë kolonë ruhen së bashku. Nuk do të jetë e nevojshme të skanoni të gjithë regjistrimin.
Kështu, formati kolonor rrit performancën e kërkesave, pasi kalimi te kolonat e nevojshme kërkon më pak kohë kërkimi dhe zvogëlon numrin e operacioneve të hyrje-daljeve, duke lexuar vetëm kolonat e nevojshme.
Një nga veçoritë unike ka të bëjë me faktin se në këtë format ai mund të ruajë të dhëna me struktura të shtrirë. Kjo do të thotë se në skedarin Parquet, madje fushat e shtrira mund të lexohen veçmas pa qenë nevoja të lexoni të gjitha fushat në strukturën e shtrirë. Për ruajtjen e strukturave të shtrirë, Parquet përdor algoritmin e grimcimit dhe montimit (shredding and assembly).
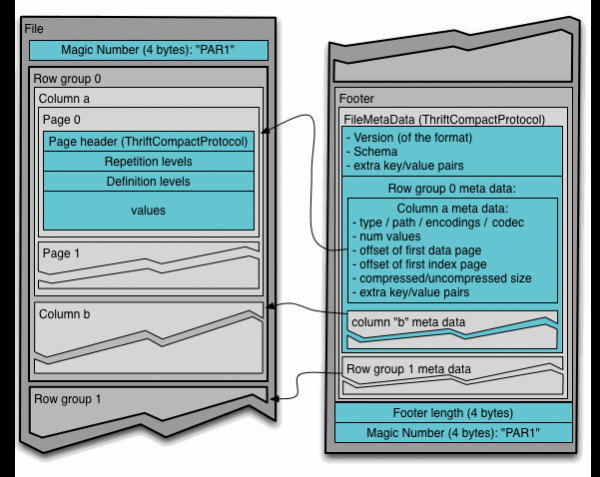
Për të kuptuar formatin e skedarit Parquet në Hadoop, duhet të dini termat e mëposhtëm:
- Grupi i rreshtave (row group): ndarje logjike horizontale e të dhënave në rreshta. Grupi i rreshtave përbëhet nga një fragment i çdo kolone në grupin e dhënave.
- Fragmenti i kolonës (column chunk): fragmenti i një kolonë specifike. Këto fragmente kolonash jetojnë në një grup rreshtash të caktuar dhe garantimisht do të jenë ngjitur në skedar.
- Faqja (page): fragmentet e kolonave ndahen në faqe, të shkruara një pas tjetrës. Faqet kanë një titull të përbashkët, kështu që kur lexoni, mund të kaloni ato të padëshiruara.
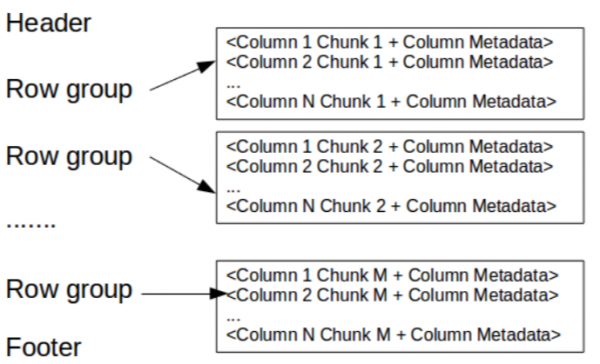
Këtu, titulli thjesht përmban numrin magjik PAR1 (4 byte), i cili identifikon skedarin si një skedar të formatit Parquet.
Në fund është shkruar e mëposhtme:
- Meta të dhënat e skedarit, të cilat përmbajnë koordinatat fillestare të meta të dhënave për çdo kolonë. Kur lexoni, duhet së pari të lexoni meta të dhënat e skedarit për të gjetur të gjitha fragmentet e kolonave të interesit. Pastaj, fragmentet e kolonave duhet të lexohen radhazi. Meta të dhënat përfshijnë gjithashtu versionin e formatit, skemën dhe çdo çift shtesë çelës-vlerë.
- Gjatësia e meta të dhënave (4 byte).
- Numri magjik PAR1 (4 byte).
Formati i skedarëve ORC
Formati i skedarëve të optimizuar rresht-kolonës (Optimized Row Columnar, ) ofron një mënyrë shumë efektive për ruajtjen e të dhënave dhe është zhvilluar për të tejkaluar kufizimet e formateve të tjera. Ruajt të dhënat në një formë të përsosur kompakte, duke lejuar kalimin e detajeve të panevojshme — pa kërkuar ndërtimin e indekseve të mëdha, të komplikuara apo manualisht të mbajtura.
Përfitimet e formatit ORC:
- Një skedar në daljen e çdo detyre, që redukton ngarkesën në NameNode (nyja e emrave).
- Mbështetje për tipet e të dhënave Hive, duke përfshirë DateTime, decimal dhe tipe të dhënash komplekse (struct, list, map dhe union).
- Leximi njëkohësisht i të njëjtit skedar nga procese të ndryshme RecordReader.
- Mundësia për të ndarë skedarët pa skanuar për shenja.
- Vlerësimi i ndarjes maksimale të mundshme të memories heap për proceset e leximit/shkrimit sipas informacionit në fundin e skedarit.
- Metadatët ruhen në formatin binar të serializimit Protocol Buffers, që lejon shtimin dhe heqjen e fushave.
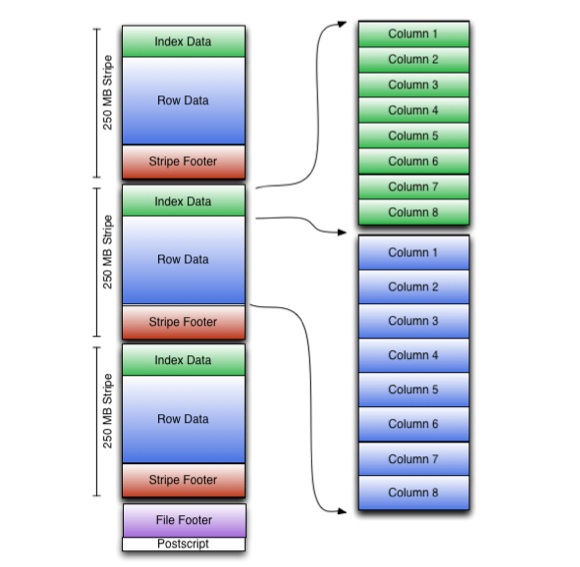
ORC ruan koleksionet e rreshtave në një skedar, ndërsa brenda koleksionit, të dhënat rreshtore ruhen në formatin kolonor.
Skedari ORC ruan grupe rreshtash, që quhen stripes, dhe informacion të ndihmës në fundin e skedarit. Postscript në fund të skedarit përmban parametrat e kompresimit dhe madhësinë e fundin të kompresuar.
Për default, madhësia e stripe është 250 MB. Përmes stripe-ve të këtij madhësi të madhe, leximi nga HDFS kryhet më efektivisht: me blloqe të mëdha të pandërprera.
Në fundin e skedarit është e regjistruar një listë stripe në skedar, numri i rreshtave për stripe dhe tipi i të dhënave për çdo kolonë. Aty gjithashtu regjistrohet vlera rezultante count, min, max dhe sum për çdo kolonë.
Fundi i stripe përmban një katalog vendndodhjesh të fluxit.
Të dhënat rreshtore përdoren gjatë skanimit të tabelave.
Të dhënat e indeksit përfshijnë vlerat minimale dhe maksimale për çdo kolonë dhe pozitat e rreshtave në çdo kolonë. Indekset ORC përdoren vetëm për selektimin e stripe-ve dhe grupeve të rreshtave, dhe jo për të përgjigjur kërkesave.
Krahasimi i formateve të ndryshme të skedarëve
Avro krahasuar me Parquet
- Avro është një format ruajtjeje sipas rreshtave, ndërsa Parquet ruan të dhënat sipas kolonave.
- Parquet është më i përshtatshëm për kërkesat analitike, që do të thotë se operacionet e leximit dhe kërkesës për të dhëna janë shumë më efektive se sa shkrimi.
- Operacionet e shkrimit në Avro kryhen më efektivisht se në Parquet.
- Avro funksionon më matur me evolucionin e skemave. Parquet mbështet vetëm shtimin e skemës, ndërsa Avro ka implementuar një evolucion multifunksional, që do të thotë shtimin ose ndryshimin e kolonave.
- Parquet është ideal për të kërkuar një nëngrup kolonash në një tabelë me shumë kolona. Avro është i përshtatshëm për operacionet ETL, ku ne kërkojmë të gjitha kolonat.
ORC krahasuar me Parquet
- Parquet ruan më mirë të dhënat e emtuara.
- ORC është më i përshtatshëm për shtimin e predikateve.
- ORC mbështet pronat ACID.
- ORC kompreson më mirë të dhënat.
Çfarë tjetër të lexoni mbi këtë temë:
- .
- .
- .
Burimi: habr.com
