

Përshëndetje, lexues të Habrës. Me këtë artikull ne hapim një cikël që do të flasë për sistemin hibrid të zhvilluar nga ne, AERODISK vAIR. Fillimisht dëshironim që me artikullin tonë të parë të flisnim gjithçka për gjithçka, por sistemi është mjaft kompleks, prandaj do ta hamë elefantin në pjesë.
Të fillojmë tregimin me historinë e krijimit të sistemit, do të thellohemi në sistemin e skedarëve ARDFS, i cili është baza e vAIR, si dhe do të bisedojmë pak rreth pozicionimit të këtij zgjidhjeje në tregun rus.
Në artikujt e ardhshëm do të flasim më në detaje për komponentët e ndryshëm arkitekturorë (kluster, hipervizor, balancues ngarkese, sistem monitorimi etj.), procesin e konfigurimit, do të ngremë çështjet e licencimit, do të shfaqim testet e crash-it dhe, sigurisht, do të shkruajmë për testimin e ngarkesës dhe sizing-un. Po ashtu, do t'i dedikojmë një artikull veçanërisht versionit community të vAIR.
AERODISK është si një histori e ruajtjes së të dhënave? Apo pse filluam ne në të vërtetë të merremi me hibridizimin?
Fillimisht ideja për të krijuar sistemin tonë hibrid na është ardhur dikur rreth vitit 2010. Atëherë nuk kishte as AERODISK, as zgjidhje të ngjashme (sisteme komerciale hibridizimi) në treg. Detyra jonë ishte si më poshtë: nga një grup serverësh me disqe lokale, të lidhur përmes një interkonnektiviteti me protokollin Ethernet, të krijonim një depo të shpërndarë dhe po aty të ekzekutonim makinat virtuale dhe rrjetin programor. E gjithë kjo nevojitej të realizohej pa një sistem ruajtjeje (pasi nuk kishim fonde për një sistem të tillë dhe as nuk e kishim shpikur sistemin tonë në atë kohë).
Provoëm shumë zgjidhje open source dhe megjithatë arritëm ta zgjidhnim këtë detyrë, por zgjidhja ishte shumë komplekse dhe e vështirë për t'u përsëritur. Për më tepër, kjo zgjidhje ishte në një lloj kategorie «Funksionon? Mos e prek!». Prandaj, pasi e zgjidhëm atë detyrë, nuk vendosëm të zhvillonim më tej idenë e kthimit të rezultatit të punës sonë në një produkt të plotë.
Pas asaj ngjarjeje, ne u larguam nga kjo ide, por ndjenja e asaj detyre vazhdoi të na përcjellë, ndërsa dobinë nga një zgjidhje e tillë e kishte më se të dukshme. Në vazhdim, produktet HCI të lansuara nga kompanitë e huaja vetëm sa e konfirmuan këtë ndjenjë.
Prandaj, në mesin e vitit 2016, ne u kthyem në këtë projekt si pjesë e krijimit të një produkti të plotë. Në atë kohë, ne nuk kishim asnjë marrëdhënie me investitorët, prandaj u detyruam të blinim stendën e zhvillimit me paratë tona të vogla. Duke kërkuar në Avito për serverë dhe switch-e të përdorur, filluam punën.
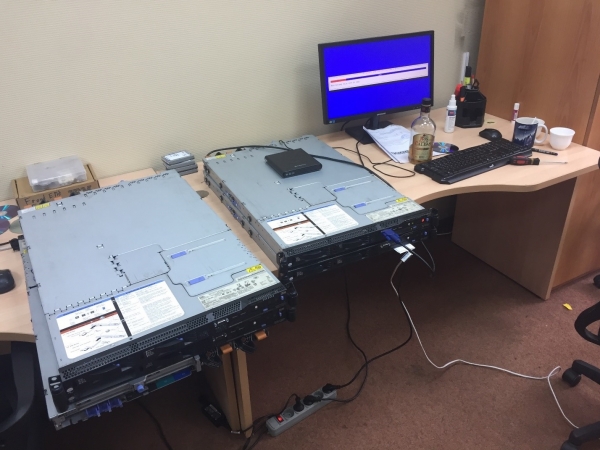
Detyra kryesore fillestare ishte krijimi i një sistemi të vetin të skedarëve, pavarësisht se sa i thjeshtë, që do të ishte në gjendje të shpërndante automatikisht dhe në mënyrë të barabartë të dhënat në formën e blloqeve virtuale në një numër n të nyjeve të klusterit, të cilat ishin të lidhura me njëra-tjetrën përmes Ethernet-it. Në të njëjtën kohë, FS duhej të shkallëzonte mirë dhe lehtësisht dhe të ishte e pavarur nga sistemet e afërta, dmth. të ishte e shkëputur nga vAIR si një "thjesht ruajtje".
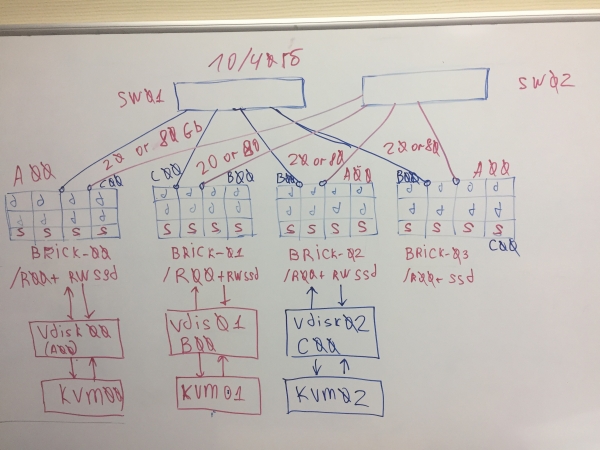
Koncepti i parë i vAIR
Ne qëllimisht refuzuam përdorimin e zgjidhjeve gati të hapura open source për organizimin e një depozitimi të shpërndarë (ceph, gluster, lustre dhe të ngjashme) në favor të zhvillimit tonë, pasi tashmë kishim përvojë të madhe projektimi me to. Sigurisht, këto zgjidhje janë të shkëlqyera vetë, dhe para se të fillonim punën me Aerodisk, kishim realizuar disa projekte integruese me to. Por një gjë është të realizosh një detyrë specifike për një klient, të trajnotosh stafin dhe, ndoshta, të blesh mbështetje nga një ofrues i madh, dhe krejt ndryshe është të krijosh një produkt të lehtë për ta riprodhuar, që do të përdoret për detyra të ndryshme, që për to, si ofrues, ndoshta nuk do të dimë as vetë. Për qëllimin e dytë, produktet ekzistuese open source nuk na përshtateshin, prandaj vendosëm ta zhvillonim sistemin e shpërndarë të skedarëve vetë.
Pas dy vitesh, forca e disa zhvilluesve (të cilët kombinonin punën mbi vAIR me punën mbi klasiken SHD Engine) arritën një rezultat të caktuar.
Në vitin 2018, ne shkruam një sistem të thjeshtë skedarësh dhe e plotësuam atë me lidhjet e nevojshme. Sistemi bashkonte disqet fizike (lokale) nga serverë të ndryshëm në një reservoir të sheshtë dhe i "priste" ato në blloqe virtuale, më pas nga blloqet virtuale krijoheshin pajisje bllokues me një nivel të caktuar të qëndrueshmërisë ndaj dështimeve, mbi të cilat, me ndihmën e hipervizorit KVM, krijoheshin dhe ekzekutoheshin makinat virtuale.
Ne kemi vendosur ta quajmë sistemin e skedarëve ARDFS (kuptoni vetë se çfarë do të thotë))
Ky prototip dukej mirë (sigurisht, jo vizualisht, sepse atëherë nuk kishte as një dizajn vizual) dhe tregoi rezultate të mira në performancë dhe shkallëzueshmëri. Pas rezultatit të parë real, e vazhduam këtë projekt, duke organizuar një mjedis të plotë zhvillimi dhe një ekip të veçantë që merrej vetëm me vAIR.
Ajo kohë e bëri të qartë arkitekturën e përgjithshme të zgjidhjes, e cila deri tani nuk ka pësuar ndryshime të rëndësishme.
Le të thellojmë në sistemin e skedarëve ARDFS
ARDFS është baza e vAIR, e cila siguron ruajtjen e të dhënave të shpërndara dhe të besueshme të gjithë klasterit. Një nga (por jo e vetmja) veçori dalluese e ARDFS është se ajo nuk përdor asnjë menaxhim të jashtëm. serverësh të dedikuar I gjithë ky koncept është menduar fillimisht për të thjeshtuar konfigurimin e zgjidhjes dhe për besueshmërinë e saj.
Struktura e ruajtjes
Në të gjitha nodet e klasterit, ARDFS organizon një rezervuar logjik nga e gjithë hapësira e disponueshme e shtesave. Është e rëndësishme të kuptoni se rezervuari nuk janë ende të dhëna dhe as hapësirë e formatizuar, por thjesht një ndarje, dmth. çdo nodë me vAIR të instaluar kur shtohet në klaster automatikisht bashkohet në rezervuarin e përbashkët ARDFS dhe burimet diskore bëhen automatikisht të zakonshme për të gjithë klasterin (dhe të disponueshme për ruajtjen e ardhshme të të dhënave). Ky qasje lejon që nodet të shtohen dhe hiqen në flakë pa ndonjë ndikim të rëndësishëm në sistemin që po punon. Pra, sistemi është shumë i lehtë për t'u shkallëzuar me 'blloqe', duke shtuar ose hequr nodet nga klasteri sipas nevojës.
Përmbi rezervuarin ARDFS shtohen disqet virtuale (objekte ruajtjeje për virtualët), të cilat ndërtohen nga blloqe virtuale me madhësi 4 megabajt. Të dhënat ruhen drejtpërdrejt në disqet virtuale. Në nivelin e disqeve virtuale gjithashtu përcaktohet një skemë besueshmërie.
Si ndoshta mund të keni kuptuar, për disponueshmërinë e sistemit të diskut nuk përdorim konceptin RAID (Grupi i tepërt i Disqeve të Pavarura), por përdorim RAIN (Grupi i tepërt i Nodëve të Pavarur). Pra, disponueshmëria matet, automatizohet dhe menaxhohet në bazë të nodëve, jo të disqeve. Disqet, natyrisht, janë gjithashtu objekte ruajtjeje, ato, ashtu si gjithçka tjetër, monitorohen dhe mund të kryejnë të gjitha operacionet standarde, përfshirë ndërtimin e një RAID lokal, por klubi operon pikërisht me nodët.
Në situata kur shumë dëshirohet RAID (p.sh., skenari që mbështet dështime të shumta në klasterët e vegjël), asgjë nuk e ndalon përdorimin e kontrollorëve të RAID lokalë, dhe mbi ta të krijohet një ruajtje e zgjatur dhe një arkitekturë RAIN. Ky skenar është plotësisht i zbatueshëm dhe mbështetet nga ne, prandaj do ta diskutojmë në artikullin tonë për skenarët tipik të përdorimit të vAIR.
Skemat e disponueshmërisë së ruajtjes
Mund të ketë dy skema disponueshmërie për disqet virtuale në vAIR:
1) Faktori i replikimit ose thjesht replikimi – kjo metodë disponueshmërie është e thjeshtë "si një shkop dhe litar". Kryhet replikimi sinkron midis nodëve me faktor 2 (2 kopje për klaster) ose 3 (3 kopje, përkatësisht). RF-2 i lejon disqet virtuale të përballojnë dështimin e një nodi në klaster, por "ha" gjysmën e volumit të dobishëm, ndërsa RF-3 do të përballojë dështimin e 2 nodëve në klaster, por do t'i rezervojë 2/3 të volumit të dobishëm për nevojat e tij. Kjo skemë është shumë e ngjashme me RAID-1, domethënë një disk virtual i konfiguruar në RF-2 është i qëndrueshëm ndaj dështimit të cilitdo nod të vetëm të klasterit. Në këtë rast, të dhënat do të jenë në rregull dhe madje I/O nuk do të ndalet. Kur nodi i rënë të kthehet në punë, do të fillojë rikuperimi/sinkronizimi automatik i të dhënave.
Më poshtë janë shembuj të shpërndarjes së të dhënave RF-2 dhe RF-3 në modalitetin normal dhe në situatat e dështimeve.
Ne kemi një makinë virtuale me 8MB të dhënash unike (të dobishme), e cila punon në 4 nodet vAIR. Është e qartë se në realitet një volum kaq i vogël nuk do të jetë i mundur, por për diagramën që pasqyron logjikën e punës së ARDFS, ky shembull është më i qartë. AB janë blloqe virtuale prej 4MB që përmbajnë të dhëna unike të makinës virtuale. Në RF-2 krijohen dy kopje të këtyre blloqeve A1 + A2 dhe B1 + B2, përkatësisht. Këto blloqe “shpërndahen” në nodet, duke shmangur mbivendosjen e të njëjtave të dhëna në një nodë, domethënë kopja A1 nuk do të jetë në një nodë me kopjen A2. Me B1 dhe B2 është e ngjashme.
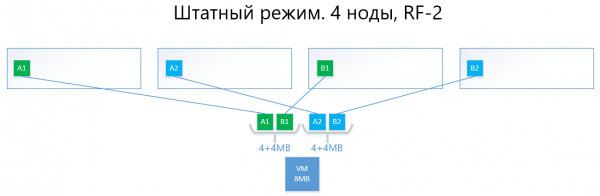
Në rast se njëra nga nodet ndalon (p.sh., nodi nr. 3, ku ndodhet kopja B1), kjo kopje aktivizohet automatikisht në nodin ku nuk ka kopje të kopjes së saj (domethënë kopjes B2).
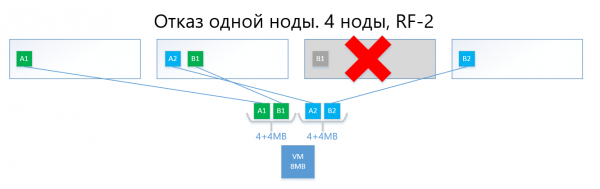
Kështu, disku virtual (dhe VM, përkatësisht) do t'i mbijetojë lehtë ndalimit të një nodi në skemën RF-2.
Skema me replikim, megjithëse e thjeshtë dhe e besueshme, vuan nga të njëjtin problem si RAID1 – hapësirë e vogël të dobishme.
2) Kodimi i fshirjes ose kodimi i fshirjes (i njohur gjithashtu si «kodim i tepricës» ose «kod i tepricës») ekziston për të zgjidhur problemin e mësipërm. EC është një skemë teprice që garanton një akses të lartë në të dhëna me më pak shpenzime në hapësirën e diskut krahasuar me replikimin. Parimi i funksionimit të këtij mekanizmi është i ngjashëm me RAID 5, 6, 6P.
Në kodimin EC, procesi e ndan bllokun virtual (për default 4MB) në disa ‘copëza të dhënash’ më të vogla, varësisht nga skema EC (p.sh., skema 2 + 1 e ndan çdo bllok 4 MB në 2 copa prej 2MB). Pas kësaj, ky proces gjeneron për ‘copëzat e të dhënave’ ‘copëza pariteti’ me madhësi jo më të madhe se një nga pjesët e ndara më parë. Kur dekodohet, EC gjeneron copët që mungojnë duke lexuar të dhënat ‘e mbetura’ në të gjithë klasterin.
Për shembull, disku virtual me skemën EC 2 + 1, e realizuar në 4 nodet e klasterit, do të përballojë lehtësisht ndalimin e një nodi në klaster ashtu si RF-2. Ndërsa shpenzimet do të jenë më të ulta, në veçanti koeficienti i kapacitetit të dëgjueshëm në RF-2 është 2, ndërsa për EC 2 + 1 do të jetë 1,5.
Nëse për ta përshkruar më thjeshtë, thelbi është se blloku virtual ndahet në 2-8 (pse nga 2 deri në 8 shih më poshtë) ‘copëza’, dhe për këto copëza llogariten ‘copëza’ pariteti të njëjtë në volum.
Si në fund, të dhënat dhe pariteti shpërndahen në mënyrë uniforme në të gjitha nodet e klasterit. Po ashtu, si në rastin e replikimit, ARDFS automatikisht shpërndan të dhënat në nodet në një mënyrë që parandalon ruajtjen e të njëjtave të dhëna (kopia e të dhënave dhe pariteti i tyre) në një nod, për të eliminuar mundësinë e humbjes së të dhënave, nëse të dhënat dhe pariteti i tyre ndodhen papritur në një nod ruajtjeje që dështojnë.
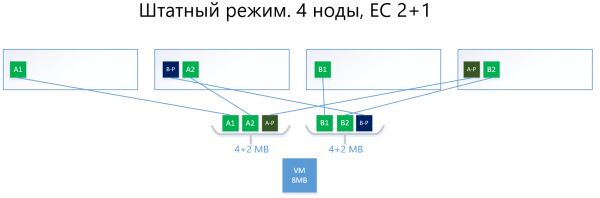
Më poshtë është një shembull, me të njëjtën virtualizim në 8 MB dhe 4 nod, por tashmë me skemën EC 2+1.
Blloqet A dhe B ndahen në dy pjesë secila 2 MB (në dy sepse 2+1), pra në A1+A2 dhe B1+B2. Në kundërshtim me replikën, A1 nuk është një kopje e A2, është një bllok virtual A, i ndarë në dy pjesë, ashtu si edhe blloku B. Në përfundim, ne kemi dy grupe prej 4MB, në secilin prej të cilëve ndodhen dy copëza dymegabajtëshe. Më tej, për secilin prej këtyre grupeve llogaritet pariteti me një volum më të vogël se një copë (dmth. 2 MB), duke marrë përfundimisht + 2 copëza pariteti (A-P dhe B-P). Në përfundim, kemi 4×2 të dhëna + 2×2 paritet.
Më tej, copëzat "shpërndahen" në nodet në një mënyrë që të dhënat të mos përputhen me paritetin e tyre. Kështu, A1 dhe A2 nuk do të jenë në të njëjtën nod me A-P.
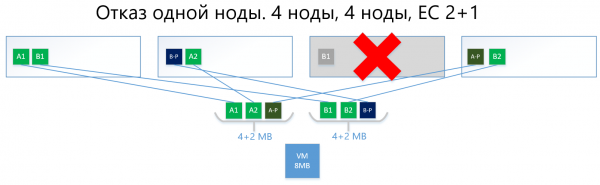
Në rast të defektit të një nodi (le të themi, nodi i tretë), blloku i rënë B1 do të rikthehet automatikisht nga pariteti B-P, i ruajtur në nodin nr. 2, dhe do të aktivizohet në nodin ku nuk ka paritet B, dmth. copëza B-P. Në këtë shembull – kjo është nodi nr. 1.
Jam i sigurt që lexuesi ka një pyetje:
"Gjithçka që keni përshkruar, është realizuar prej kohësh nga konkurrentët dhe në zgjidhjet open source, cila është ndryshimi i implementimit tuaj të EC në ARDFS?"
Më pas do të paraqiten karakteristikat interesante të funksionimit të ARDFS.
Kodimi i shkatërrimit me theks në fleksibilitet
Fillimisht ne parashikuam një skemë mjaft fleksibël EC X+Y, ku X është numri nga 2 deri në 8, dhe Y është numri nga 1 deri në 8, por gjithmonë më i vogël ose i barabartë me X. Kjo skemë është parashikuar për fleksibilitet. Rritja e numrit të copëzave të të dhënave (X), në të cilat ndahet blloku virtual, lejon uljen e kostove operative, pra rritjen e hapësirës së dobishme.
Rritja e numrit të copëzave të paritetit (Y) rrit qëndrueshmërinë e diskut virtual. Sa më e madhe të jetë vlera e Y, aq më shumë nodet në klaster mund të dështojnë. Natyrisht, rritja e volumit të paritetit ul volumetrinë e kapacitetit të dobishëm, por kjo është një çmim për qëndrueshmëri.
Varësia e performancës në skemat EC është pothuajse e drejtpërdrejtë: sa më shumë "copëza", aq më e ulët është performanca, këtu, është e qartë, nevojitet një vlerësim i balancuar.
Ky qasje lejon administratorët të konfigurojnë ruajtjen e zgjatur sa më fleksibël. Brenda grupit ARDFS është e mundur të përdoren çdo skemë të qëndrueshmërisë dhe kombinime të tyre, që gjithashtu, sipas mendimit tonë, është shumë e dobishme.
Më poshtë është një tabelë krahasimi e disa (jo të gjitha të mundshme) skemave RF dhe EC.
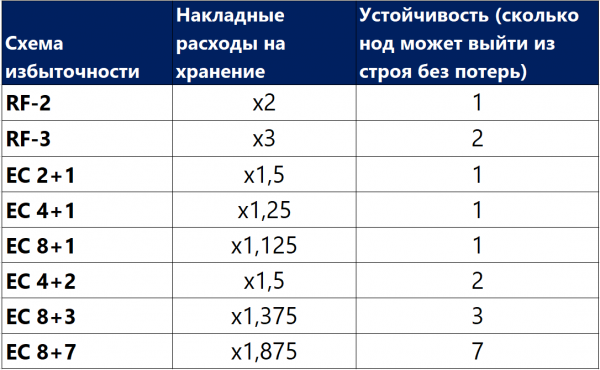
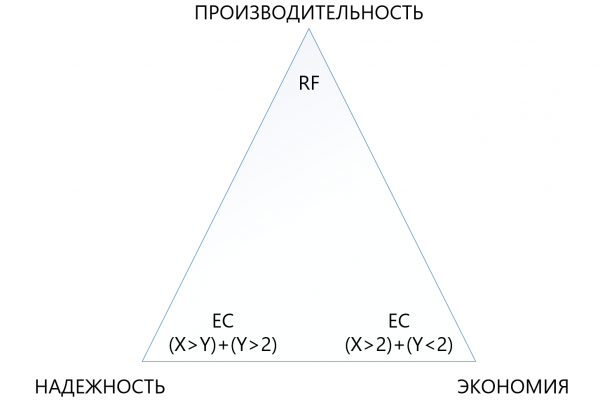
Nga tabela tregohet se edhe kombinimi më "i avancuar" EC 8+7, i cili lejon humbjen e deri në 7 nodëve në klaster, "hap" më pak hapësirë të dobishme (1,875 ndaj 2), se sa replikimi standard, dhe mbron 7 herë më mirë, që e bën këtë mekanizëm mbrojtjeje ndonëse më të ndërlikuar, por dukshëm më tërheqës në situatat kur është e nevojshme të sigurohet një besueshmëri maksimale në kushte të mungesës së hapësirës diskore. Në të njëjtën kohë, duhet të kuptohet se çdo "plus" në X ose Y do të jetë një shpenzim shtesë në performancë, prandaj në trekëndëshin mes besueshmërisë, kursimit dhe performancës duhet të zgjidhet me shumë kujdes. Për këtë arsye, një artikull të veçantë do t'i kushtohet dimensionimit të kodimit të largët.
Besueshmëria dhe autonomitë e sistemit të skedarëve
ARDFS запускаhet lokal në të gjitha nodët e klasterit dhe sinkronizon ato me mjete të veta përmes ndërfaqeve të dedikuara Ethernet. Një aspekt i rëndësishëm është se ARDFS sinkronizon automatikisht jo vetëm të dhënat, por edhe metadatën e lidhur me ruajtjen. Gjatë punës mbi ARDFS kemi studiuar paralelisht një sërë zgjidhjesh ekzistuese dhe kemi zbuluar se shumë bëjnë sinkronizimin e metadata-s së sistemit të skedarëve me anë të një DB të shpërndara të jashtme, të cilën ne gjithashtu e përdorim për sinkronizimin, por vetëm për konfigurimet, e jo për metadatat e FS (për këtë dhe për sisteme të tjera lidhur do të flasim në artikullin tjetër).
Sinkronizimi i metadata të FS-së duke përdorur një DB të jashtme është një zgjidhje, natyrisht, e funksionueshme, por kështu konsistenca e të dhënave të ruajtura në ARDFS do të varej nga DB e jashtme dhe sjellja e saj (ndërsa ajo, për të mos thënë ndryshe - është një zonjë e kaprici), gjë që sipas mendimit tonë është e keqe. Pse? Nëse metadata e FS-së dëmtohet, edhe të dhënat e vetë FS-së mund t’i themi «mirupafshim», prandaj vendosëm të ndjekim një rrugë më të komplikuar, por më të besueshme.
Ne e zhvilluam në mënyrë të pavarur nën-sistemin e sinkronizimit të metadata për ARDFS, dhe ai jeton plotësisht i pavarur nga nën-sistemat e tjera. Kjo do të thotë, asnjë nën-sistem tjetër nuk mund të dëmtojë të dhënat e ARDFS. Sipas mendimit tonë, kjo është rruga më e besueshme dhe e duhur, nëse është kjo në të vërtetë - koha do ta tregojë. Për më tepër, me këtë qasje shfaqet një përfitim shtesë. ARDFS mund të përdoret pavarësisht nga vAIR, thjesht si një magazinë e shtrirë, gjë që me siguri do ta shfrytëzojmë në produktet tona të ardhshme.
Si rezultat, pasi zhvilluam ARDFS, morëm një sistem të fileve fleksibël dhe të besueshëm, që ofron një zgjedhje se ku mund të kursehen kapacitetet ose t’i jepni gjithçka performancës, ose të bëni magazinimin jashtëzakonisht të besueshëm për një çmim të arsyeshëm, por duke ulur kërkesat për performancë.
Bashkë me një politikë të thjeshtë licencimi dhe një model fleksibël shpërndarjeje (për të mos e humbur bazën, vAIR licencohet sipas nyjave, dhe ëshë i disponueshëm ose si software, ose si PAK) kjo lejon që të precisohet zgjidhja për kërkesa të ndryshme të klientëve dhe më tej ta mirëmbajë lehtësisht këtë balancë.
Kush i nevojitet këtij mrekullie?
Nga njëra anë, mund të thuhet se në treg tashmë ka lojtarë, të cilët kanë zgjidhje serioze në fushën e hiper-konvergjencës, dhe ku ne, në thelb, po hyjmë. Kjo duket se është një pohim i saktë, POR...
Nga ana tjetër, duke dalë "në terren" dhe duke biseduar me klientët, ne dhe partnerët tanë shohim se kjo nuk është aspak e vërtetë. Ka shumë detyra për hiper-konvergjencën, ndonjëherë njerëzit thjesht nuk dinin se këto zgjidhje ekzistonin, ndonjëherë këtë e shihnin si të shtrenjtë, në disa raste kishte teste të dështuara të zgjidhjeve alternative, dhe në disa raste ndalohen blerjet për shkak të sanksioneve. Në përgjithësi, fusha doli të ishte e paprekur, prandaj ne vendosëm të fillojmë një punë të re))).
Kur është HHD më e mirë se GKS?
Gjatë punës me tregun, shpesh na pyesin se kur është më mirë të përdorim skemën klasike me SÇD dhe kur – hiperconvergent? Shumë kompani – prodhues të GKS (veçanërisht ata që nuk kanë SÇD në portofolin e tyre) thonë: "SÇD po kalon, vetëm hiperconvergent!". Ky është një pohim i guximshëm, por nuk e reflekton plotësisht realitetin.
Sinqerisht, tregu i SÇD-ve po kalon në drejtim të hiperconvergentëve dhe zgjidhjeve të ngjashme, por gjithmonë ka "por".
Së pari, qendrat e të dhënave dhe infrastrukturat IT të ndërtuara sipas skemës klasike me SÇD nuk mund të përshtaten aq lehtë, prandaj modernizimi dhe ndërtimi i tillave është ende një trashëgimi për 5-7 vitet e ardhshme.
Së dyti, ato infrastruktura që po ndërtohen aktualisht në masë (duke u referuar RF) po ndërtohen sipas skemës klasike me përdorimin e SÇD dhe jo sepse njerëzit nuk dinë për hiperconvergentët, por sepse tregu i hiperconvergentëve është i ri, zgjidhjet dhe standardet ende nuk janë formuar, specialistët IT ende nuk janë trajnuar, ka pak përvojë dhe duhet të ndërtohen qendrat e të dhënave këtu dhe tani. Dhe kjo prirje do të vazhdojë edhe për 3-5 vite (dhe pastaj një trashëgimi, shiko pika 1).
Së treti, ka një kufizim të pastër teknik në vonesat shtesë të vogla prej 2 milisekondash në shkruarje (pa marrë parasysh cache-in lokal, sigurisht), të cilat janë kosto për ruajtjen e ndarë.
Dhe mos harrojmë përdorimin e serverëve fizikë të mëdhenj, të cilat preferojnë skalimin vertikal të sistemit të diskut.
Ka shumë detyra të nevojshme dhe popullore, ku SÇD sillet më mirë se GKS. Sigurisht, prodhuesit që nuk kanë SÇD në portofolin e tyre nuk do të bien dakord me ne, por ne jemi të gatshëm të argumentohemi. Natyrisht, si zhvillues të të dy produkteve, në një nga publikimet e ardhshme do të bëjmë një krahasim të SÇD dhe GKS, ku do të demonstrojmë qartë se në cilat kushte performojnë më mirë.
Në cilat zgjidhje hiperconvergente do të punojnë më mirë se SÇD?
Duke u bazuar në thëniet më sipër, mund të nxjerrim tri përfundime të qarta:
- Aty ku vonesat shtesë prej 2 milisekondash në shkruarje, të cilat shfaqen gjithmonë në çdo produktiv (kështu që nuk po flasim për sintetiken, sepse në sintetike mund të tregoni edhe nanosekonda), janë të pranueshme, hiperconvergent i përshtatet.
- Aty ku ngarkohet nga servera fizikë të mëdhenj mund të shndërrohet në shumë të vogla virtuale dhe të shpërndahen në node, atje gjithashtu do të pikaset siç duhet hyperconverged.
- Aty ku shkallëzimi horizontal është më prioritare se ai vertical, do të pritet gjithashtu që GKS të përshtatet në mënyrë të shkëlqyer.
Çfarë janë këto zgjidhje?
- Të gjitha shërbimet standarde të infrastrukturës (shërbimi i katalogëve, posta, SED, serverët e skedarëve, sistemi ERP dhe BI të vogla ose të mesme etj.). Ne i quajmë këto "llogaritje të përbashkëta".
- Infrastruktura e ofruesve të shërbimeve në cloud, ku është e nevojshme të zgjerohet horizontalisht shpejt dhe standardizuar dhe të priten lehtësisht një numër i madh makinash virtuale për klientët.
- Infrastruktura e skripteve virtuale (VDI), ku shumë makina virtuale të vogla të përdoruesve aktivizohen dhe notojnë qetësisht brenda një klasteri uniforme.
- Rrjetet filial, ku në çdo filial është e nevojshme të arrihet një infrastrukturë standarde, me qëndrim të besueshëm, por njëkohësisht të përballueshme nga 15-20 makina virtuale.
- Çdo llogaritje e shpërndarë (shërbimet big data, për shembull). Aty ku ngarkesa shkon jo "thellë", por "gjerë".
- Mjedise testuese, ku janë të pranueshme vonesa të vogla, por ka kufizime buxhetore, pasi janë teste.
Në këtë moment, për këto detyra ne kemi krijuar AERODISK vAIR dhe kemi vendosur theksin tek to (deri tani me sukses). Mund të ndodhi që kjo të ndryshojë së shpejti, pasi bota nuk qëndron në vend.
Pra…
Kjo është pjesa e parë e një cikli të madh artikujsh, në artikullin e ardhshëm ne do të flasim për arkitekturën e zgjidhjes dhe komponentët e përdorur.
Do të jemi të lumtur për pyetje, propozime dhe debata konstruktive.
Burimi: habr.com
