

Ju ofroj të njihem me interpretimin e raportit të fundit të vitit 2019 nga Aleksandër Valjalkin "Optimizimet e Go në VictoriaMetrics"
— një DBMS e shpejtë dhe e shkallëzueshme për ruajtjen dhe përpunimin e të dhënave në formën e serive temporale (ncifuli përbëhet nga koha dhe një grup vlerash përkatëse të kësaj kohe, për shembull, të marra përmes një sondazhi periodik të gjendjes së sensorëve ose mbledhjes së metrikeve).
Ja lidhja për videon e këtij raporti —
Do të flas pak për veten time. Unë jam Aleksandër Valjalkin. Këtu është . Pasioni im janë Go dhe optimizimi i performancës. Kam shkruar shumë biblioteka të ndryshme, disa të dobishme e disa jo. Ato fillojnë ose me fast, ose me quick prefiksin.
Aktualisht po punoj në VictoriaMetrics. Çfarë është kjo dhe çfarë bëj atje? Këtë do ta shpjegoj në këtë prezantim.
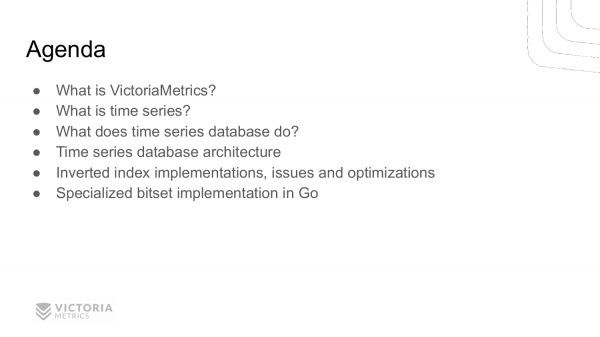
Plani i raportit është si më poshtë:
- Fillimisht do t'ju tregoj se çfarë është VictoriaMetrics.
- Më pas do të shpjegoj se çfarë janë seritë temporale.
- Më pas do të flas për se si funksionon një bazë të dhënash për seritë temporale.
- Më tej do të flas për arkitekturën e bazës së të dhënave: nga çfarë përbëhet ajo.
- Dhe më pas do të kalojmë te optimizimet që janë në VictoriaMetrics. Këtu përfshihet optimizimi i indeksit të invertuar dhe optimizimi për implementimin e bitset në Go.
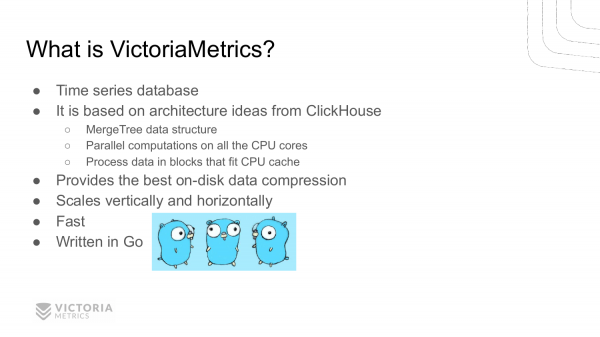
Dikush në audiencë di se çfarë është VictoriaMetrics? Uau, shumë njerëz e dinë këtë. Kjo është një lajm i mirë. Për ata që nuk e dinë – është një bazë të dhënash për seritë temporale. Ajo bazohet në arkitekturën ClickHouse, mbi disa detaje të implementimit të ClickHouse. Për shembull, mbi aspekte si: MergeTree, llogaritje të paralelë në të gjitha bërthamat e disponueshme të procesorit dhe optimizimi i performancës përmes punës mbi blloqet e të dhënave që vendosen në cache-in e procesorit.
VictoriaMetrics ofron kompresimin më të mirë të të dhënave krahasuar me bazat e tjera të të dhënave për seritë temporale.
Ajo shkallëzohet vertikalisht — dmth. mund të shtoni një numër më të madh procesorësh, një sasi më të madhe të memories operativë në një kompjuter. VictoriaMetrics do të jetë në gjendje të shfrytëzojë këto burime të disponueshme dhe do të rrisë performancën lineare.
Po ashtu, VictoriaMetrics shkallëzohet horizontalisht — dmth. mund të shtoni node të tjera në klasterin e VictoriaMetrics, dhe performanca e saj do të rritet pothuajse linearisht.
Siç e keni marrë me mend, VictoriaMetrics është një bazë të dhënash e shpejtë, sepse nuk mund të shkruaj për të tjera. Dhe ajo është e shkruar në Go, prandaj po flas për të në këtë takim.
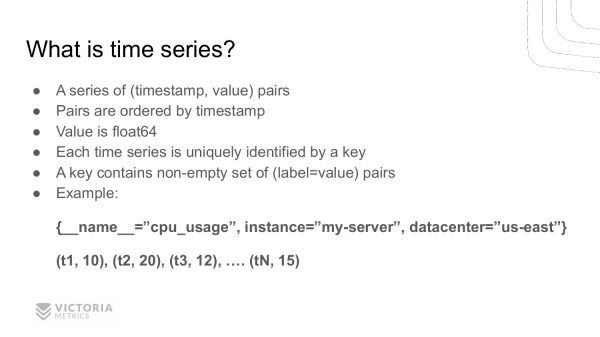
Kush e di se çfarë është një seri e përkohshme? Edhe shumë njerëz e dinë këtë. Një seri e përkohshme është një seri çiftesh (timestamp, vlera), ku këto çifte janë renditur sipas kohës. Vlera përfaqëson një numër fluturues – float64.
Çdo seri e përkohshme identifikohet unikisht me një çelës. Çfarë përbën ky çelës? Ai përbëhet nga një grup i pandashëm çiftësh çelës-vlerë.
Ja një shembull i një serie të përkohshme. Çelësi i kësaj serie është një listë çiftësh: __name__="cpu_usage" – ky është emri i metrikës, instance="my-server" – ky është kompjuteri ku është mbledhur kjo metrikë, datacenter="us-east" – ky është qendra e të dhënave ku ndodhet ky kompjuter.
Kemi marrë emrin e një serie të përkohshme, e cila përbëhet nga tri çiftë çelës-vlerë. Ky çelës i korrespondon një liste çiftësh (timestamp, value). t1, t3, t3, ..., tN – këto janë timestamps, 10, 20, 12, ..., 15 – vlerat përkatëse. Kjo është përdorimi i CPU në momentin e caktuar për këtë seri.
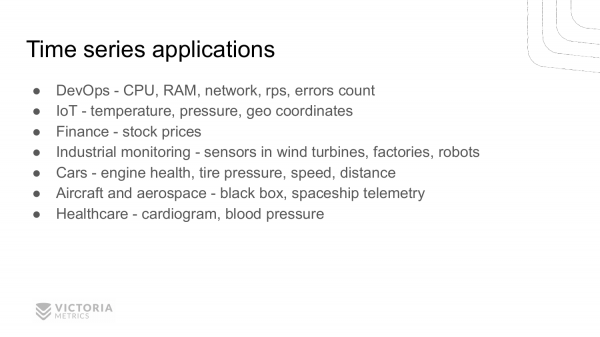
Ku mund të përdoren seritë e përkohshme? A ka ndokush ide?
- Në DevOps, mund të masim ngarkesën e CPU, RAM, rrjetit, rps, numrin e gabimeve etj.
- IoT – mund të masim temperaturën, presionin, koordinatat gjeografike dhe ndonjë gjë tjetër.
- Po ashtu financat – mund të monitorojmë çmimet e aksioneve dhe valutave.
- Përveç kësaj, seritë e përkohshme mund të përdoren për monitorimin e proceseve prodhuese në fabrika. Kemi përdorues që përdorin VictoriaMetrics për monitorimin e turbinave të erës, për robotët.
- Gjithashtu, seritë e përkohshme janë të dobishme për grumbullimin e informacionit nga sensorët e pajisjeve të ndryshme. Për shembull, për motorin; për matjen e presionit në pneun; për matjen e shpejtësisë, distancës; për matjen e konsumit të benzinës etj.
- Po ashtu, seritë e përkohshme mund të përdoren për monitorimin e aeroplanëve. Në çdo aeroplan ka një kuti të zezë që mbledh seritë e përkohshme për parametrat e ndryshëm të shëndetit të aeroplanit. Seritë e përkohshme përdoren gjithashtu në industrinë ajrore.
- Shëndetësia – kjo përfshin presionin e gjakut, pulsin etj.
Ndoshta ka edhe aplikacione të tjera që kam harruar, por shpresoj se kuptuat që seritë e përkohshme përdoren aktivisht në botën moderne. Dhe volumi i përdorimit të tyre po rritet cdo vit.
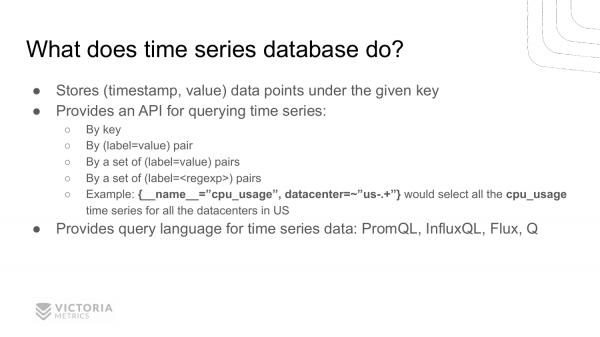
Për çfarë është e nevojshme një bazë të dhënash për seritë e përkohshme? Pse nuk mund të përdorim një bazë të dhënash racionale për ruajtjen e serive të përkohshme?
Sepse në seritë e kohës zakonisht ka një sasi të madhe informacioni, e cila është e vështirë të ruhet dhe të përpunohet në databaza të zakonshme. Prandaj, janë shfaqur databaza speciale për seritë e kohës. Këto baza ruajnë në mënyrë efektive pikat (timestamp, value) me një çelës të caktuar. Ato ofrojnë API për të lexuar të dhënat e ruajtura sipas çelësit, për një çift çelës-vlerë, ose për disa çifte të tilla, ose për regexp. Për shembull, nëse dëshironi të gjeni ngarkesën e procesorit të të gjitha shërbimeve tuaja në qendrën e të dhënave në Amerikë, duhet të përdorni një kërkesë të tillë.
Zakonisht, databazat për seritë e kohës paraqesin gjuhë kërkese të specializuara, sepse SQL për seritë e kohës nuk është shumë i përshtatshëm. Edhe pse ka databaza që mbështesin SQL, ai nuk është shumë i përshtatshëm. Gjuha më të përshtatshme janë , , , . Shpresoj që dikush të ketë dëgjuar për së paku një nga këto gjuhë. Për PromQL, ndoshta shumë kanë dëgjuar. Kjo është gjuha e kërkesës për Prometheus.
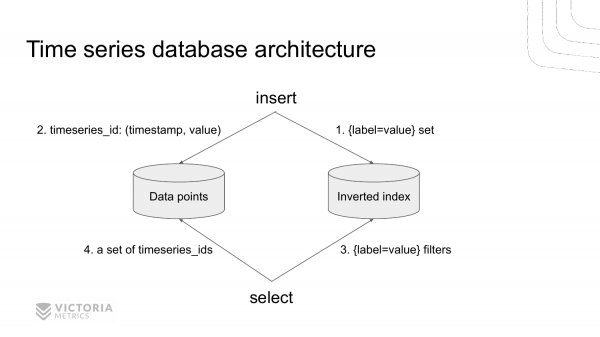
Këtu është si duket arkitektura e një databaze moderne për seritë e kohës, me shembullin e VictoriaMetrics.
Ajo përbëhet nga dy pjesë. Është një depo për indeksin e invertuar dhe një depo për vlerat e serive të kohës. Këto depo janë të ndara.
Kur vjen një shënim i ri në databazë, ne së pari kthehemi në indeksin e invertuar për të gjetur identifikuesin e serisë së kohës sipas një grupi të caktuar label=value për këtë metrikë. Gjejmë këtë identifikues dhe ruajmë vlerën në depo të dhënash.
Kur vjen një kërkesë për tërheqjen e të dhënave nga TSDB, ne së pari shohim në indeksin e invertuar. Nxjerrim të gjitha timeseries_ids shënimet që përputhen me këtë grup label=value. Dhe pastaj nxjerrim të gjitha të dhënat e nevojshme nga depoja e të dhënave, e indeksuar sipas timeseries_ids.
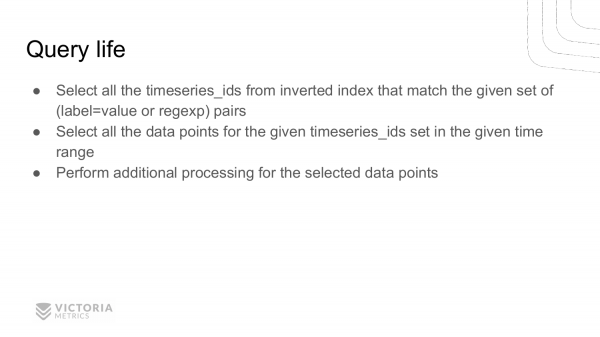
Le të shohim një shembull se si databaza për seritë e kohës përpunon një kërkesë të ardhur select.
- Së pari, ajo nxjerr të gjitha
timeseries_idsnga indeksi i invertuar, që përmbajnë çiftet e caktuaralabel=value, ose përmbushin një shprehje të dhënë të rregullt. - Pastaj ajo nxjerr të gjitha pikat e të dhënave nga depoja e dhënash në një interval të caktuar kohor për të gjeturat
timeseries_ids. - Pas kësaj, databaza kryen disa llogaritje mbi këto pika të të dhënave, sipas kërkesës së përdoruesit. Dhe më pas kthen përgjigjen.
Në këtë prezantim, do t'ju tregoj për pjesën e parë. Kjo është kërkimi timeseries_ids për indeksin e invertuar. Mund të shihni pjesën e dytë dhe të tretë më vonë. , ose mund të prisni derisa të përgatis dokumente të tjera 🙂
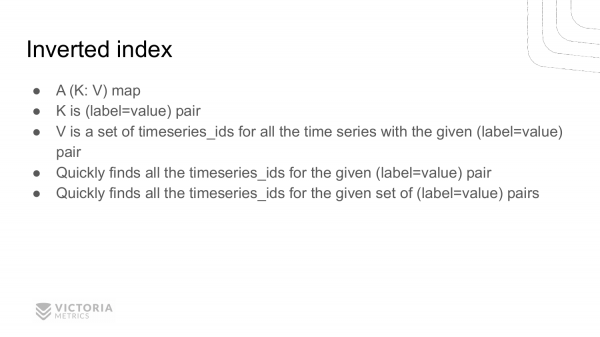
Le të fillojmë me indeksin e invertuar. Disa njerëz mund të mendojnë se është e thjeshtë. Kush e njeh indeksin e invertuar dhe si funksionon? O, tashmë nuk ka shumë njerëz. Le të përpiqemi të kuptojmë se çfarë është.
Në të vërtetë, gjithçka është e thjeshtë. Është një fjalor që lidh çelësin me vlerën. Çfarë është çelësi? Kjo çift label=valueindex label dhe vlera — janë fjalë. Nëse vlerat janë një grup timeseries_ids, i cili përmban çiftin e caktuar label=value.
Indeksi i invertuar lejon të gjenden shpejt të gjitha timeseries_ids, që kanë label=value.
Gjithashtu, ai lejon të gjeni shpejt timeseries_ids seritë e kohës për disa çifte label=value, ose për çifte label=regexp. Si ndodh kjo? Përmes gjetjes së prerjes së një grumbulli timeseries_ids për çdo çift label=value.
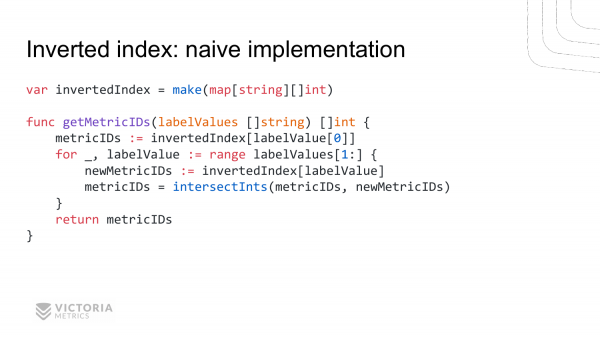
Le të shqyrtojmë realizimet e ndryshme të indeksit të invertuar. Le të fillojmë me realizimin më të thjeshtë naiv. Ai duket kështu.
Funksioni getMetricIDs merr një listë fjalish. Çdo fjalë përmban label=value. Kjo funksion kthen një listë metricIDs.
Si funksionon? Këtu kemi një variabël globale, e quajtur invertedIndex. Ky është një fjalor i zakonshëm (map), që lidh fjalinë me slice int-i. Fjalia përmban label=value.
Realizimi i funksionit: marrim metricIDs për të parën label=value, pastaj kalojmë në të tjerat label=value, marrim metricIDs për to. Dhe thërrasim funksionin intersectInts, për të cilin do të flitet më vonë. Dhe ky funksion kthen prerjen e këtyre listave.
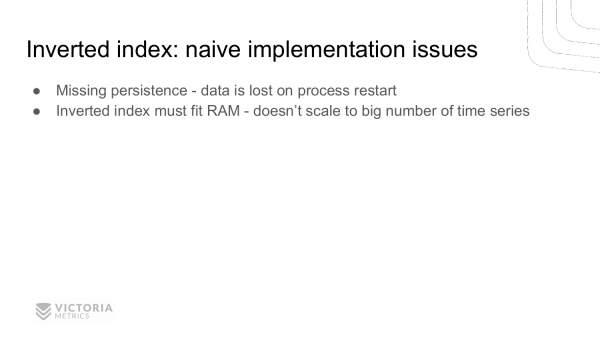
Siç e shihni, realizimi i indeksit të invertuar nuk është shumë i komplikuar. Por kjo është një realizim naiv. Cilat janë disavantazhet e saj? Disavantazhi kryesor i realizimit naiv është se indeksi i tillë i invertuar ruhet në memorien operative. Pas rinisjes së aplikacionit, ne humbasim këtë indeks. Nuk ka ruajtje të këtij indeksi në disk. Për një bazë të dhënash, një indeks i tillë i invertuar nuk është i përshtatshëm.
Disavantazhi i dytë gjithashtu lidhet me memorien. Indeksi i invertuar duhet të vendoset në memorien operative. Nëse ai kalon madhësinë e memories operative, është e qartë se do të marrim – gabim 'out of memory'. Dhe programi nuk do të funksionojë.
Kjo problem mund të zgjidhet përmes zgjidhjeve të gatshme si , ose .
Në përmbledhje, na nevojitet një bazë të dhënash që lejon të bëjmë shpejt tre operacione.
- Operacioni i parë është shënimi
çelës-vlerënë këtë bazë. Ajo e bën këtë shumë shpejt, kuçelës-vlerëjanë vargje të rastësishme. - Operacioni i dytë është kërkimi i shpejtë të vlerës sipas çelësit të caktuar.
- Dhe operacioni i tretë është kërkimi i shpejtë të të gjitha vlerave sipas prefixit të caktuar.
LevelDB dhe RocksDB – këto baza janë zhvilluar në Google dhe Facebook. Në fillim doli LevelDB. Pastaj ekipi nga Facebook mori LevelDB dhe filloi ta përmirësojë, duke bërë RocksDB. Tani, në RocksDB brenda Facebook-ut punojnë pothuajse të gjitha databazat e brendshme, përfshirë se ata kanë transferuar MySQL në RocksDB. Ata e quajtën .
Indeksi i invertuar mund të realizohet me ndihmën e LevelDB. Si mund ta bëjmë këtë? Ruajmë si çelës label=value. Ndërsa si vlerë – identifikuesin e serisë kohore, ku ndodhet çifti label=value.
Nëse kemi shumë seri kohore me këtë çift label=value, do të ketë shumë rreshta në këtë bazë të dhënash me çelësa të njëjtë dhe me vlera të ndryshme. timeseries_idsPër të marrë listën e të gjitha timeseries_ids, që fillojnë me këtë label=prefix, ne bëjmë një skanimin e gamës, për të cilën kjo bazë është optimizuar. Kjo do të thotë, ne zgjedhim të gjithë rreshtat, që fillojnë me label=prefix dhe marrim vlerat e nevojshme. timeseries_ids.
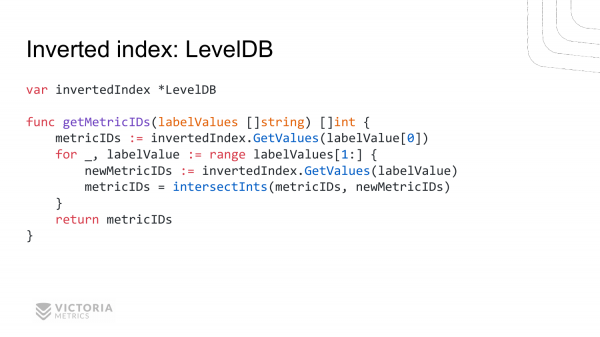
Ja një implementim i përafërt, si do të dukej në Go. Ne kemi një indeks të invertuar. Kjo është LevelDB.
Funksioni është i njëjtë, si për implementimin naive. Ajo pothuajse përsërit rresht për rresht implementimin naive. Momentin e vetëm është që në vend të qasjes në map ne qasemi në indeksin e invertuar. Ne nxjerrim të gjitha vlerat për çiftin e parë. label=valuePastaj kalojmë përmes të gjithë çifteve të mbetura label=value dhe nxjerrim grupe të përkatshme të metricIDs për to. Më pas gjejmë kryqëzimin.
Duket gjithçka mirë, por në këtë zgjidhje ka disavantazhe. VictoriaMetrics fillimisht implementoi indeksin e invertuar mbi bazën e LevelDB. Por në fund, u detyrua të heq dorë nga ai.
Pse? Sepse LevelDB është më i ngadaltë se implementimi naive. Në implementimin naive sipas çelësit të caktuar ne në menjë nxjerrim të gjithë slice-in metricIDs. Kjo është një operacion shumë i shpejtë – të gjithë slice-in është gati për t'u përdorur.
Në LevelDB, për çdo thirrje të funksionit GetValues duhet të kalojmë përmes të gjithë rreshtave, që fillojnë me label=value. Dhe për çdo rresht të nxjerrim vlerën timeseries_ids. Nga këta timeseries_ids të mbledhim slice-in e këtyre timeseries_ids. Èshte e qartë se kjo është shumë më e ngadaltë se sa thjesht të qasemi në një map të zakonshëm sipas çelësit.
Disavantazhi i dytë është se LevelDB është shkruar në C. Thirrja e funksioneve C nga Go nuk është shumë e shpejtë. Merr qindra nanosekonda. Kjo nuk është shumë e shpejtë, sepse krahasuar me thirrjen e zakonshme të funksionit të shkruar në Go, e cila merr 1-5 nanosekonda, diferenca në performancë është disa herë më e lartë. Për VictoriaMetrics, ky ishte një disavantazh fatal 🙂
Prandaj, unë shkrova një implementim të vetin të indeksit të kthyer. Dhe e quajta .
Mergeset është i bazuar në strukturën e të dhënave MergeTree. Kjo strukturë e të dhënave është huazuar nga ClickHouse. Qartë, mergeset duhet të jetë optimizuar për kërkimin e shpejtë timeseries_ids për një çelës të caktuar. Mergeset është shkruar plotësisht në Go. Ju mund të shihni . Implementimi i mergeset ndodhet në dosjen . Ju mund të provoni të kuptoni se çfarë ndodh atje.
API i mergeset është shumë i ngjashëm me LevelDB dhe RocksDB. Pra, ai lejon ruajtjen e shpejtë të regjistrimeve të reja dhe përzgjedhjen e shpejtë të regjistrimeve sipas një prefiksi të caktuar.
Për disavantazhet e mergeset do të flasim më vonë. Tani, do të diskutojmë se cilat probleme u shfaqën me VictoriaMetrics në prodhim gjatë implementimit të indeksit të kthyer.
Pse ndodhi kjo?
Arsyeja e parë është shkalla e lartë e ndryshimit. Në përkthim në shqip - kjo është ndërrimi i shpeshtë i serive të kohës. Kjo ndodh kur një seri e kohës përfundon dhe nis një seri e re, ose fillojnë shumë seri të reja të kohës. Dhe kjo ndodh shpesh.
Arsyeja e dytë është numri i madh i serive të kohës. Fillimisht, kur monitorimi po fitonte popullaritet, numri i serive të kohës ishte i vogël. Për shembull, për çdo computer duhet të monitorohet ngarkesa e procesorit, memories, rrjetit dhe diskut. 4 seri të kohës për çdo computer. Keni, për shembull, 100 kompjuterë dhe 400 seri të kohës. Kjo është shumë pak.
Me kalimin e kohës, njerëzit e shpikën se mund të masin informacione më të detajuara. Për shembull, të maten ngarkesat e çdo bërthame të veçantë të procesorit, jo thjesht të gjithë procesorit. Nëse keni 40 bërthama procesori, atje keni gjithashtu 40 herë më shumë seri të kohës për të matur ngarkesën e procesorit.
Por megjithatë, kjo nuk është gjithçka. Çdo bërthamë procesori mund të ketë disa gjendje si idle, kur është në pritje. Gjithashtu ka punë në user space, punë në kernel space dhe gjendje të tjera. Çdo gjendje e tillë gjithashtu mund të matet si një seri e veçantë e kohës. Kjo rrit në mënyrë të konsiderueshme numrin e serive në 7-8 herë.
Nga një metrikë kemi marrë 40 x 8 = 320 metrika vetëm për një kompjuter. Duke e shumëfishuar me 100, marim 32,000 në vend të 400.
Pastaj u shfaq Kubernetes. Dhe akoma përkeqësoi situatën, sepse në Kubernetes mund të hostohen shumë shërbime të ndryshme. Çdo shërbim në Kubernetes përbëhet nga shumë pod, dhe të gjitha këto duhet të monitorohen. Përveç kësaj, kemi një deployment të vazhdueshëm të versioneve të reja të shërbimeve tuaja. Për çdo version të ri, duhet të krijohen seria të reja të kohës. Si përfundim, numri i serive të kohës rritet në mënyrë eksponenciale dhe ne përballemi me problemin e numrit të madh të serive të kohës, që quhet high-cardinality. VictoriaMetrics përballet me të në mënyrë efektive krahasuar me bazat e tjera të të dhënave për seritë e kohës.
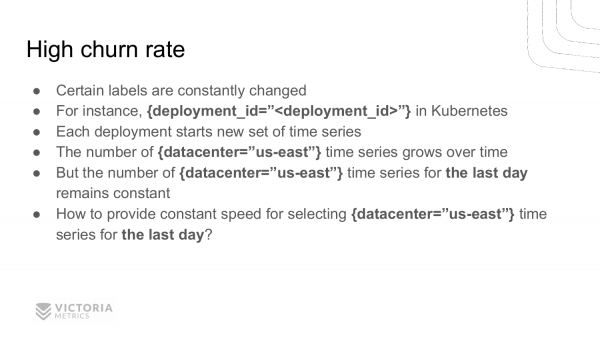
Le të shqyrtojmë më hollësisht high churn rate. Pse ekziston high churn rate në prodhim? Sepse disa vlera të etiketave dhe etiketave ndryshojnë vazhdimisht.
Për shembull, le të marrim Kubernetes, ku ekziston koncepti deployment, dmth. kur ndodh një version i ri i aplikacionit tuaj. Zhvilluesit e Kubernetes për një arsye të panjohur vendosën të shtojnë id e deployment në etiketë.
Çfarë ndodhi si rezultat? Të gjithë seritë e vjetra të kohës ndërpriten me çdo deployment të ri, dhe në vend të tyre fillojnë seritë e reja të kohës me vlerën e re të etiketës deployment_id. Ka mundësi që të ketë qindra mijëra dhe madje miliona të tilla serish.
Një karakteristikë e rëndësishme e gjithë kësaj është se numri total i serive të kohës rritet, por numri i serive të kohës që janë aktualisht aktive, të cilat marrin të dhëna, mbetet konstant. Ky gjendje quhet – high churn rate.
Problemi kryesor i high churn rate është të sigurojë një shpejtësi konstante kërkimi për të gjitha seritë e kohës në një grup të caktuar etiketash për një interval të caktuar kohor. Zakonisht, ky është një interval kohor për orët e fundit ose për ditët e fundit.
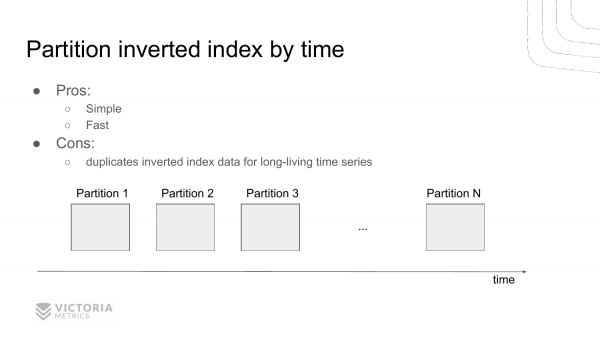
Si e zgjidhim këtë problem? Këtu është një variant i parë. Kjo është ndarja e indeksit të përmbysur në pjesë të pavarura sipas kohës. Do thotë, kalon një interval kohe, përfundojmë punën me indeksin e përmbysur aktual. Dhe krijojmë një indeks të ri të përmbysur. Kalon një tjetër interval kohe, krijojmë një tjetër dhe një tjetër.
Dhe gjatë zgjedhjes nga këto indekse të përmbysura ne gjejmë një grup indekse të përmbysura që bien brenda intervalit të caktuar. Dhe, përkatësisht, zgjedhim aty id-të e serive temporale.
Kjo lejon kursimin e burimeve, sepse nuk na nevojitet të shqyrtojmë pjesët që nuk bien brenda intervalit të caktuar. Do thotë, zakonisht, nëse po zgjedhim të dhëna për orën e fundit, atëherë për intervalet e mëparshme të kohës ne anashkalojmë kërkesat.
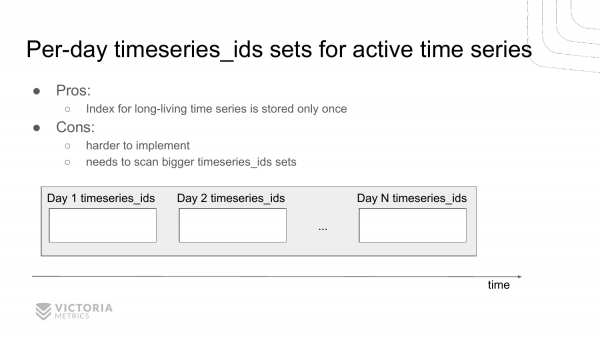
Ka edhe një variant tjetër për zgjidhjen e këtij problemi. Kjo është ruajtja e një liste të veçantë të id-ve të serive temporale për çdo ditë, të cilat u gjendën gjatë atij ditë.
Avantazhi i kësaj zgjidhjeje në krahasim me zgjidhjen e mëparshme është se ne nuk e ripërsërisim informacionin mbi seritë temporale që nuk zhduken me kalimin e kohës. Ato janë gjithmonë aty dhe nuk ndryshojnë.
Disavantazhi është se një zgjidhje e tillë është më e komplikuar në realizim dhe më e vështirë për debug. Dhe VictoriaMetrics e zgjodhi këtë zgjidhje. Kjo ndodhi historikisht. Kjo zgjidhje gjithashtu tregon rezultate të kënaqshme, në krahasim me të parën. Sepse kjo zgjidhje nuk u realizua për shkak se duhej të ripërsëritnim të dhënat në çdo pjesë për seritë temporale që nuk ndryshojnë, domethënë ato që nuk zhduken me kalimin e kohës. VictoriaMetrics është optimizuar fillimisht për konsumimin e hapësirës në disk, dhe realizimi i mëparshëm e përkeqësoi këtë konsum. Ndërsa kjo realizim është më i përshtatshëm për minimizimin e konsumit të hapësirës në disk, prandaj u zgjodh.
Duhej të përballem me të. Lufta qëndronte në atë se në këtë realizim duhet të përzgjedhësh gjithmonë një numër shumë më të madh timeseries_ids për të dhënat, sesa kur indeksi i përmbysur është i ndarë sipas kohës.
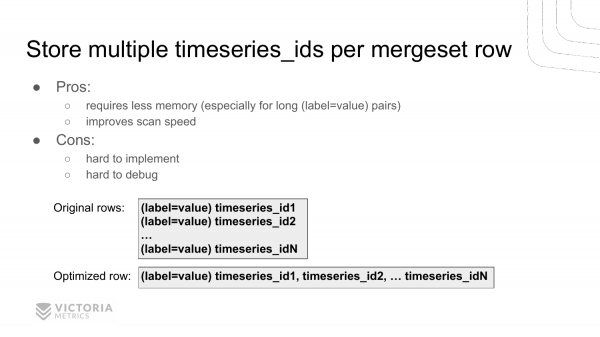
Si e zgjidhëm këtë problem? E zgjodhëm në një mënyrë origjinale – duke ruajtur disa identifikues të serive temporale në secilën të dhënë të indeksit të përmbysur në vend të një identifikuesi të vetëm. Do thotë, ne kemi një çelës label=value, që ndodh në çdo rresht temporal. Dhe tani ne ruajmë disa timeseries_ids në një regjistër.
Ja një shembull. Më parë kishim N regjistra, ndërsa tani kemi një regjistër, me një prefiks të njëjtë si të tjerët. Regjistri i mëparshëm kishte një vlerë që përmbante të gjitha id-të e rreshtave temporale.
Kjo ka lejuar rritjen e shpejtësisë së skanimit të këtij indeksi të përmbysur deri në 10 herë. Dhe ka lejuar reduktimin e konsumit të memories për cache, sepse tani ne ruajmë vargun label=value vetëm një herë në cache së bashku me N herë. Dhe ky varg mund të jetë i madh, nëse keni rreshta të gjatë në etiketa dhe labels që i pëlqen t'i fusë atje Kubernetes.
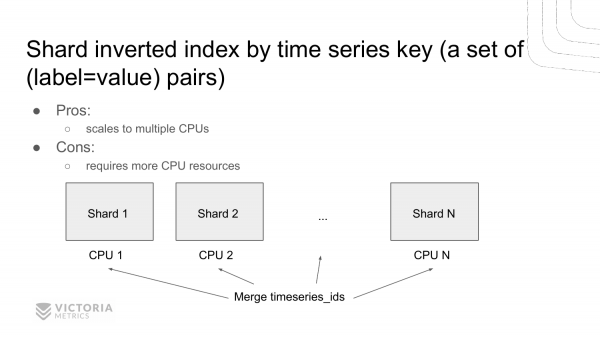
Një variant tjetër përshpejtimi i kërkimit në indeksin e përmbysur është sharding. Krijimi i indekseve të shumta të përmbysura në vend të një dhe sharding të të dhënave midis tyre sipas një çelësi. Ky është një grup key=value çiftash. Pra, ne kemi disa indekse të pavarura të përmbysura, të cilat mund t’i marrim në pyetje paralelisht në disa procesorë. Realizimet e mëparshme lejonin punën vetëm në modin një-procesor, dmth. skanimin e të dhënave vetëm në një bërthamë. Ç solution i jep mundësinë për të skanuar të dhënat menjëherë në disa bërthama, siç i pëlqen të bëjë ClickHouse. Këtë planifikojmë ta implementojmë.
Dhe tani le të kthehemi te dhitë tona – tek funksioni i ndërprerjes timeseries_ids. Le të shohim se cilat mund të jenë realizimet. Ky funksion lejon të gjejmë timeseries_ids për një grup të caktuar label=value.
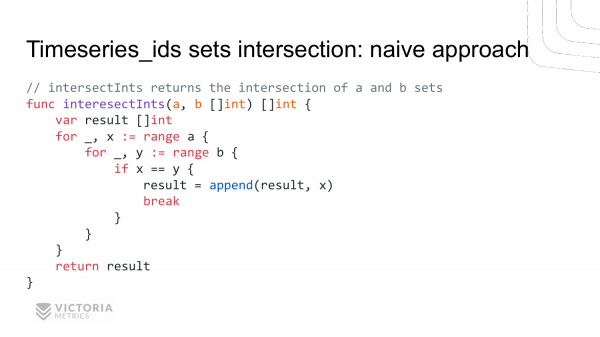
Varianti i parë – është realizimi ingenuoz. Dy cikle të ngjitur. Ja ne marrim në input të funksionit intersectInts dy slices — a dhe b. Në daljen e saj ajo duhet të na kthejë ndërprerjen e këtyre slices.
Realizimi ingenuoz duket kështu. Ne kalojmë përmes të gjitha vlerave nga slice a, brenda këtij cikli kalojmë përmes të gjitha vlerave të slice b. Dhe i krahasojmë ato. Nëse ata përputhen, atëherë kemi gjetur ndërprerjen. Dhe e ruajmë në rezultati.
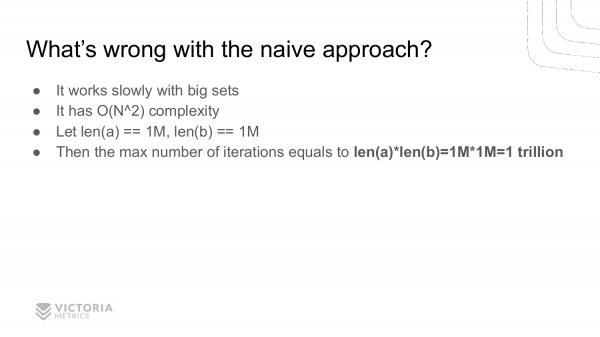
Cilat janë disavantazhet? Kompleksiteti katror – është disavantazhi kryesor i saj. Për shembull, nëse keni dimensionet e slice a dhe b me një milion, atëherë ky funksion kurrë nuk do t'ju kthejë një përgjigje. Sepse i nevojitet një trilion iteracionesh, që është shumë edhe për kompjuterët modernë.
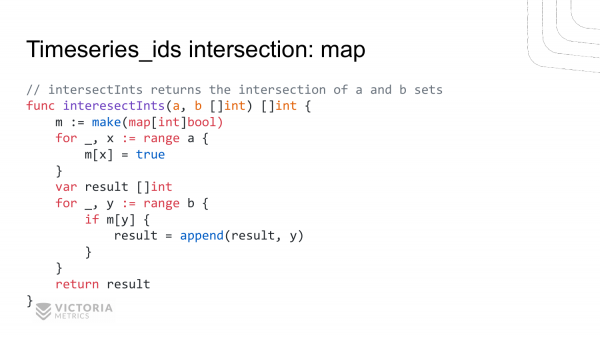
Realizimi i dytë bazohet në hartë. Ne krijojmë një hartë. Vendosim në këtë hartë të gjitha vlerat nga slice a. Pastaj kalojmë me një cikël të veçantë në slice b. Dhe kontrollojmë – a ekziston kjo vlerë nga slice b në map. Nëse është atje, atëherë e shtojmë në rezultat.
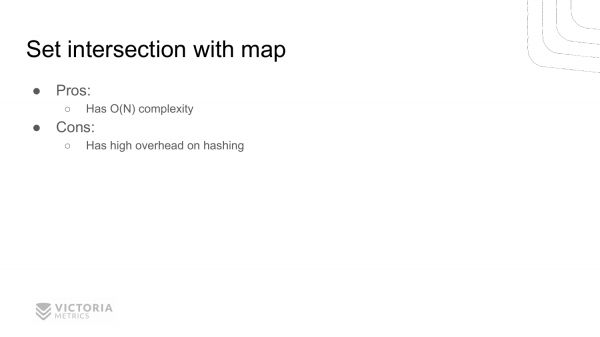
Cilat janë përparësitë? Përparësia është se këtu ka vetëm kompleksitet lineare. Kjo do të thotë se funksioni do të ekzekutohet shumë më shpejt për madhësi të mëdha slices. Për një slice me madhësi një milion, ky funksion do të ekzekutohet në 2 milion iteracione, ndryshe nga një trilion iteracione, si në funksionin e mëparshëm.
Ndërsa një disavantazh është se ky funksion kërkon më shumë memorie për të krijuar këtë map.
Disavantazhi i dytë – është overhead i madh në hashim. Ky disavantazh nuk është shumë i dukshëm. Dhe për ne nuk ishte as shumë i dukshëm, prandaj në fillim, në VictoriaMetrics, realizimi i bashkëngjitjes ishte përmes map. Por më pas profilizimi tregoi se koha kryesore e procesorit shpenzohej për të shkruar në map dhe për të kontrolluar nëse vlera është në këtë map.
Pse në këto vende shpenzohet kohë procesori? Sepse në këto rreshta Go kryen operacionin e hashimit. Kjo do të thotë se ai llogarit hash-in nga çelësi, për t'u referuar më pas në indeksin e caktuar në HashMap. Operacioni i llogaritjes së hash-it kryhet në dhjetra nanosekonda. Kjo është e ngadalshme për VictoriaMetrics.
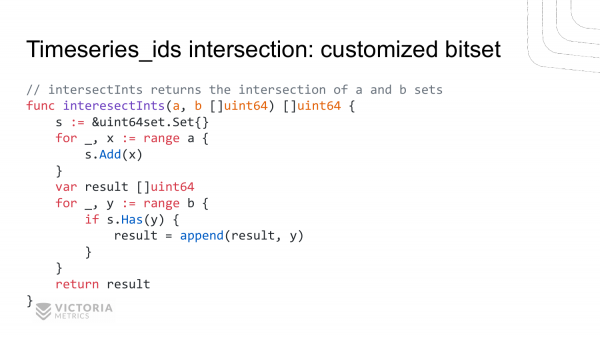
Unë vendosa të implementoj bitset, optimizuar veçanërisht për këtë rast. Ja si duket tani bashkëngjitja e dy slices. Këtu krijojmë një bitset. Shtojmë elementet nga slice i parë. Më pas kontrollojmë praninë e këtyre elementeve në slice-in e dytë. Dhe i shtojmë në rezultat. Kjo do të thotë se pothuajse nuk ndryshon nga shembulli i mëparshëm. E vetmja gjë që ne këtu zëvendësuam duhet të jetë referimi në map me funksione të personalizuara. add dhe ka.
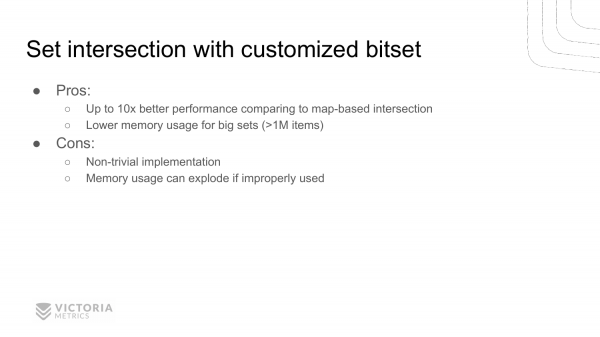
Nga një shikim të parë duket se kjo duhet të funksionojë më ngadalë, nëse më parë ishte përdorur një map standard, dhe tani thirren ndonjë funksion, por profilizimi tregon se kjo gjë punon 10 herë më shpejt se map standard për rastin me VictoriaMetrics.
Përveç kësaj, ajo përdor shumë më pak memorie në krahasim me realizimin në map. Sepse ne ruajmë këtu bitet në vend të vlerave tetëbyte.
Disavantazhi i kësaj realizimi është se nuk është aq e dukshme, jo triviale.
Një tjetër disavantazh që shumë njerëz mund të mos e vënë re është se kjo zbatim mund të funksionojë keq në disa raste. Domethënë, është optimizuar për një rast të caktuar, për rastin e përputhjes së identiteteve të serive temporale të VictoriaMetrics. Kjo nuk do të thotë se ajo do të jetë e përshtatshme për të gjitha rastet. Nëse përdoret gabimisht, do të kemi jo një përmirësim të performancës, por një gabim out of memory dhe ngadalësim të performancës.
Le të shqyrtojmë zbatimin e kësaj strukture. Nëse doni ta shihni, është në burimet e VictoriaMetrics, në dosjen . Ajo është optimizuar pikërisht për rastin e VictoriaMetrics, ku timeseries_id është një vlerë 64-bit, ku 32 bitët e parë janë kryesisht konstantë dhe ndryshojnë vetëm 32 bitët e fundit.
Kjo strukturë të dhënash nuk ruhet në disk, ajo funksionon vetëm në memorie.
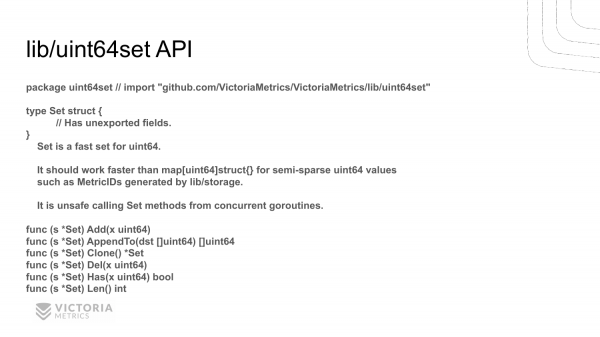
Këtu është API-i i saj. Ai nuk është shumë i komplikuar. API-u është adaptuar pikërisht për shembullin specifik të përdorimit të VictoriaMetrics. Domethënë, këtu nuk ka funksione të tepërta. Këtu janë funksionet që përdoren qartë nga VictoriaMetrics.
Ka funksione add, që shton vlera të reja. Ka një funksion ka, që kontrollon vlerat e reja. Dhe ka një funksion del, që heq vlera. Ka një funksion ndihmës len, që kthen madhësinë e grupit. Funksioni clone klonon grupin. Dhe funksioni appendto e ndryshon këtë grup në slice timeseries_ids.
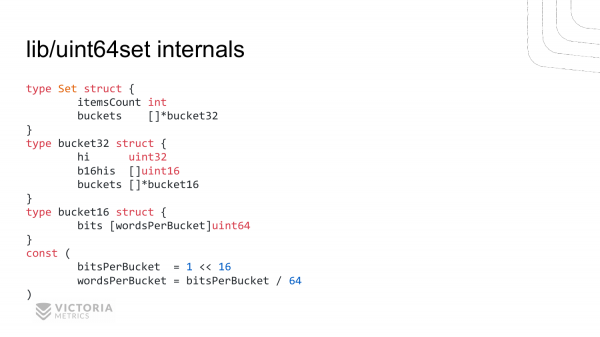
Ja si duket implementimi i kësaj strukture të dhënash. Në set ka dy elemente:
ItemsCount– ky është një fushë ndihmëse, për të kthyer shpejt numrin e elementeve në set. Mund të ishte hequr ky fushë ndihmëse, por duhej ta shtonim këtu, sepse VictoriaMetrics shpesh pyet në algoritmet e saj për gjatësi bitset.Fusha e dytë është
buckets. Ky është një slice i strukturësbucket32. Në çdo strukturë ruhethifusha. Këto janë 32 bitët e sipërm. Dhe dy slice -b16hisdhebucketsngabucket16struktura.
Këtu ruhen 16 bitët e sipërm të pjesës së dytë të strukturës 64-bit. Dhe këtu ruhen bitsets për 16 bitët më të rinj të çdo byte.
Bucket64 është i përbërë nga një array uint64. Gjatesia llogaritet duke përdorur këto konstanta. Në një bucket16 maksimumi mund të ruajë 2^16=65536 bït. Nëse e ndajmë atë me 8, kjo është 8 kilobajt. Nëse e ndajmë përsëri me 8, kjo është 1000 uint64 në vlerë. Domethënë, Bucket16 është një strukturë 8-kilobajtëshe.
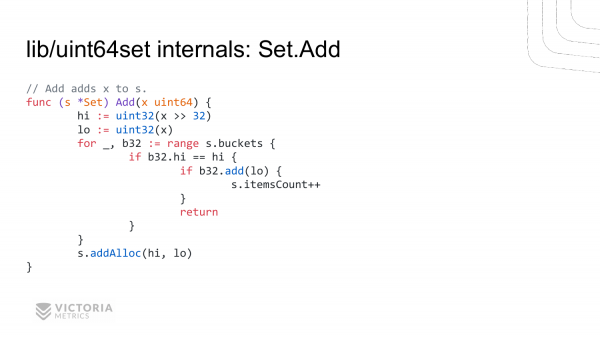
Le të shohim se si është implementuar një nga metodat e kësaj strukture për shtimin e një vlerë të re.
Të gjitha fillon me uint64 vlerave. Llogarisim 32 bitët e sipërm, llogarisim 32 bitët e poshtëm. Kalojmë përmes të gjithë buckets. Krahasojmë 32 bitët e sipërm në secilën bucket me vlerën që po shtohet. Dhe nëse ato përputhen, atëherë thërrasim funksionin add në strukturën b32 buckets. Dhe shtojmë aty 32 bitët e poshtëm. Dhe nëse kjo ktheu true, atëherë do të thotë se e kemi shtuar atë vlerë aty dhe nuk e kishim një të tillë. Nëse ajo kthen false, atëherë një vlerë e tillë tashmë ekzistonte. Më pas rrisim numrin e elementëve në strukturë.
Nëse nuk gjetëm të nevojshmen bucket me vlerën hi-përkatëse, atëherë thërrasim funksionin addAlloc, i cili alokon një të ri bucket, duke e shtuar atë në strukturën bucket.
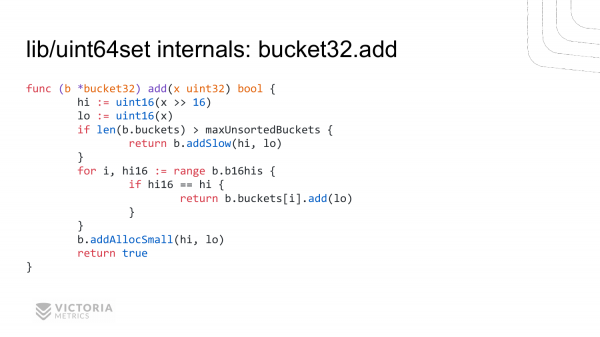
Kjo është implementimi i funksionit b32.add. Ajo është e ngjashme me implementimin e mëparshëm. Ne llogarisim 16 bitët e vjetër, 16 bitët e rinj.
Më pas kalojmë përmes të gjithë 16 bitëve të sipërm. Gjejmë përputhje. Dhe në rast përputhjeje thërrasim metodën add, të cilën do ta shqyrtojmë në faqen e ardhshme për bucket16.
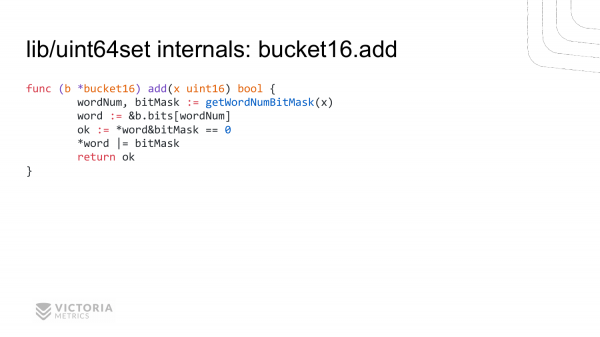
Dhe këtu është niveli më i ulët, i cili duhet të jetë maksimalisht i optimizuar. Ne llogarisim për uint64 id vlerën në slice bit, si dhe bitmask. Kjo është një maskë për këtë vlerë 64-bit, me të cilën mund të kontrollojmë pranishmërinë e këtij biti, ose ta vendosim atë. Ne kontrollojmë nëse ky bit është i vendosur dhe e vendosim, dhe kthejmë pranishmërinë. Kjo është implementimi ynë, i cili ka lejuar të shpejtojë operacionin e ndërprerjes së ids të serive kohore 10 herë krahasuar me maps standarde.
Në VictoriaMetrics përveç kësaj optimizimi ka shumë optimizime të tjera. Shumica e këtyre optimizimeve janë shtuar jo thjesht kështu, por pas profilizimit të kodit në produksion.
Ky është rregulli kryesor i optimizimit – mos shtoni optimizimin, duke supozuar se këtu do të ketë një pikë të ngushtë, sepse mund të rezultojë se nuk do të ketë një pikë të ngushtë atje. Optimizimi zakonisht përkeqëson cilësinë e kodit. Prandaj, është e nevojshme të optimizohet vetëm pas profilizimit dhe preferohet në produksion, në mënyrë që të jenë të dhëna reale. Atëherë, ata që janë të interesuar, mund të shikojnë burimet e VictoriaMetrics dhe të studiojnë optimizimet e tjera që ka.
Kam një pyetje në lidhje me bitset. Ka shumë ngjashmëri me implementimin e C++ vector bool, bitset i optimizuar. E keni marrë implementimin nga atje?
Jo, nuk është prej aty. Kur po realizoja këtë bitset, unë u orientova në njohuritë e strukturës së këtyre ids timeseries që përdoren në VictoriaMetrics. Strukturën e tyre është e tillë që 32 bitët e sipërm janë kryesisht të qëndrueshëm. 32 bitët e poshtëm mund të ndryshojnë. Sa më poshtë të jetë bita, aq më shpesh mund të ndodhi ndryshimi. Prandaj, kjo realizim është pikërisht optimizuar për këtë strukturë të dhënash. Realizimi në C++, aq sa di unë, është optimizuar për rastin e përgjithshëm. Nëse bëhet optimizimi për rastin e përgjithshëm, atëherë kjo do të thotë se nuk do të jetë më optimal për rastin specifik.
Ju rekomandoj gjithashtu të shikoni ligjëratën e Aleksej Milovidit. Ai rreth një muaj më parë fliste për optimizimet në ClickHouse për specializime specifike. Ai vërtet tregon se në rastin e përgjithshëm implementimi në C++ ose ndonjë implementim tjetër janë të punuar për të funksionuar mirë në mesatare. Ajo mund të funksionojë më keq se një implementim i specializuar për njohuri specifike, siç jemi ne, kur e dimë se 32 bitët e sipërm janë kryesisht të qëndrueshëm.
Kam një pyetje tjetër. Cila është dallimi i theksuar nga InfluxDB?
Janë shumë dallime të theksuara. Nëse flasim për performancën dhe konsumimin e memories, InfluxDB në testime tregon dhjetë herë më shumë konsumim të memories për seritë temporale me kardinalitet të lartë kur keni shumë, për shembull, miliona. Për shembull, VictoriaMetrics konsumon 1 GB për një milion seri aktive, ndërsa InfluxDB në këtë rast konsumon 10 Gb. Dhe kjo është një ndryshim i madh.
Dallimi i dytë i theksuar është se në InfluxDB ka gjuhë të çuditshme pyetjesh – Flux dhe InfluxQL. Ato nuk janë shumë të përshtatshme për punë me seritë temporale në krahasim me , që mbështetet në VictoriaMetrics. PromQL është gjuha e pyetjeve nga Prometheus.
Dhe një dallim tjetër është se InfluxDB ka një model të çuditshëm të të dhënave, ku në çdo rresht mund të mbahen disa fushë me grupe të ndryshme tag-esh. Këto rreshta ndahen edhe në tabela të ndryshme. Këto komplikime shtesë e bëjnë më të vështirë punën e mëvonshme me këtë bazë. Është e vështirë për t'u mbajtur dhe kuptuar.
Në VictoriaMetrics gjithçka është shumë më e thjeshtë. Atje çdo seri temporale përfaqëson një çelës-vlerë. Vlera është një set pikash – (timestamp, value), ndërsa çelësi është një set label=value. Nuk ka ndarje mes fushave dhe matjeve. Kjo ju lejon të zgjidhni të dhëna të çfarëdo lloji dhe më pas t'i kombinoni, të shtoni, të zbritni, të shumëzoni, të ndani, ndryshe nga InfluxDB, ku llogaritjet midis rreshtave të ndryshëm nuk janë ende realizuar, sa kam dijeni. Nëse janë realizuar, ato janë të komplikuara, duhet të shkruani shumë kode.
Kam një pyetje sqaruese. A e kuptova saktë që kishte ndonjë problem, për të cilin flisnit, se indeksi i invers nuk i ndalon në memorie, prandaj aty bëhet particionimi?
Fillimisht, tregova një implementim naive të indeksit të invers në standardin Go map. Një implementim i tillë nuk është i përshtatshëm për bazat e të dhënave, sepse ky indeks i invers nuk ruhet në disk, dhe një bazë të dhënash duhet të ruajë në disk, për të siguruar që këto të dhëna të mbeten të aksesueshme pas rinisjes. Në këtë implementim, pasi aplikacioni riniset, indeksi i invers do të humbasë. Dhe do të humbni qasjen në të gjitha të dhënat, sepse nuk do të jeni në gjendje t'i gjeni ato.
Përshëndetje! Faleminderit për prezantimin! Unë quhem Pavel. Jam nga kompania Wildberries. Kam disa pyetje për ju. Pyetja e parë. Si mendoni, nëse do të kishit zgjedhur një parim tjetër në ndërtimin e arkitekturës së aplikacionit tuaj dhe do të ishit partiçionuar të dhënat sipas kohës, ndoshta do të kishit mundur të realizonit ndërhapësira të të dhënave gjatë kërkimit, duke u bazuar vetëm në faktin se në një partiçion ndodhen të dhëna për një periudhë kohore, dmth. për një interval kohor dhe nuk do t'ju duhej të shqetësoheshit për faktin se keni pjesë të shpërndara në mënyrë të ndryshme? Pyetja numër 2 - nëse realizoni një algoritëm të tillë me bitset dhe gjithçka tjetër, ndoshta keni provuar të përdorni instruksionet e procesorit? Mund të keni provuar optimizime të tilla?
Për pyetjen e dytë do t'ju përgjigjem menjëherë. Ne nuk kemi arritur ende në këtë. Por nëse do të jetë e nevojshme, do të arrijmë. A ishte e para, çfarë ishte pyetja?
Diskutuat dy skenarë. Dhe thatë se zgjodhët të dytin me një implementim më të komplikuar. Dhe nuk e përzgjodhët të parin, ku të dhënat janë partiçionuar sipas kohës.
Po, në rastin e parë, volumi total i indeksit do të ishte më i madh, sepse në çdo parti ne do të duhej të ruanim kopje të dhënash për ato seritë kohore që vazhdojnë përmes këtyre të gjitha partive. Dhe nëse ka një shkallë të ulët të ndryshimit në seritë kohore, pra, vazhdimisht përdoren të njëjtat seri, atëherë në rastin e parë do të humbnim ndjeshëm më shumë hapësirë diskore krahasuar me rastin e dytë.
Po, ndarja sipas kohës është një opsion i mirë. Kjo e përdor Prometheus. Por në Prometheus ka një mangësi tjetër. Kur bashkohen këto copa të dhënash, kërkohet të ruajë në memorje metainformacione për të gjitha etiketat dhe seritë kohore. Prandaj, nëse copat e dhënash janë të mëdha që ai i bashkon, përdorimi i memorjes rritet shumë gjatë bashkimit, ndryshe nga VictoriaMetrics. VictoriaMetrics gjatë bashkimit nuk konsumon fare memorje, përdoren disa kilobajtë, pavarësisht nga përmasat e copave të bashkuara të dhënash.
Algoritmi që përdorni konsumon memorje. Aty regjistrohen etiketat e serive kohore që kanë vlera. Dhe kështu kontrolloni praninë e dyfisht në një grup të dhënash dhe në tjetrin. Dhe kuptoni - ndodhi përputhja apo jo. Zakonisht në bazat e të dhënave implemtohen kursore, iterators, që ruajnë gjendjen e tyre aktuale dhe kalojnë nëpër të dhënat e renditura, për shkak të kësaj, keni një kompleksitet të thjeshtë në këto operacione.
Pse nuk përdorim kursore për përputhjen e të dhënave?
Po.
Në LevelDB ose në mergeset ruhen pikërisht rreshtat e renditur. Mund të kalojmë me një kursor dhe të gjejmë përputhjen. Por pse nuk e përdorim? Sepse - është e ngadaltë. Sepse kursoret nënkuptojnë se për çdo rresht duhet të thërrasësh një funksion. Thirrja e funksionit - është 5 nanosekonda. Dhe nëse keni 100,000,000 rreshta, rezulton se ne shpenzojmë një të pestën e sekondës vetëm për thirrjen e funksionit.
Kjo ndodh, po. Dhe pyetja ime e fundit. Pyetja, ndoshta, mund të duket pak e çuditshme. Pse në momentin e pranimit të të dhënave nuk mund të llogariten të gjitha agregatet e nevojshme dhe të ruhen në formën e nevojshme? Pse të ruani volume të mëdha në sisteme si VictoriaMetrics, ClickHouse, etj., në mënyrë që pastaj të shpenzoni shumë kohë për to?
Më lejoni të jap një shembull për ta bërë më të qartë. Supozoni, si funksionon një spidometër i vogël lodër? Ai regjistron distancën që keni kaluar, duke e shtuar atë vazhdimisht në një vlerë, dhe në vlerën tjetër - kohën. Pastaj bën ndarjen për të marrë shpejtësinë mesatare. Mund të bëni diçka të ngjashme. Shtoni në fluturim të gjitha faktet e nevojshme.
Mirë, kuptova pyetjen. Shembulli juaj ka vend në jetë. Nëse e dini se cilat agregate ju duhen, atëherë kjo është zbatimi më i mirë. Por problemi është se njerëzit ruajnë këto metrika, disa të dhëna në ClickHouse dhe ata nuk e dinë ende se si do t'i agregojnë dhe filtrojnë ato në të ardhmen, prandaj duhet të ruajnë të gjitha të dhënat e papërpunuara. Por nëse e dini se ju nevojitet të llogaritni diçka mesatare, atëherë përse të mos e llogaritni atë, në vend që të ruani një sasi të madhe vlerash të papërpunuara? Por kjo është vetëm në rastin kur e dini saktësisht se çfarë ju nevojitet.
Për më tepër, bazat për ruajtjen e serive të kohës mbështesin llogaritjen e agregateve. Për shembull, Prometheus mbështet . Kjo do të thotë se është e mundur ta bëni këtë, nëse e dini se cilat agregate do t'ju nevojiten. Në VictoriaMetrics kjo ende nuk ekziston, por zakonisht para saj vendoset Prometheus, ku mund ta bëni këtë në rregullat e regjistrimit.
Për shembull, në punën time të mëparshme duhej të llogarisja numrin e ngjarjeve në një dritare që lëviz për orën e fundit. Problemi ishte se duhej të përfundoja një implementim të personalizuar në Go, dmth., një shërbim për të llogaritur këtë gjë. Ky shërbim përfundimisht doli të ishte jo triviale, sepse është e vështirë të llogaritet. Një implementim mund të jetë i thjeshtë, nëse keni nevojë të llogaritni disa agregate në intervale fikse kohore. Nëse dëshironi të llogaritni ngjarjet në një dritare lëvizëse, atëherë kjo nuk është aq e lehtë sa duket. Mendoj se kjo nuk është realizuar ende në ClickHouse ose në bazat e të dhënave të serive të kohës, sepse është e komplikuar për t'u realizuar.
Dhe një pyetje tjetër. Tani po flisnim për mesataren, dhe më erdhi në mend që dikur kishte një gjë si Graphite me backend Carbon. Ai dinte të filtrojë të dhënat e vjetra, dmth. të linte një pikë për minutë, një pikë për orë dhe kështu me radhë. Në fakt, është mjaft e përshtatshme, nëse na duhen të dhëna të papërpunuara, thjesht për muajin, ndërsa gjithçka tjetër mund të filtrohet. Por Prometheus dhe VictoriaMetrics nuk e mbështesin këtë funksionalitet. A është planifikuar të mbështetet? Nëse jo, atëherë pse?
Faleminderit për pyetjen. Përdoruesit tanë e bëjnë këtë pyetje herë pas here. Ata kërkojnë të dinë kur do të shtojmë mbështetje për ngjeshjen e të dhënave (downsampling). Këtu ka disa probleme. Së pari, çdo përdorues ka kuptimin e tij për downsampling duke kërkuar një pikë të caktuar në një interval të caktuar, dikush dëshiron vlerat maksimale, minimale ose mesatare. Nëse në bazën tuaj janë duke i shkruar të dhëna shumë sisteme, nuk mund t'i trajtoni ato njëlloj. Mund të ndodhë që për çdo sistem të nevojitet përdorimi i një mënyre të ndryshme ngjeshjeje. Dhe kjo është e vështirë për t'u realizuar.
Dhe e dyta – është që VictoriaMetrics, ashtu si ClickHouse, është optimizuar për të punuar me një volum të madh të dhënash të papërpunuara, kështu që ajo mund të analizoje një miliard rreshta për më pak se një sekondë, nëse keni shumë bërthama në sistemin tuaj. Skarimi i pikave të serisë temporale në VictoriaMetrics është 50,000,000 pika në sekondë për një bërthamë. Dhe kjo performancë shkallëzohet në bërthamat e disponueshme. Pra, nëse keni 20 bërthama, për shembull, do të arrini të analizoni një miliard pikash në sekondë. Dhe kjo veçori e VictoriaMetrics dhe ClickHouse zvogëlon nevojën për downsampling.
Një tjetër veçori është se VictoriaMetrics kompreson këto të dhëna në mënyrë efikase. Kompresimi mesatar në prodhim është nga 0.4 deri në 0.8 byte për pikë. Çdo pikë përbëhet nga timestamp + vlera. Dhe ajo kompresohet më pak se një byte në mesatare.
Sergei. Kam një pyetje. Cili është kvanti minimal i kohës së regjistrimit?
Një milisekondë. Së fundmi, kishim një bisedë me zhvillues të tjerë të bazave të dhënash për seritë temporale. Kvanti minimal i tyre kohor është një sekondë. Edhe në Graphite, për shembull, është një sekondë. Në OpenTSDB gjithashtu është një sekondë. Në InfluxDB – pikësia është në nanosekonda. Në VictoriaMetrics – është një milisekondë, sepse në Prometheus është një milisekondë. Dhe VictoriaMetrics është zhvilluar si ruajtje e largët për Prometheus fillimisht. Por tani ajo mund të ruajë të dhëna edhe nga sisteme të tjera.
Njeriu me të cilin bisedova thotë se ndajnë një pikësi sekondë – kjo është e mjaftueshme për ta, sepse varet nga lloji i të dhënave që ruhen në bazën e të dhënave temporale. Nëse janë të dhëna DevOps ose të dhëna nga infrastruktura, ku i mbledhni ato me intervale prej 30 sekondash deri në një minutë, atëherë një pikësi sekondë është e mjaftueshme, më pak nuk është e nevojshme. Por nëse po mbledhni këto të dhëna nga sisteme tregtimi me frekuencë të lartë, atëherë nevojitet pikësi në nanosekonda.
Saktësia në milisekonda në VictoriaMetrics është e përshtatshme si për rastin e DevOps, ashtu edhe për shumicën e rasteve që përmenda në fillim të raportit. E vetmja gjë për të cilën ajo mund të mos jetë e përshtatshme është për sistemet e tregtisë me frekuencë të lartë.
Faleminderit! Dhe një pyetje tjetër. Cila është përputhshmëria në PromQL?
Përputhshmëria e plotë retroaktive. VictoriaMetrics mbështet plotësisht PromQL. Për më tepër, ajo shton një funksionalitet të zgjeruar mbi PromQL, i cili quhet . Për këtë funksionalitet të zgjeruar ka një raport në YouTube. E kam përshkruar në Monitoring Meetup pranverën e kaluar në Shën Petersburg.
Kanali i Telegramit .
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
Çfarë ju pengon të kaloni në VictoriaMetrics si një magazinë afatgjatë për Prometheus? (Shkruani në komentet, do ta shtoj në ankete))
71,4%Nuk po përdor Prometheus5
28,6%Nuk e dija për VictoriaMetrics2
7 përdorues kanë votuar. 12 përdorues janë abstenuar.
Burimi: habr.com
