

Përshëndetje, banorë të Habrushka. Si zakonisht, vijojmë të ndajmë materiale interesante përpara nisjes së kurseve të reja. Sot, për ju, kemi përkthyer një artikull mbi Google Cloud Spanner, duke e përshatur me lansimin e kursit .
Fillimisht e publikuar në .
Si një kompani që ofron një sërë zgjidhjesh cloud POS për tregtarët me pakicë, restorantet dhe shitësit online në të gjithë botën, Lightspeed përdor disa lloje të ndryshme platformash databazash për shumë raste transaksionale, analitike dhe kërkuese. Secila nga këto platforma databazash ka përparësitë dhe disavantazhet e saj. Prandaj, kur Google prezantoi Cloud Spanner në treg — funksione të premtuara, të papara në botën e databazave relacionale, si shkallëzimi horizontal praktikisht i pakufizuar dhe një marrëveshje për nivelin e shërbimit (SLA) prej 99,999% — ne nuk mund të humbisnim rastin për ta pasur atë në duar!
Për të ofruar një pasqyrë të plotë të përvojës sonë me Cloud Spanner, si dhe të kritereve të vlerësimit që kemi përdorur, ne do të shqyrtojmë temat e mëposhtme:
- Kriteret tona të vlerësimit
- Cloud Spanner në dy fjalë
- Vlerësimi ynë
- Konkluzionet tona
1. Kriteret tona të vlerësimit
Para se të thellohemi në karakteristikat e Cloud Spanner, ngjashmërinë dhe ndryshimet me zgjidhjet e tjera në treg, le të flasim fillimisht për rastet kryesore të përdorimit që kishim në mendje kur shqyrtonim se ku të implementonim Cloud Spanner në infrastrukturën tonë:
- Si një zëvendësim për zgjidhjen tradicionale të databazave SQL
- Si një zgjidhje OLTP me mbështetje për OLAP
Vërejtje: Për lehtësi dhe për krahasonim, ky artikull krahas së Cloud Spanner me variantet e MySQL të familjeve të zgjidhjeve GCP Cloud SQL dhe Amazon AWS RDS.
Përdorimi i Cloud Spanner si zëvendësim për zgjidhjen tradicionale të databazave SQL
Në mjedisin tradicional të databazave, kur koha e përgjigjes për një kërkesë në databazë afron ose madje kalon vlerat e përcaktuara të pragut të aplikacionit (më së shumti për shkak të rritjes së numrit të përdoruesve dhe/ose kërkesave), ka disa mënyra për të ulur kohën e përgjigjes në nivele të pranueshme. Megjithatë, shumica e këtyre zgjidhjeve përfshijnë ndërhyrje manuale.
Për shembull, hapi i parë që duhet të merrni është të shikoni parametrat e ndryshëm të bazës së të dhënave që lidhen me performancën dhe t'i konfiguroni ata në mënyrë që të përputhen sa më mirë me modelet e skenarëve të përdorimit të aplikacioneve. Nëse kjo nuk është e mjaftueshme, mund të zgjidhni për të shkallëzuar bazën e të dhënave në mënyrë vertikale ose horizontale.
Shkallëzimi vertikal i një aplikacioni bëhet me azhurnimin e instancës së serverit, zakonisht duke shtuar më shumë procesorë/kanale, më shumë memorie RAM, ruajtje më të shpejtë, etj. Shtimi i më shumë burimeve harduerike çon në rritjen e performancës së bazës së të dhënave, e cila matet kryesisht në transaksione për sekondë dhe vonesa transaksionesh për sistemet OLTP. Sistemet e bazave të të dhënave relazionale (të cilat përdorin qasjen shumëthithëse), si MySQL, shkallëzohen mirë në mënyrë vertikale.
Ky qasje ka disa disavantazhe, por më e dukshme është madhësia maksimale e serverit në treg. Sapo të arrihet kufiri i instancës më të madhe të serverit, do të mbetet vetëm një rrugë: shkallëzimi horizontal.
Shkallëzimi horizontal është një qasje në të cilën shtohen më shumë serverë në klaster, për të rritur idealisht performancën në mënyrë lineare me shtimin e numrit të serverëve. Shumica tradicional e sistemeve të bazave të të dhënave shkallëzohen keq horizontalisht ose nuk shkallëzohen fare. Për shembull, MySQL mund të shkallëzohet horizontalisht për operacione leximi, duke shtuar lexues slave, por nuk mund të shkallëzohet horizontalisht për operacione shkruese.
Nga ana tjetër, për shkak të natyrës së tij, Cloud Spanner mund të shkallëzohet lehtësisht horizontalisht me ndërhyrje minimale.
Një Sistemi i Menaxhimit të Bazave të të Dhënave si Shërbim duhet të vlerësohet nga këndvështrime të ndryshme. Si bazë, ne morëm sistemin më të popullarizuar të bazave të të dhënave në cloud — për Google, GCP Cloud SQL dhe për Amazon, AWS RDS. Në vlerësimin tonë, përqëndruam vëmendjen në kategoritë e mëposhtme:
- Krahasimi i karakteristikave: extensi SQL, DDL, DML; bibliotekat e lidhjeve/konektorëve, mbështetja për transaksione etj.
- Mbështetja për zhvillimin: lehtësia e zhvillimit dhe testimit.
- Mbështetje për administrimin: menaxhimi i instanceve — për shembull, shkallëzimi lart/poshtë dhe përmirësimi i instanceve; SLA, kopjimi në rezervë dhe rikuperimi; siguria/kontrolli i qasjes.
Përdorimi i Cloud Spanner si një zgjidhje OLTP me mbështetje OLAP
Megjithëse Google nuk e deklaron qartë se Cloud Spanner është i destinuar për përpunimin analitik, ai ndan disa tipare me mekanizma të tjerë si Apache Impala & Kudu dhe YugaByte, të cilët janë të dizajnuar për ngarkesa të punës OLAP.
Edhe nëse do të kishte vetëm një probabilitet të vogël që Cloud Spanner të përfshinte një motor të shkallëzueshëm horizontalisht të harmonizuar HTAP (përpunim hibrid transaksional/analitik) me një paketë funksionesh OLAP që është (më shumë apo pak) e përdorshme, ne mendojmë se kjo do të meritonte vëmendjen tonë.
Me këtë në mendje, ne shqyrtuam kategoritë në vijim:
- Ngarkimi i të dhënave, indekset dhe mbështetje për partiçionimin
- Kërkesat e performancës dhe DML
2. Cloud Spanner në dy fjalë
Google Spanner është një sistem i grumbulluar i menaxhimit të bazave të të dhënave relacionale (RDBMS) që Google e përdor për shërbime të shumta të veta. Google e bëri atë të disponueshme për përdoruesit e Google Cloud Platform në fillim të vitit 2017.
Ja disa nga atributet e Cloud Spanner:
- Klastra RDBMS e shkallëzuar me harmonizim të fortë: përdor sinchronizimin e harduerit për të siguruar koherencën e të dhënave.
- Mbështetje për transaksionet ndërmjet tabelave: transaksionet mund të përfshijnë disa tabela — nuk është e nevojshme të kufizohen në një tavolinë (ndryshe nga Apache HBase ose Apache Kudu).
- Tabela të bazuara në çelësin primar: të gjitha tabelat duhet të kenë një çelës të deklaruar primar (ÇP), i cili mund të përbëhet nga disa kolona të tabelës. Të dhënat e tabelave ruhen sipas ÇP, gjë që i bën ato shumë efikase dhe të shpejta për kërkim sipas ÇP. Si sistemet e tjera të bazuara në ÇP, zbatimi duhet të modelojë me kujdes rastet e përdorimit të parashikuara për të arritur .
- Tabelat e alternuara: tabelat mund të kenë varësi fizike nga njëra-tjetra. Rreshtat e tabelës fëmijë mund të lidhen me rreshtat e tabelës prind. Ky qasje accelrojnë kërkimin e marrëdhënieve, të cilat mund të përcaktohen në fazën e modelimit të të dhënave, për shembull, në vendosjen e përbashkët të klientëve dhe faturave të tyre.
- Indekset: Cloud Spanner mbështet indekset dytësore. Një indeks përbëhet nga kolonat e indeksuara dhe të gjitha kolonat e PK. Nëse dëshirohet, indeksi gjithashtu mund të përfshijë kolona të tjera që nuk janë të indeksuara. Indeksi mund të alternohet me tabelën prind për të përshpejtuar kërkesat. Janë disa kufizime që zbatohen për indekset, siç është numri maksimal i kolonave shtesë që ruhen në indeks. Gjithashtu, kërkesat përmes indekseve mund të mos jenë aq të drejtpërdrejta si në sistemet e tjera RDBMS.
«Cloud Spanner zgjedh indeksin automatikisht vetëm në raste të rralla. Në veçanti, Cloud Spanner nuk zgjedh automatikisht një indeks dytësor nëse kërkesa kërkon ndonjë kolonë që nuk ruhet në ».
- Marrëveshja për nivelin e shërbimit (SLA): implementimi në një rajon me SLA prej 99,99%; implementimet me shumë regjione me 99,999% SLA. Edhe pse marrëveshja për nivelin e shërbimit është thjesht një marrëveshje dhe jo ndonjë garanci, unë besoj se punonjësit e Google kanë disa të dhëna të sakta për të bërë një deklaratë kaq të rëndësishme. (Për reference, 99,999% do të thotë 26,3 sekonda papërshtatshmëri shërbimi në muaj.)
- Më shumë:
Vërejtje: Projekti Apache Tephra shton mbështetje të zgjeruar për transaksionet në Apache HBase (i implementuar gjithashtu tani në Apache Phoenix si një version beta).
3. Vlerësimi ynë
Pra, të gjithë kemi lexuar deklaratat e Google për përfitimet e Cloud Spanner — një shkallëzim horizontal praktikisht të pakufizuar duke ruajtur një konsistencë të lartë dhe një SLA shumë të lartë. Edhe pse këto kërkesa, në çdo rast, janë jashtëzakonisht të vështira për t'u arritur, qëllimi ynë nuk ishte të mohonim ato. Në vend të kësaj, le të përqendrohemi në gjëra të tjera që shqetësojnë shumicën e përdoruesve të bazës së të dhënave: qartësia dhe lehtësia e përdorimit.
Ne e vlerësuam Cloud Spanner si një zëvendësim për Sharded MySQL.
Google Cloud SQL dhe Amazon AWS RDS, dy sistemet më të popullarizuara OLTP në tregun cloud, kanë një set të madh funksionesh. Megjithatë, për të shkallëzuar këto baza të dhënash përtej madhësisë së një nodi, ju nevojitet të realizoni shpartallimin e aplikacioneve. Ky qasje krijon një kompleksitet të shtuar si për aplikacionet ashtu edhe për administrimin. Ne shqyrtuam se si Spanner përfshihet në skenarin e bashkimit të disa segmenteve në një instancë dhe cilat funksione (nëse ka) mund të nevojiten të sakrifikohen.
Mbështetje për SQL, DML dhe DDL, si dhe për lidhësin dhe bibliotekat?
Së pari, kur startoni me çdo bazë të dhënash, është e nevojshme të krijoni një model të dhënash. Nëse mendoni se mund ta lidhni JDBC Spanner me mjetin tuaj të preferuar SQL, do të zbuloni se mund të kërkoni të dhënat tuaja me të, por nuk mund ta përdorni atë për të krijuar tabela ose për të bërë ndryshime (DDL) ose ndonjë operacion nënshtesa/aktualizimi/fshirje (DML). JDBC zyrtar nga Google nuk mbështet asnjërin.
«Aktualisht, driverët nuk mbështesin operacionet DML ose DDL».
Dokumentacioni i Spanner
Me konsolën GCP, situata nuk është më e mirë - mund të dërgoni vetëm kërkesa SELECT. Me fat, ekziston një driver JDBC me mbështetje për DML dhe DDL nga komuniteti, duke përfshirë transaksionet . Edhe pse ky driver është jashtëzakonisht i dobishëm, mungesa e një driver-i JDBC nga Google është befasuese. Me fat, Google ofron një mbështetje të gjerë për bibliotekat e klientëve (të bazuara në gRPC): C#, Go, Java, node.js, PHP, Python dhe Ruby.
Përdorimi praktikisht i detyrueshëm i API-ve të personalizuara për Cloud Spanner (për shkak të mungesës së DDL dhe DML në JDBC) sjell disa kufizime për fushat e lidhura të kodit, siç janë pikat e lidhjes ose kornizat e lidhjes së bazës së të dhënave (p.sh., Spring MVC). Si rregull, kur përdorni JDBC, mund të zgjidhni lirshëm pikat e lidhjes tuaj të preferuar (p.sh., HikariCP, DBCP, C3PO etj.), të cilat janë testuar dhe punojnë mirë. Në rastin e API-ve të personalizuara Spanner, ne duhet të mbështetemi në kornizat/pikat e lidhjes/sesionet që kemi krijuar vetë.
Konstrukti, i orientuar drejt çelësit të parë (PK), i lejon Cloud Spanner të jetë shumë i shpejtë në aksesin e të dhënave përmes PK, por gjithashtu çon në disa probleme me kërkesat.
- Nuk mund të përditësoni vlerën e çelësit kryesor; duhet të fshini fillimisht rekordin me PK-në origjinale dhe ta insertoni atë përsëri me vlerën e re. (Kjo është e ngjashme me bazat e të dhënave të orientuara ndaj PK-ve / mekanizmat e ruajtjes.)
- Çdo operator UPDATE dhe DELETE duhet të përcaktojë PK në WHERE, prandaj, nuk mund të ketë operatorë DELETE të zbrazët - gjithmonë duhet të ketë një nënkërkesë, për shembull: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Mungon opsioni i auto-increment ose diçka e ngjashme që vendos një sekuencë për fushën e PK-së. Në mënyrë që kjo të funksionojë, vlera përkatëse duhet të krijohet nga ana e aplikacionit.
Indekset sekondare?
Google Cloud Spanner ka mbështetje të integruar për indekset sekondare. Kjo është një tipar shumë i bukur, i cili nuk është gjithmonë i pranishëm në teknologjitë e tjera. Apache Kudu aktualisht nuk mbështet fare indekset sekondare, ndërsa Apache HBase nuk mbështet indekset drejtpërdrejt, por mund t'i shtojë ato nëpërmjet Apache Phoenix.
Indekset në Kudu dhe HBase mund të modelohen si një tabelë e veçantë me një përbërje të ndryshme të çelësave kryesorë, por atomikësia e operacioneve që kryhen me tabelën prindore dhe tabelat indeks të lidhura duhet të kryhet në nivelin e aplikacionit dhe nuk është triviale në një zbatim të duhur.
Siç u përmend në përmbledhjen e Cloud Spanner, indeksat e tij mund të ndryshojnë nga indeksat e MySQL. Prandaj, është e rëndësishme të jepni kujdes të veçantë kur krijoni pyetje dhe bëni profilizimin, për të siguruar përdorimin e indeksit të duhur atje ku është e nevojshme.
Pamjet?
Një objekt shumë popullor dhe i dobishëm në një bazë të dhënash janë pamjet. Ato mund të jenë të dobishme për një sërë përdorimesh; dy të preferuarit e mi janë niveli i abstraksionit logjik dhe niveli i sigurisë. Fatkeqësisht, Cloud Spanner nuk mbështet pamjet. Megjithatë, kjo na kufizon vetëm pjesërisht, pasi detajet e aksesit nuk janë në nivelin e kolonave, ku pamjet mund të jenë një zgjidhje e pranueshme.
Në dokumentacionin e Cloud Spanner, në seksionin që përshkruan kuotat dhe kufizimet (), there is one in particular that may be problematic for some applications: Cloud Spanner out of the box has a limit of a maximum of 100 databases per instance. Obviously, this can become a serious obstacle for a database intended to scale beyond 100 databases. Fortunately, after speaking with our Google technical representative, we found out that this limit can be increased to virtually any value through Google support.
Support for development?
Cloud Spanner offers quite decent support for programming languages to work with its API. Officially supported libraries are available for C#, Go, Java, node.js, PHP, Python, and Ruby. The documentation is quite detailed, but, like with other cutting-edge technologies, the community is relatively small compared to the most popular database technologies, which can lead to increased time spent on solving less common use cases or issues.
So, what about support for local development?
We did not find a way to create a Cloud Spanner instance in a local environment. The closest we got was a Docker image , which is generally similar but, in practice, is quite different. For example, CockroachDB can use PostgreSQL JDBC. Since the development environment should be as close as possible to the production environment, Cloud Spanner is not ideal, as you need to rely on a full Spanner instance. To save costs, you can choose an instance for a single region.
Support for administration?
Creating a Cloud Spanner instance is very simple. You just need to choose between creating a multi-regional or a single-region instance, specify the region(s), and the number of nodes. In less than a minute, the instance will be up and ready to work.
Several basic metrics are directly available on the Spanner page in the Google Console. More detailed views are available through Stackdriver, where you can also set metric thresholds and alert policies.
Access to resources?
MySQL ofron një konfigurim të gjerë dhe shumë të detajuar të lejeve/rolave të përdoruesve. Mund të rregulloni lehtësisht qasjen në një tabelë të caktuar apo madje edhe në një nëngrup të kolonave të saj. Cloud Spanner përdor mjetin Google Identity & Access Management (IAM), i cili lejon vendosjen e politikave dhe lejeve vetëm në një nivel shumë të lartë. Më i detajuar është leja në nivelin e bazës së të dhënave, e cila nuk përshtatet në shumicën e rasteve prodhuese. Ky kufizim ju detyron të shtoni masa të tjera sigurie në kodin tuaj, infrastrukturën tuaj ose të dyja për të parandaluar përdorimin e paautorizuar të burimeve Spanner.
Kopjet e rezervës?
Thënë thjesht, nuk ekzistojnë kopje rezervë në Cloud Spanner. Edhe pse kërkesat e larta të SLA të Google mund të garantojnë që nuk do të humbisni asnjë të dhënë për shkak të dështimeve të pajisjeve ose të bazës së të dhënave, nga gabimet njerëzore, defektet e aplikacioneve etj. Të gjithë e dimë rregullin: disponueshmëria e lartë nuk zëvendëson një strategji të arsyeshme të kopjimit të rezervës. Në këtë moment, mënyra e vetme për të bërë kopje rezervë të të dhënave është transmetimi i tyre përmes një programi në një ambient të veçantë të ruajtjes.
Përformanca e kërkesave?
Për shkarkimin e të dhënave dhe testimin e kërkesave, ne përdorëm Yahoo! Cloud Serving Benchmark. Në tabelën më poshtë, është paraqitur ngarkesa e punës B YCSB me një raport leximi 95% dhe shkrimi 5%.
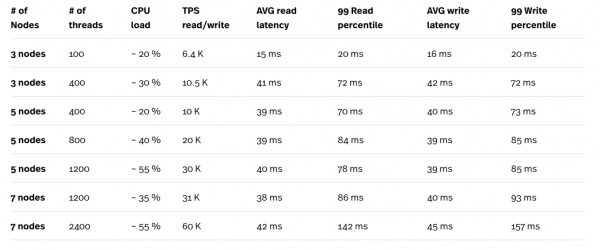
* Testi i ngarkesës u krye në motorin e llogaritjes (CE) n1-standard-32 (32 vCPU, 120 GB RAM), dhe instanca testuese nuk ishte kurrë një ngushtësim në testime.
** Numri maksimal i fijeve në një instancë YCSB është 400. Më shumë se duhej të nisnin gjashtë instanca paralele të testeve YCSB për të arritur një total prej 2400 fijeve.
Duke rezultatet e testeve, veçanërisht kombinimi i ngarkesës mbi procesorin dhe TPS, ne qartë shohim se Cloud Spanner shkallëzohet mjaft mirë. Ngarkesa e madhe, e shkaktuar nga numri i madh i proceseve, kompensohet nga numri i madh i nyjeve në klasterin Cloud Spanner. Megjithëse vonesa duket mjaft e lartë, veçanërisht kur punoni me 2400 procese, për të fituar numra më të saktë mund të nevojitet ritetestim me 6 instance më të vogla të motorit të përllogaritjes. Çdo instancë do të kryejë një test YCSB në vend të një instance të madhe CE me 6 teste paralele. Kështu, do të jetë më e lehtë të dallosh vonesat e kërkesave të Cloud Spanner dhe vonesat e shtuar nga lidhja rrjetore midis Cloud Spanner dhe instance CE ku po kryhet testi.
Si e menaxhon Cloud Spanner si OLAP?
Pjesëtimi?
Ndarja e të dhënave në segmente fizikisht dhe\/ose logjikisht të pavarura, të quajtura pjesë, është një koncept shumë i njohur, që i takon shumicës së mekanizmave OLAP. Pjesët mund të përmirësojnë ndjeshëm performancën e kërkesave dhe mbështetje të bazës së të dhënave. Një thellim më i thellë në pjesë do të rezultonte në një artikull të ndarë (artikuj), prandaj le të përmendim thjesht rëndësinë e ekzistencës së një skeme të pjesëtimit dhe sub-pjesëtimit. Aftësia për të ndarë të dhënat në pjesë dhe madje më tej në nënpjesë është çelësi për performancën e kërkesave analitike.
Cloud Spanner nuk mbështet pjesët si të tilla. Ai ndan të dhënat brenda në ato që njihen si split-e në bazë të intervaleve të çelësit primar. Ndarja kryhet automatikisht për të balancuar ngarkesën në klasterin Cloud Spanner. Një funksion shumë i përshtatshëm i Cloud Spanner është ndarja e ngarkesës bazë të tabelës prind (tabela që nuk alternohet me ndonjë tjetër). Spanner automatikisht përcakton nëse split të dhënat që lexohen më shpesh se të dhënat në të tjera split-e, dhe mund të vendosë për ndarjen më tej. Kështu, më shumë nyje mund të jenë të angazhuara në një kërkesë, e cila gjithashtu rrit në mënyrë efektive kapacitetin.
Ngarkimi i të dhënave?
Metoda Cloud Spanner për të dhëna voluminoze është e ngjashme me atë të ngarkesës normale. Për të arritur maksimalin e performancës, duhet të ndiqni disa rekomandime, duke përfshirë:
- Klasifikoni të dhënat tuaja sipas çelësit primar.
- Bëni ato në 10*numri i nyjeve seksioneve të veçanta.
- Krijoni një grup detyrash pune që ngarkojnë të dhënat paralelisht.
Teksa ngarkohet data, të gjitha nyjet e Cloud Spanner shfrytëzohen.
Ne përdorëm ngarkesën A YCSB për të gjeneruar një grup të dhënash prej 10M rreshtash.
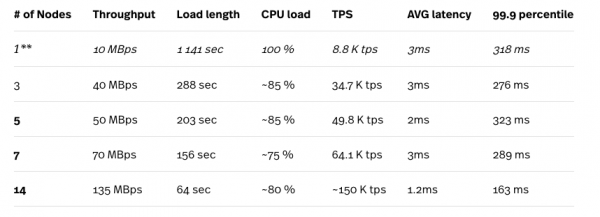
* Testi i ngarkesës u realizua në motorin llogaritës n1-standard-32 (32 vCPU, 120 GB RAM), dhe instanca testuese kurrë nuk u bë një ngushticë në teste.
** Cilësimi me 1 nyje nuk rekomandohet për asnjë ngarkesë prodhuese.
Siç përmendëm më sipër, Cloud Spanner automatizimisht menaxhon ndarjet në varësi të ngarkesës së tyre, prandaj rezultatet përmirësohen pas disa përsëritjeve të pasfollowuara të testeve. Rezultatet e paraqitura këtu janë rezultatet më të mira që kemi marrë. Duke parë numrat e mësipërm, mund të shohim se Cloud Spanner (në mënyrë të mirë) shkallëzohet me rritjen e numrit të nyjeve në klasër. Numrat që spikatin paraqesin mesatare shumë të ulët vonese, të cilat bien në kontrast me rezultatet e ngarkesave të përziera (95% për lexim dhe 5% për shkruaj), siç është përshkruar në seksionin më sipër.
Shkallëzimi?
Rritja dhe ulja e numrit të nyjeve në Cloud Spanner është një detyrë që bëhet me një klik. Nëse dëshironi të ngarkoni të dhëna shpejt, mund të merrni parasysh përshkallëzimin e instancës në maksimum (në rastin tonë ishin 25 nyje në rajonin US-EAST), dhe pastaj të ulni numrin e nyjeve që i përshtaten ngarkesës tuaj të zakonshme, pas ngarkimit të të gjitha të dhënave në databazë, duke pasur parasysh kufizimin prej 2 TB/nyje.
Na u kujtua për këtë kufi edhe me një databazë shumë më të vogël. Pas disa cikleve të testimit të ngarkesës, databaza jonë kishte një madhësi prej rreth 155 GB, dhe kur u ulim në një instancë me 1 nyje morëm këtë gabim:
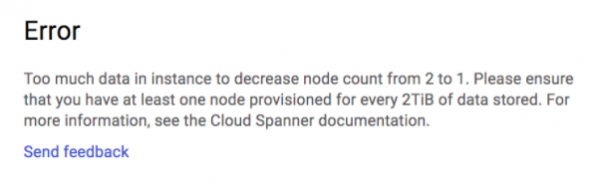
Na arriti të zvogëlojmë shkallën nga 25 në 2 instance, por mbetëm të ngujuar në dy nyje.
Rritja dhe ulja e numrit të nyjeve në klasën Cloud Spanner mund të automatizohet duke përdorur REST API. Kjo mund të jetë veçanërisht e dobishme për të zvogëluar ngarkesën e shtuar në sistem gjatë orëve me fluks të lartë.
Cila është performanca e pyetjeve OLAP?
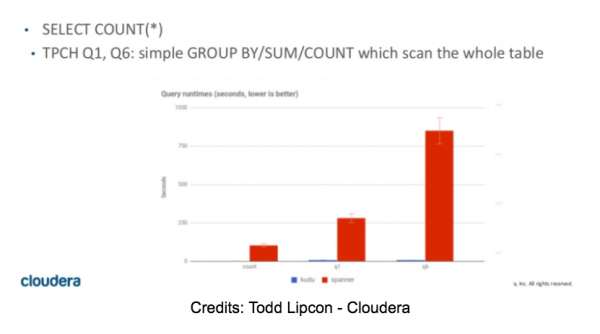
Fillimisht, ne planifikuam të dedikonim një kohë të madhe për vlerësimin tonë të Spanner për këtë pjesë. Pas disa SELECT COUNT, ne menjëherë kuptuam se testimi do të ishte i shkurtër dhe se Spanner NUK do të ishte i përshtatshëm si motor OLAP. Pavarësisht nga numri i nyjeve në klasë, një zgjedhje e thjeshtë e numrit të rreshtave në një tabelë me 10M rreshta zgjati nga 55 deri në 60 sekonda. Për më tepër, çdo kërkesë që kërkonte një volum më të madh memorje për ruajtjen e rezultateve ndërmjetëse përfundoi me një gabim OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M vlera të ndryshme)-> SpoolingHashAggregateIterator e shkoi jashtë memorjes gjatë rreshtit të ri.
Disa numra për kërkesat TPC-H mund të gjenden në artikullin e Todd Lipkon. , diapozitivet 42 dhe 43. Këto numra bien dakord me rezultatet tona (fatkeqësisht).
4. Përfundimet tona
Duke marrë parasysh gjendjen aktuale të karakteristikave të Cloud Spanner, është e vështirë të imagjinosh se ai do të ishte një zëvendësim i thjeshtë për zgjidhjen ekzistuese OLTP, veçanërisht kur nevojat e tua do të tejkalojnë ato. Do të nevojitej një kohë e konsiderueshme për të ndërtuar një zgjidhje duke marrë parasysh disavantazhet e Cloud Spanner.
Kur filluam vlerësimin e Cloud Spanner, prisnim që funksionaliteti i menaxhimit të ishte në nivelin e duhur ose, të paktën, jo shumë larg nga zgjidhjet e tjera Google SQL. Por na surprizoi mungesa totale e kopjeve rezervë dhe kontrolli shumë i kufizuar mbi burimet. Të mos harrojmë mungesën e pamjeve, mungesën e mjedisit lokal të zhvillimit, sekuenca që nuk mbështeten, JDBC pa mbështetje për DML dhe DDL dhe kështu me radhë.
Pra t'u shkruar, çfarë mund të bëjë ai që i nevojitet për të shkallëzuar një bazë të dhënash transaksionale? Duket se aktualisht në treg nuk ka një zgjidhje unike që i përshtatet të gjitha rasteve të përdorimit. Ekzistojnë shumë zgjidhje me kod të hapur dhe të mbyllur (disa prej të cilave përmenden në këtë artikull), çdo njëra ka forcën dhe dobësitë e saj, por asnjëra nuk ofron SaaS me SLA 99,999% dhe një nivel të lartë konsistence. Nëse një nivel i lartë SLA është qëllimi juaj kryesor, dhe nuk jeni të prirur të krijoni një zgjidhje për disa mjete cloud, Cloud Spanner mund të jetë zgjidhja që po kërkoni. Por duhet të jeni të vetëdijshëm për të gjitha kufizimet e tij.
Për të qenë të drejtë, duhet të përmendet se Cloud Spanner u publikua për qasje të përgjithshme vetëm në pranverën e vitit 2017, prandaj është e arsyeshme të pritet që disa nga disavantazhet e tij aktuale mund të zhduken në fund (shpresoj), dhe kur ndodhi kjo, mund të ndryshojë lojën. Pas të gjitha, Cloud Spanner nuk është thjesht një projekt jashtë për Google. Google e përdor atë si bazë për produkte të tjera të Google. Dhe kur Google kohët e fundit zëvendësoi Megastore në Google Cloud Storage me Cloud Spanner, kjo i dha mundësi Google Cloud Storage të bëhej shumë i qëndrueshëm për listat e objekteve në shkallë globale (çka ende nuk i përket ).
Pra, shpresë ka ende… ne shpresojmë.
Këtu përfundon gjithçka. Siç është autori i artikullit, ne gjithashtu vazhdojmë të shpresojmë, por çfarë mendoni ju për këtë? Shkruani në komentet
Të gjithë të interesuarit i ftojmë të vizitojnë në kuadër të të cilit do të flasim në detaje mbi kursin from OTUS.
Burimi: habr.com
