

Ideja e artikullit lindi spontanisht nga diskutimi në komentet e artikullit .
E vërteta është se specifikimi i brendshëm i funksionimit të shërbimeve tona është ruajtja e një numri të madh skedarësh të vegjël. Aktualisht kemi rreth qindra terabajt të tillë të dhënash. Dhe kemi hasur në disa pengesa të qarta dhe jo shumë të qarta dhe i kemi kaluar ato me sukses.
Prandaj po ndaj përvojën tonë, ndoshta do t'i shërbejë dikujt.
Problemi i parë: «Nuk ka hapësirë të mbetur në pajisje»
Siç u përmend në artikullin e mësipërm, problemi është se ka blloqe të lira në sistemin e dosjeve, por inode-ët janë ezauruar.
Numrin e inode-ve të përdorura dhe të lira mund ta kontrolloni me komandën df -ih:
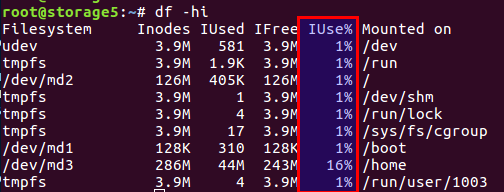
Nuk do ta përsëris artikullin, nëse e shohim shkurt, në disk ka blloqe të drejta për të dhënat, si dhe blloqe për metainformacionin, të njohura si inode (indeks i nyjës). Numri i tyre përcaktohet gjatë inicializimit të sistemit të dosjeve (flasim për ext2 dhe pasardhësit e saj) dhe më tej nuk ndryshohet. Balancimi i blloqeve të të dhënave dhe inode-ve llogaritet nga të dhënat mesatare, ndërsa në rastin tonë, ku ka shumë skedarë të vegjël, balancimi duhet të zhvendoset në anën e numrit të inode-ve — duhet të jenë më shumë.
Në Linux gjithashtu janë parashikuar variante me një balancim të ndryshëm, dhe të gjitha këto konfiguracione të paracaktuara ndodhen në skedarin /etc/mke2fs.conf.
Prandaj, gjatë inicializimit të parë të sistemit të dosjeve përmes mke2fs, mund të specifikoni profilin e nevojshëm.
Ja disa shembuj nga skedari:
    small = {
        blocksize = 1024
        inode_size = 128
        inode_ratio = 4096
    }

    big = {
        inode_ratio = 32768
    }

    largefile = {
        inode_ratio = 1048576
        blocksize = -1
    }
Zgjidhni variantin e nevojshëm të përdorimit me opsionin «-T» gjatë thirrjes së mke2fs. Po ashtu, mund të specifikoni manualisht parametrat e nevojshëm, nëse nuk ka një zgjidhje të gatshme.
Më shumë detaje janë përshkruar në manualet për mke2fs.conf dhe mke2fs.
Një karakteristikë e papërmendur në artikullin e mësipërm — mund të specifikoni madhësinë e bllokut të të dhënave. Ose, për skedarë të mëdhenj ka kuptim që blloku të jetë më i madh, për të vegjlit — më i vogël.
Megjithatë, është e rëndësishme të merret parasysh një karakteristikë interesante, siç është arhitektura e procesorit.
Në një moment unë mendoja se më duhej një madhësi më e madhe blloku për skedarët e mëdhenj të fotografive. Kjo ndodhi në kushte shtëpiake, në një ruajtës skedarësh WD mbi arkitekturën ARM. Unë, pa menduar shumë, vendosa madhësinë e bllokut 8k ose 16k në vend të standardit 4k, pas një matjeje të kursimit. Dhe gjithçka ishte shkëlqyer deri në momentin kur ruajtësi dështoi, ndërkohë që disku ishte i gjallë. Pasi e vendosa diskun në një kompjuter të zakonshëm me një procesor Intel të zakonshëm, mora një surprizë: madhësi blloku e papërshtatshme. E shkuara. Të dhënat janë aty, gjithçka është mirë, por nuk është e mundur të lexohen. Procesorët i386 dhe të ngjashmit nuk dinë të punojnë me madhësi blloku që nuk përputhen me madhësinë e faqeve të memories, e cila është saktësisht 4k. Në përgjithësi, kjo përfundoi me përdorimin e utiliteteve nga hapësira e përdoruesit, gjithçka ishte e ngadalshme dhe e trishtueshme, por të dhënat u shpëtuan. Për ata që janë të interesuar — kërkoni me emrin e utilitetit. fuseext2. Mësimi: ose të mendosh për të gjitha rastet paraprakisht, ose të mos bësh si një superheroi dhe të përdorësh cilësime standarde për amvisat.
UPD. Sipas vërejtjes së përdoruesit duke sqaruar se për i386 madhësia e bllokut nuk duhet të tejkalojë 4k, por nuk është e nevojshme të jetë saktësisht 4k, pra janë të pranueshme 1k dhe 2k.
Pra, si i zgjidhëm problemet ne.
Së pari, ne u përballëm me problemin kur disku me shumë terabajt ishte i mbushur me të dhëna dhe ne nuk mund të riparonim konfigurimin e sistemit të skedarëve.
Së dyti, zgjidhja kërkohej menjëherë.
Në fund arritëm në përfundimin se duhej të ndryshonim balancën, duke reduktuar numrin e skedarëve.
Për të reduktuar numrin e skedarëve, u vendos të vendosim skedarët në një arkiv të përbashkët. Duke marrë parasysh specifikën tonë, ne vendosëm në një arkiv të gjithë skedarët për një periudhë të caktuar kohore dhe e bëmë arkivimin me një task cron çdo natë.
Zgjodhëm një arkiv zip. Në komentet e artikullit të mëparshëm u propozuan tar, por me të ka një kompleksitet: nuk ka indeks, dhe skedarët në të janë të radhitur në mënyrë kaotike (nuk është rastësi që "tar" është shkurtim për "Tape Archive", trashëgimi e paisjeve me kasetë), dmth. nëse duam të lexojmë një skedar në fund të arkivit — duhet të lexojmë të gjithë arkivin, pasi nuk ka offset për secilin skedar në raport me fillimin e arkivit. Pra, kjo është një operacion i gjatë. Në zip, gjërat janë shumë më mirë: ai ka atë indeksin dhe offset skedarëve brenda arkivit, dhe koha e qasjes në çdo skedar nuk varet nga pozita e tij. Gjithashtu, në rastin tonë mund të ishte caktuar opsioni i kompresimit "0", pasi të gjithë skedarët ishin tashmë kompresuar në gzip.
Klientët marrin skedarët përmes nginx, dhe sipas API të vjetër, thjesht jepet emri i skedarit, për shembull kështu:
http://www.server.com/hydra/20170416/0453/3bd24ae7-1df4-4d76-9d28-5b7fcb7fd8e5
Për të shpaketuar skedarët në fluks, gjetëm dhe lidhëm modulin nginx-unzip-module () dhe konfiguruam dy upstream.
Si rezultat, u krijua një konfigurim i tillë:
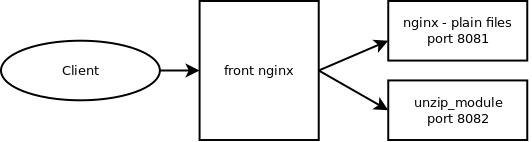
Dy host-e në konfigurim dukeshin kështu:
server {
  listen *:8081;

  location / {
    root /home/filestorage;
  }
}
server {
listen *:8082;
location ~ ^/hydra/(d+)/(
root /home/filestorage;
file_in_unzip_archivefile "/home/filestorage/hydra/$1/$2.zip";
file_in_unzip_extract "$2/$3";
file_in_unzip;
}
}
Dhe konfigurimi i upstream-eve në nginx e lartë:
upstream storage {
  server server.com:8081;
  server server.com:8082;
}
Si funksionon:
- Klienti shkon në nginx front
- Front nginx përpiqet të japë skedarin nga upstream i parë, dmth. drejtpërdrejt nga sistemi i skedarëve
- Nëse skedari nuk ekziston — përpiqet të japë nga upstream i dytë, i cili përpiqet të gjejë skedarin brenda arkivit
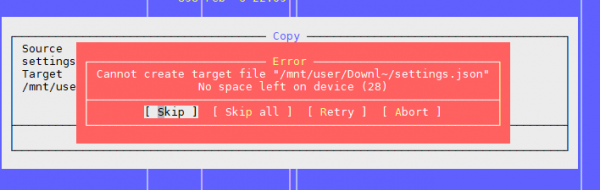
Problemi i dytë: përsëri "Nuk ka hapësirë të mbetur në pajisje"
Ky është problemi i dytë me të cilin u përballëm, kur në katalog ka shumë skedarë.
Ne përpiqemi të krijojmë një skedar, sistemi ankohet se nuk ka hapësirë. Ndryshojmë emrin e skedarit dhe përpiqemi përsëri ta krijojmë.
Dhe funksionon.
Duket kështu:

Kontrolli i inodes nuk dha asgjë — ka shumë të lirë.
Kontrolli i hapësirës — po të njëjtën gjë.
Mendova se ndoshta ka shumë skedarë në katalog, dhe për këtë ka një kufizim, por përsëri jo: Numri maksimal i skedarëve për katalog: ~1.3 × 10^20
Po ashtu, skedarin mund ta krijosh, nëse ndryshon emrin.
Përfundimi — problemi është te emri i skedarit.
Kërkime të mëtejshme treguan se problemi është te algoritmi i hash-it kur ndërtohet indeksi i katalogut, me numër të madh skedarësh vërehen kolizionet me të gjitha pasojat e tyre. Më shumë detaje mund të lexoni këtu:
Mund të çaktivizoni këtë opsion, por... kërkimi i skedarit sipas emrit mund të bëhet papritur shumë i gjatë gjatë kalimit në të gjithë skedarët.
tune2fs -O "^dir_index" /dev/sdb3
Në përgjithësi, si një zgjidhje përkohësore mund të funksionojë.
Mora e historisë: shumë skedarë në një katalog zakonisht është e keqe. Nuk duhet bërë kështu.
Zakonisht në këto raste krijohen katalogë të brendshëm, sipas shkronjave të para të emrit të skedarit ose sipas ndonjë parametri tjetër, për shembull, sipas datave, në shumicën e rasteve kjo shpëton.
Por numri total i skedarëve të vegjël është vazhdimisht i keq, edhe nëse ata ndahen në katalogë — atëherë shihni problemin e parë.
Problemi i tretë: si të shikoni listën e skedarëve, nëse ka shumë.
Në situatën tonë, kur kemi shumë skedarë, për ndonjë arsye, ne përballemi me problemin se si të shikojmë përmbajtjen e katalogut.
Zgjidhja standarde është komandë ls.
Ok, le të shohim se çfarë ndodh me 4772098 skedarë:
$ time ls /home/app/express.repository/offercache/ >/dev/null

real	0m30.203s
user	0m28.327s
sys	0m1.876s
30 sekonda... është shumë. Dhe koha kryesore shkon në përpunimin e skedarëve në hapësirën e përdoruesit, dhe aspak në funksionimin e bërthamës.
Por ka një zgjidhje:
$ time find /home/app/express.repository/offercache/ >/dev/null

real	0m3.714s
user	0m1.998s
sys	0m1.717s
3 sekonda. 10 herë më e shpejtë.
Hurra!
Për të përmirësuar kuptimin e tipave të mundshëm të njerëzve, pak e kam ndryshuar emrin e tyre:
Një zgjidhje edhe më e shpejtë nga përdoruesi — çaktivizimi i rendit ls
time ls -U /home/app/express.repository/offercache/ >/dev/null
real	0m2.985s
user	0m1.377s
sys	0m1.608s
Problemi i katërt: LA e madhe gjatë punës me skedarët
Herë pas here ndodhet situata kur duhet të kopjoni një mori skedarësh nga një makinë në një tjetër. Gjatë kësaj, shpesh ndodh të rritet ndjeshëm LA, pasi gjithçka varet nga performanca e disqeve të vet.
Ajo që është më arsyeshme është të përdorni SSD. Realisht e mahnitshme. Pyetja është vetëm për çmimin e SSD-ve të shumë terabyte.
Por nëse disqet janë normale, duhen kopjuar skedarët, dhe kjo është gjithashtu sistem prodhimi, ku ngarkesa çon në pakënaqësi të klientëve? Ka të paktën dy mjete të dobishme: nice dhe ionice.
nice — ul prioritetin e procesit, përkatësisht, plani i ekzekutimit ndan më shumë kuota kohe për proceset e tjera, më me prioritet.
Në praktikën tonë ka ndihmuar të vendosim nice maksimal (19 — është prioriteti minimal, -20 (minus 20) — maksimal).
ionice — përkatësisht rregullon prioritetin e hyrjes/daljes (I/O scheduling)
Nëse përdorni RAID dhe ai papritur ka nevojë të sinkronizohet (pas një rinisjeje të dështuar ose ndihmë për rikuperimin e RAID-it pas zëvendësimit të një disku), në disa situata ka kuptim të zvogëloni shpejtësinë e sinkronizimit, për t'i lejuar proceset e tjera të funksionojnë mjaft normalisht. Komanda e tillë do të ndihmojë:
echo 1000 > /proc/sys/dev/raid/speed_limit_max
Problemi i pestë: Si të sinkronizoni skedarët në kohë reale
Kemi të njëjtat sasi masive skedarësh, të cilat duhet t'i bëjmë backup në serverin e dytë për të shmangur… Skedarët shkruhen vazhdimisht, kështu që për të pasur minimumin e humbjeve, duhet t'i kopjojmë ato sa më shpejt të jetë e mundur.
Zgjidhja standarde: Rsync mbi SSH.
Kjo është një mundësi e mirë, nëse nuk duhet ta bëni këtë çdo disa sekonda. Dhe ka shumë skedarë. Edhe nëse nuk i kopjoni, duhet të kuptoni se çfarë ka ndryshuar, dhe krahasimi i disa miliona skedarëve është kohë dhe ngarkesë në disqe.
Pra, na nevojitet të dimë menjëherë se çfarë duhet të kopjojmë, pa e nisur krahasimin çdo herë.
Shpëtimi është – lsyncd. Lsyncd — . Ai gjithashtu funksionon përmes rsync, por përveç kësaj monitoron sistemin e skedarëve për ndryshime duke përdorur inotify dhe fsevents dhe nisin kopjimin vetëm për skedarët që janë krijuar ose ndryshuar.
Problemi i gjashtë: Si të kuptoni kush ngarkon diskët
Këtë ndoshta e dinë të gjithë, por megjithatë për plotësinë e pamjes: për monitorimin e nën-sistemave të disqeve ka komandën iotop – e ngjashme me top, por tregon proceset që përdorin diskët më aktivisht.
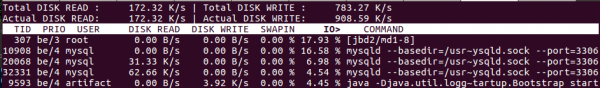
P.S. Vjetër e mirë top gjithashtu lejon të kuptoni nëse ka probleme me diskët apo jo. Për këtë ka dy parametra më të përshtatshëm: Load Average dhe IOwait.
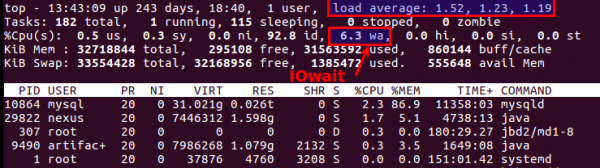
Parë e parë tregon se sa procese janë në radhë për shërbim, zakonisht më shumë se 2 – diçka nuk shkon siç duhet. Gjatë kopjimit aktiv në serverët e backup-it kemi tolerancë deri në 6-8, pas kësaj situata konsiderohet jo normale.
E dyta – sa është e angazhuar procesori në operacionet e disqeve. IOwait >10% – shkak për shqetësim, megjithatë në serverët tanë me profil të ngarkesës specifike ndodh që të jetë stabilisht 40-50%, dhe kjo është vërtet normale.
Këtu do ta mbyll, megjithatë me siguri ka shumë momente me të cilat na është dashur të përballemi, do të pres me kënaqësi komentet dhe përshkrimet e rasteve interesante reale.
Burimi: habr.com
