

Ne do ta shikojmë funksionimin e Zabbix me bazën e të dhënave TimescaleDB si backend. Do të tregojmë se si të startoni nga e para dhe si të migroni nga PostgreSQL. Gjithashtu, do të japim teste krahasuese të performancës së dy konfiguracioneve.
HighLoad++ Siberia 2019. Salla "Tomsk". 24 qershor, 16:00. Tezat dhe . Konferenca e ardhshme HighLoad++ do të zhvillohet më 6 dhe 7 prill 2020 në Shën Petersburg. Detajet dhe biletat .
Andrej Gushin (më pas – A.G.): – Unë jam inxhinier në mbështetje teknike të ZABBIX (më pas – "Zabbix"), trajner. Kam mbi 6 vjet përvojë në mbështetje teknike dhe kam përballur drejtpërdrejt me performancën. Sot do të flas për performancën që mund të ofrojë TimescaleDB, në krahasim me PostgreSQL 10. Gjithashtu, do të jap disa informata hyrëse – për mënyrën se si funksionon.
Sfidat kryesore të performancës: nga grumbullimi në pastrimin e të dhënave
Le të fillojmë me sfidat e caktuara të performancës, me të cilat përballen çdo sistem monitorimi. Sfidë e parë e performancës është mbledhja dhe përpunimi i shpejtë i të dhënave.
Një sistem monitorimi i mirë duhet të marrë dhe përpunojë të gjitha të dhënat me shpejtësi dhe në kohë, duke i përpunuar ato sipas shprehjeve provokuese, domethënë, duke i përpunuar sipas disa kritereve (në sisteme të ndryshme kjo është ndryshe) dhe të ruajë në bazën e të dhënave, në mënyrë që këto të dhëna të përdoren më vonë.
Sfidë e dytë e performancës është ruajtja e historisë. Të ruhen në bazën e të dhënave shpesh dhe të kenë qasje të shpejtë dhe të lehtë në këto metrika që janë mbledhur për një periudhë të caktuar kohe. E rëndësishme është që këto të dhëna të jenë të lehta për t'u marrë, t'i përdorni ato në raporte, grafikë, në shprehje provokuese, në disa vlera pragore, për njoftime etj.
Sfidë e tretë e performancës është pastrimi i historisë, domethënë kur arrin një ditë kur nuk është e nevojshme të ruash disa metrika të detajuara që janë mbledhur për 5 vjet (sikur edhe për muaj ose dy muaj). Disa nyje të rrjetit janë fshirë, ose disa hosta, metrikat nuk janë më të nevojshme sepse janë bërë të vjetra dhe kanë ndaluar së mbledhuri. Këto duhet të pastrohen, në mënyrë që baza e të dhënave të mos shndërrohet në një madhësi të madhe. Në të vërtetë, pastrimi i historisë shpesh është një provim serioz për magazinimin – zakonisht ndikon shumë te performanca.
Si të zgjidhni problemet e caching-ut?
Tani do të flasë konkretisht për «Zabbix». Në «Zabbix», thirrjet e para dhe të dyta zgjidhen përmes memorie të arkivimit.
Grumbullimi dhe përpunimi i të dhënave – ne përdorim memorien operative për të ruajtur të gjitha këto të dhëna. Tani do të flasë më në detaje rreth këtyre të dhënave.
Po ashtu, në anën e bazës së të dhënave ka një arkivim të caktuar për zgjedhjet kryesore – për grafiket, gjërat e tjera.
Arkivimi në anën e vetë serverit Zabbix: ne kemi ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Çfarë janë këto?
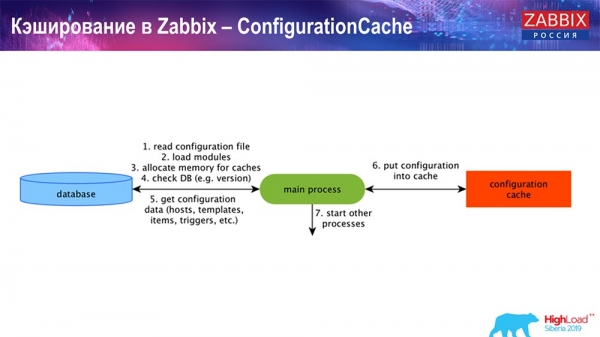
ConfigurationCache – është arkivi kryesor ku ruajmë metrikat, hostet, elementet e të dhënave, trigjerat; gjithçka që nevojitet për përpunimin paraprak, grumbullimin e të dhënave, se nga cilat hoste të grumbullojmë dhe me çfarë frekuencash. Të gjitha këto ruhen në ConfigurationCache, që të mos shkojmë në bazën e të dhënave, të mos krijojmë kërkesa të panevojshme. Pas fillimit të serverit, ne përditësojmë këtë arkiv (e krijojmë) dhe e përditësojmë periodikisht (në varësi të konfigurimit).
Arkivimi në Zabbix. Grumbullimi i të dhënave
Këtu schema është mjaft e madhe:
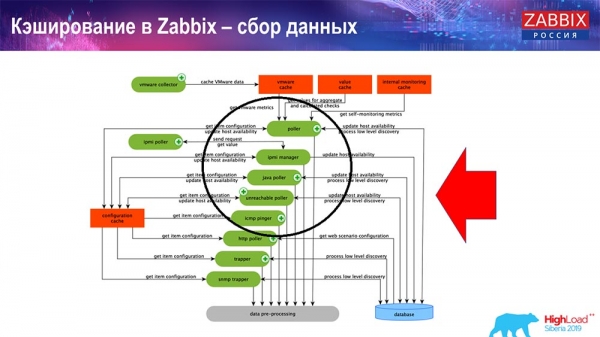
Kryesorët në schema – janë këta grumbullues:
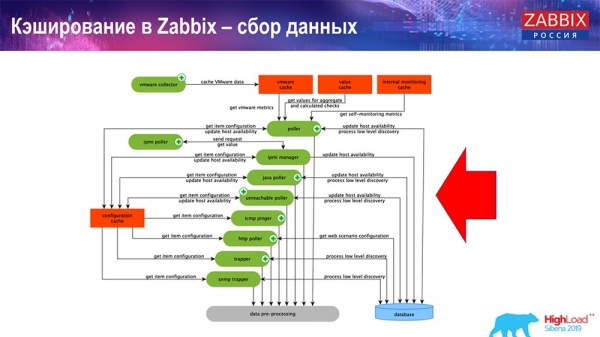
Këta janë proceset e grumbullimit, ‘poller’-at e ndryshëm, që janë përgjegjës për lloje të ndryshme grumbullimesh. Ata grumbullojnë të dhëna për icmp, ipmi, për protokolle të ndryshme dhe e kalojnë të gjitha këto për përpunim paraprak.
PreProcessing HistoryCache
Po ashtu, nëse kemi elemente të dhënash të llogaritura (ata që janë njohur me «Zabbix» e dinë), ka elemente të dhënash të llogaritura, agregative – ne i marrim ato direkt nga ValueCache. Si mbushet ai, do e tregoj më vonë. Të gjithë këta grumbullues përdorin ConfigurationCache për të marrë detyrat e tyre dhe pastaj i kalojnë për përpunim paraprak.
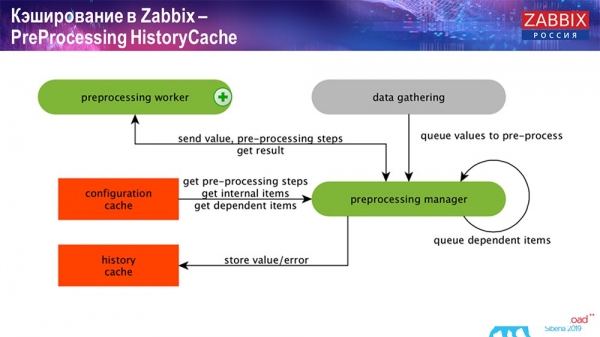
Përpunimi paraprak po ashtu përdor ConfigurationCache për të marrë hapat e përpunimit paraprak, e përpunon këto të dhëna në mënyra të ndryshme. Duke filluar nga versioni 4.2, ai është transferuar në proxy. Kjo është shumë e dobishme, sepse vetë përpunimi paraprak është një operacion mjaft i rëndë. Dhe nëse keni një ‘Zabbix’ shumë të madh, me shumë elemente të dhënash dhe një frekuencë të lartë grumbullimi, atëherë kjo e lehtëson ndjeshëm punën.
Pas përpunimit të këtyre të dhënave në ndonjë mënyrë përmes përpunimit paraprak, i ruajmë ato në HistoryCache për t'i përpunuar më tej. Këtu përfundon grumbullimi i të dhënave. Ne kalojmë në procesin kryesor.
Puna e History syncer
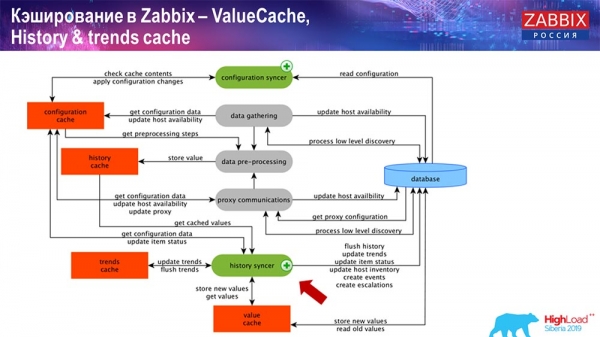
Procesi kryesor në «Zabbix» (që është një arkitekturë monolitike) është History syncer. Ky është procesi kryesor që merret me përpunimin atomar të çdo elementi të të dhënave, pra të çdo vlerësimi:
- vjen një vlerë (e merr nga HistoryCache);
- kontrollon në Configuration syncer: a ka ndonjë trigger për kalkulim – i llogarit ato;
nëse ka – krijon ngjarje, krijon eskalim për të krijuar një njoftim, nëse është e nevojshme sipas konfigurimit; - regjistron trigger për përpunim të mëtejshëm, agregim; nëse e agregoni për orën e fundit e kështu me radhë, kjo vlerë ruhet në ValueCache, për të mos u kthyer në tabelën e historisë; kështu, ValueCache plotësohet me të dhënat e nevojshme për të llogaritur trigger, elemente të llogaritura etj.;
- pastaj History syncer ruan të gjitha të dhënat në bazën e të dhënave;
- baza e të dhënave i shkruan ato në disk – këtu procesi i përpunimit përfundon.
Baza e të dhënave. Keshimi
Në anën e DB, kur dëshironi të shikoni grafikët ose ndonjë raporte për ngjarjet, ka disa caches. Por në kuadër të kësaj prezentimi nuk do të flas për to.
Për MySQL ka Innodb_buffer_pool, gjithashtu shumë caches të ndryshme që gjithashtu mund të konfigurohen.
Por këto janë – kryesoret:
- shared_buffers;
- effective_cache_size;
- shared_pool.
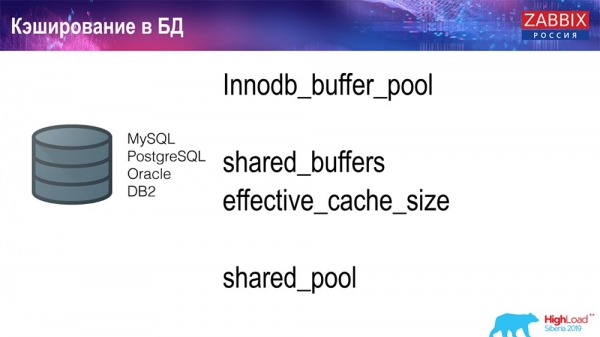
Për të gjitha bazat e të dhënave e kam treguar se ka caching të caktuar që lejon mbajtjen në memorie ato të dhëna që janë shpesh të nevojshme për kërkesa. Aty kanë teknologjitë e tyre për këtë.
Për performancën e bazës së të dhënave
Përkatësisht, ka një ambient konkurrues, pra serveri «Zabbix» mbledh të dhëna dhe i shkruan ato. Kur rindez, ai gjithashtu lexon nga historia për të mbushur ValueCache dhe kështu me radhë. Këtu mund të keni skenarë dhe raporte që përdorin «Zabbix»-API, i cili është ndërtuar në bazë të ndërfaqes së uebit. «Zabbix»-API hyn në DB dhe merr të dhënat e nevojshme për të marrë grafikët, raportet ose një listë ngjarjesh, problemet më të fundit.
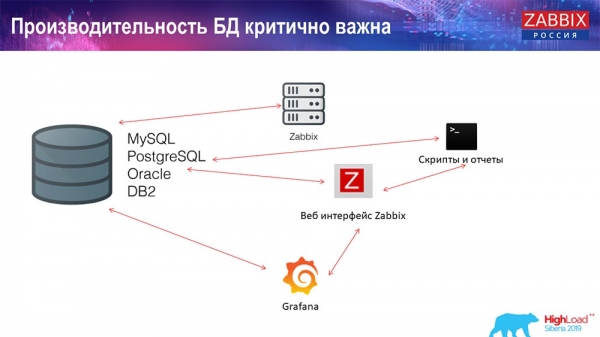
Një zgjidhje shumë e njohur për vizualizim është Grafana, që e përdorin përdoruesit tanë. Ajo mund të hyjë drejtpërdrejt si përmes «Zabbix»-API, ashtu edhe përmes DB. Ajo gjithashtu krijon një konkurrencë të caktuar për marrjen e të dhënave: nevojitet një konfigurim më i hollësishëm dhe i mirë i DB për të përmbushur shpërndarjen e shpejtë të rezultateve dhe testimeve.
Pastrimi i Historisë. Në Zabbix ka Housekeeper
Thirrja e tretë që përdoret në «Zabbix» është pastrimi i historisë me ndihmën e Housekeeper. «Housekeeper» respekton të gjitha cilësimet, pra kemi në elementët e të dhënave sa të ruajmë (në ditë), sa të ruajmë trendet, dinamikën e ndryshimeve.
Nuk e tregova për TrendCache, të cilin e llogarisim në kohë reale: të dhënat arrijnë, ne i agregojmë për një orë (kryesisht kjo është numri për orën e fundit), numri mesatar / minimal dhe i regjistrojmë këtë një herë në orë në tabelën e dinamikës së ndryshimeve («Trendet»). «Housekeeper» aktivizohet dhe fshin të dhënat nga DB me ndihmën e selektonëve të zakonshëm, çka nuk është gjithmonë efikase.
Si të kuptoni se kjo nuk është efikase? Mund të shihni një pamje të tillë në grafiket e performancës së proceseve të brendshme:
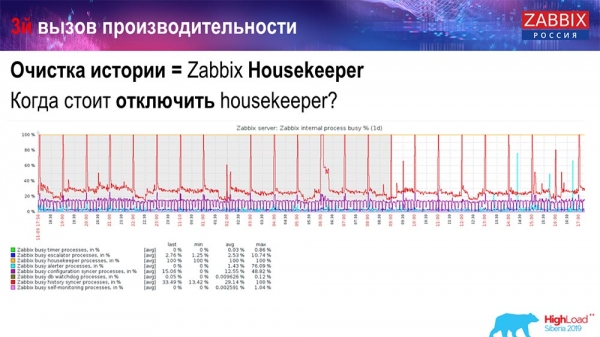
Historia juaj e sinkronizimit është vazhdimisht e angazhuar (grafiku i kuq). Dhe grafiku «portokalli», që shkon lart. Ky është «Housekeeper», i cili aktivizohet dhe pret nga DB që të fshijë të gjitha rreshtat që ai ka caktuar.
Merrni një ID të ndonjë Artikulli: duhet të fshini 5 mijë të fundit; sigurisht, sipas indekseve. Por zakonisht dataset-i është mjaft i madh – baza e të dhënave megjithatë e lexon këtë nga disku dhe e ngre në cache, dhe kjo është një operacion shumë i shtrenjtë për DB. Në varësi të madhësive të saj, kjo mund të sjellë disa probleme të performancës.
Mund ta çaktivizoni «Housekeeper» në një mënyrë të thjeshtë – kemi ndërfaqen e njohur të uebit. Cilësimi në Administration general (cilësimet për «Housekeeper») ne çaktivizojmë housekeeping-un e brendshëm për historinë dhe trendet e brendshme. Për rrjedhojë, «Housekeeper» nuk menaxhon më këtë:
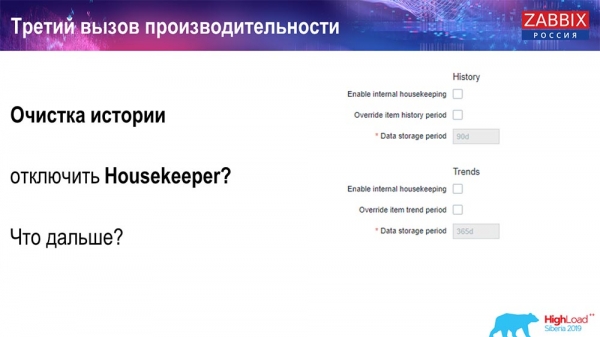
Çfarë mund të bëni më tej? E keni çaktivizuar, grafiket tuaj janë rregulluar... Çfarë probleme mund të dalin më pas në këtë rast? Çfarë mund të ndihmojë?
Particionimi (sekcionimi)
Zakonisht kjo inkorporohet në çdo bazë të dhënash relacionale, të cilat i përmenda, në mënyra të ndryshme. Në MySQL ka teknologjinë e saj. Por në përgjithësi ato janë shumë të ngjashme, nëse flasim për PostgreSQL 10 dhe MySQL. Sigurisht, ka shumë ndryshime të brendshme, si është realizuar gjithçka dhe si ndikon gjithçka në performancë. Por në përgjithësi, krijimi i një partie të re shpesh të çon gjithashtu në disa probleme të caktuara.
Në varësi të setup-it tuaj (sa shumë të dhëna krijohen për një ditë), zakonisht vendoset minimumi – 1 ditë/pjesë, dhe për "trendet", dinamika e ndryshimeve – 1 muaj/pjesë e re. Kjo mund të ndryshojë, nëse keni një setup shumë të madh.
Më lejoni t'ju them përmasat e setup-it: deri në 5 mijë vlera të reja për sekondë (nvps e ashtuquajtura) – kjo do të konsiderohet një "setup" i vogël. I mesëm – nga 5 deri në 25 mijë vlera në sekondë. Gjithçka që kalon – është një instalim i madh dhe shumë i madh, që kërkon një konfigurim shumë të kujdesshëm të bazës së të dhënave.
Në instalimet shumë të mëdha, 1 ditë – mund të mos jetë optimale. Unë kam parë personalisht në MySQL pjesë deri në 40 gigabajt për ditë (dhe mund të jenë më shumë). Ky është një volum shumë i madh të dhënash, që mund të çojë në disa probleme. Duhet ta zvogëloni.
Përse është e nevojshme pjesëtimi?
Çfarë ofron Pjesëtimi, mendoj se të gjithë e dinë – kjo është ndarja e tabelave. Shpesh, këto janë skedarë të veçantë në disk dhe kërkesa të shpejta. Ai përzgjedh më optimalisht një pjesë, nëse është pjesë e zakonshme e ndarjes.
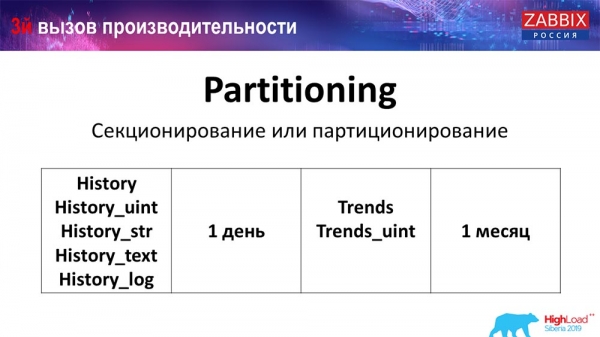
Për "Zabbix", në veçanti, përdoret sipas rangut, sipas intervalit, pra ne përdorim timestamp (numri normal, koha që nga fillimi i epokës). Ju caktoni fillimin e ditës/fundin e ditës, dhe kjo është një pjesë. Për rrjedhojë, nëse kërkoni të dhëna të dy ditëve më parë, gjithçka merret nga baza e të dhënave më shpejt, sepse duhet të ngarkohet vetëm një skedar në cache dhe të jepet (dhe jo një tabelë e madhe).
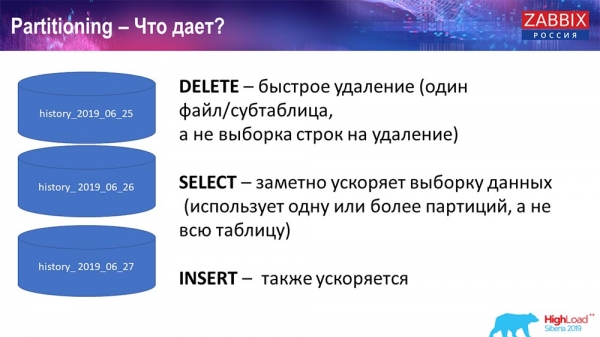
Shumë baze të dhënash gjithashtu përshpejtojnë insertin (shtimin në një tabelë të fëmijës). Ndërsa po flas në mënyrë abstrakte, por kjo është gjithashtu e mundur. Pjesëtimi shpesh ndihmon.
Elasticsearch për NoSQL
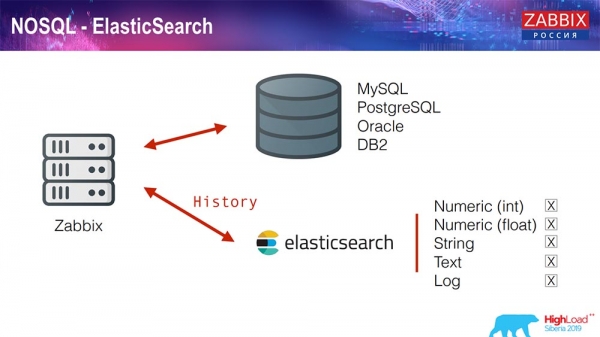
Së fundmi, në 3.4, ne implementuam një zgjidhje për NoSQL. Shtuam mundësinë për të shkruar në Elasticsearch. Ju mund të shkruani disa lloje të veçanta: zgjidhni – ose shkruani numra, ose disa simbole; ne kemi tekst të vargut, mund të shkruani logje në Elasticsearch... Për rrjedhojë, ndërfaqja e uebit do të lidhet gjithashtu me Elasticsearch. Kjo funksionon shkëlqyer në disa raste, por në momentin e tanishëm mund të përdoret.
TimescaleDB. Hyper-tabela
Për 4.4.2 ne kemi vënë re një gjë, siç është TimescaleDB. Çfarë është kjo? Kjo është një shtesë për PostgreSQL, që do të thotë se ka një ndërfaqe native për PostgreSQL. Përveç kësaj, kjo shtesë lejon që të punoni shumë më efektivisht me të dhënat e caktuara me kohë dhe gjithashtu ka ndarje automatike. Si duket kjo:
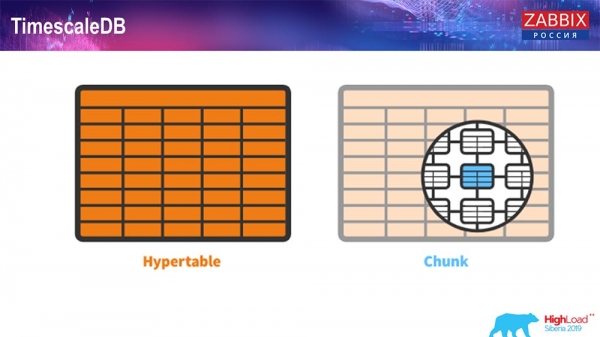
Kjo është hypertable – ka një koncept të tillë në Timescale. Kjo është një hipertabelë që krijoni, dhe në të gjenden chunks. Chunks janë ndarje, janë tabelat fëmijët, nëse nuk gaboj. Kjo është me të vërtetë efektive.
TimescaleDB dhe PostgreSQL
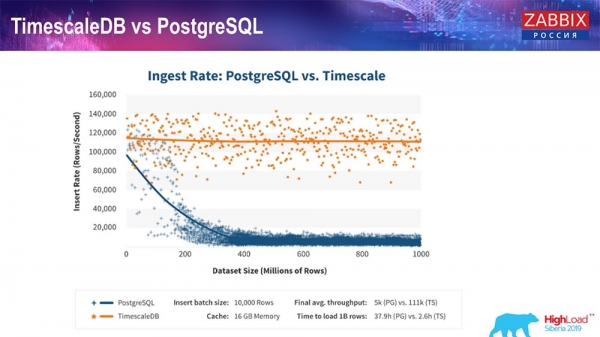
Sipas prodhuesve të TimescaleDB, ata përdorin një algoritëm më të saktë për përpunimin e kërkesave, sidomos për insertimet, i cili lejon të ketë një performancë afërsisht të vazhdueshme me rritjen e madhësisë së dataset-inserimit. Do të thotë, pas 200 milion rreshtash, PostgreSQL fillon të humbasë shumë në performancë, duke rënë literally në zero, ndërsa 'Timescale' lejon që të inseroni sa më efektivisht të jetë e mundur me çdo sasi të të dhënash.
Si të instaloni TimescaleDB? E gjithë kjo është e thjeshtë!
Ka në dokumentacionin e tij, përshkruar – mund të instalohet nga paketat për çdo... Ajo varet nga paketat zyrtare të 'PostgreSQL'. Mund të kompiloni manualisht. Kështu ndodhi që më duhej të kompiloj për DB.
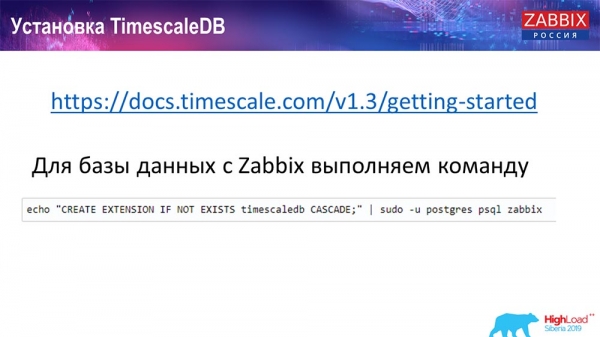
Në 'Zabbix' ne thjesht aktivizojmë Shtesën. Mendoj se ata që kanë përdorur Shtesën në 'PostgreSQL'... Thjesht e aktivizoni Shtesën, e krijoni për DB 'Zabbix' që përdorni.
Dhe hapi i fundit...
TimescaleDB. Migrimi i tabelave të historisë
Ju nevojitet të krijoni hypertable. Për këtë ka një funksion të veçantë – Krijoni hypertable. Në të, si parametrin e parë duhet të tregoni tabelën që është e nevojshme në këtë DB (për të cilën duhet të krijoni hipertabelën).
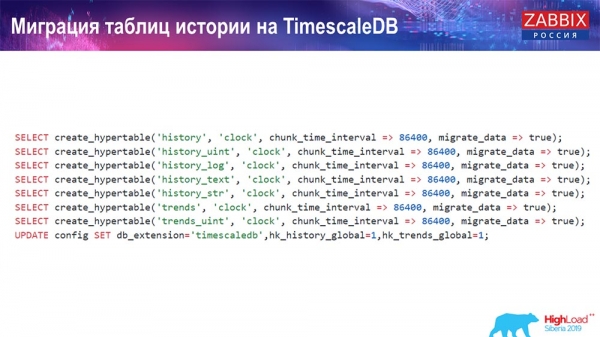
Fusha mbi të cilën duhet të krijoni, dhe chunk_time_interval (kjo është intervali i chunks (ndarjeve, që duhet të përdoren). 86,400 – kjo është një ditë.
Parametri migrate_data: nëse e vendosni në true, atëherë kjo transferon të gjitha të dhënat aktuale në chunks e krijuara më parë.
Unë vetë kam përdorur migrate_data – kjo merr një kohë të konsiderueshme, në varësi të madhësisë së DB tuaj. Kam pasur më shumë se një terabajt – krijimi zgjati më shumë se një orë. Në disa raste, gjatë testimit, kam fshirë të dhënat historike për tekstin (history_text) dhe stringun (history_str), që të mos i transferoja – ato në të vërtetë nuk më interesonin.
Dhe përditësimi përfundimtar e bëjmë në db_extention tonë: vendosim timescaledb, në mënyrë që DB dhe, veçanërisht, "Zabbix" të kuptoj se ekziston db_extention. Ai e aktivizon dhe përdor sintaksën e duhur dhe kërkesat ndaj DB, duke përdorur tashmë ato "karakteristika" që janë të nevojshme për TimescaleDB.
Konfigurimi i serverit
Kam përdorur dy serverë. Serveri i parë është një makinë virtuale mjaft e vogël, 20 procesorë, 16 gigabajt ram. E konfigurova me "Postgres" 10.8:
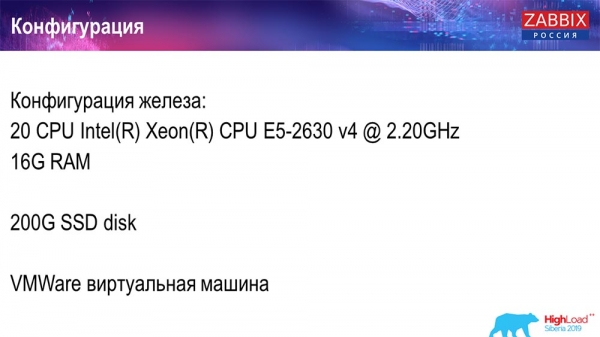
Sistemi operativ ishte Debian, sistemi i skedarëve – xfs. Bëra konfigurime minimale, për të përdorur pikërisht këtë bazë të dhënash, duke përjashtuar atë që do të përdorte vetë "Zabbix". Në këtë makinë kishte "Zabbix"-server, PostgreSQL dhe agjentë ngarkese.
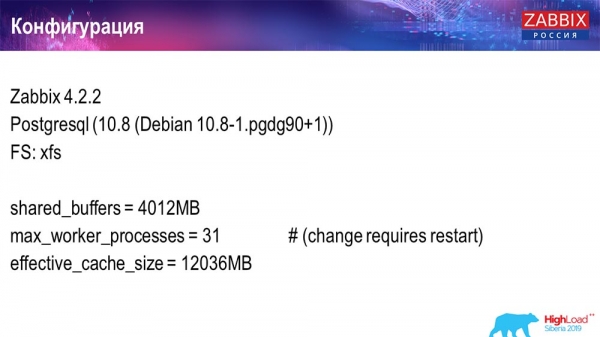
Kam përdorur 50 agjentë aktivë, të cilët përdorin LoadableModule, për të gjeneruar shpejt rezultate të ndryshme. Atyre iu gjeneruan rreshta, numra dhe kështu me radhë. E mbushja DB me një sasi të madhe të dhënash. Fillimisht, konfigurimi përmbante 5 mijë elementë të dhënash për çdo host, dhe rreth çdo element të dhënash përmbante një trigger – në mënyrë që të ishte një konfigurim real. Ndonjëherë, për përdorim kërkohet edhe më shumë se një trigger.
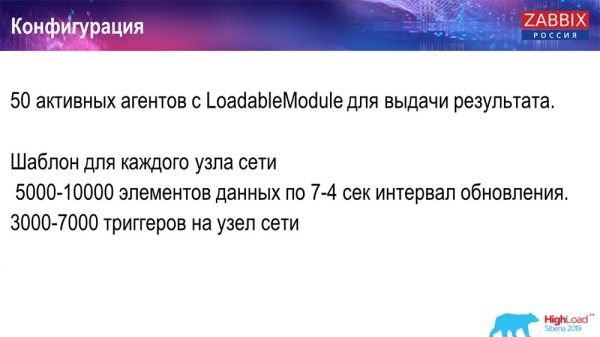
Intervali i përditësimit, ngarkesa e vetë e rregullova duke përdorur jo vetëm 50 agjentë (shtova edhe), por dhe me ndihmën e elementeve dinamike të dhënash dhe e uli intervalin e përditësimit në 4 sekonda.
Test i performancës. PostgreSQL: 36 mijë NVPs
Aktivizimi i parë, konfigurimi i parë ishte në PostgreSQL të pastër 10 në këtë hardware (35 mijë vlera në sekondë). Në përgjithësi, siç duket në ekran, futja e të dhënave merr fraksione sekondash – gjithçka është mirë dhe e shpejtë, SSD-të (200 gigabajt). E vetmja gjë është se 20 GB mbushen mjaft shpejt.
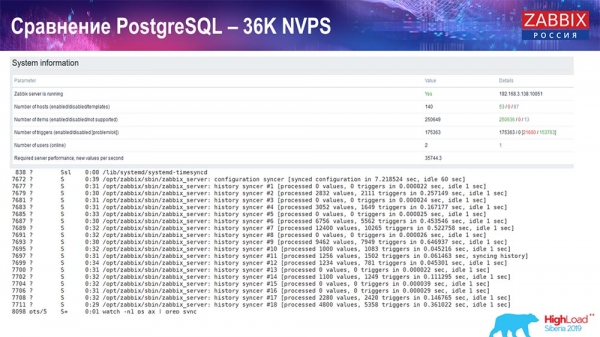
Do të ketë shumë prej këtyre grafikëve. Kjo është një dashboard standard i performancës së "Zabbix"-serverit.
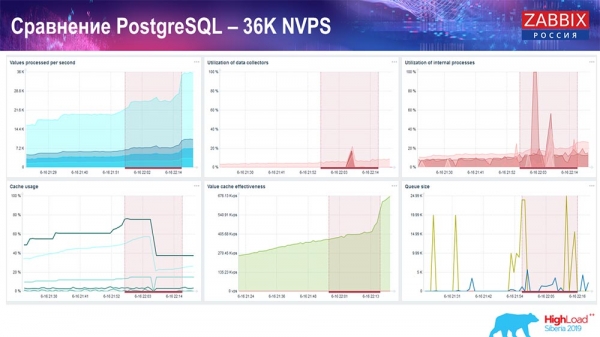
Grafiku i parë – numri i vlerave në sekondë (blu, në majtas lart), 35 mijë vlera në këtë rast. Kjo (në qendër lart) është ngarkesa e proceseve të mbledhjes, dhe kjo (në majtas djathtas) është ngarkesa e proceseve të brendshme: history syncers dhe housekeeper, të cilët këtu (në qendër poshtë) u kryen për një kohë të gjatë.
Ky kyç në qendër tregon përdorimin e ValueCache – sa goditje ValueCache për gjeneruesit (disa mijëra vlera në sekondë). Një tjetër grafik i rëndësishëm është ai i katërt (në fund të majtë), i cili tregon përdorimin e HistoryCache, për të cilin kam folur, që është një tampon para se të futet në DB.
Testi i performancës. PostgreSQL: 50 mijë NVPs
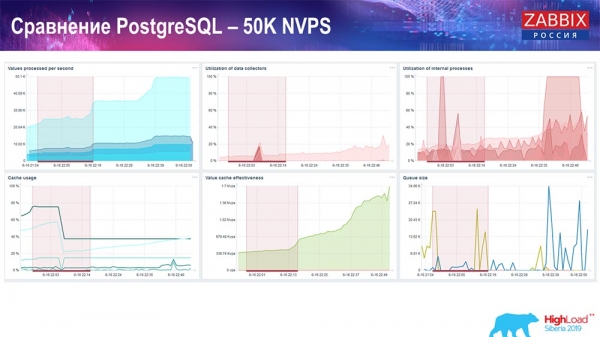
Pastaj e rita ngarkesën në 50 mijë vlera në sekondë në këtë hardware. Gjatë ngarkimit nga 'Housekeeper', 10 mijë vlera u regjistruan në 2-3 sekonda me llogaritjen. Kjo, në fakt, është e dukshme në ekranin pasues:
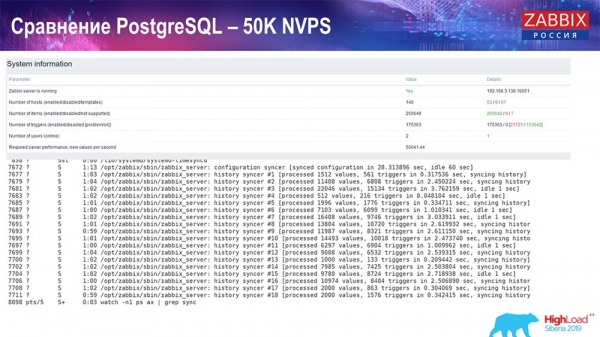
'Housekeeper' tashmë fillon të pengojë funksionimin, por në përgjithësi ngarkesa e sinkronizuesve të historisë është ende në nivelin 60 % (grafiku i tretë, në të djathtë lart). HistoryCache tashmë gjatë funksionimit të 'Housekeeper' fillon të mbushet aktivisht (në fund të majtë). Ai ishte rreth gjysmë gigabajt, mbushej me 20%.
Testi i performancës. PostgreSQL: 80 mijë NVPs
Pastaj e rita në 80 mijë vlera në sekondë:
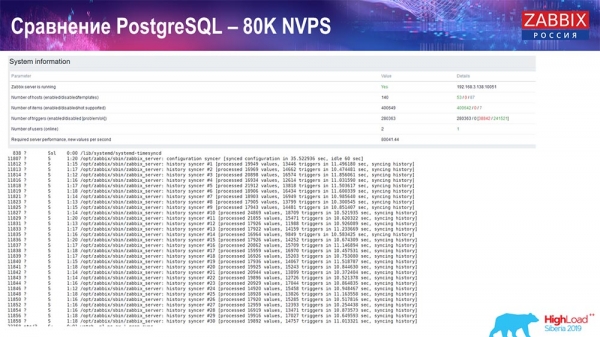
Ishte rreth 400 mijë elemente të dhënash, 280 mijë gjenerues. Regjistrimi, siç e shihni, nga ngarkesa e sinkronizuesve të historisë (të cilët ishin 30) ishte tashmë mjaft i lartë. Pastaj fillova të rita parametrat e ndryshëm: sinkronizuesit e historisë, cache… Në këtë hardware, ngarkesa e sinkronizuesve të historisë filloi të rritej në maksimum, praktikisht 'në raft' – për rrjedhojë, HistoryCache shkoi në një ngarkesë shumë të lartë:
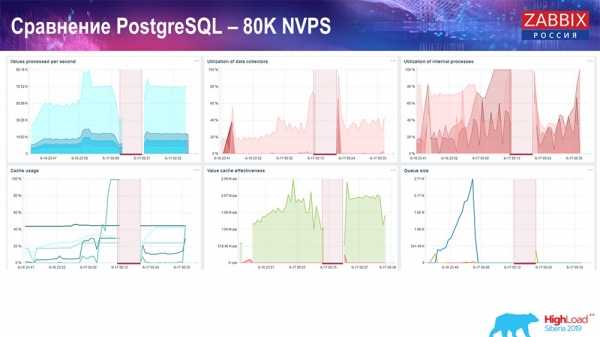
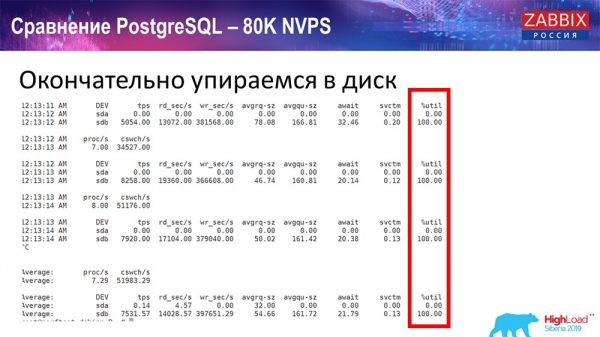
Gjatë gjithë kësaj kohe kam vëzhguar të gjithë parametrat e sistemit (si përdoret procesori, memoria e rastit) dhe zbulova se shfrytëzimi i disqeve ishte maksimal – arrita mundësinë maksimale të këtij disku në këtë hardware, në këtë makinë virtuale. 'Postgres' filloi të heqë të dhënat mjaft aktivisht me këtë intensitet, dhe disku nuk po arrinte më të regjistronte, lexonte…
Mora një server tjetër, i cili tashmë kishte 48 procesorë dhe 128 gigabajt memorie të rastit:
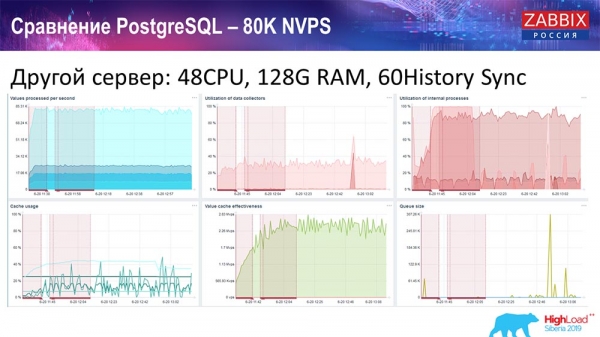
Gjithashtu e 'modifikoja' – vendosa History syncer (60 copë) dhe arrita një performancë të kënaqshme. Në fakt, ne nuk jemi 'në raft', por ndoshta kjo është tashmë kufiri i performancës, ku është e nevojshme të merret diçka në konsideratë.
Testi i performancës. TimescaleDB: 80 mijë NVPs
Ishte qëllimi im kryesor – të përdorja TimescaleDB. Në çdo grafik është e dukshme një rënie:
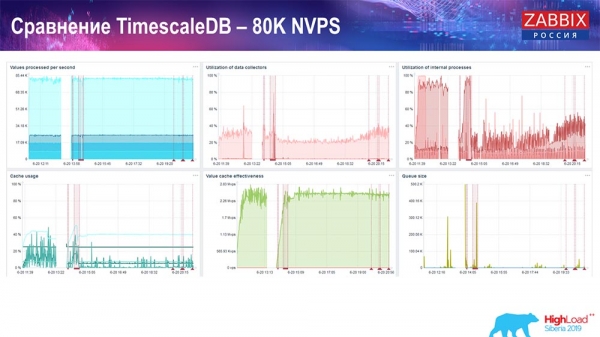
Këto dështime janë pikërisht migrimi i të dhënave. Pas kësaj, në serverin "Zabbix", profili i ngarkesës së historianëve është ndryshuar ndjeshëm, siç e shihni, ai lejon të futen të dhënat gati 3 herë më shpejt dhe përdor më pak HistoryCache – përgjithësisht, të dhënat do të dërgohen në kohë. Edhe një herë, 80 mijë vlera në sekondë – është një ritëm mjaft i lartë (sigurisht, jo për "Yandex"). Në tërësi, është një setup mjaft i madh, me një server.
Testi i performancës PostgreSQL: 120 mijë NVPs
Më pas e rita vlerën e numrit të elementeve të dhënash deri në gjysmë milioni dhe arrita një vlerë të kalkuluar prej 125 mijë në sekondë:
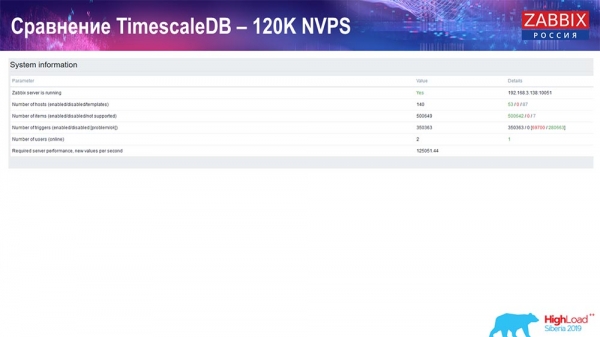
Dhe mora këto grafika:
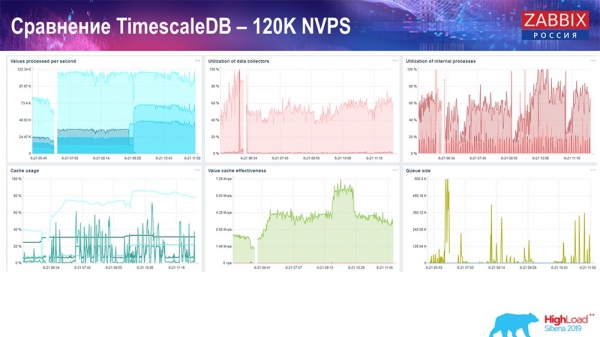
Praktikisht, ky është një setup funksional, ai mund të punojë për një kohë të gjatë. Por pasi kisha një disk prej vetëm 1.5 terabajtësh, e shpenzova atë për disa ditë. Më e rëndësishmja, në të njëjtën kohë, u krijuan partitë e reja në TimescaleDB, dhe kjo për performancën kaloi krejtësisht pa u vënë re, gjë që nuk mund të thuhet për MySQL.
Zakonisht partitë krijohen natën, sepse kjo ndalon gjithçka sa i përket futjes dhe punës me tabelat, dhe mund të çojë në degradimin e shërbimit. Në këtë rast, kjo nuk ndodhi! Detyra kryesore ishte të provonim mundësitë e TimescaleDB. U arrit një numër i tillë: 120 mijë vlera në sekondë.
Gjithashtu ka në komunitet shembuj:
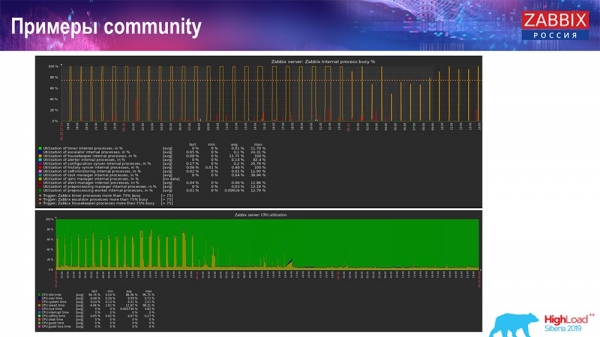
Një person gjithashtu aktivizoi TimescaleDB dhe ngarkesa në përdorimin e io.weight ra në procesor; dhe përdorimi i elementeve të proceseve të brendshme gjithashtu ra falë aktivizimit të TimescaleDB. Dhe blloqet janë blloqe të zakonshme, pra një virtualizues i zakonshëm në blloqet e zakonshme (jo SSD)!
Për ndonjë setup të vogël, që hasin në performancën e disku, TimescaleDB, siç mendoj, është një zgjidhje shumë e mirë. Ai do të lejojë të vazhdoj punën deri sa të migroj në pajisje më të shpejta për databazën.
Ftoj të gjithëve në ngjarjet tona: Konferenca - në Moskë, Samiti - në Rigë. Përdorni kanalet tona - "Telegram", forum, IRC. Nëse keni ndonjë pyetje - vini të flasim me ne në stendë, mund të diskutojmë për gjithçka.
Pyetjet e publikut
Pyetja e publikut (më vonë – P): – Nëse TimescaleDB është kaq e lehtë për t'u konfiguruar dhe ofron një rritje të tillë të performancës, ndoshta duhet ta përdorim si një praktikë të mirë për konfigurimin e «Zabbix» me «PostgreSQL»? A ka ndonjë pengesë ose disavantazh në këtë zgjidhje, apo vallë, nëse vendosa të përdor «Zabbix», mund të marr «PostgreSQL», ta instaloj «Timescale» menjëherë dhe ta shfrytëzoj pa u shqetësuar për ndonjë problem?
AG: – Po, do të thosha se kjo është një rekomandim i mirë: të përdorni «PostgreSQL» menjëherë me zgjerimin TimescaleDB. Siç kam thënë, ka shumë komente të mira, ndonëse kjo «veçori» është eksperimentale. Por në të vërtetë, testet tregojnë se kjo është një zgjidhje e shkëlqyer (me TimescaleDB), dhe mendoj se do të zhvillohet! Ne po ndjekim se si po zhvillohet kjo zgjerim dhe do të rregullojmë atë që nevojitet.
Gjatë zhvillimit ne u mbështetëm në një nga «veçoritë» e tyre të njohura: atje mund të punonit pak ndryshe me çunkat. Por pastaj ata e hoqën atë në versionin e ardhshëm dhe na duhej të mos mbështeteshim në atë kod. Do të rekomandoja ta përdornit këtë zgjidhje në shumë sete. Nëse po përdorni MySQL... Për sete të mesme çdo zgjidhje funksionon mirë.
P: – Në graphët e fundit nga komuniteti, kishte një grafik me «Housekeeperin»:
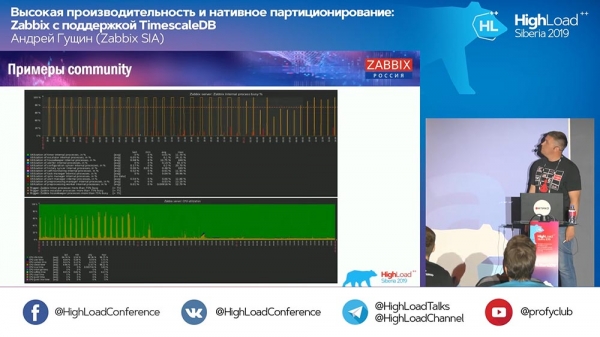
Ai vazhdoi të punonte. Çfarë bën «Housekeeperi» në rastin e TimescaleDB?
AG: – Tani nuk mund të them saktësisht – do ta shikoj kodin dhe do të them më në detaje. Ai përdor kërkesat e TimescaleDB jo për të fshirë çunkat, por siç duket agregon. Deri tani nuk jam i gatshëm të përgjigjem për këtë pyetje teknike. Në stendë sot ose nesër do të sqarojmë.
P: – Kam një pyetje të ngjashme – për performancën e operacionit të fshirjes në «Timescale».
P (përgjigja e publikut): – Kur fshini të dhëna nga tabela, nëse e bëni këtë përmes fshirjes, duhet të kaloni përmes tabelës – të fshini, pastroni, të shënoni gjithçka për vakuumin e ardhshëm. Në «Timescale», pasi keni çunka, mund të hiqni. Në thelb, thjesht i thoni skedarit që ndodhet në big data: «Fshi!»
«TimeScale» simply understands that this chunk no longer exists. Since it integrates into the query planner, it captures your conditions in the select or other operations and immediately realizes that this chunk is gone – «I will not go there anymore!» (data unavailable). That's it! This means that scanning the table is replaced by deleting the binary file, so it's fast.
P: – We've touched on the non-SQL topic already. As far as I understand, «Zabbix» doesn’t really need to modify data, and all this is more like a log. Can we use specialized databases that can't change their data but can save, accumulate, and retrieve much faster – something like ClickHouse or something Kafka-like?.. Kafka is also a log! Can we somehow integrate them?
AG: – You can perform an export. We have a specific feature since version 3.4: you can write all historical files, events, and everything else to files; and then send them to any other database with some handler. In fact, many people redo and write directly to the database. Historical syncers write all this to files on the fly, rotate these files, etc., and you can transfer them into «ClickHouse». I can't comment on future plans, but perhaps further support for NoSQL solutions (like «ClickHouse») will continue.
P: – So, is it possible to completely eliminate Postgres?
AG: – Of course, the most challenging part in «Zabbix» is the historical tables, which create the most problems, along with the events. In this case, if you don’t keep events for a long time and store history with trends in some other fast storage, then overall there shouldn’t be any issues, I believe.
P: – Can you estimate how much faster everything will work if we switch to «ClickHouse», for example?
AG: – I haven't tested it. I think, at the very least, similar numbers can be achieved quite easily, considering that «ClickHouse» has its own interface, but I can't say for sure. It's better to test. Everything depends on the configuration: how many hosts you have, and so on. Insertion is one thing, but you also need to retrieve this data – with Grafana or something else.
P: – So, it's about an equal competition, not a significant advantage for these fast databases?
AG: – I think when we integrate, we will have more accurate tests.
P: – Po shkuan ato RRD-të e vjetra të mira? Çfarë e detyroi kalimin në bazat e të dhënave SQL? Fillimisht, të gjitha metrikat mblidheshin në RRD.
AG: – Në 'Zabbix', RRD mund të ketë qenë në një version shumë të vjetër. Gjithmonë kanë qenë bazat e të dhënave SQL – një qasje klasike. Qasja klasike është MySQL, PostgreSQL (janë ekzistuar shumë kohë më parë). Ne ndoshta kurrë nuk e kemi përdorur një ndërfaqe të përbashkët për bazat e të dhënave SQL dhe RRD.

Pak reklamë 🙂
Faleminderit që po qëndroni me ne. Ju pëlqen artikujt tanë? Doni të shihni më shumë materiale interesante? Na mbështesni duke bërë një porosi ose duke rekomanduar tek miqtë tuaj, , një analog unik i serverëve entry-level që e kemi shpikur për Ju: (opcionet me RAID1 dhe RAID10, deri në 24 bërthama dhe deri në 40GB DDR4 janë të disponueshme).
Dell R730xd dyfish më i lirë në qendër të të dhënave Equinix Tier IV në Amsterdam? Vetëm te ne në Holandë! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — nga $99! Lexoni rreth
Burimi: habr.com
