

Konferenca e ardhshme HighLoad++ do të mbahet më 6 dhe 7 prill 2020 në Shën Petersburg.
Detajet dhe biletat . HighLoad++ Siberia 2019. Salla "Krasnoyarsk". 25 qershor, 12:00. Thesaret dhe .
Ndonjëherë kërkesat praktike bien në kontradiktë me teorinë, ku aspekte të rëndësishme për një produkt komercial nuk kanë qenë të marrë parasysh. Në këtë referat paraqitet procesi i zgjedhjes dhe kombinimit të qasjeve të ndryshme për të krijuar komponentë Causal consistency në bazë të kërkimeve akademike në përputhje me kërkesat e produktit komercial. Dëgjuesit do të mësojnë për qasjet teorike ekzistuese ndaj logical clocks, ndjekjes së varësive, sigurisë së sistemit, sinkronizimit të orës dhe pse MongoDB zgjodhi zgjidhje të caktuara.
Mikhail Tyulenev (më tutje – MT): – Unë do të flas për Causal consistency – është një veçori mbi të cilën ne kemi punuar në MongoDB. Punoj në grupin e sistemeve të shpërndara, e kemi zhvilluar rreth dy vjet më parë.
Në proces, duhet të njihem me një numër të madh të Kërkimeve akademike, sepse kjo veçori është studiuar mjaft mirë. Doli se asnjë artikull nuk i përmbush kërkesat për prodhim, për shkak të kërkesave shumë specifike që ndoshta ka në çdo aplikacion në prodhim.
Unë do të flas për mënyrën se si ne, si konsumatorë të Kërkimeve akademike, përgatisim diçka të tillë, të cilën ne mund ta ofrojmë si një pjatë të gatshme, me të cilën është e lehtë dhe e sigurt të punohet.
Konsistenca e arsyeshme (Causal consistency). Le të sqarojmë konceptet
Për fillim, dua të flas në terma të përgjithshëm për çfarë është Causal consistency. Ka dy personazhe – Leonard dhe Penny (seriali "Teoria e Big Bangut"):
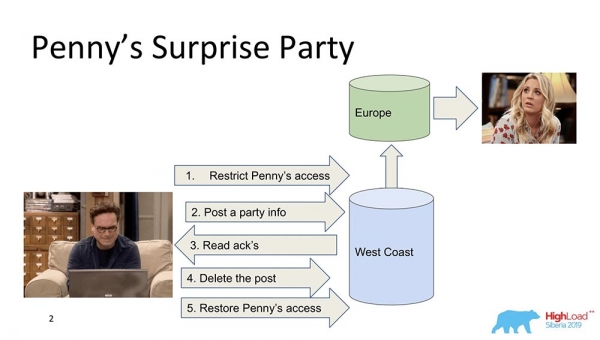
Supozoni se Penny është në Evropë, ndërsa Leonard dëshiron t'i bëjë një befasi, një festë. Dhe ai nuk mendon asgjë më të mirë se të heqë nga lista e miqve, të dërgojë një azhurnim të të gjithë miqve në feed: "Le të befasojmë Penny-n!" (ajo është në Evropë, duke fjetur, nuk e sheh asgjë dhe nuk mund ta shohë, sepse nuk është aty). Në fund, ai fshin këtë postim, e fshin nga "Feed" dhe rivendos aksesin, që ajo të mos e vërejë dhe të mos ndodhi ndonjë skandal.
Kjo është e shkëlqyer, por le të supozojmë se sistemi është i shpërndarë dhe ngjarjet nuk shkuan siç duhet. Mund të ndodhë, për shembull, që kufizimi i aksesit të ndodhë pas publikimit të këtij posti, nëse ngjarjet nuk janë të lidhura me njëra-tjetrën në lidhje shkak-pasojë. Në fakt, ky është një shembull se si është e nevojshme që të ketë Konsistencë Shkakësore për të përmbushur një funksion biznesi (në këtë rast).
Në të vërtetë, këto janë pronësi mjaft jokonvencionale të bazave të të dhënave – shumë pak prej tyre i mbështesin ato. Le të kalojmë te modelet.
Modelet e Konsistencës (Consistency Models)
Çfarë është model konsistence në bazat e të dhënave? Këto janë disa garanci që sistemi i shpërndarë jep rreth asaj se cilat të dhëna dhe në cilën radhë mund të marrë klienti.
Në parim, të gjitha modelet e konsistencës janë përmbledhje në atë masë sa sistemi i shpërndarë përputhet me një sistem që operon, për shembull, në një nod të vetëm në laptop. Dhe sa më shumë që një sistem që funksionon në mijëra 'Nodë' të shpërndara të ngjajë me laptopin, në të cilin të gjitha këto pronësi përmbushen në mënyrë automatike.
Prandaj, modelet e konsistencës aplikohen vetëm për sistemet e shpërndara. Të gjitha sistemet që kanë ekzistuar më parë dhe kanë funksionuar me një shkallëzim të vertikalizuar, nuk kanë hasur në këto probleme. Aty kishte një Buffer Cache, dhe nga ai gjithmonë është lexuar.
Modeli i Fortë
Në fakt, modeli i parë është modeli i Fortë (ose linja e rritjes, siç quhet shpesh). Ky është një model konsistence që garanton se çdo ndryshim, sapo merr konfirmimin se ka ndodhur, bëhet i dukshëm për të gjithë përdoruesit e sistemit.
Kjo krijon një rend global të të gjitha ngjarjeve në DB. Ky është një pronësi shumë e fortë e konsistencës, dhe është gjithashtu shumë e shtrenjtë. Megjithatë, ajo mbështetet shumë mirë. Thjesht është shumë e shtrenjtë dhe e ngadaltë – prandaj përdoret rrallë. Kjo quhet rritje.
Ka një pronësi tjetër, më të fortë, që mbështetet në 'Spanner' – quhet Konsistenca Eksterne. Do të flasim për të më vonë.
Konsistente Shkakësore
Të ardhshme është Causal, pikërisht ajo për të cilën po flisja. Ndërmjet Strong dhe Causal ekzistojnë disa nënnivelesh të tjera, për të cilat nuk do të flas, por gjithçka përfundon në Causal. Ky është një model i rëndësishëm, sepse është modeli më i fortë nga të gjitha modelet, koherenca më e fortë në praninë e rrjetit ose ndarjeve.
Causals janë situata në të cilat ngjarjet janë të lidhura me njëra-tjetrën për shkak të shkakut. Shpesh perceptohen si Read your on rights nga këndvështrimi i klientit. Nëse klienti ka vërejtur disa vlera, ai nuk mund të shohë vlerat që ishin në të kaluarën. Ai tashmë fillon të shohë leximet prefikse. Të gjithë ata përfundojnë në të njëjtën gjë.
Causals si model koherencë janë nje renditje e pjesshme e ngjarjeve në server, ku ngjarjet nga të gjithë klientët vërehen në të njëjtën renditje. Në këtë rast – Leonard dhe Penny.
Eventual
Modeli i tretë është Eventual Consistency. Ky është modeli që mbështetet nga të gjitha sistemet e shpërndara, model minimal që ka ndonjë kuptim. Ai nënkupton se: kur ndodhin disa ndryshime në të dhëna, ato në një moment bëhen koherente.
Në atë moment, ai nuk thotë asgjë, përndryshe do të kthehej në External Consistency – do të ishte një histori krejt tjetër. Megjithatë, ky është një model shumë popullor, modeli më i përhapur. Në parazgjedhje, të gjithë përdoruesit e sistemeve të shpërndara përdorin pikërisht Eventual Consistency.
Dua të jap disa shembuj krahasues:
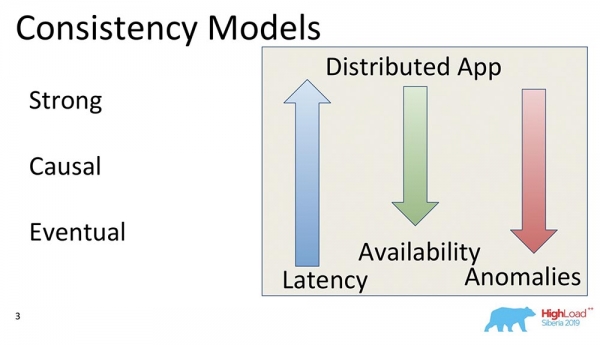
Çfarë do të thonë këto shigjeta?
- Latency. Me rritjen e forcës së koherencës, ajo bëhet më e madhe për arsye të qarta: nevojitet të bëhen më shumë shkronja, të marrim konfirmimin nga të gjithë hostet dhe nodet që marrin pjesë në klaster, që të dhënat të ekzistojnë atje. Si pasojë, në Eventual Consistency përgjigja më e shpejtë, sepse zakonisht mund të komitet në memory dhe kjo do të ishte mjaft e mjaftueshme.
- Availability. Nëse e kuptojmë këtë si mundësi të sistemit për të përgjigjur në prani të ndërprerjeve të rrjetit, ndarjeve, ose ndonjë dështimi – qëndrueshmëria rritet me zvogëlimin e modelit të koherencës, për shkak se na mjafton që një host të jetë aktiv dhe të ofrojë disa të dhëna. Eventual Consistency në fakt nuk garanton asgjë në lidhje me të dhënat – mund të jetë gjithçka.
- Anomalies. Natyrisht, numri i anomali-ve rritet. Në Strong Consistency, ato në të vërtetë nuk duhet të ekzistojnë, ndërsa në Eventual Consistency ato mund të jenë çfarëdo. Kjo ngre pyetjen: pse njerëzit zgjedhin Eventual Consistency, nëse ajo përmban anomali? Përgjigja qëndron në faktin se modelet e Eventual Consistency janë të aplikueshme, dhe anomali ekzistojnë, për shembull, për një periudhe të shkurtër kohore; ka mundësinë të përdorësh master për të lexuar dhe për të lexuar të dhëna relativisht konsistente; shpesh ka mundësi të përdorësh modele të forta konsistence. Në praktikë, kjo funksionon, dhe zakonisht numri i anomali-ve është i kufizuar në kohë.
Teorema CAP
Kur ju shihni fjalët konsistencë, disponueshmëri – çfarë ju vjen në mend? E drejta – teorema CAP! Unë tani dua të shpërthej mitin… Nuk jam unë – është Martin Kleppmann, i cili shkroi një artikull të shkëlqyer, një libër të shkëlqyer.
Teorema CAP është një parim i formuluar në vitet 2000, që thotë se Konsistenca, Disponueshmëria, Ndarjet: merrni çdo dy, dhe nuk mund të zgjidhni tre. Ky ishte një parim i caktuar. Ai u provua si një teorem disa vite më vonë, nga Gilbert dhe Lynch. Pastaj kjo filloi të përdorej si një mantrë – sistemi filluan të ndahen në CA, CP, AP dhe kështu me radhë.
Kjo teoremë u provua në të vërtetë për këto raste… Së pari, Disponueshmëria nuk u shqyrtua si një vlerë e pandërprerë nga zero deri në njëqind (0 – sistemi ‘i vdekur’, 100 – përgjigjet shpejt; kështu e kemi zakonisht), por si një pronë e algoritmit që garanton se në të gjitha ekzekutimet e tij kthehet të dhëna.
Për kohën e përgjigjes atje nuk ka asnjë fjalë! Ka një algoritëm që kthen të dhëna pas 100 vjetësh – një algoritëm perfekt të disponueshëm, që është pjesë e teoremës CAP.
E dyta: teorema u provua për ndryshime në vlerat e të njëjtit çelës, përveç se këto ndryshime ishin një linjë të ripërshtatshme. Kjo do të thotë se ato në të vërtetë nuk përdoren shumë, për shkak se modelet e tjera janë Eventual Consistency, Strong Consistency (ndoshta).
Për çfarë është e gjitha kjo? Për faktin se teorema CAP, në formën në të cilën është provuar, është praktikisht e paprakteshme, ndodhet rrallë në përdorim. Në formën teorike ajo në njëfarë mënyre kufizon gjithçka. Kështu del një parim që është intuitivisht i saktë, por nuk është, në përgjithësi, provuar.
Konsistenca shkakësore – modeli më i fortë
Ajo që po ndodh tani është se mund të merrni tre gjëra: Konsistencë, Disponueshmëri, që mund të arrihen përmes Particioneve. Në veçanti, konsistenca shkakësore – modeli më i fortë i konsistencës, i cili megjithatë funksionon në prani të Particioneve (ndarjeve në rrjet). Prandaj, ajo përfaqëson një interes kaq të madh dhe prandaj merremi me të.
Së pari, ajo thjeshton punën e zhvilluesve të aplikacioneve. Në veçanti, ekzistenca e një mbështetje të madhe nga serveri: kur të gjitha regjistrimet që ndodhin brenda një klienti, garantohen se do të arrijnë në atë rend të njëjtë në një klient tjetër. Së dyti, ajo përballon ndarjet.
Kuzhina e brendshme e MongoDB
Duke mbajtur parasysh se është drekë, ne po kalojmë në kuzhinë. Do të flas për modelin e sistemit, pra – çfarë është MongoDB për ata që dëgjojnë për këtë bazë të dhënash për herë të parë.
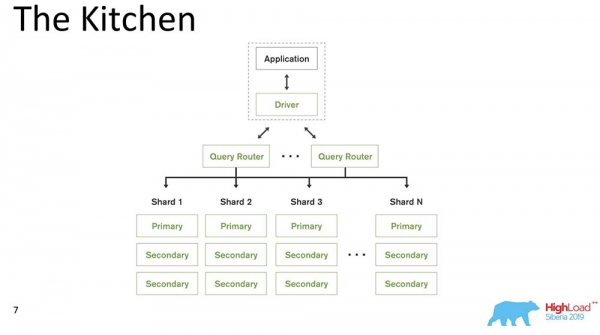
MongoDB (më tej – "MongoDB") është një sistem i shpërndarë, i cili mbështet shkallëzimin horizontal, dmth sharding; dhe brenda çdo shardi, gjithashtu mbështet redundantësin e të dhënave, pra replikimin.
Shardimi në "MongoDB" (jo një DB relationale) kryen balancimin automatik, domethënë çdo koleksion dokumentesh (ose "tabel" në terminologjinë e të dhënave relationale) ndahet në copa, dhe serveri automatikisht i lëviz ato midis shardeve.
Query Router, i cili shpërndan kërkesat, për klientin është një lloj klienti, përmes të cilit ai punon. Ai tashmë e di se ku dhe cilat të dhëna ndodhen, dhe drejton të gjitha kërkesat në shardin e duhur.
Një aspekt tjetër i rëndësishëm: MongoDB është një master i vetëm. Ka një Primar – ai mund të marrë regjistrimet që mbështesin ato çelësa që ai ka në vetvete. Nuk mund të bëhet shkrim shumë-master.
Ne lëshuam versionin 4.2 – aty janë shfaqur gjëra të reja interesante. Në veçanti, vendosëm Lucene – kërkimin – pikërisht java ekzekutues direkt në "Mongo", dhe tani është e mundur të bëhet kërkimi përmes Lucene, ashtu si në "Elasticsearch".
Dhe bëmë një produkt të ri – Charts, ai është gjithashtu i disponueshëm në "Atlas" (Cloud-i ynë "Mongo"). Ata kanë një Tier Falas – mund të luani me këtë. Charts më pëlqeu shumë – vizualizimi i të dhënave, shumë intuitiv.
Përbërësit e konsistencës shkakësore
Kam numëruar rreth 230 artikuj, që janë publikuar mbi këtë temë – nga Leslie Lamport. Tani, nga kujtesa ime, do t'ju sjell disa pjesë të këtyre materialeve.
E gjithëçka filloi me një artikull të Leslie Lampert, i shkruar në vitet 1970. Siç e shihni, ende vazhdojnë disa kërkime mbi këtë temë. Tani, konsistenca shkaku ka tërhequr interesin e zhvillimit të sistemeve të shpërndara.
Kufizimet
Çfarë kufizimesh ekzistojnë? Në të vërtetë, kjo është një nga çështjet kryesore, sepse kufizimet që vendosin sistemet e prodhimit ndahen shumë nga ato kufizime që ekzistojnë në artikujt akademikë. Shpesh ato janë mjaft artificiale.
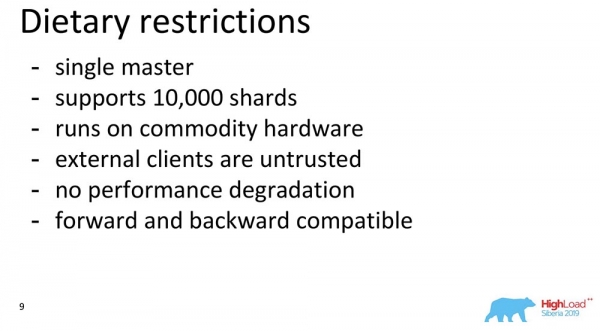
- Së pari, 'MongoDB' është një master i vetëm, siç e thashë më parë (kjo e thjeshton shumë).
- Ne besojmë se sistemi duhet të mbështesë afërsisht 10,000 sharde. Nuk mund të marrim vendime arkitektonike që do të kufizonin qartë këtë vlerë.
- Kemi një mjegull, por supozojmë se një person duhet të ketë mundësinë që kur të shkarkon binary, ta ekzekutojë në laptopin e tij dhe gjithçka të funksionojë mirë.
- Ne supozojmë atë që në kërkim përdoret rrallë: klientët e jashtëm mund të bëjnë çfarëdo. 'MongoDB' është open source. Prandaj, klientët mund të jenë kaq të zgjuar, të lig, – mund të duan të thyejnë gjithçka. Ne supozojmë se mund të ndodhin defekte bizantine.
- Për klientët e jashtëm, që janë jashtë perimetrit – një kufizim i rëndësishëm: nëse kjo veçori është e çaktivizuar, nuk duhet të ketë asnjë degradim të performancës.
- Një tjetër çështje – krejtësisht antiakademike: përputhshmëria e versioneve të mëparshme dhe ato të ardhshme. Shqerëzuesit e vjetër duhet të përballojnë përditësimet e reja, dhe DB duhet të mbështesë shqerëzuesit e vjetër.
Në përgjithësi, gjithë kjo vendos kufizime.
Komponentët e Konsistencës Shkaku
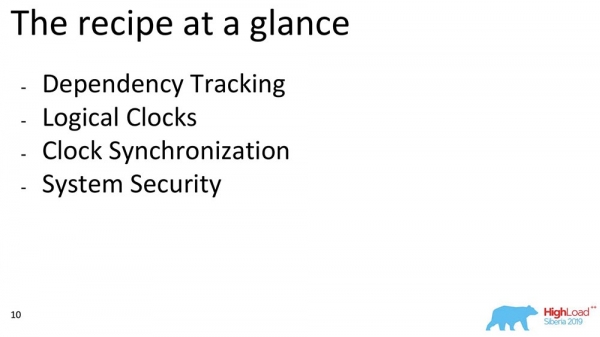
Tani do të flas për disa komponente. Nëse e shqyrtojmë përgjithësisht Konsistencën Shkaku, mund të veçojmë blloqet. Ne zgjodhëm nga punët që përfshihen në një bllok: Ndjekja e Varësive, zgjedhja e orëve, si mund të sinkronizohen këto orë me njëra-tjetrën, dhe si ne sigurojmë sigurinë – ky është një plan i përgjithshëm për atë që do të flasë:
Ndjekja e Plotë e Varësive (Full Dependency Tracking)
Pse është e nevojshme? Për të siguruar që kur të dhënat replikohen – çdo regjistër, çdo ndryshim i të dhënave përmban informacione rreth ndryshimeve nga të cilat varet. Ndryshimi i parë dhe më naïv është kur çdo mesazh që përmban një regjistër ka informacion mbi mesazhet e mëparshme:
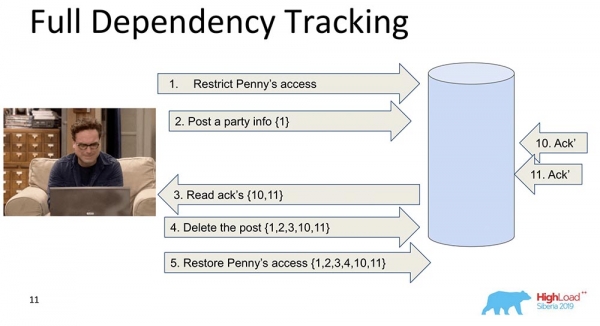
Në këtë shembull, numri në kllapa kaq – janë numrat e regjistrave. Ndonjëherë këto regjistra me vlera kalojnë tërësisht, ndonjëherë përçohen disa versione. Ndërsa qëllimi është që çdo ndryshim përmban informacione për të mëparshmet (e sjell këtë në vetvete).
Pse vendosëm të mos përdorim një qasje të tillë (ndjekje e plotë)? Qartë, sepse kjo qasje është e paprakti: çdo ndryshim në rrjetin social varet nga të gjitha ndryshimet e mëparshme në atë rrjet social, duke e përçuar, të themi, «Facebook» ose «Vkontakte» në çdo përditësim. Megjithatë, ka shumë studime mbi ndjekjen e plotë të varësive – këto janë para rrjeteve sociale, në disa situata kjo vërtet funksionon.
Ndjekja e qartë e varësive (Explicit Dependency Tracking)
Tjetra – një qasje më e kufizuar. Këtu shqyrtohet gjithashtu transfertën e informacionit, por vetëm atë që varet qartë. Çfarë varet nga çfarë, zakonisht përcaktohet nga Aplikacioni. Kur të dhënat replikohen, përgjigjet jepen vetëm kur varësitë e mëparshme janë përmbushur, dmth. janë treguar. Kjo është mënyra se si funksionon konsistenca e shkaktuar.
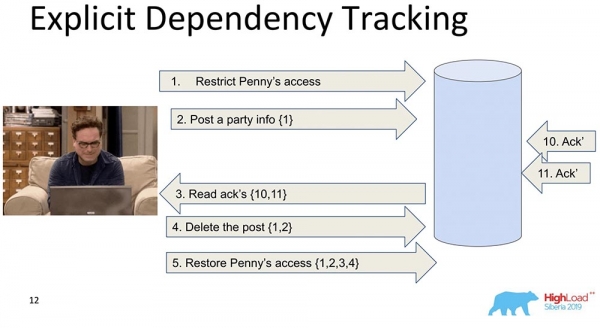
Ajo sheh se regjistri 5 varet nga regjistrat 1, 2, 3, 4 – përkatësisht, ajo pret, përpara se klienti të ketë qasje në ndryshimet e bëra nga vendimi i aksesit të Penny, kur të gjitha ndryshimet e mëparshme kanë kaluar në bazën e të dhënave.
Kjo gjithashtu nuk na kënaq, sepse informatat janë shumë dhe do të ngadalësojnë procesin. Ka një qasje tjetër…
Orët e Lamportit (Lamport Clock)
Ato janë shumë të vjetra. Lamport Clock nënkupton se këto varësi shuhen në një funksion skalar, i cili quhet Lamport Clock.
Funksioni skalar është një numër abstrakt. Shpesh e quajnë kohë logjike. Çdo herë që ndodh një ngjarje, ky counter rritet. Counter, i njohur tani nga procesi, dërgon çdo mesazh. Është e qartë se proceset mund të jenë jashtë sinkronizimit, ato mund të kenë kohë krejt të ndryshme. Megjithatë, me këtë shkëmbim mesazhesh, sistemi njëfarësoj balancion orët. Çfarë ndodh në këtë rast?
E ndava atë shard të madh në dy pjesë, që të ishte e qartë: Friends mund të jetojnë në një node, që përmban një copë koleksioni, ndërsa Feed – në një node tjetër, që përmban një copë të këtij koleksioni. A është e qartë se si ata mund të mos shkojnë në radhë? Fillimisht Feed do të thotë: 'U riplikua', dhe më pas – Friends. Nëse sistemi nuk ofron ndonjë garanci që Feed nuk do të tregojë deri sa varësitë e Friends në koleksionin Friends të jenë gjithashtu të dorëzuara, atëherë do të kemi pikërisht situatën që përmenda.
Ju shihni si rritet logjikisht koha e counter në Feed:
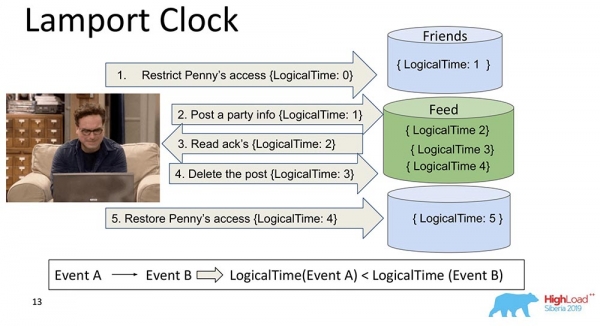
Kështu, prona kryesore e këtij Lamport Clock dhe Causal consistency (të shpjeguar përmes Lamport Clock) qëndron në këtë: nëse kemi ngjarjet A dhe B, dhe ngjarja B varet nga ngjarja A *, atëherë rrjedhimisht LogicalTime e Ngjarjes A është më e vogël se LogicalTime e Ngjarjes B.
* Ndonjëherë thuhet gjithashtu se A ndodhi para B, që do të thotë se A ndodhi më parë se B – ky është një marrëdhënie që pjesërisht rendit tërë grumbullin e ngjarjeve që kanë ndodhur ndonjëherë.
E kundërta nuk është e vërtetë. Kjo në të vërtetë është një ndër disavantazhet kryesore të Lamport Clock – rendi pjesor. Ka konceptin e ngjarjeve të njëkohshme, që do të thotë ngjarje, në të cilat as (A ndodhi para B), as (A ndodhi pas B). Një shembull mund të jetë shtimi paralel i Leonardit si mik të dikujt tjetër (edhe jo Leonardit, por Sheldonit, për shembull).
Ky është edhe atributi që shpesh përdoret gjatë punës me orët Lamport: shikoni pikërisht në funksion dhe nga kjo nxjerrin përfundimin – ndoshta këto ngjarje janë të varura. Sepse në një drejtim është e vërtetë: nëse LogicalTime A është më e vogël se LogicalTime B, atëherë B nuk mund të ndodhi para A; ndërsa nëse është më e madhe, atëherë mund të jetë.
Orët vektoriale (Vector Clock)
Zhvillimi logjik i orëve Lamport është Orët Vektoriale. Ato dallojnë nga fakti që çdo node këtu ka orët e veta, të veçanta, dhe ato transmetohen si një vektor.
Në këtë rast, ju shihni se indeksi zero i vektorit i përgjigjet Feed-it, ndërsa indeksi i parë i vektorit – miqve (çdo një nga këto noda). Dhe tani ato do të rriten: indeksi zero i "Feed" rritet në regjistrim – 1, 2, 3:
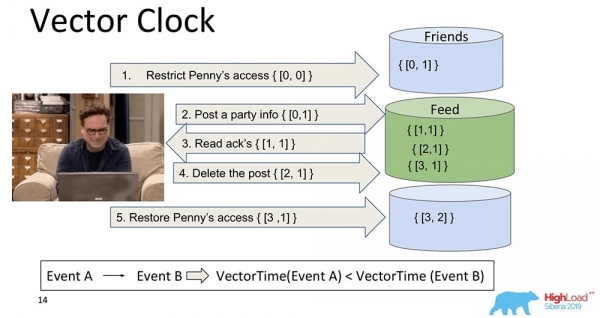
Pse janë më të mira orët vektoriale? Ato lejojnë të kuptoni se cilat ngjarje ndodhin njëkohësisht dhe kur ndodhin në nodat e ndryshëm. Kjo është shumë e rëndësishme për sistemin e sharding, si "MongoDB". Megjithatë, ne nuk e zgjodhëm këtë, megjithëse është një gjë e shkëlqyer dhe punon shumë mirë, dhe do na ishte ndoshta e përshtatshme...
Nëse kemi 10 mijë shard-e, nuk mund të transferojmë 10 mijë komponentë, edhe nëse i kompresojmë, ende do të jemi më të ulët në kapacitetin e mbetjeve, se sa është volumi i të gjithë këtij vektori. Pra, me dhimbje në zemër dhe me dhëmbë, ne e hodhëm këtë qasje dhe kaluam në një tjetër.
Spanner TrueTime. Orë atomike
Kam thënë se do të flas për "Spanner". Kjo është diçka e mrekullueshme, e vërtetë e shekullit të 21: orë atomike, sinkronizim GPS.
Cila është ideja? "Spanner" është një sistem i Google-it, i cili kohët e fundit u bë i disponueshëm për njerëzit (ata i shtuan SQL). Çdo transaksion atje ka një timestamp të caktuar. Pavarësisht se koha është e sinkronizuar*, çdo ngjarje mund t'i caktohet një kohë e caktuar – orët atomike kanë një kohë pritjeje, pas së cilës garanton që "ndodh" një kohë tjetër.
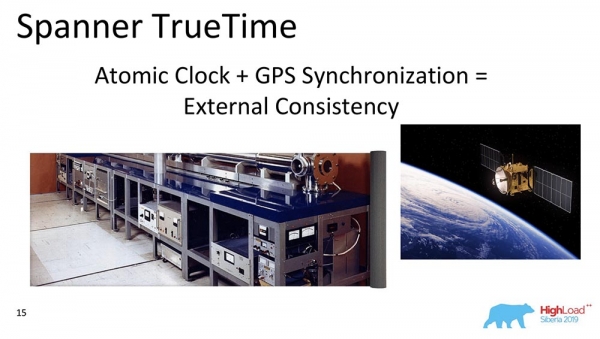
Kështu, thjesht duke regjistruar në DB dhe duke pritur një periudhë të caktuar kohore, automatike garanton Serializability të ngjarjes. Ata kanë modelin më të fortë të Consistency që mund të imagjinohet – ajo është External Consistency.
* Kjo është problemi kryesor i orëve të Lampard-it – ato kurrë nuk janë të sinkronizuara në sistemet e shpërndara. Ato mund të shpërndahen, edhe me praninë e NTP, ato nuk funksionojnë shumë mirë. "Spanner" ka orë atomike dhe sinkronizim, duket se deri në mikrosekonda.
Pse ne nuk e zgjodhëm? Ne nuk supozojmë se përdoruesit tanë kanë orë atomike të integruara. Kur ato të jenë të integruara në çdo laptop, do të ketë një sinkronizim super të mrekullueshëm GPS – atëherë po… Por për momentin, gjëja më e mirë që është e mundur – është "Amazon", Base Stations – për fanatikët... Prandaj ne përdorëm orë të tjera.
Orë hibride (Hybrid Clock)
Kjo është, në thelb, ajo që shkakton "MongoDB" të ofrojë konsistencë të rastësishme. Si janë të përziera? Hibridi është një vlerë skalarike, por përbëhet nga dy komponente:
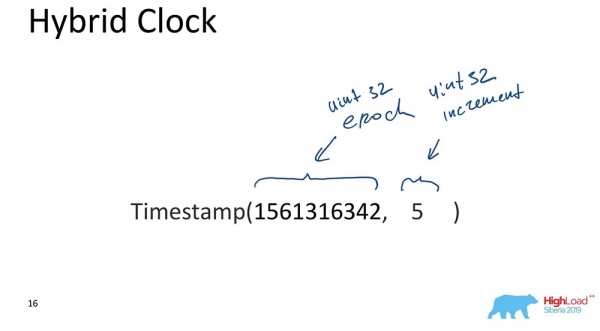
- E para është epoka unixiane (sa sekonda kanë kaluar nga "fillimi i botës kompjuterike").
- E dyta është një inkrement, gjithashtu një int unsigned 32-bit.
Kjo është, në fakt, gjithçka. Ka një qasje të tillë: pjesa që përgjigjet për kohën sinkronizohet vazhdimisht me orët; çdo herë kur ndodh një përditësim, kjo pjesë sinkronizohet me orët dhe rezulton që koha është gjithmonë më-llogjikisht e saktë, ndërsa inkrementi lejon dallimin e ngjarjeve që kanë ndodhur në të njëjtin moment kohor.
Pse është kjo e rëndësishme për "MongoDB"? Sepse lejon bëjmë disa rikuperime rezervë në një moment të caktuar kohor, pra ngjarja indeksohet me kohën. Kjo është e rëndësishme kur duhen disa ngjarje; për DB, ngjarjet janë ndryshime në DB që kanë ndodhur në pika të caktuara të kohës.
Arsyeja kryesore do t’ju them vetëm juve (ju lutem, mos e thoni askujt tjetër)! Ne e bëmë këtë sepse kështu duken të dhënat e renditura, të indikuara në MongoDB OpLog. OpLog është një strukturë të dhënash që përmban të gjitha ndryshimet në bazën e të dhënave: ato fillimisht shkojnë në OpLog dhe pastaj aplikohen në Storage vetëm në rastin kur është data e replikueshme ose e ndarë.
Kjo ishte arsyeja kryesore. Megjithatë, ka edhe kërkesa praktike për zhvillimin e bazës, që do të thotë se duhet të jetë e thjeshtë – sa më pak kod, sa më pak gjëra që dështojnë dhe duhet të rikodohen dhe testohen. Fakti që op-logët tanë u indekseuan me orë hibride ndihmoi shumë dhe mundësuan një zgjedhje të drejtë. Kjo vërtet i justifikoi vetveten dhe ndofta funksionoi magjikisht që në prototipin e parë. Ishte shumë e shkëlqyer!
Sinkronizimi i orëve
Ka there'sh disa mënyra për sinkronizim, të përshkruara në literaturën shkencore. Po flas për sinkronizimin, kur kemi dy sharda të ndryshme. Nëse ka një replikë-set, atje nuk nevojitet asnjë sinkronizim: është «single-master»; kemi OpLog, në të cilin përfshihen të gjitha ndryshimet - në këtë rast, gjithçka është tashmë renditur në mënyrë sekondare brenda vetë «OpLog». Por nëse kemi dy sharda të ndryshme, këtu sinkronizimi i kohës është i rëndësishëm. Këtu orët vektoriale ndihmuan më shumë! Por ne nuk i kemi ato.
Mënyra e dytë e përshtatshme janë «Heartbeats». Mund të shkëmbehen disa sinjale, që ndodhin çdo njësi kohe. Por «Heartbeats» janë shumë të ngadalta, nuk mund t'i sigurojmë klientit tonë një latencë të duhur.
True time - padyshim, është një gjë e shkëlqyer. Por, përsëri, kjo ndoshta është e ardhmja… Megjithatë, në «Atlas» ndoshta tashmë bëhet, tashmë ka sinkronizues të shpejtë të kohës «Amazon». Por kjo nuk do të jetë e disponueshme për të gjithë.
Gossiping – kjo është kur të gjitha mesazhet përfshijnë kohën. Kjo është përafërsisht ajo që ne përdorim. Çdo mesazh midis nodave, drejtuesit, router-i i nodave të të dhënave, absolutisht gjithçka për «MongoDB» – janë disa elemente, komponente të bazës së të dhënave, që mbajnë orë që rrjedhin. Kudo aty ka një vlerë të kohës hibride, ajo transmetohet. 64 bit? Kjo është e mundur, kjo lejohen.
Si funksionon e gjitha kjo së bashku?
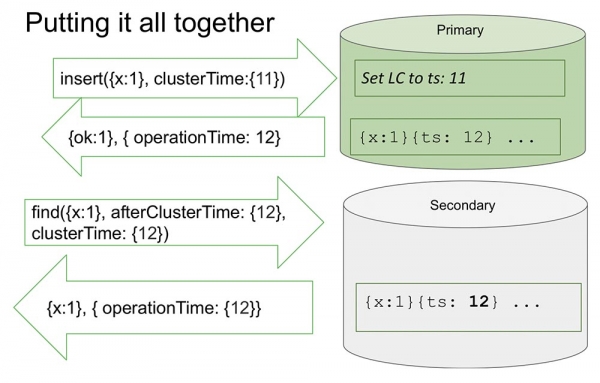
Këtu po shqyrtoj një replikë-set për ta bërë pak më të lehtë. Ka Primary dhe Secondary. Secondary bën replikimin dhe nuk është gjithmonë plotësisht në sinkronizim me Primary.
Një insert ndodh në «Primary» me një vlerë të caktuar kohe. Ky insert rrit një numërues të brendshëm me 11, nëse kjo është maksimale. Ose ai do të kontrollojë vlerat e orëve dhe do të sinkronizohet sipas orëve, nëse vlerat janë më të mëdha. Kjo lejon renditjen sipas kohës.
Pasardhës i pas regjistrimit ndodh një moment i rëndësishëm. Orët në «MongoDB» janë të inkrementuara vetëm në rastin e regjistrimit në «OpLog». Kjo është ngjarja që ndryshon gjendjen e sistemit. Absolute në të gjitha artikujt klasikë, ngjarje konsiderohet ndarja e një mesazhi në nod: mesazhi erdhi - do të thotë se sistemi ka ndryshuar gjendjen e tij.
Kjo lidhet me faktin se kur bëhet një hulumtim, nuk është krejtësisht e qartë se si do të interpretohet kjo mesazh. Ne e dimë saktësisht se nëse nuk është reflektuar në "Oplog", atëherë nuk do të interpretohet në asnjë mënyrë, dhe ndryshimi i gjendjes së sistemit është vetëm regjistrimi në "Oplog". Kjo na e thjeshton gjithçka: dhe modeli e thjeshton, dhe lejon të mbahet rendi brenda një grup replika, dhe shumë gjëra të tjera të dobishme.
Kthehet një vlerë që tashmë është regjistruar në "Oplog" – ne e dimë se në "Oplog" tashmë është kjo vlerë, dhe koha e saj është 12. Tani, le të themi se fillon leximi nga një nod tjetër (Sekondar), dhe ai e kalon tashmë afterClusterTime në vetë mesazhin. Ai thotë: "Më duhen të gjitha ato që ndodhën të paktën pas 12 ose gjatë dymbëdhjetës" (shih figurën lart).
Kjo është ajo që quhet Causal a consistent (CAT). Ka një koncept në teori që është një prerje e caktuar kohe, që është konsistente me vete. Në këtë rast mund të thuhet se është gjendja e sistemit, që është vërejtur në momentin e kohës 12.
Tani këtu nuk ka asgjë për momentin, sepse kjo simiton situatën kur Sekondari duhet të replikojë të dhënat nga Primari. Ai po pret… Dhe këtu të dhënat erdhën – kthen këto vlera mbrapa.
Kështu funksionon gjithçka. Në thelb.
Çfarë do të thotë "në thelb"? Le të supozojmë se ka ndonjë person që e ka lexuar dhe kuptuar se si funksionon gjithçka. Kuptoi se çdo herë ndodhi ClusterTime, ai përditëson orët e tij logjike të brendshme, dhe pastaj regjistrimi i ardhshëm rritet me një. Kjo funksion do të marrë 20 rreshta. Le të themi se ky person kalon numrin më të madh 64-bit, minus një.
Pse "minus një"? Sepse orët e brendshme do të vendosen në këtë vlerë (sigurisht, kjo është vlera më e madhe e mundshme dhe më e madhe se koha aktuale), pastaj do të ndodhë regjistrimi në "Oplog", dhe orët do të inkrementohen përsëri me një – dhe atëherë do të jetë vlera maksimale (atje gjithçka janë një, nuk ka më të lartë, unsaint int’ë).
E qartë se pas këtij momenti sistemi bëhet krejtësisht i pavendosur për çfarëdo. Ai mund të shkarkohet, pastruar – shumë punë manuale. Disponueshmëria e plotë:
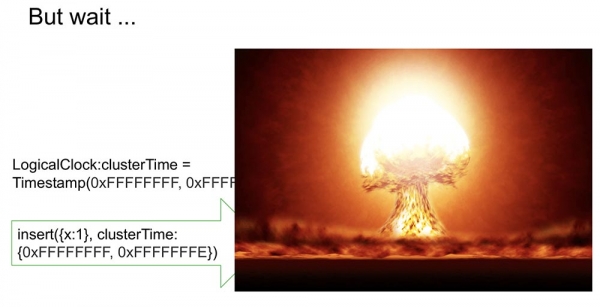
Në fakt, nëse kjo riprodhohet diku tjetër, atëherë e gjithë klasteri thyhet. Një situatë krejt e papranueshme, që çdo person mund ta organizojë shumë shpejt dhe lehtë! Prandaj, ne e shqyrtuam këtë aspekt si një nga më të rëndësishmit. Si ta parandalojmë atë?
Rruga jonë - të nënshkruajmë clusterTime
Kështu ai transmetohet në mesazhin (deri te teksti blu). Por ne filluam gjithashtu të gjenerojmë nënshkrimin (teksti blu):
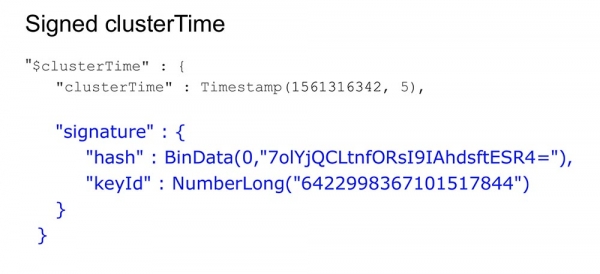
Nënshkrimi gjenerohet me një çelës, i cili ruhet brenda bazës së të dhënave, brenda perimetrave të mbrojtur; ai gjenerohet, përditësohet (përdoruesit nuk e shohin këtë). Gjenerohet një hash, dhe çdo mesazh, në momentin e krijimit nënshkruhet, dhe kur merret - validizohet.
Ndoshta, ngrihet një pyetje te njerëzit: "Sa shumë e ngadalëson gjithçka kjo?" Unë kam thënë se duhet të punojë shpejt, veçanërisht në mungesë të kësaj feature.
Çfarë do të thotë të përdorësh Causal consistency në këtë rast? Është të tregosh parametrin afterClusterTime. Pa këtë, ai thjesht do të transmetojë vlera në çdo rast. Gossiping, duke filluar nga versioni 3.6, punon gjithmonë.
Nëse ne do të lëmë gjenerimin e vazhdueshëm të nënshkrimeve, atëherë kjo do ta ngadalësojë sistemin edhe në mungesë të feature, që nuk përputhet me qasjet dhe kërkesat tona. Por çfarë bëmë ne?
Bëje shpejt!
Është një gjë mjaft e thjeshtë, por truku është interesant - do të ndaja, ndoshta do t'i interesojë dikujt.
Kemi një hash, në të cilin ruhen të dhënat e nënshkruara. Të gjitha të dhënat kalojnë përmes caches. Cache nënshkruan jo saktësisht kohën, por Range. Kur vjen një vlerë e caktuar, ne gjenerojmë Range, maskojmë 16 bitët e fundit, dhe këtë vlerë nënshkruajmë:
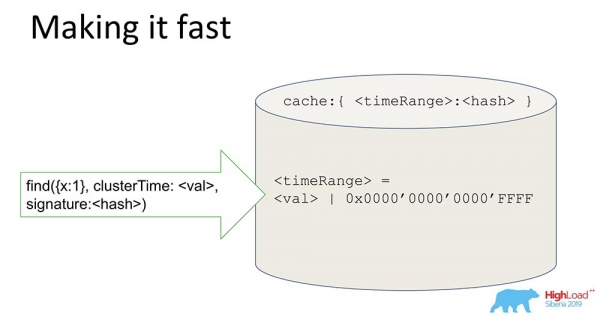
Duke marrë një nënshkrim të tillë, ne shpejtojmë sistemin (kondicionalisht) 65 mijë herë. Ai funksionon shkëlqyeshëm: kur vendosëm eksperimente - koha realisht u shkurtua 10 mijë herë kur kishim një përditësim të radhës. Është e qartë se kur ato janë të çrregullta, kjo nuk ndodh. Por në shumicën e rasteve praktike, kjo funksionon. Kombinimi i nënshkrimit të Range së bashku me nënshkrimin e lejuan zgjidhjen e problemit të sigurisë.
Çfarë mësuam?
Mësimet që kemi nxjerrë nga kjo:
- Duhet të lexoni materiale, histori, artikuj, sepse kemi shumë gjëra interesante për të. Kur punojmë mbi ndonjë veçori (veçanërisht tani, kur kemi bërë transaksione etj.), duhet të lexojmë dhe të kuptojmë. Kjo merr kohë, por në të vërtetë është shumë e dobishme, sepse bëhet e qartë ku jemi. Nuk kemi shpikur asgjë të re - thjesht morëm përbërësit.
Në përgjithësi, vërehet një diferencë e caktuar në mendim kur ndodh një konferencë akademike (p.sh. 'Sigmon') - aty të gjithë përqendrohen në idetë e reja. Çfarë është noviteti i algoritmit tonë? Këtu nuk ka ndonjë novitet të veçantë. Noviteti përfundimisht qëndron në mënyrën se si i kemi përzier qasjet ekzistuese. Kështu, e para - duhet të lexoni klasikët, duke filluar nga Lamport.
- Në prodhim ka kërkesa krejt ndryshe. Jam i sigurt se shumë prej jush nuk përballen me databaza 'sferike' në një vakuum abstrakt, por me gjëra normale, reale, të cilat kanë probleme me disponueshmërinë, vonesën dhe qëndrueshmërinë ndaj dështimeve.
- E fundit - është se na duhej të shqyrtonim ide të ndryshme dhe të kombinonim disa artikuj të ndryshëm në një qasje, së bashku. Ideja për nënshkrimin, për shembull, erdhi nga një artikull që shqyrtonte protokollin Paxos, i cili është për failet jo-bizantine brenda protokollit të autorizimit, për ato bizantine - jashtë protokollit të autorizimit... Në thelb, kjo është saktësisht ajo që ne përfundimisht bëmë.
Nuk ka asgjë të re këtu! Por sapo i përzjejmë të gjitha së bashku... Është e ngjashme me të thënë se receta e sallatës Olivier është një budallallëk, sepse vezët, majoneza dhe turshitë janë tashmë shpikur... Kjo është përafërsisht e njëjta histori.
Këtu do ta mbyll. Faleminderit!
Pyetje
Pyetje nga publiko (përkatësisht - P): – Faleminderit, Mihail, për referatin! Tema për kohën është interesante. Ju përdorni Gossiping. Të thashë që të gjithë kanë kohën e tyre, të gjithë e dinë kohën e tyre lokale. E kuptova që kemi një shofer - mund të ketë shumë klientë me shoferë, po ashtu shumë planifikues pyetjesh, shumë skatash... Po për çfarë kthehet sistemi nëse ndonjëherë ndodh një diferencë: dikush vendos se është një minutë përpara, dikush - një minutë prapa? Ku do të jemi?
MT: – Është një pyetje e shkëlqyer në të vërtetë! Unë isha duke menduar për shard-et. Nëse e kuptoj saktë pyetjen, kemi këtë situatë: ka shard 1 dhe shard 2, leximi ndodh nga këto dy sharde – ata kanë dallime, nuk ndërveprojnë me njëri-tjetrin, sepse koha që ata dinë – është e ndryshme, veçanërisht koha që ata kanë në oplog.
Supozoni se shard 1 ka bërë një milion regjistrime, shard 2 – asgjë, dhe kërkesa erdhi në dy sharde. Dhe i pari ka afterClusterTime më të madh se një milion. Në një situatë të tillë, siç e shpjegova, shard 2 kurrë nuk do të përgjigjet.
P: – Doja të dija se si sinkronizohen dhe si zgjedhin një kohë logjike.
MT: – Shumë thjeshtë sinkronizohen. Shard-i, kur merr afterClusterTime dhe nuk gjen kohën në "Oplog", inicion no approved. Pra, ai e rrit me dorë kohën e tij në këtë vlerë. Kjo do të thotë se ai nuk ka ngjarje që i përgjigjen kësaj kërkese. Ai krijon këtë ngjarje artificialisht dhe në këtë mënyrë bëhet Causal Consistent.
P: – E nëse pas kësaj, ndodhin ndonjë ngjarje që janë humbur në rrjet diku?
MT: – Shard-i është ndërtuar në mënyrë që ato nuk do të vijnë më, pasi është një master i vetëm. Nëse ai e ka regjistruar atë, ato nuk do të vijnë më, por do të vijnë më vonë. Nuk mund të ndodhë që diku diçka të ngecë, pastaj ai të bëjë no write, dhe pastaj këto ngjarje të vijnë – dhe të prishin Causal consistency. Kur ai bën no write, ato duhet të vijnë më vonë (ai i pret).
P: – Kam disa pyetje në lidhje me radhët. Causal consistency supozon se ka një radhë të caktuar veprimesh që duhet të realizohen. Çfarë ndodh nëse ne humbim një paketë? Këtu ka shkuar 10-ta, 11… paketa 12 ka humbur, dhe të gjitha të tjerat presin që ta realizojnë. Dhe papritmas makina vdiq, ne nuk mund të bëjmë asgjë. A ka ndonjë gjatësi maksimale të radhës, e cila akumulohet para se të realizohet? Cili është dështimi fatal në rast të humbjes së ndonjë gjendjeje? Për më tepër, nëse ne regjistrojmë se ka një gjendje të mëparshme, ne duhet të fillojmë nga ajo, apo jo? Por ne nuk u nisëm nga ajo!
MT: – Po, gjithashtu një pyetje e shkëlqyer! Çfarë bëjmë ne? Në MongoDB ka një koncept të regjistrimeve kuorum dhe leximeve kuorum. Në cilat raste një mesazh mund të humbasë? Kur regjistrimi është jo kuorum ose kur leximi nuk është kuorum (gjithashtu mund të mbetet ndonjë garbage).
Përsa i përket konsistencës kauzale, kemi kryer një verifikim të madh eksperimental, i cili tregoi se në rastin kur regjistrimet dhe leximi janë jo-kvorum, ndodhin shkelje të konsistencës kauzale. Pikërisht siç thoni ju!
Këshilla jonë: të përdoret të paktën leximi kvorum gjatë përdorimit të konsistencës kauzale. Në këtë rast, asgjë nuk do të humbasë, madje edhe nëse regjistrimi kvorum humbet... Kjo është një situatë ortogonale: nëse përdoruesi nuk dëshiron që të humbasin të dhënat, duhet të përdorë regjistrim kvorum. Konsistenca kauzale nuk ofron garanci për qëndrueshmëri. Garancia për qëndrueshmëri ofrohet nga replikimi dhe mekanizmat që lidhen me replikimin.
P: – Kur krijojmë një instancë, që i bën sharding (jo master, por slave përkatësisht), ajo mbështetet në kohën unix të vetë makinës ose në kohën e "masterit"; a sinkronizohet herën e parë apo periodikisht?
MT: – Tani do të sqarohem. Shardi (pra, partitoni horizontal) ka gjithmonë një Primar. Në shard mund të ketë "master" dhe mund të ketë replika. Por shardi gjithmonë mbështet regjistrimin, sepse duhet të mbështesë një domen të caktuar (në shard shtë Primari).
P: – Pra, gjithçka varet ngushtë nga "masteri"? A përdoret gjithmonë koha e "masterit"?
MT: – Po. Mund ta themi figurativisht: orët bien, kur ndodh regjistrimi në "master", në "OpLog".
P: – Ne kemi një klient, i cili lidhet, dhe nuk ka nevojë të dijë asgjë për kohën?
MT: – Asgjë nuk ka nevojë të dijë! Nëse flasim për mënyrën se si funksionon tek klienti: klienti, kur dëshiron të përdorë konsistencën kauzale, duhet të hapë një sesion. Tani atje ka gjithçka: dhe transaksionet në sesion, dhe retrieve a rights… Sesioni është një renditje e ngjarjeve logjike që ndodhin me klientin.
Nëse ai hap këtë sesion dhe atje thotë se dëshiron konsistencë kauzale (nëse sipas parazgjedhjes sesioni mbështet konsistencën kauzale), gjithçka funksionon automatikisht. Driver-i mbart këtë kohë dhe e rrit atë kur merr një mesazh të ri. Ai mbart se çfarë përgjigjeje kishte kthyer më parë serveri, i cili ktheu të dhënat. Kërkesa e ardhshme do të përmbajë afterCluster ("koha më e madhe se kjo").
Klienti nuk ka nevojë të dijë asgjë! Kjo është plotësisht e paqartë për të. Nëse njerëzit përdorin këto karakteristika, çfarë lejohet të bëjnë? E para, mund të lexojnë sigurtë nga secondaries: mund të shkruajnë në Primary dhe të lexojnë nga secondaries që janë replikuar gjeografikisht dhe të jenë të sigurt se kjo funksionon. Po ashtu, seancat që janë regjistruar në Primary mund të kalohen në Secondary, dmth. mund të përdoren disa seanca.
P: – Tematika e Konsistencës Eventuale është shumë e lidhur me një shtresë të re të Shkencës Kompjuterike – llojet e të dhënave CRDT (Tipet e Dhënash të Riplikuar pa Konflikte). A keni shqyrtuar integrimin e këtyre llojeve të të dhënave në bazën e të dhënave dhe çfarë mund të thoni për këtë?
MT: – Në pyetje të mirë! CRDT ka kuptim për konfliktet gjatë regjistrimit: në MongoDB – një master i vetëm.
P: – Kam një pyetje nga devops-at. Në botën reale, ndodhin situata të tilla hezituese, kur ndodhin dështime bizantine, dhe njerëz të këqij brenda perimeterit të mbrojtur fillojnë të hetojnë protokollin, dërgojnë paketa të krijuara posaçërisht?
MT: – Njerëzit e këqij brenda perimeterit janë ashtu si një kalë Troje! Njerëzit e këqij brenda perimeterit mund të bëjnë shumë gjëra të këqija.
P: – Është e qartë se të lësh një "vrimë" në server, në një mënyrë, përmes së cilës mund të kalosh një zoologji elefantësh dhe të shembësh tërë klasterin përgjithmonë… Do të nevojitet kohë për rikuperim manual… Kjo, lehtësisht, është e gabuara. Nga ana tjetër, është interesante të dihet: në jetën reale, ndodhin raste të tilla kur sulmet e brendshme ndodhin natyrshëm?
MT: – Pasi nuk i has shpesh dështimet e sigurisë në jetën reale, nuk mund të them – ndoshta ato ndodhin. Por nëse flasim për filozofinë zhvillimore, ne mendojmë kështu: kemi një perimetër që siguron ekipi që merret me sigurinë – ky është një çelës, një mur; dhe brenda perimeterit mund të bëjmë gjithçka që duam. Është e qartë se ka përdorues që kanë vetëm mundësinë për të parë, dhe ka përdorues me mundësinë për të fshirë katalogun.
Në varësi të të drejtave, dëmi që përdoruesit mund të shkaktojnë, mund të jetë si një mi, por mund të jetë edhe si një elefant. Është e qartë se një përdorues me të drejta të plota mund të bëjë gjëra të gjitha. Një përdorues me të drejta më të kufizuara mund të shkaktojë dëm shumë më të vogël. Në veçanti, ai nuk mund të prishë sistemin.
P: – Në perimetrin e mbrojtur, dikush po përpiqet të formojë protokolle të papritura për serverin, duke e vendosur atë në rrezik, dhe nëse ka fat, ndoshta edhe të gjithë klasterin… A është ndonjëherë aq "e mirë"?
MT: – Nuk kam dëgjuar asnjëherë për gjëra të tilla. Nuk është sekret që mund të dështosh serverin në këtë mënyrë. Të dështosh brenda, duke qenë një përdorues i autorizuar që mund të shkruajë diçka në mesazh… Në të vërtetë nuk është e mundur, sepse gjithsesi do të verifikohet. Ka mundësi për të çaktivizuar këtë autentifikim për ata përdorues që nuk duan – kjo është pastaj problemi i tyre; ata, në mënyrë të ashpër, e kanë shembur murin dhe mund të futin aty një elefant që do t'i shkatërrojë… Në të vërtetë, mund të vish si riparues, të vish dhe të nxjerrësh!
P: – Faleminderit për raportin. Sergei ("Yandex"). Në "Mongo" ka një konstantë që kufizon numrin e anëtarëve votues në Replica Set, dhe kjo konstantë është 7 (shtatë). Pse është kjo një konstantë? Pse nuk është ndonjë parametër?
MT: – Replica Set mund të ketë deri në 40 node. Atje gjithmonë ka shumicë. Nuk e di cila është versione…
P: – Në Replica Set mund të aktivizosh anëtarë jo-votues, por votuesit – maksimumi 7. Si të përballohet ndalesa në këtë rast, nëse kemi një Replica Set të shpërndarë në 3 qendra të dhënash? Një qendër e dhënash mund të fiket lehtësisht, dhe një makinë tjetër mund të bie jashtë.
MT: – Kjo tashmë është pak jashtë raportit. Ky është një pyetje e përgjithshme. Mund ta tregoj më vonë.
Pak reklamë 🙂
Faleminderit që po qëndroni me ne. Ju pëlqen artikujt tanë? Doni të shihni më shumë materiale interesante? Na mbështesni duke bërë një porosi ose duke rekomanduar tek miqtë tuaj, , një analog unik i serverëve entry-level që e kemi shpikur për Ju: (opcionet me RAID1 dhe RAID10, deri në 24 bërthama dhe deri në 40GB DDR4 janë të disponueshme).
Dell R730xd dyfish më i lirë në qendër të të dhënave Equinix Tier IV në Amsterdam? Vetëm te ne në Holandë! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — nga $99! Lexoni rreth
Burimi: habr.com
