

Më 26 shkurt, organizuam mitap Apache Ignite GreenSource, ku folën kontribuuesit e projektit open source. . Një ngjarje e rëndësishme në jetën e këtij komuniteti ishte rindërtimi i komponentit , i cili lejon të vendosen mikroshërbime të përdoruesve direkt në klastern e Ignite. Rreth këtij procesi të vështirë në mitap foli , inxhinier softueri dhe kontribues i Apache Ignite për më shumë se dy vjet.
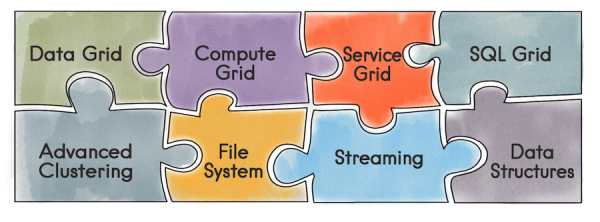
Le të fillojmë me atë se çfarë është në të vërtetë Apache Ignite. Kjo është një bazë të dhënash që përfaqëson një ruajtës të shpërndarë Key/Value me mbështetje për SQL, transaksionet dhe cache. Për më tepër, Ignite lejon vendosjen e shërbimeve të përdoruesve direkt në klastern Ignite. Zhvilluesi ka në dispozicion të gjitha mjetet që ofron Ignite — struktura të dhënash të shpërndara, Messaging, Streaming, Compute dhe Data Grid. Për shembull, kur përdoret Data Grid, problemi i administratës së një infrastrukture të veçantë për ruajtjen e të dhënave zhduket dhe, si pasojë, shpenzimet e lidhura që dalin nga kjo.
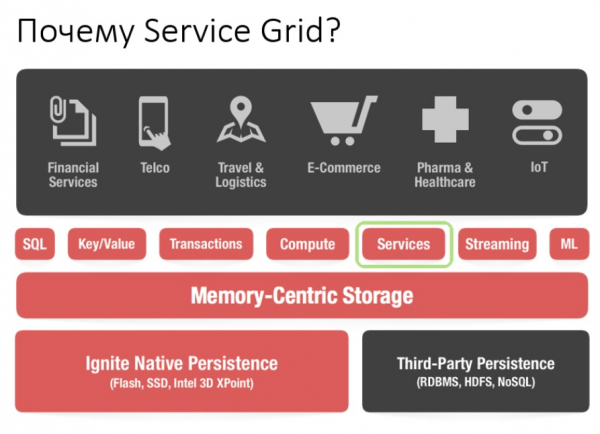
Duke përdorur API Service Grid, mund të vendosni një shërbim, thjesht duke treguar në konfigurim skemën e vendosjes dhe, përkatësisht, shërbimin vetë.
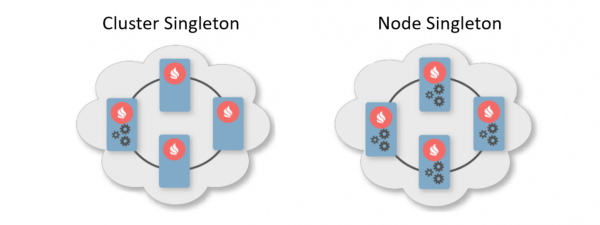
Një skemë e zakonshme vendosjeje është përcaktimi i numrit të instancave që duhet të vendosen në nyjet e klasterit. Ka dy skema tipike vendosjeje. E para – është Cluster Singleton: në çdo moment, në klaster garanton që do të jetë e disponueshme një instancë e vetme e shërbimit të përdoruesit. E dyta – është Node Singleton: në çdo nyje të klasterit është vendosur një instancë e shërbimit.
Përdoruesi gjithashtu mund të përcaktojë numrin e instancave të shërbimit në të gjithë klasterin dhe të vendosë një predikat për filtrimin e nyjeve përkatëse. Në këtë skenar, Service Grid do të llogarisë shpërndarjen optimale për vendosjen e shërbimeve.
Për më tepër, ekziston një veçori si Shërbimi i Afinitetit. Afiniteti është një funksion që përcakton lidhjen e çelësave me parti dhe lidhjen e partive me nyjat në topologji. Sipas çelësit, mund të përcaktohet nyja kryesore, ku ruhen të dhënat. Kështu, mund të asociohet shërbimi juaj me çelësin dhe me cache-in e funksionit të afinitetit. Në rast se ndodh një ndryshim në funksionin e afinitetit, do të ndodhë një ri-deployment automatik. Kështu, shërbimi do të vendoset gjithmonë pranë të dhënave me të cilat duhet të manipulojë, duke ulur për pasojë kostot e aksesit në informacion. Kjo skemë mund të quhet një lloj llogaritjesh të kolokuar.
Tani, kur e kemi analizuar se çfarë e bën Shërbimin e Gridës të veçantë, do të flasim për historinë e tij të zhvillimit.
Çfarë ndodhi më parë
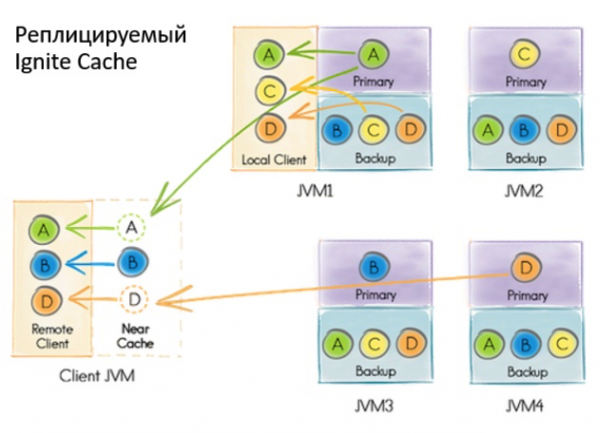
Implementimi i kaluar i Shërbimit të Gridës bazohej në një cache sistemik transaksional të replikuar, si Ignite. Nën termin "cache" në Ignite kuptohet një magazinë. Kështu, kjo nuk është diçka e përkohshme, siç mund të mendohet. Edhe pse cache-i është i replikuar dhe çdo nyje përmban të gjithë setin e të dhënave, brenda cache-it ka një pamje të ndarë në party. Kjo lidhet me optimizimin e magazinave.
Çfarë ndodhte kur përdoruesi donte të bëjë deploy të shërbimit?
- Të gjitha nyjat në klaster ishin të regjistruara për të marrë përditësimin e të dhënave në magazinë përmes mekanizmit të integruar Continuous Query.
- Nyja inicizuese, nën një transaksion të leximit të miratuar, bënte një regjistrim në bazën e të dhënave, e cila përmbante konfigurimin e shërbimit, përfshirë një instancë të serializuar.
- Kur merrte një njoftim për një regjistrim të ri, koordinatorët llogaritnin shpërndarjen sipas konfigurimit. Objekti i marrë regjistrohej përsëri në bazë.
- Nëse nyja hynte në shpërndarje, koordinatorët duhej ta bënin atë deploy.
Çfarë na shqetësonte
Në një moment, arritëm në përfundimin se kështu nuk mund të punonim me shërbimet. Arsyet ishin disa.
Nëse gjatë deploy-it ndodhte një gabim, mund të merrej vesh vetëm nga log-et e asaj nyje ku ndodhi gjithçka. Ekzistonte vetëm një deploy asinkron, kështu që pas kthimit të kontrollit te përdoruesi nga metoda e deploy-it, kërkohej një kohë shtesë për të nisur shërbimin — dhe gjatë kësaj kohe përdoruesi nuk mund të menaxhonte asgjë. Për të zhvilluar më tej Shërbimin e Gridës, për të zhvilluar veçori të reja, për të tërhequr përdorues të rinj dhe për të bërë jetën e të gjithëve më të lehtë, duhej të ndryshonim diçka.
Kur dizajnimin e Service Grid të ri, ne në radhë të parë dëshironim të ofronim garancinë e një deploji të sinkronizuar: sa herë që përdoruesit iu rikthye kontrolli nga API, ata mund të fillonin menjëherë të përdorin shërbimet. Po ashtu, dëshironim t'i ofronim iniciatorit mundësinë për të trajtuar gabimet e deploit.
Përveç kësaj, dëshironim ta lehtësonim implementimin, dmth. të shmangnim transaksionet dhe ribalancimin. Megjithëse cache është replikues dhe nuk ka balancim, gjatë deplojeve të mëdha me shumë node janë shfaqur probleme. Kur ndryshon topologjia, node-t duhet të shkëmbejnë informacion, dhe gjatë një deploje të madhe, këto të dhëna mund të peshojnë shumë.
Kur topologjia ishte e paqëndrueshme, koordinatori kishte nevojë të ri-kalibronte shpërndarjen e shërbimeve. Po ashtu, kur punoni me transaksione në një topologji të paqëndrueshme, kjo mund të çojë në gabime të vështira për të parashikuar.
Problemet
Cilat janë ndryshimet globale pa probleme përkatëse? E para që u shfaq ishte ndryshimi i topologjisë. Duhet të kuptohet se në çdo moment, madje edhe në momentin e deploimit të shërbimit, një node mund të hyjë ose të dalë nga klasteri. Më shumë se kaq, nëse një node hyn në klaster gjatë deploimit, do të jetë e nevojshme të kalojë informacionin për shërbimet në node-n e ri në mënyrë koherente. Dhe flasim jo vetëm për ato që tashmë janë vendosur, por edhe për deploimet aktuale dhe të ardhshme.
Kjo është vetëm një nga problemet që mund të përmbledhin në një listë të veçantë:
- Si të deplojmë shërbimet e konfiguruara statikisht gjatë nisjes së node-it?
- Dalja e node-it nga klasteri – çfarë duhet të bëjmë nëse node-i kishte angazhuar shërbime?
- Çfarë duhet të bëjmë nëse ndryshoi koordinatori?
- Çfarë duhet të bëjmë nëse klienti u ri-lidh me klasterin?
- A duhet të trajtojmë kërkesat për aktivizim / deaktivizim dhe si?
- E çfarë nëse thirret shkatërrimi i cache-it, dhe ne kemi shërbime me afinitet që varen nga ai?
Dhe kjo nuk është aspak e gjitha.
Zgjidhja
Kemi zgjedhur si qasje qëllimore qasjen e drejtuar nga ngjarjet me implementimin e komunikimit të proceseve përmes mesazheve. Në Ignite tashmë janë implementuar dy komponente, të cilat lejojnë node-t të dërgojnë mesazhe mes tyre, - communication-spi dhe discovery-spi.
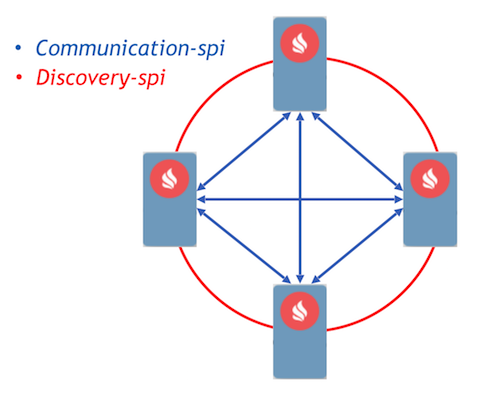
Communication-spi lejon që nodet të komunikojnë drejtpërdrejt dhe të dërgojnë mesazhe. Ai është i përshtatshëm për dërgimin e një sasi të madhe të të dhënave. Discovery-spi lejon dërgimin e një mesazhi te të gjitha nodet në klaster. Në implementimin standard, kjo bëhet me topologjinë "unazë". Gjithashtu, ka integrim me Zookeeper, në këtë rast përdoret topologjia "yll". Një pikë tjetër e rëndësishme është se discovery-spi ofron garanci se mesazhi do të dorëzohet saktësisht në rendin e duhur te të gjitha nodet.
Të shqyrtojmë protokollin e deploy-it. Të gjitha kërkesat e përdoruesve për deploy dhe undeploy dërgohen përmes discovery-spi. Kjo ofron garancitë e mëposhtme garancitë:
- Kërkesa do të pranohen nga të gjithë nodet në klaster. Kjo do të lejojë vazhdimin e përpunimit të kërkesës në rast se koordinatori ndryshon. Gjithashtu, kjo do të thotë se për një mesazh të vetëm, çdo nod do të ketë të gjitha metadatët e nevojshme, si konfigurimi i shërbimit dhe instanca e tij e serializuar.
- Rendi i rreptë i dorëzimit të mesazheve lejon zgjidhjen e konflikteve të konfigurimeve dhe kërkesave konkurruese.
- Duke qenë se hyrja e nodit në topologji përpunsohet gjithashtu përmes discovery-spi, nodi i ri do të marrë të gjitha të dhënat e nevojshme për të punuar me shërbimet.
Me marrjen e kërkesës, nodet në klaster e validitojnë atë dhe formojnë detyra për përpunim. Këto detyra grumbullohen në një radhë dhe pastaj përpunohen në një tjetër thread nga një punëtor i veçantë. Kjo është realizuar në këtë mënyrë, sepse deploy mund të marrë një kohë të konsiderueshme dhe ndalimi i rrjedhës së shtrirjes është i papranueshëm.
Të gjitha kërkesat nga radha përpunohen nga menaxheri i deploy-it. Ai ka një punëtor të veçantë që nxjerr një detyrë nga kjo radhë dhe e inicializon për të filluar implementimin. Pas kësaj, ndodhin hapat e mëposhtëm:
- Çdo nod llogarit vetë shpërndarjen përmes një funksioni të assign-it të ri dhe të caktuar.
- Nodet formojnë një mesazh me rezultatet e deploy-it dhe e dërgojnë atë te koordinatori.
- Koordinatori agregon të gjitha mesazhet dhe formon rezultatin e gjithë procesit të deploy-it, i cili dërgohet përmes discovery-spi të gjitha nodet në klaster.
- Me marrjen e rezultatit, procesi i deploy-it përfundon, pas së cilës detyra fshihet nga radha.
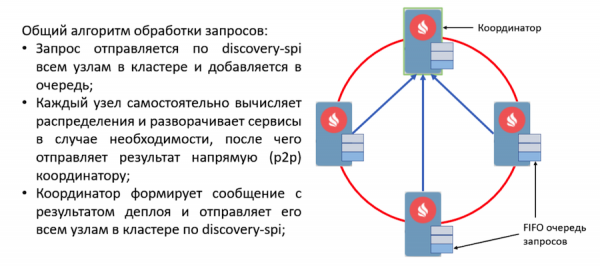
Dizajni i ri i bazuar në ngjarje: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Nëse ndodhi një gabim gjatë shpalosjes, ndihmësi menjëherë e përfshin këtë gabim në mesazhin që e dërgon te koordinatori. Pas agregimit të mesazheve, koordinatori do të ketë informacion mbi të gjitha gabimet gjatë shpërndarjes dhe do ta dërgojë këtë mesazh për discovery-spi. Informacioni mbi gabimet do të jetë i disponueshëm në çdo ndihmës në klaster.
Me këtë algoritëm, trajtohen të gjitha ngjarjet e rëndësishme në Service Grid. Për shembull, ndryshimi i topologjisë është gjithashtu një mesazh për discovery-spi. Dhe në përgjithësi, nëse e krahasojmë me atë që ishte, protokolli doli mjaft i lehtë dhe i besueshëm. Aq sa të trajtojë çdo situatë gjatë shpërndarjes.
Çfarë do të ndodhë më pas
Tani për planet. Çdo përmirësim i madh në projektin Ignite realizohet si një iniciativë për përmirësimin e Ignite, e njohur si IEP. Redizajnimi i Service Grid gjithashtu ka një IEP — me titullin humoristik "Zëvendësimi i vajit në Service Grid." Por në fakt, ne e kemi ndërruar jo vetëm vajin në motor, por tërë motorin.
Ne i kemi ndarë detyrat në IEP në 2 faza. Faza e parë — faza e madhe, që përfshin rishikimin e protokollit të shpërndarjes. Ajo tashmë është përfshirë në master, mund të provoni Service Grid të ri, i cili do të dalë në versionin 2.8. Faza e dytë përfshin shumë detyra të tjera:
- Rishpërndarje e nxehtë
- Versionimi i shërbimeve
- Rritja e qëndrueshmërisë ndaj dështimit
- Klienti i hollë
- Veglat e monitorimit dhe numërimit të metrikave të ndryshme
Mund të rekomandojmë Service Grid për ndërtimin e sistemeve të qëndrueshme me disponueshmëri të lartë. Po ashtu, ju ftojmë për në dhe për të ndarë përvojën tuaj. Përvoja juaj është vërtet e rëndësishme për komunitetin, ajo do të ndihmojë në kuptimin e drejtimit të ardhshëm, si të zhvillojmë komponentin në të ardhmen.
Burimi: habr.com
