

— është një sistem i menaxhimit të bazave të të dhënave kolumnar për përpunimin analitik në linjë (OLAP) me kod të hapur, i krijuar nga Yandex. Përdoret nga Yandex, CloudFlare, VK.com, Badoo dhe shërbime të tjera në të gjithë botën për të ruajtur sasi të mëdha të dhënash (me qindra mijëra rreshta të futur në sekondë ose petabay të dhënash të ruajtur në disk).
Në një DBM të zakonshëm, siç janë MySQL, Postgres, MS SQL Server, të dhënat ruhen në këtë rend:
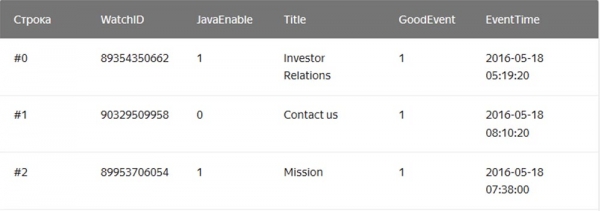
Në këtë mënyrë, vlerat që i përkasin një rreshti ruhen fizikisht afër njëra-tjetrës. Në DBM-të kolumnar, vlerat nga kolona të ndryshme ruhen ndaras, dhe të dhënat e një kolone ruhen së bashku:
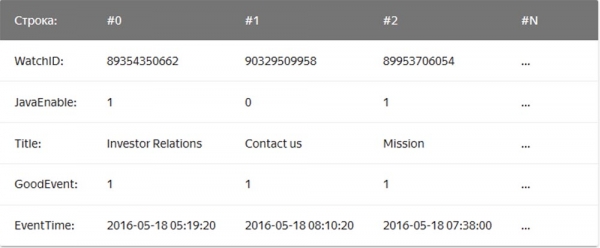
Shembuj të DBM-ve kolumnar përfshijnë Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Kompania – mailforwarder ka filluar të përdorë Clickhouse në vitin 2018 për përgatitjen e raporteve dhe është impresionuar shumë nga thjeshtësia, shkallëzueshmëria, mbështetja për SQL dhe shpejtësia e saj. Shpejtësia e punës së kësaj DBM ishte afër magjisë.
Thjeshtësia
Clickhouse instalon në Ubuntu me një komandë të vetme. Nëse e njihni SQL, mund të filloni menjëherë të përdorni Clickhouse për nevojat tuaja. Megjithatë, kjo nuk do të thotë se mund të ekzekutoni "show create table" në MySQL dhe të bëni kopipastimin e SQL në Clickhouse.
Krahasuar me MySQL, në këtë DBM ekzistojnë dallime të rëndësishme në llojet e të dhënave në përkufizimet e skemave të tabelave, prandaj, për të punuar comforotbë me të, do t'ju nevojitet pak kohë për të modifikuar përkufizimet e skemave të tabelave dhe për të studiuar motorët e tabelave.
Clickhouse funksionon shkëlqyeshëm pa ndonjë software shtesë, por nëse dëshironi të përdorni replikimin, do t'ju duhet të instaloni ZooKeeper. Analiza e performancës së kërkesave tregon rezultate të shkëlqyera — tabelat sistemike përmbajnë të gjithë informacionin dhe të gjitha të dhënat mund të merren nëpërmjet SQL-it të vjetër dhe të mërzitshëm.
Performanca
- për krahasimin e Clickhouse me Vertica dhe MySQL në një server me konfigurimin: dy socketë Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 në 8 disqe 6TB SATA, ext4.
- për krahasimin e Clickhouse me ruajtjen e të dhënave në re Amazon RedShift.
- Pjesë nga blogu :
Baza e të dhënave ClickHouse ka një dizajn shumë të thjeshtë - të gjitha nyjat në kluster kanë funksionalitet të njëjtë dhe përdorin vetëm ZooKeeper për koordinim. Ne ndërtuam një kluster të vogël me disa nyje dhe ekzekutuam teste, gjatë të cilave zbuluam se sistemi ka një performancë mjaftimpresive që i përgjigjet avantazheve të deklaruara në benchmarkë të bazave të të dhënave analitike. Ne vendosëm të shqyrtojmë më në detaje konceptin që qëndron pas ClickHouse. Pengesa e parë për hulumtimet ishte mungesa e mjeteve dhe numri i vogël i komunitetit ClickHouse, ndaj ne thelluam në dizajnin e kësaj baze të dhënash për të kuptuar se si funksionon.
ClickHouse nuk mbështet marrjen e të dhënave direkt nga Kafka, pasi është thjesht një bazë të dhënash, prandaj ne shkruam një shërbim adaptues të vetin në gjuhën Go. Ai lexonte mesazhet e koduara Cap’n Proto nga Kafka, i transformonte ato në TSV dhe i futte në ClickHouse në grupe përmes HTTP-interface. Më vonë, ne e riprogramuam këtë shërbim për të përdorur bibliotekën Go së bashku me ndërfaqen tonë të ClickHouse për të rritur performancën. Gjatë vlerësimit të performancës së pranimit të grupeve, ne zbuluam diçka të rëndësishme - u zbulua se performanca e ClickHouse varet shumë nga madhësia e grupit, domethënë nga numri i rreshtave që futen njëherësh. Për të kuptuar pse ndodh kjo, ne hulumtuam se si ClickHouse ruan të dhënat.
Motori kryesor, në fakt, familja e motorëve për tabela, të përdorur nga ClickHouse për ruajtjen e të dhënave, është MergeTree. Ky motor është konceptualisht i ngjashëm me algoritmin LSM, i aplikuar në Google BigTable ose Apache Cassandra, megjithatë, shmang ndërtimin e një tabele të përkohshme dhe shkruan të dhënat drejtpërdrejt në disk. Kjo i jep atij një kapacitet të shkëlqyer të shkruarjes, pasi çdo grup i futur renditet vetëm sipas “çelësit primar”, kompresonohet dhe shkruhet në disk për të formuar një segment.
Mungesa e tabelës së memories ose një koncepti të këtij lloji të "freskisë" së të dhënave gjithashtu do të thotë se ato mund të shtohen vetëm, sistemi nuk mbështet ndryshimin ose fshirjen. Aktualisht, mënyra e vetme për të fshirë të dhëna është të fshihen ato sipas muajve kalendarikë, pasi segmentet kurrë nuk kalojnë kufirin e muajit. Ekipa e ClickHouse po punon aktivisht për ta bërë këtë funksion të konfigurueshëm. Nga ana tjetër, kjo e bën regjistrimin dhe bashkimin e segmenteve pa konflikte, prandaj kapaciteti i pranimit rritet në mënyrë lineare me numrin e shtesave paralele derisa të ndodhi ngopja e I/O ose bërthamave.
Megjithatë, kjo situatë gjithashtu do të thotë se sistemi nuk është i përshtatshëm për grupe të vogla, prandaj shërbimet Kafka dhe injektorët përdoren për buferim. Për më tepër, ClickHouse vazhdon të kryejë bashkimin e segmenteve në sfond, kështu që shumë pjesë të vogla informacioni do të bashkohen dhe do të regjistrohen më shumë herë, duke rritur kështu intensitetin e regjistrimit. Megjithatë, tepër shumë pjesë të papërputhshme do të shkaktojnë një ngadalësim agresiv të shtesave derisa bashkimi të vazhdojë. Ne kemi zbuluar se kompromisi më i mirë midis pranimit të të dhënave në kohë reale dhe performancës së pranimit është pranimi në tabelë i një numri të kufizuar të shtesave në sekondë.
Çelësi për performancën e leximit të tabelave është indeksimi dhe pozita e të dhënave në disk. Pavarësisht se sa e shpejtë është përpunimi, kur motorit i duhet të skanojë terabajt të të dhënave nga disku dhe të përdorë vetëm një pjesë të tyre, do të marrë kohë. ClickHouse është një depo kolonesh, kështu që secili segment përmban një skedar për secilën kolonë me vlera të renditura për çdo rresht. Kështu, kolona të tëra që nuk janë të pranishme në kërkesë mund të shpëtohen fillimisht, dhe pastaj disa qeliza mund të procesohen paralelisht me ekzekutimin e vectorizuar. Për të shmangur skanimin e plotë, çdo segment ka një skedar të vogël indeksi.
Duke pastruar se të gjitha kolonat janë renditur sipas 'çelësit primar', skedari i indeksit përmban vetëm etiketa (rreshtat e kapura) të çdo N-rreshti, për të qenë në gjendje t'i ruajmë ato në memorie edhe për tabela shumë të mëdha. Për shembull, mund të vendosim cilësimet e parazgjedhura për 'të etiketuar çdo 8192-rresht', atëherë 'indeksimi i varfër' i një tabele me 1 trilion rreshta, e cila lehtë vendoset në memorie, do të marrë vetëm 122,070 karaktere.
Zhvillimi i sistemit
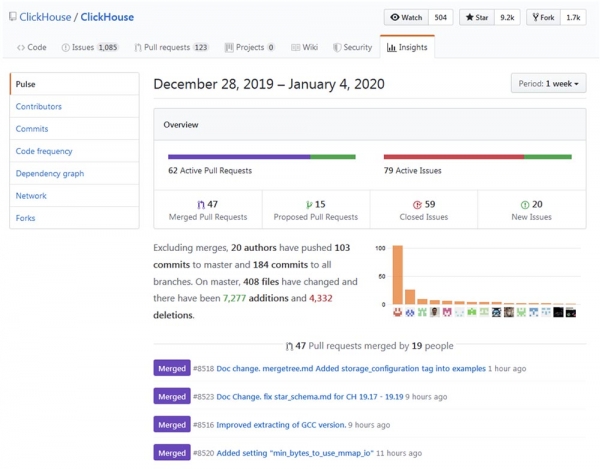
Zhvillimi dhe përmirësimi i Clickhouse mund të ndiqet në dhe të sigurohemi që procesi i 'rritjes' po ndodh me pasoja mbresëlënëse.
Popullariteti
Duket se popullariteti i Clickhouse po rritet eksponencialisht, veçanërisht në komunitetin rusishtfolës. Konferenca e vitit të kaluar High Load 2018 (Moskë, 8-9 nëntor 2018) tregoi se monstër si vk.com dhe Badoo po përdorin Clickhouse, me të cilin futin të dhëna (p.sh., loge) nga dhjetëra mijëra serverë njëkohësisht. Në një video 40-minutëshe Së shpejti do të publikojmë transkriptin në Habr për të lehtësuar punën me materialin.
Fushat e aplikimit
Pas një kohe të kaluar në kërkime, mendoj se ekzistojnë fusha ku ClickHouse mund të jetë e dobishme ose të zëvendësojë plotësisht zgjidhje të tjera më tradicionale dhe të njohura, si MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot dhe Druid. Më poshtë po paraqesim detajet për përdorimin e ClickHouse për modernizimin ose zëvendësimin e plotë të bazave të të dhënave të mësipërme.
Zgjerimi i mundësive të MySQL dhe PostgreSQL
Së fundmi kemi zëvendësuar pjesërisht MySQL me ClickHouse për platformën e buletineve informative Problemi ishte se MySQL për shkak të një dizajni të padishet regjistronte secilën letër të dërguar dhe çdo lidhje në këtë letër me një hash base64, duke krijuar një tabelë të madhe MySQL (email_stats). Pas dërgimit të 10 milionëve email-e për abonentët e shërbimit, kjo tabelë zinte 150 GB hapësirë skedarësh, dhe MySQL filloi të 'ngadalësohej' në pyetje të thjeshta. Për të rregulluar problemin e hapësirës së skedarëve, ne përdorëm me sukses kompresimin e tabelës InnoDB, e cila e zvogëloi atë me 4 herë. Megjithatë, prapë nuk ka kuptim të ruash më shumë se 20-30 milion email-e në MySQL vetëm për të lexuar historinë, pasi çdo kërkesë e thjeshtë, që për ndonjë arsye duhet të kryejë një skanim të plotë, çon në swap dhe një ngarkesë të madhe në I/O, mbi të cilën rregullisht merrnim paralajmërime nga Zabbix.
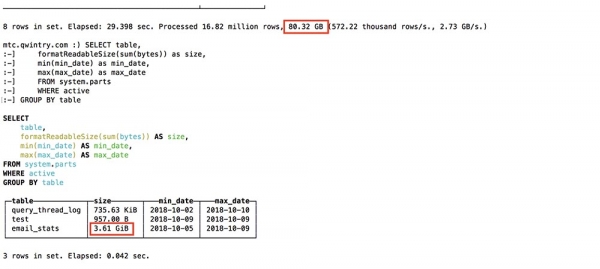
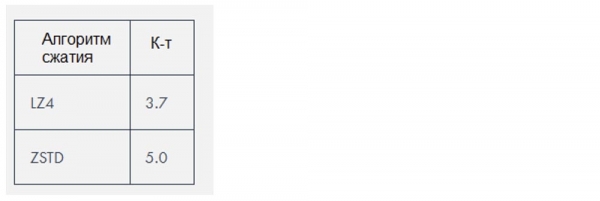
Clickhouse përdor dy algoritme kompresimi që reduktojnë volumin e të dhënave me rreth , por në këtë rast të veçantë të dhënat ishin veçanërisht 'të kompresueshme'.
Zëvendësimi i ELK
Duke u bazuar në përvojën time, staku ELK (ElasticSearch, Logstash dhe Kibana, në këtë rast ElasticSearch) kërkon shumë më shumë burime për të funksionuar sesa është e nevojshme për të ruajtur log-et. ElasticSearch është një motor i shkëlqyer nëse ke nevojë për një kërkim të plotëtekstual në log-e (dhe unë nuk mendoj se realisht e ke nevojën), por më intereson se si de facto u bë standardi i motorit për menaxhimin e log-eve. Performanca e saj e pranimit e kombinuar me Logstash na krijonte probleme edhe në ngarkesa relativisht të vogla dhe kërkonte shtimin e gjithnjë e më shumë memorie të përkohshme dhe hapësirë disku. Si një DB, Clickhouse është më i mirë se ElasticSearch për shkak të arsyeve të mëposhtme:
- Mbështetje për dialektin SQL;
- Një shkallë më e mirë kompresimi të dhënash të ruajtura;
- Mbështetje për kërkimin me shprehje të rregullta Regex në vend të kërkimit të plotëtekstual;
- Planifikim më të përmirësuar të pyetjeve dhe performancë më të lartë të përgjithshme.
Aktualisht, problemi më i madh që del kur krahasohet ClickHouse me ELK është mungesa e zgjidhjeve për ngarkimin e log-eve, si dhe mungesa e dokumentacionit dhe udhëzuesve mbi këtë temë. Megjithatë, çdo përdorues mund të konfigurojë ELK me udhëzimin e Digital Ocean, që është shumë e rëndësishme për një implementim të shpejtë të teknologjive të tilla. Aty ka një motor DB, por ende nuk ka Filebeat për ClickHouse. Po, aty është pranuar. dhe sistemi për punën me logjet , ekziston një mjet për të futur në ClickHouse të dhënat e skedarëve të logjeve, por gjithçka kërkon më shumë kohë. Megjithatë, ClickHouse mbetet lider për shkak të thjeshtësisë së tij, prandaj edhe fillestarët e instalojnë lehtësisht dhe fillojnë përdorimin e plotë brenda 10 minutash.
Duke preferuar zgjidhjet minimalistike, përpiqem të përdor FluentBit, një mjet për shkarkimin e njohjeve me një përdorim shumë të vogël memorie, së bashku me ClickHouse, duke u munduar të shmang përdorimin e Kafka-s. Megjithatë, do të ishin të nevojshme të përmirësohen disa të papajtueshmëri të vogla, si , para se të mund të bëhet pa një sloj proksi që konverton të dhënat nga FluentBit në ClickHouse.
Si një alternativë për Kibana, mund të përdoret ClickHouse si backend . Sa kam kuptuar, këtë mund të krijojë probleme në performancë gjatë renderimit të një sasie të madhe të të dhënave, veçanërisht me versionet më të vjetra të Grafana. Në Qwintry ende nuk e kemi provuar këtë, por ankesat për këtë dërgohen herë pas here në kanalin e suportit të ClickHouse në Telegram.
Zëvendësimi i Google Big Query dhe Amazon RedShift (zgjidhje për kompani të mëdha)
Opsioni ideal për të përdorur BigQuery është të ngarkoni 1 TB të dhënash JSON dhe të kryeni kërkesa analitike mbi to. Big Query është një produkt i shkëlqyer, shkallëzimi i të cilit është i vështirë për t'u nënvlersuar. Ky është një softuer shumë më i ndërlikuar se ClickHouse, që funksionon në një klasër të brendshëm, por nga perspektiva e klientit ka shumë ngjashmëri me ClickHouse. BigQuery mund të bëhet shpejt
ClickHouse është zgjedhja më e mirë kur ju bëni shumë kërkesa përpunuese të kushtueshme. Sa më shumë kërkesa SELECT të bëni çdo ditë — aq më shumë ka kuptim të zëvendësoni Big Query me ClickHouse, sepse një zëvendësim i tillë do t'ju kursejë mijëra dollarë nëse bëhet fjalë për disa terabajt të dhënash të përpunuara. Kjo nuk i referohet të dhënave të ruajtura, përpunimi i të cilave në Big Query është relativisht i lirë.
Në një artikull nga bashkëthemeluesi i kompanisë Altinity, Aleksandër Zaitsev flitet për avantazhet e kësaj migrimi të DBMS.
Zëvendësimi i TimescaleDB
TimescaleDB është një zgjerim i PostgreSQL, i cili optimizon punën me radhët e kohës në një bazë të zakonshme të dhënash., ).
Megjithëse ClickHouse nuk është një konkurrues serioz në niçen e radhëve të kohës, struktura e koloneve dhe ekzekutimi vektorial i kërkesave e bëjnë atë shumë më të shpejtë se TimescaleDB në shumicën e rasteve për përpunimin analitik. Në këtë kuptim, performanca e pranimit të të dhënave me paketa në ClickHouse është rreth 3 herë më e lartë, përveç kësaj, përdor ai 20 herë më pak hapësirë disk, gjë që është vërtet e rëndësishme për përpunimin e volumeve të mëdha të të dhënave historike..
Në ndryshim nga ClickHouse, mënyra e vetme për të kursyer pak hapësirë disku në TimescaleDB është përdorimi i ZFS ose sistemeve të ngjashme të skedarëve.
Përditësimet e ardhshme të ClickHouse, me siguri do të sjellin kompresimin delta, e cila do ta bëjë atë edhe më të përshtatshëm për përpunimin dhe ruajtjen e të dhënave të radhëve të kohës. TimescaleDB mund të bëhet një zgjedhje më e mirë se ClickHouse 'i pastër' në rastet e mëposhtme:
- instalime të vogla me një memorie shumë të vogël (<3 GB);
- një numër i madh INSERT-esh të vogla që nuk dëshironi t'i bufferoni në fragmente të mëdha;
- konsistencë, uniformitet dhe kërkesa AСID më të mira;
- mbështetje për PostGIS;
- bashkimi me tabelat ekzistuese të PostgreSQL, pasi në thelb Timescale DB është PostgreSQL.
Konkurrenca me sistemi Hadoop dhe MapReduce.
Hadoop dhe produkte të tjera MapReduce mund të kryejnë shumë llogaritje komplekse, por zakonisht funksionojnë me vonesa të mëdha. ClickHouse e zgjidh këtë problem duke procesuar terabajtë e të dhënave dhe duke ofruar rezultate pothuajse menjëherë. Kështu, ClickHouse është shumë më efikas për kryerjen e hetimeve analitike të shpejta dhe interaktive, që duhet të tërheqë specialistët e përpunimit të të dhënave.
Konkurrenca me Pinot dhe Druid.
Konkurrentët më të afërt të ClickHouse janë produktet open source me strukturë kolone dhe të shkallëzuar linearisht Pinot dhe Druid. Një krahasim i shkëlqyer i këtyre sistemeve është publikuar në artikullin nga 1 shkurt 2018.
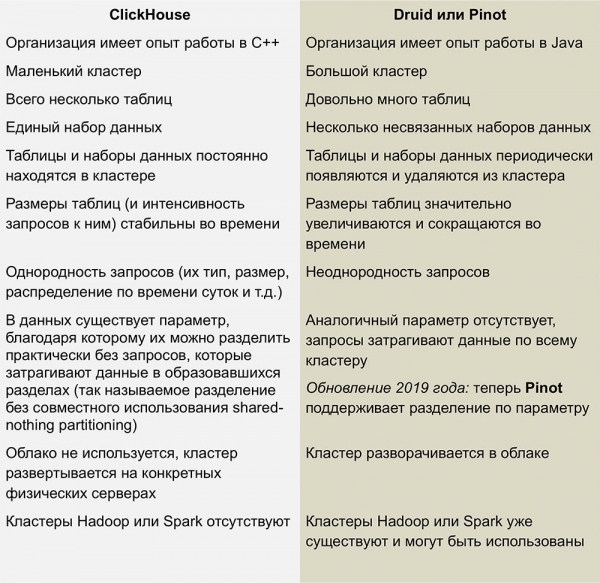
Ky artikull kërkon përditësim – ai thekson se ClickHouse nuk mbështet operacionet UPDATE dhe DELETE, gjë që nuk është krejtësisht e saktë për versionet e fundit.
Ne kemi përvojë të mjaftueshme me këto DBMS, por më pëlqen fare pak kompleksiteti i infrastrukturës që kërkohet për të nisur Druid dhe Pinot - është një grumbull i madh "pjesësh lëvizës", të rrethuara nga Java anash.
Druid dhe Pinot janë projekte inkubator të Apache, ecuria e të cilëve ndiqet në detaje nga Apache në faqet e projekteve të tyre në GitHub. Pinot doli në inkubator në tetor 2018, ndërsa Druid lindi 8 muaj më herët - në shkurt.
Mungesa e informacionit rreth mënyrës si funksionon AFS më jep disa pyetje, ndoshta të gabuara. Më intereson, a e kanë vënë re autorët e Pinot se Fondacioni Apache është më i predispozuar ndaj Druid, dhe a e ka shkaktuar kjo marrëdhënie me konkurentin ndjenjën e xhelozisë? A do të ngadalësohet zhvillimi i Druid dhe do të përshpejtohet ai i Pinot, nëse sponsorët që mbështesin të parin, papritmas interesohen për të dytin?
Disavantazhet e ClickHouse
Pjekuria: është e qartë se kjo ende është një teknologji interesante, por në çdo rast, nuk ka asgjë të ngjashme në DBMS-të e tjera kolonuese.
Insertet e vogla funksionojnë keq me shpejtësi të lartë: insertet duhet të ndahen në copa të mëdha, sepse performanca e insertëve të vogla zvogëlohet proporcionalisht me numrin e kolonave në secilën rresht. Kështu ruhet të dhënat në disk në ClickHouse - secila kolone do të thotë 1 skedar ose më shumë, prandaj për të futur 1 rresht që përmban 100 kolona, duhet të hapet dhe shkruhet të paktën 100 skedarë. Kjo është arsyeja pse është e nevojshme një ndërmjetës për tamponimin e insertëve (nëse vetë klienti nuk ofron tamponimin) - zakonisht kjo është Kafka ose ndonjë sistem menaxhimi të radhëve. Mund të përdoret gjithashtu motorri Buffer table, për të kopjuar më vonë copa të mëdha të të dhënave në tabelat MergeTree.
Lidhjet e tabelave janë të kufizuara nga memorie e serverit, por të paktën, ato ekzistojnë atje! Për shembull, Druid dhe Pinot nuk kanë fare lidhje të tilla, sepse ato janë të vështira për t'u realizuar direkt në sistemet e shpërndara, të cilat nuk mbështesin zhvendosjen e copave të mëdha të të dhënave midis nyjeve.
Përfundimet
Në vitet e ardhshme, ne planifikojmë të përdorim gjerësisht ClickHouse në Qwintry, pasi kjo bazë të dhënash ofron një balancë të shkëlqyer midis performancës, kostove të ulta, shkallëzueshmërisë dhe thjeshtësisë. Jam pothuajse i sigurt se ajo do të fillojë të përhapej shpejt, sapo komuniteti ClickHouse të gjejë më shumë mënyra për ta përdorur në instalime të vogla dhe mesatare.
Pak reklamë 🙂
Faleminderit që po qëndroni me ne. Ju pëlqen artikujt tanë? Doni të shihni më shumë materiale interesante? Na mbështesni duke bërë një porosi ose duke rekomanduar tek miqtë tuaj, , një analog unik i serverëve entry-level që e kemi shpikur për Ju: (opcionet me RAID1 dhe RAID10, deri në 24 bërthama dhe deri në 40GB DDR4 janë të disponueshme).
Dell R730xd dyfish më i lirë në qendër të të dhënave Equinix Tier IV në Amsterdam? Vetëm te ne në Holandë! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — nga $99! Lexoni rreth
Burimi: habr.com
