

Algoritmet e menaxhuara nga të dhënat, si rrjetet nervore, kanë kapur botën me fuqinë e tyre. Zhvillimi i tyre është shkaktuar nga disa arsye, duke përfshirë pajisjet e lira dhe të fuqishme dhe volumin e madh të të dhënave. Rrjetet nervore aktualisht janë në avangardën e gjithçkaje që ka të bëjë me detyrat "kognitive", si njohja e imazheve, kuptimi i gjuhës natyrore etj. Por ato nuk duhet të kufizohen në këto detyra. Ky material trajton një mënyrë për të kompresuar imazhet duke përdorur rrjetet nervore, përmes mësimit rezidual. Qasja e paraqitur në këtë artikull funksionon më shpejt dhe më mirë se kodekët standardë. Skemat, ekuacionet dhe, natyrisht, tabela me testet janë në fund.
Ky artikull bazohet në punimin. Supozohet se jeni të njohur me rrjetet nervore dhe konceptet e tyre konvolucioni dhe funksioni i humbjeve.
Çfarë është kompresimi i imazheve dhe cilat janë llojet e tij?
Kompresimi i imazheve është procesi i transformimit të një imazhi në një formë që zë më pak vend. Thjesht ruajtja e imazheve do të zinte shumë hapësirë, prandaj ekzistojnë kodekët, si JPEG dhe PNG, të cilët kanë për qëllim të zvogëlojnë madhësinë e imazhit origjinal.
Siç dihet, ekzistojnë dy lloje të kompresimit të imazheve: pa humbje dhe me humbje. Siç del nga emrat, gjatë kompresimit pa humbje mund të rikthehen të dhënat e imazhit origjinal, ndërsa gjatë kompresimit me humbje disa të dhëna humbasin gjatë procesit të kompresimit. Për shembull, JPG janë algoritme me humbje [shën. përcjellës — në thelb, mos harrojmë as JPEG pa humbje], ndërsa PNG është një algoritëm pa humbje.
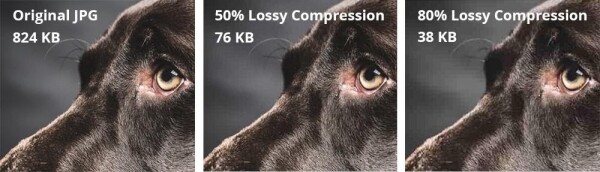
Krahasimi i kompresimit pa humbje dhe me humbje
Vini rehat, se në imazhin në anën e djathtë ka shumë artefakte blokore. Kjo është informacion i humbur. Pixeler e ngjyrave të ngjashme ngjeshen si një zonë për të kursyer hapësirë, por duke humbur informacionin mbi pixelat e vërtetë. Sigurisht, algoritmet e aplikuara në kodekët JPEG, PNG etj., janë shumë më të komplikuara, por kjo është një shembull intuitiv i ngjeshjes me humbje. Ngjeshja pa humbje është e mirë, por skedarët e ngjeshur pa humbje zënë shumë hapësirë në disk. Ka manera më efikase për të ngjeshur imazhet pa humbur shumë informacion, por ato janë mjaft të ngadalta, dhe shumë prej tyre përdorin qasje iteruese. Kjo do të thotë se ato nuk mund të ekzekutohen paralelisht në disa bërthama të procesorit qendror ose grafik. Ky kufizim e bën ato krejtësisht të paprakteshëm për përdorim të përditshëm.
Hyrja e rrjetit nervor konvolucional
Nëse duhet të llogaritet diçka dhe llogaritjet mund të jenë afër, shtoni . Autorët përdorën një rrjet nervor konvolucional të zakonshëm për të përmirësuar ngjeshjen e imazheve. Metoda e paraqitur jo vetëm që funksionon në nivelin e zgjidhjeve më të mira (nëse jo më mirë), por gjithashtu mund të përdorë llogaritje paralel, çka çon në një rritje të madhe të shpejtësisë. Arsyetimi është se rrjetet nervore konvolucionale (CNN) janë shumë të mira në nxjerrjen e informacionit hapësinor nga imazhet, të cilat më pas paraqiten në një formë më kompakte (për shembull, ruhet vetëm “biti” i rëndësishëm të imazhit). Autorët duan të përdorin këtë mundësi të CNN për të përfaqësuar imazhet më mirë.
Arkitektura
Autorët propozuan një rrjet të dyfishtë. Rrjeti i parë merr si input imazhin dhe gjeneron një përfaqësim kompakt (ComCNN). Të dhënat e daljes së këtij rrjeti më pas përpunohen nga një kodek standard (për shembull, JPEG). Pas përpunimit nga kodeku, imazhi i kalon në rrjetin e dytë, i cili "korrigjon" imazhin nga kodeku në përpjekje për të rikthyer imazhin origjinal. Autorët e quajtën këtë rrjet CNN rikrijues (RecCNN). Ngjashëm me GAN, të dy rrjetet stërviten në mënyrë iteruese.
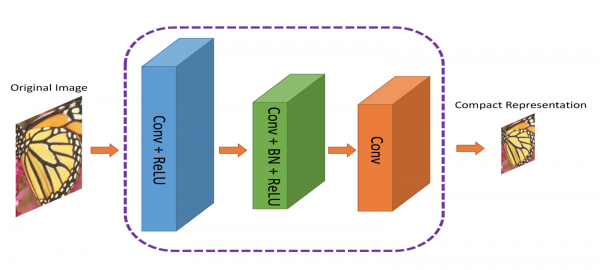
ComCNN Pëfaqësimi kompakt i kalon kodekut standard
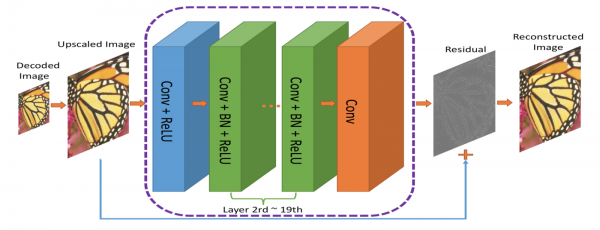
RecCNN. Të dhënat e daljes nga ComCNN shkallëzohen me rritjen dhe kalohen në RecCNN, e cila do të përpiqet të mësojë mbetjen
Daljet e kodit shkallëzohen me rritjen e tyre dhe më pas transmetohen në RecCNN. RecCNN do të përpiqet të prodhojë një imazh që i ngjan origjinalit sa më shumë që të jetë e mundur.
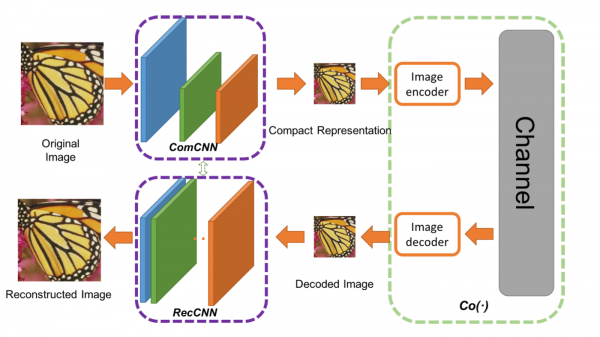
Një kornizë kompresimi për imazhe. Co(.) është një algoritëm kompresimi imazhesh. Autorët aplikojnë JPEG, JPEG2000 dhe BPG.
Çfarë është mbetja?
Mbetja mund të konsiderohet si një hap post-procesimi për "përmirësimin" e imazhit të dekoduar nga kodeku. Me më shumë "informacione" për botën, rrjeti nervor mund të marr vendime kognitive rreth asaj që duhet të korrigjohet. Kjo ide bazohet në , detajet e të cilave mund të lexoni .
Funksionet e humbjes
Dy funksione humbjeje përdoren sepse kemi dy rrjete nervore. E para, ComCNN, është e etiketuar si L1 dhe përcaktohet si:
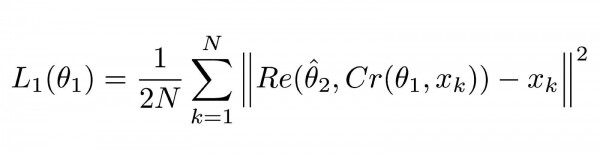
Funksioni i humbjes për ComCNN
Shpjegimi
Ky ekuacion mund të duket i komplikuar, por në të vërtetë është standard (gabimi mesatar katror) MSE. ||² do të thotë norma e vektorit që ata përfshijnë.
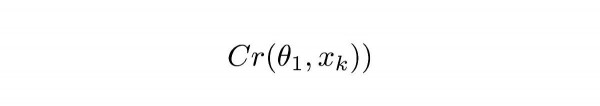
Ekuacioni 1.1
Cr tregon daljet e ComCNN. θ tregon aftësinë e parametrave të ComCNN, XK është imazhi hyrës.
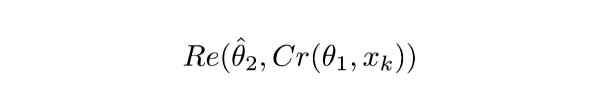
Ekuacioni 1.2
Re() tregon RecCNN. Ky ekuacion vetëm se përcjell vlerën e ekuacionit 1.1 në RecCNN. θ tregon parametrat e trajnuar të RecCNN (kapaku mbi tregon se parametrat janë të fiksuar).
Definimi intuitiv
Ekuacioni 1.0 do ta bëjë ComCNN të ndryshojë peshat e veta në mënyrë që, pas rikrijimit me RecCNN, imazhi përfundimtar të duket sa më i ngjashëm me imazhin hyrës. Funksioni i dytë i humbjes RecCNN përcaktohet si:
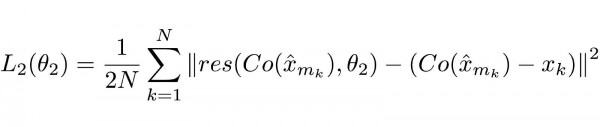
Ekuacioni 2.0
Shpjegimi
Edhe një herë, funksioni mund të duket i komplikuar, por në të vërtetë është kryesisht një funksion standard humbjeje për rrjetin nervor (MSE).
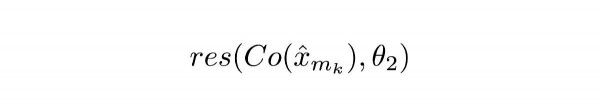
Ekuacioni 2.1
Co() tregon daljen e kodekut, x me kapak mbi tregon daljen e ComCNN. θ2 janë parametrat e trajnuar të RecCNN, res() është thjesht dalja mbetëse e RecCNN. Vlen të theksohet se RecCNN mësohet mbi diferencën midis Co() dhe imazhit hyrës, por jo mbi imazhin hyrës.
Definimi intuitiv
Ekuacioni 2.0 do ta bëjë RecCNN të ndryshojë peshat e veta në mënyrë që daljet të duken sa më të ngjashme me imazhin hyrës.
Skema e mësimit
Modelet trajnohen në mënyrë iteruese, si Pesha e modelit të parë regjistrohet, derisa pesha e modelit të dytë përditësohet, pastaj pesha e modelit të dytë regjistrohet, derisa modeli i parë mëson.
Testet
Autoret krahasuan metodën e tyre me metodat ekzistuese, duke përfshirë kodekët e thjeshtë. Metoda e tyre punon më mirë se të tjerat, duke mbajtur gjithashtu një shpejtësi të lartë në pajisjet përkatëse. Për më tepër, autoret u përpoqën të përdorin vetëm një nga dy rrjetet dhe vërejtën një rënie të performancës.
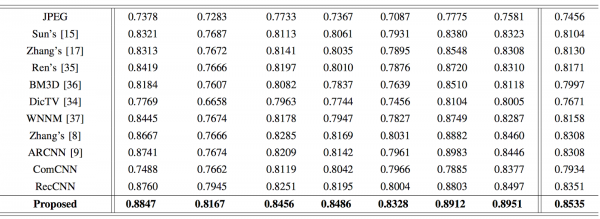
Krahasimi i indeksit të ngjashmërisë strukturore (SSIM). Vlerat e larta tregojnë ngjashmëri më të mirë me origjinalin. Rezultati i autorëve është i theksuar me shkronja të trasha.
Përfundim
Ne shqyrtuam një mënyrë të re për aplikimin e mësimit të thellë për kompresimin e imazheve, folëm për mundësinë e përdorimit të rrjeteve nervore në detyra përveç atyre ‘të zakonshmet’, si klasifikimi i imazheve dhe përpunimi i gjuhës. Kjo metodë jo vetëm që plotëson kërkesat moderne, por gjithashtu lejon përpunimin e imazheve shumë më shpejt.
Të studiuarit e rrjeteve nervore është bërë më e lehtë, pasi përveç kësaj për përdoruesit e Habrave kemi krijuar një kod promovues. HABR, i cili ofron një zbritje shtesë prej 10% mbi zbritjen e treguar në banner.
Kurse të tjera
Artikuj të rekomanduar
Burimi: habr.com
