

Përshëndetje, Habr! Aktualisht në OTUS është hapur regjistrimi për një grup të ri të kursit . Në prag të fillimit të kursit, ne kemi përgatitur tradicionalisht për ju një përkthim të një materiali interesant.
Çdo ditë më shumë se njëqind milion njerëz vizitojnë Twitter-in për të mësuar se çfarë po ndodh në botë dhe për ta diskutuar atë. Çdo tweet dhe çdo veprim tjetër i përdoruesit gjeneron një ngjarje, e cila është e disponueshme për analizën e brendshme të të dhënave në Twitter. Qindra punonjës analizojnë dhe vizualizojnë këto të dhëna dhe përmirësimi i përvojës së tyre është prioriteti kryesor për ekipin e Platformës së të Dhënave të Twitter.
Ne mendojmë se përdoruesit me një gamë të gjerë aftësish teknike duhet të kenë mundësinë të gjejnë të dhënat dhe të kenë qasje në mjete të mira për analizë dhe vizualizim të bazuara në SQL. Kjo do t'i lejonte një grup të ri përdoruesish me një zbehje më të vogël teknike, duke përfshirë analistët e të dhënave dhe menaxherët e produkteve, të nxjerrin informacion nga të dhënat, duke u lejuar atyre të kuptojnë dhe të përdorin më mirë mundësitë e Twitter. Kështu po demokratizojmë analizën e të dhënave në Twitter.
Me përmirësimin e mjeteve tona dhe mundësive për analizën e brendshme të të dhënave, kemi parë përmirësime në shërbimin e Twitter-it. Megjithatë, ka ende shumë për të bërë. Mjetet aktuale, si Scalding, kërkojnë përvojë në programim. Mjetet për analizën e bazuar në SQL, si Presto dhe Vertica, kanë probleme me performancën në një shkallë të madhe. Ne gjithashtu kemi një problem me shpërndarjen e të dhënave përmes disa sistemeve pa një qasje të vazhdueshme në to.
Vit të kaluar ne shpallëm , në kuadër të të cilit po transferojmë pjesë të në Google Cloud Platform (GCP). Ne arritëm në përfundimin se mjetet e Google Cloud mund të na ndihmojnë në iniciativat tona për demokratizimin e analizës, vizualizimit dhe mësimit të makinerive në Twitter:
- : një depo e të dhënave të korporatave me një motor SQL të bazuar në , i njohur për shpejtësinë, thjeshtësinë dhe përballimin e .
- një mjet për vizualizimin e të dhënave të mëdha me funksione bashkëpunuese, si në Google Docs.
Nga ky artikull do të mësoni për përvojën tonë me këto mjete: çfarë kemi bërë, çfarë kemi mësuar dhe çfarë do të bëjmë më pas. Tani do të përqendrohemi në analizën e grupuar dhe interaktive. Analizën në kohë reale do ta diskutojmë në artikullin e ardhshëm.
Historia e depozitave të të dhënave në Twitter
Para se të thellohemi në BigQuery, vlen të përmendet shkurtimisht historia e depozitave të të dhënave në Twitter. Në vitin 2011, analiza e të dhënave në Twitter bëhej në Vertica dhe Hadoop. Për të krijuar MapReduce për funksionin Hadoop, ne përdorëm Pig. Në vitin 2012, e zëvendësuam Pig me Scalding, i cili kishte një API në Scala me përparësi si krijimi i tubacioneve komplekse dhe lehtësia e testimit. Sidoqoftë, për shumë analistë të të dhënave dhe menaxherë produktesh, të cilët ndiheshin më rehat të punonin me SQL, kjo was një përshtatje e vështirë e mësimit. Rreth vitit 2016 nisi përdorimi i Presto si ndërfaqe SQL për të dhënat e Hadoop. Spark ofronte një ndërfaqe në Python, që e bënte atë një zgjedhje të mirë për kërkime ad hoc të të dhënave dhe mësim makinerie.
Që nga viti 2018 kemi përdorur këto mjete për analizën dhe vizualizimin e të dhënave:
- Scalding për tubacionet prodhuese
- Scalding dhe Spark për analiza ad hoc të të dhënave dhe mësim makinerie
- Vertica dhe Presto për analizë ad hoc dhe interaktive SQL
- Druid për qasje interaktive të vogël, eksploruese dhe me vonesë të vogël në metrikat e serive temporale
- Tableau, Zeppelin dhe Pivot për vizualizimin e të dhënave
Kemi zbuluar se, ndërsa këto mjete ofrojnë mundësi shumë të fuqishme, kemi hasur vështirësi në realizimin e aksesit të këtyre mundësive për një audiencë më të gjerë në Twitter. Duke zgjeruar platformën tonë me Google Cloud, ne përqendrohemi në thjeshtimin e mjeteve tona analitike për të gjithë Twitterin.
Depozita e dhënave BigQuery nga Google
Disa prej ekipeve në Twitter tashmë e kanë përfshirë BigQuery në disa nga pipeline-t e tyre të prodhimit. Duke përdorur përvojën e tyre, ne filluam të vlerësojmë mundësitë e BigQuery për të gjitha skenaret e përdorimit në Twitter. Qëllimi ynë ishte të ofronim BigQuery për të gjithë kompaninë, si dhe të standardizonim dhe mbështetnim atë brenda grupit të mjeteve të Platformës së të Dhënave. Kjo ishte e vështirë për shumë arsye. Na nevojitej të zhvillonim një infrastrukturë për të pranuar në mënyrë të besueshme sasi të mëdha të dhënash, për të mbështetur menaxhimin e të dhënave në shkallë të gjerë, për të siguruar kontroll të duhur të aksesit dhe për të ruajtur privatësinë e klientëve. Ne gjithashtu duhej të krijonim sisteme për shpërndarjen e burimeve, monitorimin dhe rikthimin e pagesave, në mënyrë që ekipet të mund të përdornin në mënyrë efektive BigQuery.
Në nëntor 2018, ne lëshuam një version alfa të BigQuery dhe Data Studio për të gjithë kompaninë. Ne u ofruam punonjësve të Twitter disa nga tabelat tona të përdorura më shpesh me të dhëna personale të pastra. BigQuery e kanë përdorur më shumë se 250 përdorues nga ekipe të ndryshme, duke përfshirë inxhinieri, financa dhe marketing. Së fundmi, ata realizuan rreth 8,000 kërkesa, duke përpunuar rreth 100 PB në muaj, përveç kërkesave të planifikuara. Duke marrë feedback shumë pozitiv, ne vendosëm të vazhdonim përpara dhe të ofronim BigQuery si burimin kryesor për ndërveprimin me të dhënat në Twitter.
Këtu është skema e arkitekturës së nivelit të lartë të depozitës sonë të të dhënave Google BigQuery.
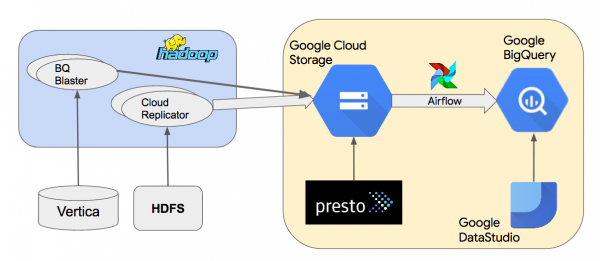
Ne kopjojmë të dhënat nga klasterët lokalë Hadoop në Google Cloud Storage (GCS), duke përdorur një mjet të brendshëm Cloud Replicator. Më pas, ne përdorim Apache Airflow për të krijuar pipeline-t që përdorin "" për të ngarkuar të dhënat nga GCS në BigQuery. Ne përdorim Presto për të pyetur grupe të dhënash Parquet ose Thrift-LZO në GCS. BQ Blaster është një mjet i brendshëm Scalding për ngarkimin e grupeve të dhënash HDFS Vertica dhe Thrift-LZO në BigQuery.
Në seksionet në vazhdim do të diskutojmë qasjen tonë dhe njohuritë në lidhje me lehtësinë e përdorimit, performancën, menaxhimin e të dhënave, disponueshmërinë e sistemit dhe kostot.
Lehtësia e përdorimit
Ne kemi zbuluar se përdoruesit ishin të lehtë të fillonin me BigQuery, pasi nuk kërkonte instalimin e softuerit dhe përdoruesit mund të kishin qasje në të përmes një ndërfaqeje intuitive në internet. Megjithatë, ishte e nevojshme që përdoruesit të njiheshin me disa funksione të GCP dhe konceptet e tij, të përfshira burime si projektet, grumbujt e të dhënave dhe tabelat. Ne zhvilluam materiale mësimore dhe tutoriale për të ndihmuar përdoruesit të fillonin punën. Me një kuptim themelor, përdoruesit e gjetën më të lehtë të lëviznin nëpër grumbujt e të dhënave, të shihnin skemën dhe të dhënat e tabelave, të kryenin kërkesa të thjeshta dhe të vizualizonin rezultatet në Data Studio.
Qëllimi ynë në lidhje me futjen e të dhënave në BigQuery ishte që të sigurohej ngarkimi i qetë i grumbujve të të dhënave HDFS ose GCS me një klik të vetëm. Ne shqyrtuam (Airflow i menaxhuar), por nuk arritëm ta përdornim për shkak të modelit tonë të sigurisë 'Domain Restricted Sharing' (më shumë mbi këtë në seksionin 'Menaxhimi i të Dhënave' më poshtë). Ne eksperimentuam me përdorimin e Shërbimit të Transferimit të Të Dhënave të Google (DTS) për të organizuar detyrat e ngarkesave në BigQuery. Ndërsa DTS u konfiguruar shpejt, nuk ishte fleksibël për ndërtimin e konvejereve me varësi. Për versionin tonë alfa, ne krijuam një ambient tonin Apache Airflow në GCE dhe po e përgatisim për prodhim dhe për mundësitë për të mbështetur më shumë burime të dhënash si Vertica.
Për të transformuar të dhënat në BigQuery, përdoruesit krijojnë kontejnerë të thjeshtë të të dhënave SQL, duke përdorur kërkesa të planifikuara. Për kontejnerë të ndërlikuar me shumë hapa me varësi, ne planifikojmë të përdorim ose infrastrukturën tonë Airflow ose Cloud Composer së bashku me .
Performanca
BigQuery është krijuar për kërkesa SQL për përdorim të përgjithshëm, që përpunojnë sasi të mëdha të dhënash. Ai nuk është i dizajnuar për kërkesa me vonesa të ulëta, me kapacitet të lartë që janë të nevojshme për bazat e të dhënave transaksionale, ose për analizën e serive temporale me vonesë të ulët, që është realizuar . Në pyetjet interaktive analitike, përdoruesit tanë presin një kohë përgjigjeje më pak se një minutë. Duhej të dizajnojmë përdorimin e BigQuery në mënyrë që të përputhej me këto pritshmëri. Për të siguruar një performancë të parashikueshme për përdoruesit tanë, përdorëm funksionalitetin e BigQuery që është në dispozicion për klientët me pagesë fikse, e cila lejon pronarët e projekteve të rezervojnë një numër minimal slots për pyetjet e tyre. BigQuery është një njësi e fuqisë llogaritëse që nevojitet për të kryer pyetje SQL.
Analizuam më shumë se 800 pyetje që procesojnë rreth 1 TB të dhënash çdo një, dhe zbuluam se koha mesatare e ekzekutimit ishte 30 sekonda. Mësojmë gjithashtu se performanca varet shumë nga përdorimi i slot-it tonë në projekte dhe detyra të ndryshme. Duhej të ndanim qartë rezervat tona të slot-ve për prodhim dhe ad hoc, për të mbështetur performancën për skenaret e përdorimit prodhues dhe analizën interaktive. Kjo kishte një ndikim të fortë në dizajnin tonë për rezervimin e slot-ve dhe hierarkinë e projekteve.
Për menaxhimin e të dhënave, funksionalitetin dhe koston e sistemeve, do të flasim në ditët në vijim në pjesën e dytë të përkthimit, por tani ftojmë të gjithë të interesuarit në , në kuadër të cilit do të keni mundësi të mësoni në detaje rreth kursit, si dhe të bëni pyetje ekspertit tonë — Yegor Mateushku (Inxhinier i të Dhënave të Larta, MaximaTelecom).
Lexoni më shumë:
Burimi: habr.com
