

Nëse punoni me Kubernetes, ndoshta kubectl është një nga utilitetet që përdorni më shpesh. Dhe sa herë që kaloni shumë kohë duke punuar me një instrument të caktuar, ia vlen ta studiojmë mirë dhe të mësojmë si ta përdorim atë efikasht.
Ekipa kam përkthyer artikullin e Daniel Weibels, ku do të gjeni këshilla dhe truke për një punë efektive me kubectl. Gjithashtu, do t'ju ndihmojë të kuptoni më thellë funksionimin e Kubernetes.
Sipas autorit, qëllimi i artikullit është të bëjë punën tuaj të përditshme me Kubernetes jo vetëm më efektive, por edhe më të këndshme!
Hyrje: çfarë është kubectl
Para se të filloni të mësoni si ta përdorni kubectl më efikasht, duhet të merrni një kuptim bazik të asaj që është dhe si funksionon.
Nga pikëpamja e përdoruesit, kubectl është një panel menaxhimi që lejon kryerjen e operacioneve Kubernetes.
Nga pikëpamja teknike, kubectl është klienti i API-së Kubernetes.
API-ja Kubernetes është një API HTTP REST. Ky API është vërtet ndërfaqja e përdoruesit të Kubernetes, përmes të cilës ai kontrollohet plotësisht. Kjo do të thotë se çdo operacion Kubernetes paraqitet si një pikë fundore API dhe mund të realizohet me një kërkesë HTTP ndaj kësaj pikë fundore.
Prandaj, detyra kryesore e kubectl është të realizojë kërkesa HTTP ndaj API-së Kubernetes:
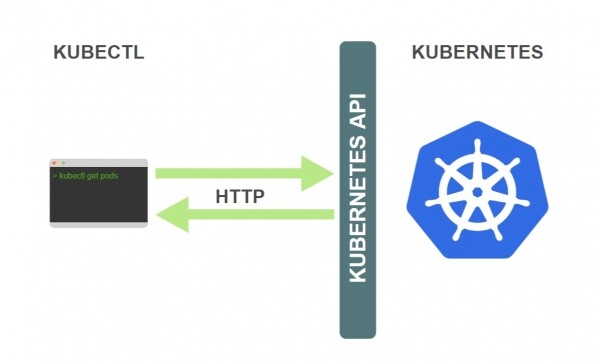
Kubernetes është një sistem plotësisht të orientuar ndaj burimeve. Kjo do të thotë se ai ruan gjendjen e brendshme të burimeve dhe të gjitha operacionet Kubernetes janë operacione CRUD.
Ju kontrolloni plotësisht Kubernetes duke menaxhuar këto burime, dhe Kubernetes e kupton se çfarë duhet të bëjë në bazë të gjendjes aktuale të burimeve. Për këtë arsye, lidhja me API-në Kubernetes është e organizuar në formën e një liste të tipeve të burimeve me operacionet përkatëse.
Le të shqyrtojmë një shembull.
Supozoni se dëshironi të krijoni një burim ReplicaSet. Për ta bërë këtë, e përshkruani ReplicaSet-in në një skedë me emrin replicaset.yaml, pastaj ekzekutoni komandën:
$ kubectl create -f replicaset.yamlSi rezultat, do të krijohet një burim ReplicaSet. Por çfarë ndodh pas këtij procesi?
Në Kubernetes ekziston një operacion për krijimin e ReplicaSet. Si çdo operacion tjetër, ajo ofrohet si një pikë fundore API. Pika specifike fundore API për këtë operacion duket kështu:
POST /apis/apps/v1/namespaces/{namespace}/replicasetsPikat fundore API për të gjitha operacionet Kubernetes mund të gjenden në (duke përfshirë ). Për të bërë një kërkesë reale në pikën përfundimtare, duhet të shtoni paraprakisht adresën URL të serverit API te rrugët e pikës përfundimtare që janë të detajuara në manualin e API-së.
Prandaj, kur ekzekutoni komandën e mësipërme, kubectl dërgon një kërkesë HTTP POST në pikën përfundimtare të sipërpërmendur të API-së. Përkufizimi i ReplicaSet që keni specifikuar në skedarin replicaset.yaml, dërgohet në trupin e kërkesës.
Kështu funksionon kubectl për të gjitha komandat që ndërveprojnë me klusterin Kubernetes. Në të gjitha këto raste, kubectl thjesht dërgon kërkesa HTTP në pikët përfundimtare përkatëse të API-së Kubernetes.
Vini re se mund të menaxhoni plotësisht Kubernetes me një utilitar si curl, duke dërguar manualisht kërkesa HTTP në API-në Kubernetes. Kubectl thjesht e thjeshton përdorimin e API-së Kubernetes.
Këto janë bazat e asaj çfarë është kubectl dhe si funksionon. Por ka edhe diçka tjetër për API-në Kubernetes që çdo përdorues i kubectl duhet të dijë. Le të hedhim një shikim të shkurtër brenda botës së brendshme të Kubernetes.
Bota e brendshme e Kubernetes
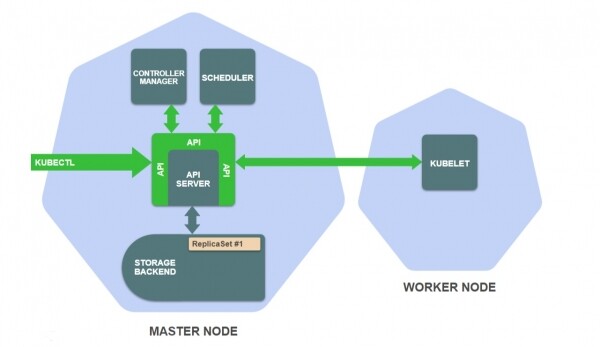
Kubernetes përbëhet nga një grup komponentësh të pavarur që funksionojnë si procese të ndara në nyjet e klasterit. Disa komponentë funksionojnë në nyjat kryesore, të tjerë në nyjat punuese, secili komponent ka detyrën e tij të veçantë.
Këtu janë komponentët më të rëndësishëm në nyjat kryesore:
- Depoze — ruan përkufizimet e burimeve ().
- Serveri API — ofron API-në dhe menaxhon depozën.
- Menaxheri i kontrollorëve — siguron që statuset e burimeve përputhen me specifikimet.
- Dy ndryshime të dukshme në planifikim (të dyja në versionin alfa): — planifikon pod-et në nyjat punuese.
Dhe ja një komponent shumë i rëndësishëm në nyjat punuese:
- ka filluar të përdorë — menaxhon ekzekutimin e kontejnerëve në nyjën punuese.
Për të kuptuar se si këta komponentë funksionojnë së bashku, le të shqyrtojmë një shembull.
Supozoni se sapo keni ekzekutuar kubectl create -f replicaset.yaml, pas së cilës kubectl bëri një kërkesë HTTP POST në (duke dërguar përkufizimin e burimit të ReplicaSet).
Çfarë ndodh në kluster?
- Pas ekzekutimit
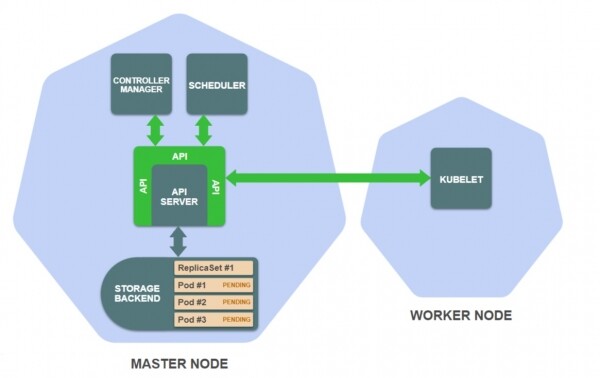
kubectl create -f replicaset.yamlServeri API ruan përkufizimin e burimit tuaj ReplicaSet në depo:
- Më pas, kontrollori i ReplicaSet fillon në menaxherin e kontrollorëve, i cili merr përsipër krijimin, modifikimin dhe fshirjen e burimeve të ReplicaSet:

- Kontrollori i ReplicaSet krijon përkufizimin e pod-it për çdo replike të ReplicaSet (në përputhje me modelin e pod-it në përkufizimin e ReplicaSet) dhe i ruan ato në depo:

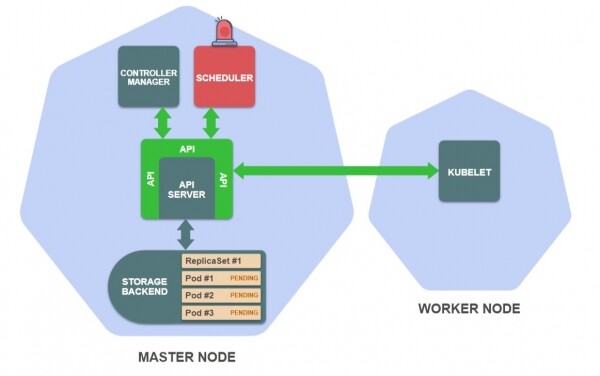
- Një planifikues aktivizohet për të ndjekur pod-ët që ende nuk janë caktuar për ndonjë nodë pune:

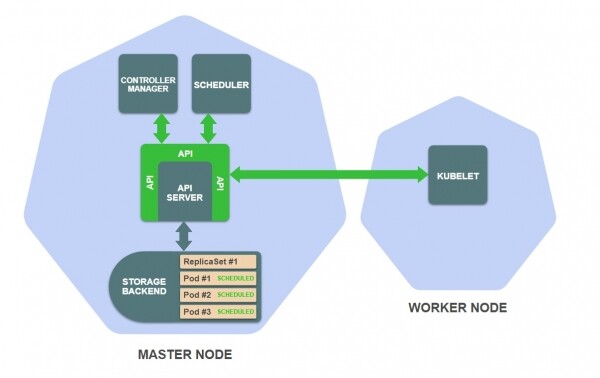
- Planifikuesi zgjedh një nodë pune të përshtatshme për çdo pod dhe e shton këtë informacion në definicionin e pod-it në ruajtje:
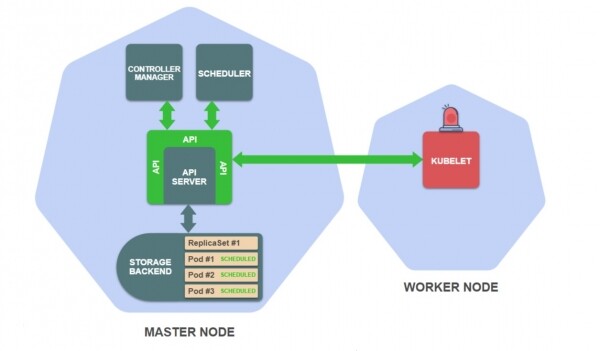
- Në nodën e punës të caktuar për pod, nis Kubelet, i cili ndjek pod-ët e caktuar për këtë nodë:

- Kubelet lexon definicionin e pod-it nga ruajtja dhe i jep urdhra mjedisit të ekzekutimit të konteinerëve, si Docker, për të nisur konteinerit në nodë:

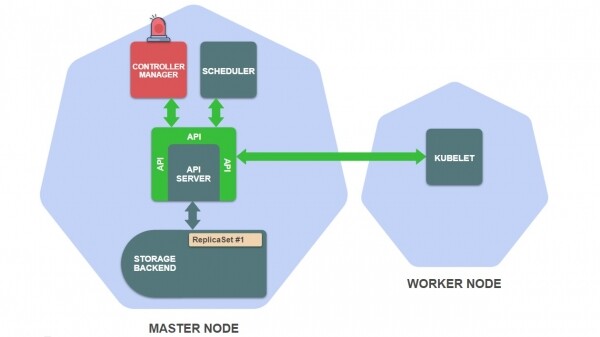
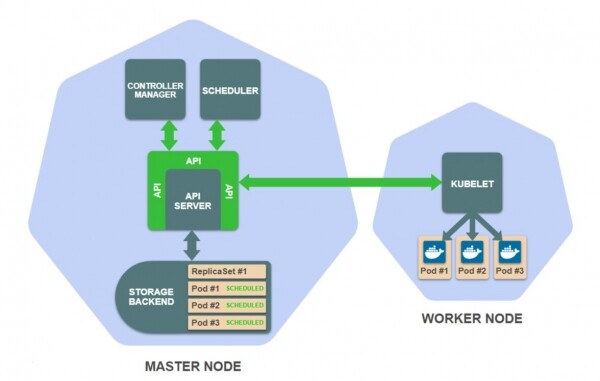
Më poshtë është një version tekstual i këtij përshkrimi.
Një kërkesë API në pikën e fundit për krijimin e ReplicaSet përpunon nga serveri API. Serveri API autentifikon kërkesën dhe ruan definicionin e burimit të ReplicaSet në ruajtje.
Ky ngjarje aktivizon kontrolluesin e ReplicaSet, i cili është një nënproces i menaxherit të kontrolluesve. Kontrolluesi i ReplicaSet ndjek krijimin, përditësimin dhe fshirjen e burimeve të ReplicaSet në ruajtje dhe merr njoftimin për ngjarjen kur ndodh kjo.
Detyra e kontrolluesit të ReplicaSet është të sigurojë që të ekzistojë numri i nevojshëm i pod-ëve të replikës ReplicaSet. Në shembullin tonë, nuk ka pod-e ende, kështu që kontrolluesi i ReplicaSet krijon këto definita pod-ësh (në përputhje me shabllonin e pod-it në definicionin e ReplicaSet) dhe i ruan ato në ruajtje.
Krijimi i pod-eve të reja aktivizon planifikuesin, i cili ndjek definitat e pod-ëve që ende nuk janë planifikuar për nodat e punës. Planifikuesi zgjedh një nodë pune të përshtatshme për çdo pod dhe përditëson definitat e pod-ëve në ruajtje.
Vini re se deri në këtë moment, askund në kluster nuk është ekzekutuar kodi i ngarkesës së punës. Gjithçka që është bërë deri tani, — është krijimi dhe përditësimi i burimeve në ruajtje në nodën kryesore.
Ngjarja e fundit aktivizon Kubelet-in, i cili ndjek pod-ët e planifikuar për nodat e tyre të punës. Kubelet-i i nodës së punës, për të cilën janë caktuar pod-et tuaja të ReplicaSet, duhet t'i japë urdhra mjedisit të ekzekutimit të konteinerëve, si Docker, për të ngarkuar imazhet e nevojshme të konteinerëve dhe për t'i nisur ato.
Në këtë moment, përfundimisht, aplikacioni juaj ReplicaSet është nisur!
Roli i API-së Kubernetes
Siç e patë në shembullin e mëparshëm, komponentët e Kubernetes (përveç serverit API dhe ruajtjes) ndjekin ndryshimin e burimeve në ruajtje dhe ndryshojnë informacionin për burimet në ruajtje.
Sigurisht, këto komponentë nuk ndërveprojnë drejtpërdrejt me magazinën, por vetëm nëpërmjet API të Kubernetes.
Le të shqyrtojmë shembujt e mëposhtëm:
- Kontrolluesi ReplicaSet përdor pikën përfundimtare API në anën
watchpër të monitoruar ndryshimet e burimeve të ReplicaSet. - Kontrolluesi ReplicaSet përdor pikën përfundimtare API (krijoni pod) për të krijuar pods.
- Planifikuesi përdor pikën përfundimtare API (modifikoni pod) për të përditësuar pods me informacionin rreth nodave të zgjedhura për punë.
Siç mund ta shihni, kjo është e njëjta API që përdor kubectl. Përdorimi i të njëjtës API për të punuar me komponentët e brendshëm dhe përdoruesit e jashtëm është një koncept themelor i dizajnit të Kubernetes.
Tani mund të përmbledhim se si funksionon Kubernetes:
- Magazina ruan gjendjen, pra burimet e Kubernetes.
- API serveri ofron një ndërfaqe për magazinën në formën e API të Kubernetes.
- Të gjitha komponentët e tjerë dhe përdoruesit e Kubernetes lexojnë, monitorojnë dhe manipulojnë gjendjen (burimet) e Kubernetes përmes API-së.
Njohja e këtyre koncepteve do të ndihmojë në kuptimin më të mirë të kubectl dhe në shfrytëzimin e tij në maksimum.
Tani le të shqyrtojmë një sërë këshillash dhe trukesh konkrete që ndihmojnë në rritjen e produktivitetit me kubectl.
1. Shpejtimi i hyrjes përmes përfundimit të komandave
Një nga teknikët më të dobishme, por shpesh të injoruara, që ndihmojnë në rritjen e produktivitetit me kubectl është përfundimi i komandave.
Përfundimi i komandave lejon plotësimin automatik të pjesëve të veçanta të komandave kubectl me të prekurin e butonit Tab. Kjo punon për subkomandat, opsionet dhe argumentet, përfshirë ato komplekse si emrat e burimeve.
Shikoni se si funksionon përfundimi i komandave kubectl:
Përfundimi i komandave funksionon për shell-et Bash dhe Zsh.
përmban udhëzime të detajuara për konfigurinë e përfundimit automatik, por më poshtë do të japim një përmbledhje të shkurtër.
Si funksionon përfundimi i komandave
Përfundimi i komandave është një funksion i shell-it që punon me një skript përfundimi. Skripti përfundimi është një skenar shell-i që përcakton sjelljen e përfundimit për një komandë të caktuar.
Kubectl automatikisht gjeneron dhe nxjerr skriptet e përfundimit për Bash dhe Zsh me komandat e mëposhtme:
$ kubectl completion bashOse:
$ kubectl completion zshTeoretikisht, mjafton të lidheni me daljen e këtyre komandave në shell-in përkatës, që kubectl të mund të përfundojë komandat.
Në praktikë, mënyra e lidhjes ndryshon për Bash (duke përfshirë ndryshimet midis Linux dhe MacOS) dhe Zsh. Më poshtë do të shqyrtojmë të gjitha këto variante.
Bash në Linux
Skripti i plotësimit për Bash varet nga paketa bash-completion, prandaj është e nevojshme ta instaloni atë fillimisht:
$ sudo apt-get install bash-completionOse:
$ yum install bash-completionMund të testoni nëse paketa është instaluar me sukses përmes komandës së mëposhtme:
$ type _init_completion Nëse kthehet një kod funksioni të shell-it, atëherë bash-completion është instaluar saktë. Nëse komandë jep një gabim 'Nuk u gjend', duhet të shtoni rreshtin e mëposhtëm në skedarin tuaj ~ /.bashrc:
$ source /usr/share/bash-completion/bash_completion Nëse duhet të shtoni këtë rresht në skedar ~ /.bashrc ose jo, varet nga menaxheri i paketave që keni përdorur për instalimin e bash-completion. Për APT është e nevojshme, për YUM nuk është.
Pas instalimit të bash-completion, duhet të konfiguroni gjithçka në mënyrë që skripti i plotësimit kubectl të përfshihet në të gjitha seancat e shell-it.
Një nga mënyrat për ta bërë këtë është të shtoni rreshtin e mëposhtëm në skedarin ~ /.bashrc:
source <(kubectl completion bash) Një tjetër mënyrë është të shtoni skriptin e plotësimit kubectl në katalogun /etc/bash_completion.d (krijoni atë nëse nuk ekziston):
$ kubectl completion bash > /etc/bash_completion.d/kubectl Të gjitha skriptet e plotësimit në katalog /etc/bash_completion.d përfshihen automatikisht në bash-completion.
Të dyja mundësitë janë po aq të aplikueshme.
Pas ri-ngarkimit të shell-it, plotësimi automatik i komandave kubectl do të funksionojë.
Bash në MacOS
Në MacOS, konfigurimi është pak më i komplikuar. Kjo për shkak se, për default, në MacOS është Bash version 3.2, dhe skripti i plotësimit automatik kubectl kërkon version 4.1 ose më të lartë dhe nuk funksionon në Bash 3.2.
Përdorimi i një versioni të vjetër të Bash në MacOS është në lidhje me çështjet e licencimit. Bash version 4 shpërndahet nën licencën GPLv3, e cila nuk mbështetet nga Apple.
Për të konfiguruar plotësimin automatik kubectl në MacOS, duhet të instaloni një version më të ri të Bash. Ju gjithashtu mund të instaloni Bash të përditësuar si shellin e parazgjedhur, çka do t'ju kursejë një sërë probleme që mund të ndodhin në të ardhmen. Kjo nuk është e komplikuar, detajet janë përmendur në artikullin ‘».
Para se të vazhdoni, sigurohuni që po përdorni një version të ri të Bash (kontrolloni daljen bash --version).
Skripti i plotësimit në Bash varet nga projekti , prandaj fillimisht duhet ta instaloni atë.
Mund ta instaloni bash-completion përmes :
$ brew install bash-completion@2 Këtu @2 tregon bash-completion versioni 2. Autoshpërndarja kubectl kërkon bash-completion v2, dhe bash-completion v2 kërkon versionin e Bash të paktën 4.1.
Dalja e komandës brew-install përmban seksionin Caveats, ku tregohet se duhet të shtoni në skedarin ~/.bash_profile:
export BASH_COMPLETION_COMPAT_DIR=\/usr\/local\/etc\/bash_completion.d\n[[ -r "\/usr\/local\/etc\/profile.d\/bash_completion.sh" ]] && . \n"\/usr\/local\/etc\/profile.d\/bash_completion.sh" Megjithatë, rekomandoj të shtoni këto rreshta jo në ~/.bash_profile, ndërsa në ~/ .bashrc. Në këtë rast, autoshpërndarja do të jetë e disponueshme jo vetëm në shell-in kryesor, por edhe në shell-të dytësore.
Pas rindizjes së shell-it, mund të kontrolloni saktësinë e instalimit duke përdorur komandën e mëposhtme:
$ type _init_completionNëse në daljen e komandës shihni një funksion shell, atëherë gjithçka është konfiguruar siç duhet.
Tani duhet të bëni që autoshpërndarja kubectl të aktivizohet në të gjitha seancat.
Një nga mënyrat është të shtoni rreshtin e mëposhtëm në ~/ .bashrc:
source <(kubectl completion bash) Mënyra tjetër është të shtoni skriptin e autoshpërndarjes në dosjen /usr/local/etc/bash_completion.d:
$ kubectl completion bash\n>\/usr\/local\/etc\/bash_completion.d\/kubectlKjo mënyrë do të funksionojë vetëm nëse keni instaluar bash-completion nëpërmjet Homebrew. Në këtë rast, bash-completion ngarkon të gjitha skriptet nga kjo drejtorinë.
Nëse keni instaluar , nuk është e nevojshme të kryeni hapin e mëparshëm, sepse skripti i autoshpërndarjes do të vendoset automatikisht në dosjen /usr/local/etc/bash_completion.d në kohën e instalimit. Në këtë rast, autoshpërndarja kubectl do të fillojë të funksionojë menjëherë sapo të instaloni bash-completion.
Si përfundim, të gjitha këto mundësi janë ekuivalente.
Zsh
Skriptet e autoshpërndarjes për Zsh nuk kërkojnë asnjë varësi. Gjithçka që duhet është t'i aktivizoni ato gjatë ngarkesës së shell-it.
Mund ta bëni këtë duke shtuar një rresht në skedarin tuaj: ~/.zshrc file:
source <(kubectl completion zsh) Nëse keni marrë një gabim not found: compdef pas rindizjes së shell-it tuaj, duhet të aktivizoni funksionin e ndërtuar compdef. Mund ta aktivizoni duke shtuar në fillim të skedarit tuaj ~/.zshrc si më poshtë:
autoload -Uz compinit\ncompinit2. Shikim i shpejtë i specifikimeve të burimeve
Kur krijoni përkufizime burimesh YAML, duhet të dini fushat dhe vlerën e tyre për këto burime. Një nga vendet për të kërkuar këtë informacion është në udhëzuesin e API-t, i cili përmban specifikime të plota për të gjitha burimet.
Megjithatë, të kalosh në shfletuesin web çdo herë që duhet të kërkosh ndihmë është e pazakontë. Prandaj, kubectl ofron komandën kubectl shpjego, e cila tregon specifikimet e të gjitha burimeve drejtpërdrejt në terminalin tuaj.
Formati i komandës është si më poshtë:
$ kubectl explain resource[.field]...Ekipa do të nxjerrë specifikimin e burimit të kërkuar ose të fushës. Informacioni i nxjerrë është identik me atë që përmban manuali i API-së.
Më në default kubectl shpjego tregon vetëm nivelin e parë të thellësisë së fushave.
Shiko se si duket .
Mund të shfaqësh të gjithë pemën nëse shton opsionin --recursive:
$ kubectl explain deployment.spec --recursiveNëse nuk e di saktësisht se cilat burime të nevojshme, mund të shfaqësh të gjitha burimet me komandën e mëposhtme:
$ kubectl api-resources Kjo komandë shfaq emrat e burimeve në formën shumësore, për shembull, deployed në vend të deployment. Ajo gjithashtu shfaq emrin e shkurtër, për shembujt e atyre burimeve që e kanë atë. Mos u shqetëso për këto dallime. Të gjitha këto variante emrash janë ekuivalente për kubectl. Pra, mund të përdorësh cilindo nga ato për deployTë gjitha komandat e mëposhtme është e barabartë: kubectl shpjego.
$ kubectl explain deployments.spec # ose $ kubectl explain deployment.spec # ose $ kubectl explain deploy.spec
3. Përdor formatin e personalizuar të nxjerrjes së kolonavePër default, formati i nxjerrjes së komandës
kubectl get $ kubectl get pods EMRI GATI STATUS RIKTHEMET MOSHA engine-544b6b6467-22qr6 1/1 Duke funksionuar 0 78d engine-544b6b6467-lw5t8 1/1 Duke funksionuar 0 78d engine-544b6b6467-tvgmg 1/1 Duke funksionuar 0 78d web-ui-6db964458-8pdw4 1/1 Duke funksionuar 0 78d:
Ky format është i përshtatshëm, por përmban numër të kufizuar informacioni. Krahasuar me formatin e plotë të përcaktimit të burimit, këtu shfaqen vetëm disa fusha.Në këtë rast, mund të përdorësh formatin e personalizuar të nxjerrjes së kolonave. Ai lejon përcaktimin se cilat të dhëna të nxirren. Mund të nxjerrësh çdo fushë burimi në një column të veçantë.
Përdorimi i formatit të personalizuar përcaktohet me opsionet:
-o custom-columns=
Mund të përcaktosh çdo kolonë nxjerrjeje me një çift— emri i kolonës, dhe — emri i kolonës, dhe — shprehja që përcakton fushën e burimit. Le të shohim një shembull të thjeshtë:
$ kubectl get pods -o custom-columns='EMRI:metadata.name'EMRI engine-544b6b6467-22qr6 engine-544b6b6467-lw5t8 engine-544b6b6467-tvgmg web-ui-6db964458-8pdw4
Nxjerrja përmban një kolonë me emrat e pods.Shprehja në opsion zgjedh emrat e pods nga fusha
metadata.name . Kjo sepse emri i podit përcaktohet në fushën fëminë name të fushësnë përshkrimin e burimit të podit. Më shumë mund të njihesh në metadata manualin e API-së kubectl explain pod.metadata.name kubectl shpjego pod.metadata.name.
Tani po të supozojmë se dëshironi të shtoni një kolona të shtesës në daljen, për shembull, duke treguar nodin ku funksionon secili pod. Për këtë, mund të thjesht shtoni specifikimin përkatës të kolonave në opsionin e kolonave të zakonshme:
$ kubectl get pods
  -o custom-columns='NAME:metadata.name,NODE:spec.nodeName'

NAME                       NODE
engine-544b6b6467-22qr6    ip-10-0-80-67.ec2.internal
engine-544b6b6467-lw5t8    ip-10-0-36-80.ec2.internal
engine-544b6b6467-tvgmg    ip-10-0-118-34.ec2.internal
web-ui-6db964458-8pdw4     ip-10-0-118-34.ec2.internal
Shprehja përzgjedh emrin e nodit nga spec.nodeName — kur podi caktohet një nodi, emri i saj shkruhet në fushën spec.nodeName e specifikimit të burimeve të podit. Informacione më të detajuara mund të shihni në daljen kubectl explain pod.spec.nodeName.
Kujdes, fushat e burimeve Kubernetes janë të ndjeshme ndaj rastit.
Mund të shikoni çdo fushë burimi si një kolonë. Thjesht shikoni specifikimin e burimit dhe provoni me çfarëdo fushe që dëshironi.
Por së pari le të shqyrtojmë më në detaje shprehjet e përzgjedhjes së fushave.
Shprehjet JSONPath
Shprehjet përzgjedhëse të fushave të burimeve bazohen në .
JSONPath është një gjuhë për të nxjerrë të dhëna nga dokumentet JSON. Përzgjedhja e një fushe është përdorimi më i thjeshtë i JSONPath. Ka shumë , duke përfshirë selektorët, filtrat dhe kështu me radhë.
Kubectl explain mbështet një numër të kufizuar mundësish JSONPath. Më poshtë janë përshkruar mundësitë dhe shembujt e përdorimit të tyre:
# Выбрать все элементы списка
$ kubectl get pods -o custom-columns='DATA:spec.containers[*].image'
# Выбрать специфический элемент списка
$ kubectl get pods -o custom-columns='DATA:spec.containers[0].image'
# Выбрать элементы списка, попадающие под фильтр
$ kubectl get pods -o custom-columns='DATA:spec.containers[?(@.image!="nginx")].image'
# Выбрать все поля по указанному пути, независимо от их имени
$ kubectl get pods -o custom-columns='DATA:metadata.*'
# Выбрать все поля с указанным именем, вне зависимости от их расположения
$ kubectl get pods -o custom-columns='DATA:..image'
Operatori [] ka një rëndësi të veçantë. Shumë fusha burimesh Kubernetes janë lista, dhe ky operator lejon përzgjedhjen e elementeve të këtyre listave. Përdoret shpesh me një wildcard si [*] për të zgjedhur të gjitha elementet e listës.
Shembuj të përdorimit
Mundësitë e përdorimit të formatit të zakonshëm të daljes së kolonave janë të pakufizuara, pasi mund të shfaqni çdo fushë ose kombinim fushash të burimeve në dalje. Ja disa shembuj aplikimesh, por mos hezitoni t'i eksploroni ato vetë dhe të gjeni aplikime të dobishme për ju.
- Shfaqja e imazheve të kontejnerëve për podet:
$ kubectl get pods
  -o custom-columns='NAME:metadata.name,IMAGES:spec.containers[*].image'

NAME                        IMAGES
engine-544b6b6467-22qr6     rabbitmq:3.7.8-management,nginx
engine-544b6b6467-lw5t8     rabbitmq:3.7.8-management,nginx
engine-544b6b6467-tvgmg     rabbitmq:3.7.8-management,nginx
web-ui-6db964458-8pdw4      wordpress
Ky komandë shfaq emrat e imazheve të kontejnerëve për secilin pod.
Mbani se nën mund të përmbajë disa kontejnerë, atëherë emrat e imazheve do të dalin në një rresht të vetëm të ndarë me presje.
- Shfaqja e zonave të disponueshmërisë të nodave:
$ kubectl get nodes
  -o
custom-columns='NAME:metadata.name,ZONE:metadata.labels.failure-domain.beta.kubernetes.io/zone'

NAME                          ZONE
ip-10-0-118-34.ec2.internal   us-east-1b
ip-10-0-36-80.ec2.internal    us-east-1a
ip-10-0-80-67.ec2.internal    us-east-1b
Kjo komandë është e dobishme nëse klasteri juaj është i vendosur në një cloud publik. Ajo shfaq zonën e disponueshmërisë për çdo nodë.
Zona e disponueshmërisë është një koncept cloud që kufizon zonën e replikimit në një rajon gjeografik.
Zonat e disponueshmërisë për çdo nodë merret përmes një etikete të veçantë — . Nëse klasteri është aktivizuar në një cloud publik, kjo etiketë krijohet automatikisht dhe mbushët me emrat e zonave të disponueshmërisë për çdo nodë.
Etiketat nuk janë pjesë e specifikimit të burimeve Kubernetes, prandaj nuk do të gjeni informacione për to në . Megjithatë, ato mund të shihen (ashtu si çdo etiketë tjetër) nëse kërkoni informacion rreth nodave në formatin YAML ose JSON:
$ kubectl get nodes -o yaml
# ose
$ kubectl get nodes -o json
Kjo është një mënyrë e shkëlqyer për të mësuar më shumë rreth burimeve, përveç studimit të specifikimeve të burimeve.
4. Kalim i lehtë mes klasterëve dhe hapësirave emri
Kur kubectl bën një kërkesë në Kubernetes API, para kësaj ai lexon skedarin kubeconfig për të marrë të gjitha parametrat e nevojshëm për lidhjen.
Sipas parazgjedhjes, skedari kubeconfig është ~/.kube/config. Zakonisht ky skedar krijohet ose përditësohet nga një komandë të veçantë.
Kur punoni me disa klasterë, skedari juaj kubeconfig përmban parametrat e lidhjes për të gjithë këta klasterë. Ju nevojitet një mënyrë për t’i treguar komandës kubectl se me cilin klaster po punoni.
Brenda klasterit, mund të krijoni disa hapësira emri — një lloj klasteri virtual brenda klasterit fizik. Kubectl përcakton se cilën hapësirë emri për të përdorur gjithashtu përmes të dhënave në skedarin kubeconfig. Kështu, ju nevojitet gjithashtu një mënyrë për t’i treguar komandës kubectl se me cilën hapësirë emri po punoni.
Në këtë kapitull do të flasim se si funksionon kjo dhe si të arrijmë një operim efektiv.
Kujdesi, mund të keni disa skedarë kubeconfig të listuar në ndryshoren KUBECONFIG. Në këtë rast, të gjitha këta skedarë do të bashkohen në një konfigurim të përbashkët gjatë ekzekutimit. Mund të ndryshoni gjithashtu skedarin kubeconfig që aplikohet si i paracaktuar duke e nisur kubectl me parametrin --kubeconfig. Shikoni .
Skedarët kubeconfig
Le të shohim se çfarë përmban skedari kubeconfig:
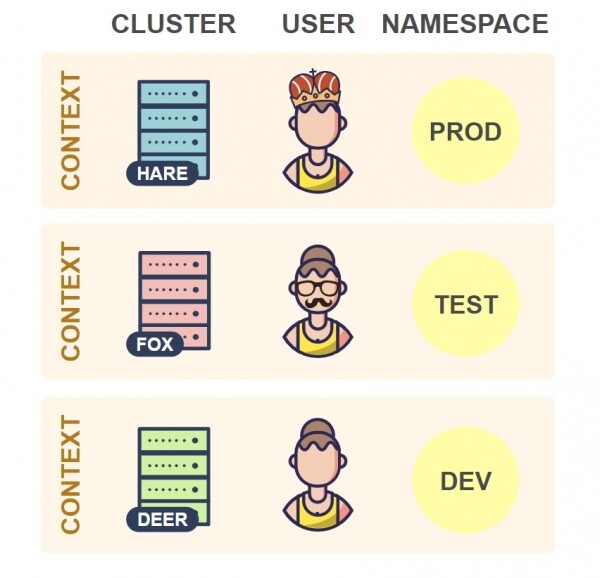
Siç e shihni, skedari kubeconfig ka një grup kontekstesh. Një kontekst përbëhet nga tre elemente:
- Cluster — URL e API serverit të klasterit.
- User — akreditive të autentikimit të përdoruesit në klaster.
- Namespace — hapësira emri që përdoret kur lidheni me klasterin.
Në praktikë, shpesh përdoret një kontekst për klaster në skedarin tuaj kubeconfig. Megjithatë, mund të keni disa kontekste për klasterin, të ndryshme sipas përdoruesit ose hapësirës emri. Megjithatë, një konfigurim me shumë kontekste është relativisht i rrallë, prandaj zakonisht ka një përputhje një-në-një midis klasterëve dhe konteksteve.
Në çdo moment, një nga kontekstet është aktualja:
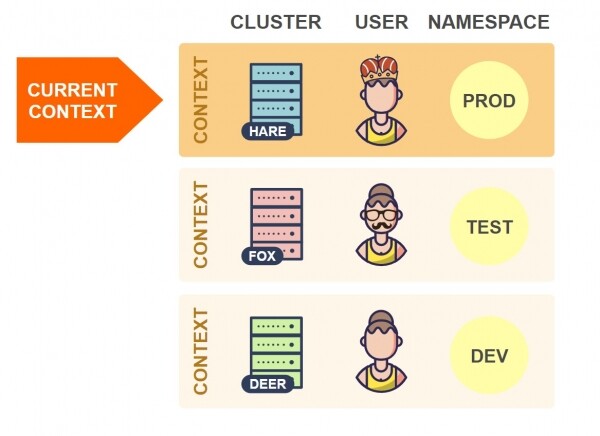
Kur kubectl lexon skedarin e konfigurimit, gjithmonë merret informacion nga konteksti aktual. Në shembullin e mësipërm, kubectl do të lidhet me klasterin Hare.
Prandaj, për të kaluar në një klaster tjetër, duhet të ndryshoni kontekstin aktual në skedarin kubeconfig:
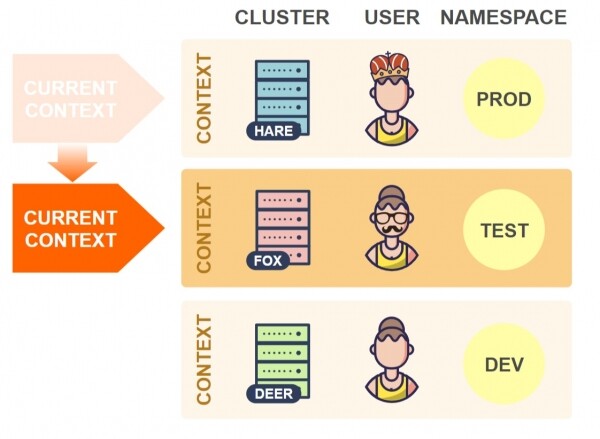
Tani kubectl do të lidhet me klasterin Fox.
Për të kaluar në një hapësirë të re emri në të njëjtin klaster, duhet të ndryshoni vlerën e elementit namespace për kontekstin aktual:
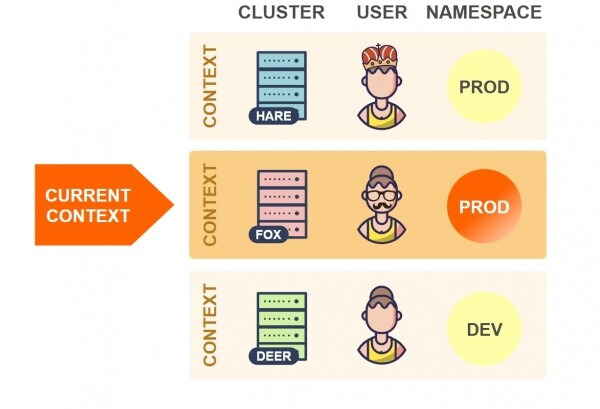
Në shembullin e përmendur më lart, kubectl do të përdorë hapësirën e emrit Prod të klasterit Fox (më parë ishte e vendosur hapësira e emrit Test).
Kujdesi, kubectl gjithashtu ofron parametrat --cluster, --user, --namespace dhe --context, të cilat lejojnë të tejkaloni elemente individuale dhe kontekstin aktual, pavarësisht se çfarë është e vendosur në skedarin kubeconfig. Shikoni kubectl options.
Teorikisht, mund të ndryshoni manualisht parametrat në skedarin kubeconfig. Por kjo është e pakëndshme. Për të thjeshtuar këto operacione ekzistojnë një sërë utilitare që lejojnë ndryshimin e parametrave në mënyrë automatike.
Përdorni kubectx
Një utilitare shumë popullore për të kaluar midis klasterëve dhe hapësirave të emrave.
Utilitari ofron komandat kubectx dhe kubens për të ndryshuar kontekstin aktual dhe hapësirën e emrave përkatësisht.
Siç u përmend më parë, ndryshimi i kontekstit aktual përfaqëson ndryshimin e klustrit, nëse keni vetëm një kontekst në klaster.
Këtu është një shembull i ekzekutimit të këtyre komandave:
Në thelb, këto komanda thjesht redaktojnë skedarin kubeconfig, siç u përmend më sipër.
Për të instaluar kubectx, ndiqni udhëzimet në
Të dy komandat mbështesin autokompletimin e emrave të konteksteve dhe hapësirave të emrave, duke e bërë të lehtë që të mos i shkruani ato plotësisht. Udhëzimet për konfigurimin e autokompletimit .
Një funksion tjetër të dobishëm kubectx është . Ai punon së bashku me mjetin , i cili duhet të instalohet veçmas. Instalimi i fzf e bën modalitetin interaktiv automatikisht të disponueshëm në kubectx. Në modalitetin interaktiv mund të zgjidhni kontekstin dhe hapësirën e emrave përmes një ndërfaqe interaktive kërkimi të lirë, të ofruar nga fzf.
Përdorimi i aliasive të komandës së shell-it
Nuk keni nevojë për mjete të veçanta për të ndryshuar kontekstin aktual dhe hapësirën e emrave, sepse kubectl gjithashtu ofron komanda për këtë. Kështu, komanda kubectl config ofron nënkomanda për redaktimin e skedareve kubeconfig.
Ja disa prej tyre:
kubectl config get-contexts: të japë të gjitha kontekstet;kubectl config current-context: të marrë kontekstin aktual;kubectl config use-context: të ndryshojë kontekstin aktual;kubectl config set-context: të ndryshojë elementin e kontekstit.
Megjithatë, përdorimi i këtyre komandave direkt nuk është shumë komode, sepse ato janë të gjata. Mund të krijoni aliaset e shell-it për to që janë të lehta për t'u ekzekutuar.
Unë krijova një grup aliasesh të bazuara në këto komanda që ofrojnë funksionalitet të ngjashëm me kubectx. Këtu mund ta shihni veprimin e tyre:
Vini re se aliaset përdorin fzf për të ofruar një ndërfaqe interaktive kërkimi të lirë (ashtu si në modalitetin interaktiv të kubectx). Kjo do të thotë se ju nevojitet , për ta përdorur këto aliasa.
Këtu janë vetë definimet e aliaseve:
# Получить текущий контекст
alias krc='kubectl config current-context'
# Список всех контекстов
alias klc='kubectl config get-contexts -o name | sed "s/^/  /;|^  $(krc)$|s/ /*/"'
# Изменить текущий контекст
alias kcc='kubectl config use-context "$(klc | fzf -e | sed "s/^..//")"'

# Получить текущее пространство имен
alias krn='kubectl config get-contexts --no-headers "$(krc)" | awk "{print $5}" | sed "s/^$/default/"'
# Список всех пространств имен
alias kln='kubectl get -o name ns | sed "s|^.*/|  |;|^  $(krn)$|s/ /*/"'
# Изменить текущее пространство имен
alias kcn='kubectl config set-context --current --namespace "$(kln | fzf -e | sed "s/^..//")"'
Për të instaluar këto aliasa, duhet të shtoni definimet e mësipërme në skedarin tuaj ~/ .bashrc ose ~/.zshrc dhe rinitisni shell-in tuaj.
Përdorimi i shtojcave
Kubectl lejon ngarkimin e shtojcave që ekzekutohen ashtu si komandat kryesore. Për shembull, mund të instaloni shtojcën kubectl-foo dhe ta ekzekutoni atë duke e përdorur komandën kubectl foo.
Do të ishte e lehtë të ndryshosh kontekstin dhe hapësirën e emrave në këtë mënyrë, për shembull, duke përdorur kubectl ctx për të ndryshuar kontekstin dhe kubectl ns për të ndryshuar hapësirën e emrave.
Kam shkruar dy plugina që e bëjnë këtë:
Funksionimi i plug-inave bazohet në aliaset nga kapitulli i mëparshëm.
Këtu është si punojnë:
Vini re se pluginat përdorin fzf për të ofruar një ndërfaqe interaktive kërkimi të lirë (si në modin interaktiv kubectx). Kjo do të thotë se ju nevojitet, për ta përdorur këto aliasa.
Për të instaluar pluginat, duhet të shkarkoni skriptet e shell me emrat dhe në ndonjë katalog në rrugën tuaj PATH dhe t’i bëni ata ekzekutues, për shembull, duke përdorur chmod +x. Menjëherë pas kësaj, do të jeni në gjendje të përdorni kubectl ctx dhe kubectl ns.
5. Shkurtesa e hyrjes me auto-aliaset
Aliaset e komandës së shell-it janë një mundësi e shkëlqyer për të përshpejtuar hyrjen. Projekti ka rreth 800 shkurtesa për komandat kryesore të kubectl.
Mund të habiteni – si të mbani mend 800 aliaset? Por nuk ka nevojë të mbani mend të gjitha, sepse ato ndërtohen sipas një skeme të thjeshtë që është dhënë më poshtë:
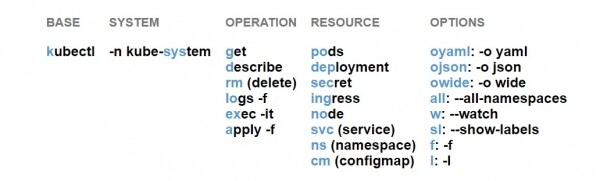
Për shembull:
- kgpooyaml — kubectl get pods oyaml
- ksysgsvcw — kubectl -n kube-system get svc w
- ksysrmcm — kubectl -n kube-system rm cm
- kgdepallsl — kubectl get deployment all sl
Siç e shihni, aliaset përbëhen nga komponentë, secili prej të cilëve përfaqëson një element të caktuar të komandës kubectl. Çdo alias mund të ketë një komponent për komandën bazë, operacionin dhe burimin dhe disa komponentë për parametrat. Ju thjesht "plotësoni" këta komponentë nga majta në djathtës sipas skemës të dhënë më lart.
Skema e detajuar aktuale ndodhet në . Atje mund të gjeni gjithashtu.
Për shembull, alias kgpooyamlall është ekuivalente me komandën kubectl get pods -o yaml --all-namespaces.
Rendi relativ i opsioneve nuk është i rëndësishëm: komanda kgpooyamlall është ekuivalente me komandën kgpoalloyaml.
Ju nuk keni pse të përdorni të gjithë komponentët si aliaset. Për shembull k, kg, klo, ksys, kgpo mund të përdoren gjithashtu. Për më tepër, në linjën e komandës mund të kombinoni aliaset dhe komandat ose opsionet e zakonshme:
Për shembull:
- Në vend të
kubectl proxymund të shkruhet sik proxy. - Në vend të
kubectl get rolesmund të shkruhet sikg roles(nuk ka aktualisht një alias për burimin Roles). - Për të marrë të dhëna për një pod të caktuar, mund të përdorni komandën
kgpo my-pod — kubectl get pod my-pod.
Mbani mend se disa alias kërkojnë një argument në linjën e komandës. Për shembull, alias kgpol do të thotë kubectl get pods -l. Opsioni --selector kërkon argument - specifikimin e etiketës. Nëse po përdorni një alias, ai do të duket si kgpol app=ui.
Për shkak se një pjesë e aliasave kërkon argumente, aliasat a, f dhe l duhet të përdoren të fundit.
Në përgjithësi, sa herë që të zotëroni këtë skemë, do të jeni në gjendje intuitivisht të nxjeni aliasat nga komandat që dëshironi të kryeni, dhe do t'ju kursejë shumë kohë në të shkruar.
Instalimi
Për të instaluar kubectl-aliases, duhet të shkarkoni skedarin nga GitHub dhe ta përfshini në skedarin ~/ .bashrc ose ~/.zshrc:
source ~/ .kubectl_aliasesPërfundimi automatik
Siç e kemi thënë më parë, shpesh shtoni fjalë shtesë në alias në komandën e linjës. Për shembull:
$ kgpooyaml test-pod-d4b77b989Nëse po përdorni përfundimin automatik për komandën kubectl, ndoshta keni përdorur përfundimin automatik për gjëra të tilla si emrat e burimeve. Por, a është e mundur të bëhet kjo, kur përdoren aliasat?
Ky është një pyetje shumë e rëndësishme, sepse nëse përfundimi automatik nuk funksionon, do të humbni një pjesë të përfitimeve të aliasave.
Përgjigjja varet nga ajo se cila shell komandash po përdorni:
- Për Zsh, përfundimi automatik për aliasat punon 'nga kutia'.
- Për Bash, fatkeqësisht, janë të nevojshme disa veprime për ta bërë përfundimin automatik të punojë.
Aktivizimi i përfundimit automatik për aliasat në Bash
Problemi me Bash është se ai përpiqet të plotësojë (kada herë që shtypni Tab) aliasin, e jo komandën që aliasi i referohet (siç bën Zsh). Duke qënë se nuk keni skripte për përfundimin për të gjithë 800 aliasat, përfundimi automatik nuk punon.
Projekti siguron një zgjidhje të përgjithshme për këtë problem. Ai lidhet me mekanizmin e përfundimit për aliasat, brenda plotëson aliasin në komandën dhe kthen opsionet e përfundimit për komandën e plotësuar. Kjo do të thotë se përfundimi për aliasin sillet saktësisht si për komandën e plotë.
Më pas, fillimisht do të shpjegoj si të instaloni complete-alias, dhe pastaj - si ta konfiguroni për të aktivizuar përfundimin për të gjithë aliasat kubectl.
Instalimi i complete-alias
Së pari, complete-alias varet nga . Prandaj, para se të instaloni complete-alias, duhet të siguroheni që bash-completion të jetë instaluar. Udhëzimet për instalim janë dhënë më parë për Linux dhe MacOS.
Shënim i rëndësishëm për përdoruesit e MacOS: si dhe skripti i përfundimit automatik për kubectl, complete-alias nuk punon me Bash 3.2, i cili është në mënyrë të paracaktuar i përdorur në MacOS. Në veçanti, complete-alias varet nga bash-completion v2 (brew install bash-completion@2), për të cilin kërkohet të paktën Bash 4.1. Kjo do të thotë se për të përdorur complete-alias në MacOS, duhet të instaloni një version më të ri të Bash.
Ju nevojitet të shkarkoni skriptin nga dhe ta përfshini në skedarin tuaj ~/ .bashrc:
source ~/bash_completion.shPasi të rinisni shell-in, complete-alias do të jetë plotësisht e instaluar.
Aktivizimi i autokompaktimit për aliaset kubectl
Teknikisht, complete-alias ofron funksionin e shell-it _complete_alias. Ky funksion kontrollon aliasin dhe rikthen sugjerime për autokompaktimin e komandës së aliasit.
Për të lidhur funksionin me një alias të caktuar, nevojitet të përdorni mekanizmin e brendshëm të Bash , për të vendosur _complete_alias si funksionin e autokompaktimit të aliasit.
Si një shembull, le të marrim aliasin k, që përfaqëson komandën kubectl. Për të vendosur _complete_alias si funksion të autokompaktimit për këtë alias, duhet të ekzekutoni komandën e mëposhtme:
$ complete -F _complete_alias k Rezultati i kësaj është se çdo herë që autokompaktoni aliasin k, thirret funksioni _complete_alias, i cili kontrollon aliasin dhe rikthen sugjerime për autokompaktimin e komandës. kubectl.
Si shembullin e dytë, le të marrim aliasin kg, që përfaqëson $ kubectl get pods EMRI GATI STATUS RIKTHEMET MOSHA engine-544b6b6467-22qr6 1/1 Duke funksionuar 0 78d engine-544b6b6467-lw5t8 1/1 Duke funksionuar 0 78d engine-544b6b6467-tvgmg 1/1 Duke funksionuar 0 78d web-ui-6db964458-8pdw4 1/1 Duke funksionuar 0 78d:
$ complete -F _complete_alias kg Në të njëjtën mënyrë si në shembullin e mëparshëm, kur autokompaktoni kg, merrni të njëjtat sugjerime për autokompaktim që do të merrnit për $ kubectl get pods EMRI GATI STATUS RIKTHEMET MOSHA engine-544b6b6467-22qr6 1/1 Duke funksionuar 0 78d engine-544b6b6467-lw5t8 1/1 Duke funksionuar 0 78d engine-544b6b6467-tvgmg 1/1 Duke funksionuar 0 78d web-ui-6db964458-8pdw4 1/1 Duke funksionuar 0 78d.
Vini re se kështu mund të përdorni complete-alias për çdo alias në sistemin tuaj.
Prandaj, për të aktivizuar autokompaktimin për të gjithë aliaset kubectl, duhet të ekzekutoni komandën e mësipërme për secilin prej tyre. Fragmenti i mëposhtëm e bën këtë nën kushtin se keni instaluar kubectl-aliases në ~/ .kubectl-aliases:
for _a in $(sed '/^alias /!d;s/^alias //;s/=.*$//'' ~/ .kubectl_aliases);
do
  complete -F _complete_alias "$_a"
done
Ky fragment kodi duhet të vendoset në ~/ .bashrc, të rinisni shell-in dhe autokompaktimi për të gjithë 800 aliaset kubectl do të jetë i disponueshëm.
6. Zgjerimi i kubectl me plugins
Deri nga , kubectl mbështet , i cili lejon zgjerimin e funksioneve të saj me komanda shtesë.
Nëse jeni të njohur me , atëherë plugins e kubectl janë ndërtuar sipas të njëjtit princip.
Në këtë kapitull ne do të shpjegojmë se si të instaloni plugins, ku t'i kërkoni dhe si të krijoni plugins tuaj.
Instalimi i plugins
Përgjigjet kubectl shpërndahen në formën e skedarëve ekzekutues të thjeshtë me emra të tipit kubectl-x. Prefiksi kubectl- është e obligueshme, pasuar nga një nënkomandë e re kubectl, e cila lejon thirrjen e plugin-it.
Për shembull, plugin-i hello do të shpërndahhet në formën e një skedari me emrin kubectl-hello.
Për të instaluar plugin-in, duhet të kopjoni skedarin kubectl-x në çfarëdo katalogu në variablën tuaj PATH dhe ta bëni atë ekzekutues, p.sh. nëpërmjet chmod +x. Menjëherë pas kësaj, mund të thërrisni plugin-in me kubectl x.
Mund të përdorni komandën e mëposhtme për të nxjerrë një listë të të gjitha plug-in-eve që aktualisht janë të instaluara në sistemin tuaj:
$ kubectl plugin listKjo komandë gjithashtu tregon paralajmërime, nëse ke disa plug-in-e me emra të njëjtë, ose nëse ka një skedar plug-in që nuk është ekzekutues.
Kërkimi dhe instalimi i plug-in-eve përmes Krew
Plug-in-e të Kubectl janë të përshtatshme për përdorim të ndarë ose të ripërdorur ashtu si paketat softuerike. Por ku mund të gjejmë plug-in-e që kanë ndarë të tjerët?
është fokusuar në ofrimin e një zgjidhjeje të unifikuar për ndarjen, kërkimin, instalimin dhe menaxhimin e plug-in-eve kubectl. Projekti e quan veten 'menaxher paketa për plug-in-e kubectl' (Krew ngjan me ).
Krew është një listë e plug-in-eve kubectl që mund të zgjidhni dhe instaloni. Gjithashtu, Krew është një plugin për kubectl.
Kjo do të thotë se instalimi i Krew funksionon, në thelb, si instalimi i çdo plug-in-i tjetër kubectl. Mund të gjeni udhëzime të detajuara në .
Komandat më të rëndësishme Krew:
# Поиск в списке плагинов
$ kubectl krew search [<query>]
# Посмотреть информацию о плагине
$ kubectl krew info <plugin>
# Установить плагин
$ kubectl krew install <plugin>
# Обновить все плагины до последней версии
$ kubectl krew upgrade
# Посмотреть все плагины, установленные через Krew
$ kubectl krew list
# Деинсталлировать плагин
$ kubectl krew remove <plugin>
Mbani mend se instalimi i plug-in-eve përmes Krew nuk ndikon në instalimin e plug-in-eve në mënyrën standarde, të përshkruar më sipër.
Vini re se komanda kubectl krew list tregon vetëm ato plug-in-e që janë instaluar përmes Krew, ndërsa komanda kubectl plugin list enumeron të gjitha plug-in-et, pra ato që janë instaluar përmes Krew, dhe ato që janë instaluar në mënyra të tjera.
Kërkimi i plug-in-eve në vende të tjera
Krew është një projekt i ri, aktualisht në listën e tij Unë rekomandoj të shikoni seksionin GitHub
kubectl-plugins Shkrimi i plug-in-eve tuaja
Mund ta bëni vetë
Ju mund ta bëni vetë — nuk është e vështirë. Ju nevojitet të krijoni një skedhë ekzekutimi që bën atë që duhet, ta quani si kubectl-x dhe ta instaloni, siç është përshkruar më sipër.
Skeda mund të jetë një skript bash, një skript python ose një aplikacion i përpiluar go — kjo nuk ka rëndësi. Kushti i vetëm është që ai të mund të ekzekutohet drejtpërdrejt në sistemin operativ.
Le të krijojmë një shembull plug-in tani. Në seksionin e mëparshëm, keni përdorur komandën kubectl për të nxjerrë një listë containers për çdo pod. Është e lehtë të shndërroni këtë komandë në një plug-in, që mund ta thërrisni, për shembull me kubectl img.
Krijoni një skedar kubectl-img users.module.ts
#!/bin/bash
kubectl get pods -o custom-columns='NAME:metadata.name,IMAGES:spec.containers[*].image'
Tani bëni skedhën ekzekutibile duke përdorur chmod +x kubectl-img dhe lëvizeni në ndonjë katalog në PATH-in tuaj. Menjëherë pas kësaj, mund të përdorni plug-in-in. kubectl img.
Siç është përmendur më parë, plug-ins kubectl mund të shkruhen në çdo gjuhë programimi apo skriptingu. Nëse po përdorni skripte të komandës, përparësia është se mund të thërrisni lehtësisht kubectl nga plug-in. Megjithatë, mund të shkruani plug-ins më të ndërlikuar në gjuhët e vërteta të programimit, duke përdorur . Nëse po përdorni Go, mund të përdorni gjithashtu , e cila ekziston veçanërisht për të shkruar plug-ins kubectl.
Si të ndani plug-inët tuaj
Nëse mendoni se plug-inët tuaj mund të jenë të dobishëm për të tjerët, mos hezitoni t'i ndani ato në GitHub. Sigurohuni që t'i shtoni në temën .
Gjithashtu mund të kërkoni që plug-in-i juaj të shtohet në . Udhëzimet se si ta bëni këtë gjeni në .
Kompletimi automatik i komandave
Aktualisht, plug-ins nuk mbështesin auto-kompletim. Domethënë, ju duhet të shkruani emrin e plotë të plug-in-it dhe emrat e plotë të argumenteve.
Në repozitorin GitHub kubectl për këtë funksion ka . Pra, është e mundur që ky funksion të realizohet ndonjëherë në të ardhmen.
Suksese!!!
Çfarë tjetër të lexoni mbi këtë temë:
- .
- .
- .
Burimi: habr.com
