

Në këtë artikull do të flasim për se si dhe për çfarë e zhvilluam – mekanizmi që transmeton informacionin midis aplikacioneve klient dhe serverave 1C:Enterprise – nga vendosja e detyrës deri te mendimi i arkitekturës dhe detajeve të realizimit.
Sistemi i Ndërveprimit (më pas – SN) është një sistem i shpërndarë me qëndrueshmëri të lartë për shkëmbimin e mesazheve me dorëzim të garantuar. SN është projektuar si një shërbim me ngarkesë të lartë dhe me shkallëzim të lartë, dhe është i disponueshëm si një shërbim online (ofrohet nga firma 1C), ashtu edhe si një produkt të cilin mund ta zbarkoni në kapacitetet tuaja serverike.
SN përdor një depo të shpërndarë dhe një sistem kërkimi . Gjithashtu do të flasim për Java dhe se si ne e shkallëzojmë horizontalisht PostgreSQL.
Formulimi i detyrës
Për ta kuptuar se përse e kemi bërë Sistemin e Ndërveprimit, do të tregoj pak rreth se si është organizuar zhvillimi i aplikacioneve biznesore në 1C.
Fillimisht – pak për ne për ata që ende nuk e dinë se me çfarë merremi :) Ne krijojmë platformën teknologjike '1C:Enterprise'. Platforma përmban mjete për zhvillimin e aplikacioneve biznesore, si dhe runtime që lejon aplikacionet biznesore të funksionojnë në një mjedis shumë-platformor.
Paradigma e klient-server për zhvillimin
Aplikacionet biznesore, të krijuara në '1C:Enterprise', funksionojnë në një arkitekturë tre-nivele në arkitekturën 'DBMS – server i aplikacioneve – klient'. Kodi aplikativ, i shkruar në , mund të ekzekutohet në serverin e aplikacioneve ose në klient. Të gjitha punët me objektet aplikative (referencat, dokumentet, etj.), si dhe leximi dhe shkrimi i bazës së të dhënave kryhen vetëm në server. Funksionaliteti i formave dhe ndërfaqes komandore gjithashtu realizohet në server. Në klient ekzekutohet marrja, hapja dhe shfaqja e formave, 'komunikimi' me përdoruesin (paralajmërimet, pyetjet...), llogaritjet e vogla në forma që kërkojnë reagim të shpejtë (p.sh., shumëzimi i çmimit me sasinë), punimi me skedarë lokalë, puna me pajisjet.
Në kodin aplikativ në titujt e procedurave dhe funksioneve duhet të specifikohet qartë ku do të ekzekutohet kodi — duke përdorur direktivat &NëKlient / &NëServer (&AtClient / &AtServer në variantin anglisht të gjuhës). Të zhvilluesit në 1C tani do të më korrigjojnë duke thënë se direktivat në të vërtetë , por ne është e rëndësishme për ne tani.
Kodi i klientit mund të thërrasë kodin e serverit, ndërsa kodi i serverit nuk mund të thërrasë kodin e klientit. Kjo është një kufizim themelor, i vendosur nga ne për disa arsye. Kryesisht sepse kodi i serverit duhet të shkruhet në mënyrë që të ekzekutohet njësoj, pavarësisht se nga ku thirret - nga klienti apo nga serveri. Dhe në rastin e thirrjes së kodit të serverit nga një kod i serverit tjetër, klienti nuk është i pranishëm si i tillë. Gjithashtu, gjatë ekzekutimit të kodit të serverit, klienti që e thirri atë mund të ketë mbyllur aplikacionin, dhe serverit nuk do t'i mbetet askush për të thirrur.

Kodi që trajton klikimin e butonit: thirrja e procedurës së serverit nga klienti do të funksionojë, thirrja e procedurës së klientit nga serveri - jo.
Kjo do të thotë se nëse ne duam të dërgojmë ndonjë mesazh në aplikacionin e klientit nga serveri, për shembull, që procesi i krijimit të raportit “me gjatësi të gjatë” ka përfunduar dhe raporti mund të shikohet - nuk kemi një mënyrë të tillë. Na duhet të shkojmë në fallxhorinë, për shembull, nga kodi i klientit për të pyetur rregullisht serverin. Por një qasje e tillë ngarkon sistemin me thirrje të tepërta, dhe gjithashtu duket jo shumë elegante.
Dhe ka gjithashtu nevojë, për shembull, në rastin e një telefoni të pranuar - të njoftojmë aplikacionin e klientit për këtë, në mënyrë që ai të gjejë në bazën e të dhënave palën që telefonon me numrin e telefonit dhe t'i tregojë përdoruesit informacionin mbi palën që telefonon. Ose, për shembull, në rastin e pranimit të një porosie në magazinë, të njoftojmë aplikacionin e klientit të porositësit. Në përgjithësi, ka shumë raste ku një mekanizëm i tillë do të ishte i dobishëm.
Pothuajse është vendosja
Të krijojmë një mekanizëm të shkëmbimit të mesazheve. I shpejtë, i besueshëm, me dorëzim të garantuar, me mundësi të kërkimit fleksibël të mesazheve. Në bazë të mekanizmit të realizohet një mesazher (mesazhe, video thirrje), që funksionon brenda aplikacioneve 1C.
Të projektojmë një sistem që është horizontalisht i shkallëzueshëm. Rritja e ngarkesës duhet të përballohet me rritjen e numrit të nodave.
Implementimi
Ne vendosëm pjesën e serverit të SV në platformën 1C: Enterprise, por do ta realizojmë si një produkt të veçantë, API i të cilit mund të thirret nga kodi i zgjidhjeve aplikative 1C. Kjo u bë për një numër arsyesh, kryesorja e të cilave ishte dëshira për të mundësuar shkëmbimin e mesazheve midis aplikacioneve të ndryshme 1C (për shembull, midis Menaxhimit të Tregtisë dhe Kontabilitetit). Aplikacione të ndryshme 1C mund të funksionojnë në versione të ndryshme të platformës 1C: Enterprise, të jenë në serverë të ndryshëm, etj. Në këto kushte, realizimi i SV si një produkt të veçantë që është "në anë" të instalimeve të 1C është zgjidhja optimale.
Kështu, ne vendosëm të bëjmë SV si një produkt të veçantë. Për kompanitë e vogla, ne rekomandojmë të përdorin serverin SV, të cilin e kemi instaluar në cloud-in tonë (wss://1cdialog.com), për të shmangur shpenzimet e lidhura me instalimin dhe konfigurimin lokal të serverit. Klientët e mëdhenj mund ta gjejnë të arsyeshme të instalojnë një server SV në kapacitetet e tyre. Qasja e ngjashme është përdorur në produktin tonë cloud SaaS. – lëshon si produkt me seritë për instalim te klientët dhe gjithashtu është vendosur në cloud-in tonë. .
Aplikacioni
Për të shpërndarë ngarkesën dhe për qëndrueshmërinë, do të përcjellim jo një por disa aplikacione Java, përpara do të vendosim një balancues ngarkese. Nëse duhet të transferojmë një mesazh nga nyja në nyje – do të përdorim publish/subscribe në Hazelcast.
Komunikimi midis klientit dhe serverit bëhet përmes websocket. Ky është shumë i përshtatshëm për sistemet në kohë reale.
Cache i shpërndarë
Kemi zgjedhur midis Redis, Hazelcast dhe Ehcache. Jemi në vitin 2015. Redis sapo ka lëshuar një klaster të ri (shumë i ri, frikshëm), ka Sentinel me një mori kufizimesh. Ehcache nuk dinte të grumbullonte në klaster (kjo funksionalitet do të vijë më vonë). Vendosëm të provojmë me Hazelcast 3.4.
Hazelcast grumbullohet në klaster "nga kutia". Në mënyrën e një nyjeje, ai nuk është shumë i dobishëm dhe mund të shërbejë vetëm si cache – nuk din të ruajë të dhënat në disk, humbëm nyjën e vetme – humbëm të dhënat. Ne vendosim disa Hazelcast, midis të cilëve backupojmë të dhënat kritike. Cache nuk e backupojmë – nuk na intereson.
Për ne, Hazelcast është:
- Një ruajtëse për sesionet e përdoruesve. Të shkojmë çdo herë për një sesion në bazë – zgjat shumë, prandaj të gjithë sesionet i vendosim në Hazelcast.
- Cache. Looking for a user profile? Check the cache. Wrote a new message? Put it in the cache.
- Topics for communication between application instances. A node generates an event and places it in the Hazelcast topic. Other application nodes subscribed to this topic receive and process the event.
- Cluster locks. For example, we create a discussion with a unique key (singleton discussion within the 1C database):
conversationKeyChecker.check("Benzokolonka");

      doInClusterLock("Benzokolonka", () -> {

          conversationKeyChecker.check("Benzokolonka");

          createChannel("Benzokolonka");
      });
We checked that the channel does not exist. Took the lock, checked again, and created it. If we don't check after taking the lock, there is a chance that another thread checked at the same moment and is now trying to create the same discussion – and it already exists. Locking through synchronized or regular Java Lock is not possible. Using the database is slow and we don't want to burden the database, using Hazelcast is the way to go.
Choosing a DBMS
We have extensive and successful experience with PostgreSQL and collaborating with developers of this DBMS.
Working with a cluster in PostgreSQL is challenging – there is , , , but generally, it is not like noSQL, which scales out of the box. We did not consider using NoSQL as the primary storage; it was enough to take Hazelcast, with which we had not worked before.
If we need to scale a relational database, then . As you know, with sharding, we divide the database into separate parts so that each can be placed on a separate server.
The first option of our sharding assumed the ability to distribute every table of our application across different servers in various proportions. If there are many messages on server A, let’s move part of this table to server B. Such a solution screamed premature optimization, so we decided to limit ourselves to a multi-tenant approach.
You can read about multi-tenant on the website .
Në SV ka koncepte të aplikacionit dhe abonentit. Aplikacioni është një instalim i caktuar i një aplikacioni biznesi, për shembull, ERP apo Kontabilitet, me përdoruesit dhe të dhënat e veta biznesore. Abonenti është një organizatë ose një person fizik, në emër të të cilit regjistrohet aplikacioni në serverin SV. Abonenti mund të ketë disa aplikacione të regjistruara, dhe këto aplikacione mund të komunikojnë mes tyre. Abonenti u bë një qiramarrës (tenant) në sistemin tonë. Mesazhet e disa abonentëve mund të ndodhen në një bazë të dhënash fizike; nëse e shohim që ndonjë abonent po gjeneron shumë trafik - e çojmë atë në një bazë të dhënash fizike të veçantë (ose madje në një server të veçantë DB).
Ne kemi një bazë të dhënash kryesore, ku ruhet tabela e routing-ut me informacionin mbi lokacionin e të gjitha bazave të të dhënave të abonentëve.
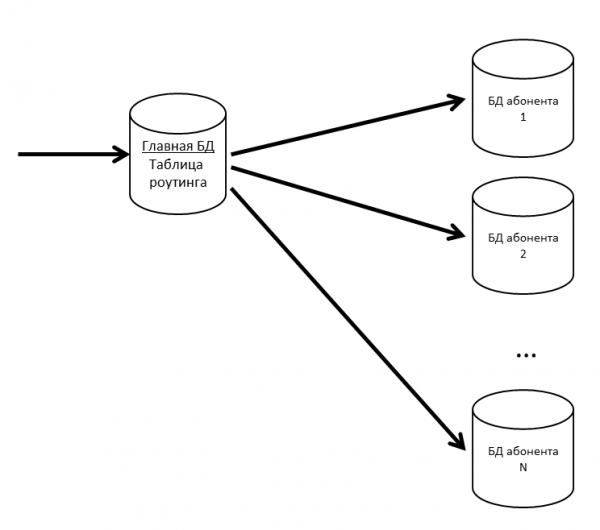
Për të mos pasur ngushticë në bazën e të dhënave kryesore, ne e mbajmë tabelën e routing-ut (dhe të dhënat e tjera që përdoren shpesh) në cache.
Nëse fillon të ngadalësohet baza e të dhënave të abonentit, do të ndajmë brenda në particione. Në projekte të tjera për particionimin e tabelave të mëdha përdorim .
Duke qenë se është e keqe të humbasim mesazhet e përdoruesve, ne i mbështesim bazat tona të dhënash me replika. Kombinimi i replikave sinkrone dhe asinkrone na lejon të jemi të mbrojtur në rast të humbjes së bazës kryesore të të dhënave. Humbja e një mesazhi do të ndodhë vetëm në rast të dështimit të njëkohshëm të bazës kryesore të të dhënave dhe replikës së saj sinkrone.
Nëse humbet replika sinkrone - replika asinkrone bëhet sinkrone.
Nëse humbet baza kryesore e të dhënave - replika sinkrone bëhet baza kryesore e të dhënave, ndërsa replika asinkrone bëhet replika sinkrone.
Elasticsearch për kërkimin
Duke qenë se, përveç të tjerave, SV është gjithashtu një mesazhues, ne kemi nevojë për një kërkim të shpejtë, të rehatshëm dhe fleksibël, duke marrë parasysh morfologjinë, për përputhjet jo të sakta. Ne e vendosëm të mos shpiknim biçikletën dhe të përdorim sistemin e kërkimit të lirë Elasticsearch, i krijuar mbi bazën e bibliotekës . Elasticsearch e vendosim gjithashtu në një klashtër (master - data - data), për të parandaluar problemet në rast se ndonjë nyje aplikacioni dështon.
Në github ne gjetëm për Elasticsearch dhe e përdorim. Në indeksin Elasticsearch ruajmë rrënjët e fjalëve (të cilat përcakton plugin) dhe N-gjërat. Ndërsa përdoruesi shkruan tekst për kërkim, ne kërkojmë tekstin e shkruar midis N-gjërave. Kur ruhet në indeks, fjala "tekste" do të ndahet në N-gjërat e mëposhtme:
[te, tek, teks, tekst, tekste, ek, eks, ekst, ekstë, ks, kst, ksty, st, sty, ty],
Gjithashtu do të ruhet rrënja e fjalës "tekst". Ky qasje lejon që të kërkojmë si në fillim, ashtu edhe në mes, dhe në fund të fjalës.
Pamja e përgjithshme
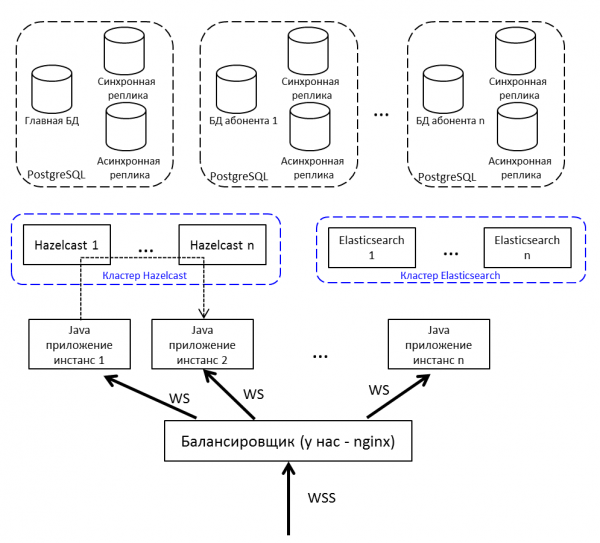
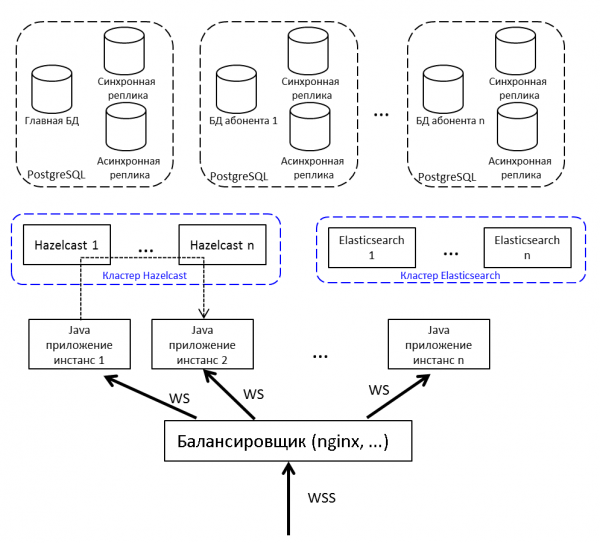
Përsëritja e imazhit nga fillimi i artikullit, por tashmë me shpjegime:
- Balancuesi, i vendosur në internet; ne kemi – nginx, mund të jetë çfarëdo.
- Instancat e aplikacionit Java komunikojnë ndërmjet vete përmes Hazelcast.
- Për të punuar me websockets përdorim .
- Aplikacioni Java është shkruar në Java 8, përbëhet nga bunde . Në planet është migrimi në Java 10 dhe kalimi në module.
Zhvillimi dhe testimi
Në procesin e zhvillimit dhe testimit të systemit, ne u përballëm me disa veçori interesante të produkteve që përdorim.
Testim ngarkese dhe rrjedhje memorjeje
Çdo lëshim të systemit – është një testim ngarkese. Ai kalon me sukses kur:
- Testi funksionoi për disa ditë dhe nuk kishte ndalesa në shërbim
- Koha e përgjigjes për operacionet kryesore nuk e kaloi pragun e rehatshëm
- Përkeqësimi i performancës në krahasim me versionin e mëparshëm nuk është më shumë se 10%
Bashkojmë bazën testuese me të dhëna – për këtë marrim nga serveri prodhues informacion mbi abonentin më aktiv, e shumëzojmë numrat e tij me 5 (numri i mesazheve, diskutimeve, përdoruesve) dhe kështu testojmë.
Testimin e ngarkesës së sistemit të ndërveprimit e kryejmë në tre konfigurata:
- Stres-Test
- Vetëm lidhjet
- Regjistrimi i abonentëve
Gjatë testit të stresit ne aktivizojmë disa qindra rrjedha, dhe ato vazhdimisht ngarkojnë sistemin: dërgojnë mesazhe, krijojnë diskutime, marrin listën e mesazheve. Imiton veprimet e përdoruesve të zakonshëm (të merrni listën e mesazheve të mia të palexuara, të shkruani dikujt) dhe zgjidhjeve programore (të transferoni një paketë në konfigurata të tjera, të përpunoni njoftimin).
Për shembull, kështu duket një pjesë e stres-testit:
- Një përdorues hyn në sistem
- Kërkon diskutimet e tij të palexuara
- Me 50% probabilitet lexon mesazhet
- Me 50% probabilitet shkruan mesazhe
- Më pas përdoruesi:
- Me një probabilitet 20% krijon një diskutim të ri
- Zgjedh rastësisht cilindo nga diskutimet e tij
- Hyn brenda
- Kërkon mesazhe, profile përdoruesish
- Krijon pesë mesazhe, të adresuara përdoruesve rastësorë nga ky diskutim
- Dalet nga diskutimi
- E përsërit 20 herë
- Del nga sistemi, kthehet sërish në fillim të skenarit
- Në sistem hyn një chatbot (simulon shkëmbimin e mesazheve nga kodi i aplikacioneve të zgjidhjeve)
- Me një probabilitet 50% krijon një kanal të ri për shkëmbim të të dhënave (disktutim të veçantë)
- Me një probabilitet 50% shkruan një mesazh në cilindo nga kanalet ekzistuese
Skenari "Vetëm lidhje" nuk u shfaq krejt rastësisht. Ka një situatë: përdoruesit e lidhën sistemin, por ende nuk janë angazhuar. Çdo përdorues në mëngjes në 09:00 ndez kompjuterin, vendos lidhjen me serverin dhe hesht. Këta djem janë të rrezikshëm, janë shumë – nga paketat e tyre kanë vetëm PING/PONG, por mbajnë lidhjen me serverin (nuk mund ta ndalin – ndoshta vjen një mesazh i ri). Testi riprodhon situatën kur brenda gjysmë ore një numër i madh i këtyre përdoruesve përpiqen të regjistrohen në sistem. Është i ngjashëm me një test stresi, por fokusi i tij është pikërisht në këtë hyrje të parë – për të shmangur dështimet (një person nuk e përdor sistemin, por ai tashmë ka filluar të bie – e vështirë të mendosh ndonjë gjë më keq).
Skenari i regjistrimit të abonentëve fillon me fillimin e parë. Ne kemi kryer një test stresi dhe ishim të sigurt se në biseda sistemi nuk ngadalësohej. Por përdoruesit erdhën dhe regjistrimi filloi të dështon për shkak të kohëve të skadimit. Gjatë regjistrimit ne përdorëm , i cili është i lidhur me entropinë e sistemit. Serveri nuk arriti të mbledhë mjaft entropi dhe gjatë kërkesës për SecureRandom të ri ngeli për disa dhjetëra sekonda. Ka shumë zgjidhje për këtë situatë, për shembull: të kalosh në një më pak të sigurt /dev/urandom, të vendosësh një pllakë speciale që gjeneron entropi, të gjenerosh numra rastësishëm paraprakisht dhe t’i ruash në një rezervë. Ne përkohësisht e mbyllëm problemin me një rezervë, por që atëherë po ekzekutojmë një test të veçantë për regjistrimin e abonentëve të rinj.
Si gjenerues ngarkese përdorim . Nuk di të punojë me websockets, është nevojshëm një plugin. Të parët në rezultatet e kërkimit për kërkesën "jmeter websocket" janë , në të cilat rekomandohet .
Prej tij vendosëm të fillojmë.
Pikërisht pasi filloi testimi i rëndë, ne zbuluam se në JMeter filluan rrjedhjet e memories.
Plugini është një histori e veçantë, me 176 yje ka 132 fork në GitHub. Autori nuk ka bërë komente prej vitit 2015 (ne e morëm atë në vitin 2015, atëherë kjo nuk ngjalli dyshime), disa probleme në GitHub rreth rrjedhjeve të memories, 7 kërkesa të hapura përr këtu.
Nëse vendosni të zhvilloni testim stresi me këtë plugin, kushtoni vëmendje diskutimeve të mëposhtme:
- Në një mjedis me shumë procese, është përdorur një LinkedList i zakonshëm, duke rezultuar në në runtime. Zgjidhet ose duke kaluar në ConcurrentLinkedDeque, ose me blloqe synchronized. Ne zgjodhëm opsionin e parë ().
- Rrjedhje e memories, informacioni mbi lidhjen nuk hiqet kur bëhet disconnection ().
- Në modin streaming (kur websocket nuk mbyllet në fund të mostrës, por përdoret më tej në plan), pattern-et e përgjigjes nuk funksionojnë ().
Kjo është nga ato që janë në GitHub. Çfarë bëmë:
- Morrëm (@elyrank) – në të janë rregulluar problemet 1 dhe 3
- Zgjidhëm problemin 2
- Përditësuam jetty nga 9.2.14 në 9.3.12
- E mbyllëm SimpleDateFormat në ThreadLocal; SimpleDateFormat nuk është thread-safe, gjë që çonte në NPE në runtime
- Eliminuan edhe një rrjedhje të memories (lidhja nuk u mbyll si duhet gjatë disconnection)
Dhe megjithatë, ai vazhdon të rrjedhë!
Memoria nuk përfundonte më pas një dite, por pas dy ditësh. Koha ishte shumë e limituar, vendosëm të nisnim më pak procese, por në katër agjentë. Kjo duhej të mjaftonte, të paktën për një javë.
Kaluar dy ditë…
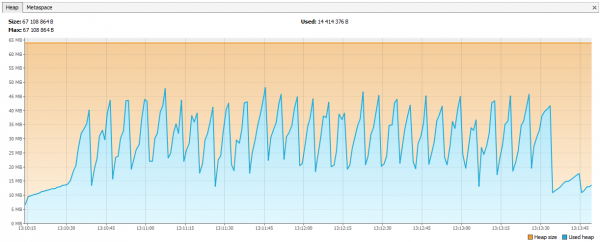
Tani memoria po përfundonte edhe me Hazelcast. Në log ishte e dukshme se pas disa ditësh testimi, Hazelcast fillonte të ankohej për mungesë memorjeje, dhe pasi kalonte ca kohë, klasteri shpartallohej dhe nodet vazhdonin të vdisnin një pas një. Ne lidhem JVisualVM me hazelcast dhe pamë një "rrafshim në rritje" – ai rregullisht thërriste GC, por nuk mund të pastrohej memoria.
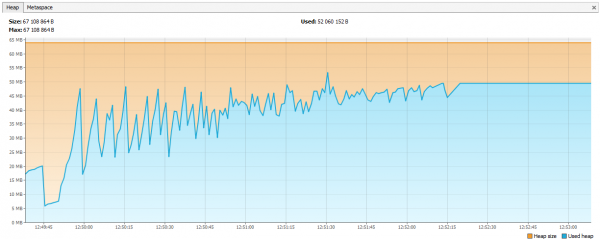
Doli se në hazelcast 3.4, kur fshije map / multiMap (map.destroy()) memoria nuk lirohej plotësisht:
Tani gabimi është rregulluar në 3.5, por atëherë kjo ishte një problem. Ne krijonim multiMap të reja me emra dinamikë dhe i fshihnim sipas logjikës tonë. Kodi dukej diçka i tillë:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Thirrja:
service.join(auth1, "NJOFTIMET_E_REJA_NË_DISKUTIM_UUID1");
service.join(auth2, "NJOFTIMET_E_REJA_NË_DISKUTIM_UUID1");
multiMap ishte krijuar për çdo abonim dhe është eliminuar kur nuk ishte më e nevojshme. Vendosëm që do të bëjmë një Map, me emrin e abonimit si çelës dhe me identifikuesit e sesioneve si vlera (nëpërmjet të cilave mund të shohim identifikuesit e përdoruesve, nëse është e nevojshme).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Grafikat janë stabilizuar.
Çfarë tjetër mësuam për testimin e ngarkesës
- JSR223 duhet shkruar në groovy dhe të përfshijë compilation cache – kjo është shumë më e shpejtë. .
- Grafikat e Jmeter-Plugins janë më të lehta për t'u kuptuar sesa ato standarde. .
Për përvojën tonë me Hazelcast
Hazelcast ishte një produkt i ri për ne, filluam të punojmë me të nga versioni 3.4.1, tani në serverin tonë production është instaluar versioni 3.9.2 (në momentin e shkruarjes së artikelit, versioni më i fundit i Hazelcast është 3.10).
Gjenerimi i ID
Filluam me identifikues numërorë. Le të imagjinojmë se na nevojitet një Long i ri për një entitet të ri. Sekuenca në DB nuk është e përshtatshme, tabelat marrin pjesë në sharding – do të ndodhte që të ketë mesazh ID=1 në DB1 dhe mesazh ID=1 në DB2, në Elasticsearch nuk mund ta vendosësh një ID të tillë, as në Hazelcast, por më e keqja, nëse dëshiron të bashkosh të dhënat nga dy DB në një (p.sh., duke vendosur se një DB është e mjaftueshme për këta abonen), mund të krijosh disa AtomicLong në Hazelcast dhe të mbash një numërues atje, atëherë performanca e marrjes së një ID të ri është incrementAndGet plus koha për të bërë kërkesë në Hazelcast. Por në Hazelcast ka diçka më të optimizuar – FlakeIdGenerator. Çdo klienti, kur bën një kërkesë, iu jepet një interval ID-sh, p.sh., të parit – nga 1 në 10 000, të dytit – nga 10 001 në 20 000 dhe kështu me radhë. Tani klienti mund të gjenerojë identifikues të rinj vetë, derisa t'i skadojë intervali i dhënë. Punon shpejt, por kur aplikacioni riniset (dhe klienti Hazelcast) fillon një sekuencë e re – prej andej ndodhin mungesat etj. Gjithashtu, zhvilluesit nuk e kuptojnë shumë mirë pse ID-të janë numërorë, por vijnë aq shumë të çrregullt. E mbaruam por edhe vendosëm të kalojmë në UUID.
A propos, pour ceux qui veulent ressembler à Twitter, il existe une bibliothèque Snowcast – une implémentation de Snowflake sur Hazelcast. Vous pouvez la consulter ici :
Mais nous n'avons déjà pas eu le temps de l'utiliser.
TransactionalMap.replace
Une autre surprise : TransactionalMap.replace ne fonctionne pas. Voici un test :
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Attendu : newValue
Réel : oldValue
Nous avons dû écrire notre propre replace, en utilisant getForUpdate :
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Remplacement de valeur dans une carte transactionnelle");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Remplacement de valeur dans une carte non transactionnelle");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testez non seulement les structures de données ordinaires, mais aussi leurs versions transactionnelles. Parfois, IMap fonctionne, mais TransactionalMap ne fonctionne pas.
Déployer un nouveau JAR sans temps d'arrêt
Au début, nous avons décidé d'enregistrer dans Hazelcast des objets de nos classes. Par exemple, nous avons une classe Application, nous voulons la sauvegarder et la lire. Sauvegardons :
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Nous lisons :
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Tout fonctionne. Puis nous avons décidé de créer un index dans Hazelcast pour rechercher à son sujet :
map.addIndex("subscriberId", false);Et en écrivant une nouvelle entité, nous avons commencé à recevoir ClassNotFoundException. Hazelcast essayait de compléter l'index, mais ne savait rien sur notre classe et voulait qu'on lui fournisse le JAR avec cette classe. Nous l'avons fait, tout a fonctionné, mais un nouveau problème est apparu : comment mettre à jour le JAR sans arrêter complètement le cluster ? Hazelcast ne prend pas en compte le nouveau JAR lors de la mise à jour à la volée. À ce moment-là, nous avons décidé que nous pouvions vivre sans recherche par index. En effet, si nous utilisons Hazelcast comme un stockage clé-valeur, tout fonctionne-t-il ? Pas tout à fait. Ici, il y a encore un comportement différent entre IMap et TransactionalMap. Là où IMap n'a pas d'importance, TransactionalMap renvoie une erreur.
IMap. Regjistrojmë 5000 objekte, lexojmë. Gjithçka është siç pritej.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
Dhe në transaksion nuk funksionon, marrim ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
Në versionin 3.8 u prezantua mekanizmi i Dislokimit të Klaseve të Përdoruesit. Ju mund të caktoni një nodë kryesore dhe të përditësoni skedarin JAR në të.
Tani ne e kemi ndryshuar plotësisht qasjen: ne vetë serializojmë në JSON dhe e ruajmë në Hazelcast. Hazelcast-i nuk ka nevojë të dijë strukturën e klasave tona, ndërsa ne mund të përditësohemi pa ndonjë ndalim. Menaxhimi i versionimit të objekteve të domenit bëhet nga aplikacioni. Njëkohësisht, mund të jenë në funksionim versione të ndryshme të aplikacionit, dhe mund të ndodhë që aplikacioni i ri të shkruajë objekte me fusha të reja, ndërsa ai i vjetër ende nuk i njeh këto fusha. Po ashtu, aplikacioni i ri lexon objekte, të shkruara nga aplikacioni i vjetër, të cilat nuk kanë fusha të reja. Këto situata i trajtojmë brenda aplikacionit, por për thjeshtësi nuk i ndryshojmë dhe nuk i fshijmë fushat, thjesht i zgjeruam klasat duke shtuar fusha të reja.
Si sigurojmë performancë të lartë
Katër vizita në Hazelcast – mirë, dy në DB – keq
Tërheqja e të dhënave nga cache është gjithmonë më e mirë sesa nga BD, por gjithashtu nuk dua të ruaj informacionet e pavlefshme. Vendimi se çfarë të cache-ojmë e shtyjmë në fazën e fundit të zhvillimit. Kur funksionaliteti i ri është koduar, ne aktivizojmë logimin e të gjitha kërkesave në PostgreSQL (log_min_duration_statement në 0) dhe fillojmë testimin e ngarkesës për rreth 20 minuta. Sipas log-eve të mbledhura, utilitetet si pgFouine dhe pgBadger dinë të ndërtoshin raporte analitike. Në raporte, në radhë të parë, kërkojmë kërkesa të ngadalta dhe të shpeshta. Për kërkesat e ngadalta krijojmë një plan ekzekutimi (EXPLAIN) dhe vlerësojmë nëse një kërkesë e tillë mund të shpejtohet. Kërkesat e shpeshta me të njëjtat të dhëna hyrëse futen mirë në cache. Mundoheni të mbani kërkesat "të sheshta", me një tabelë në çdo kërkesë.
Eksplorimi
SV si një shërbim online u lançua në pranverën e vitit 2017, ndërsa si një produkt i veçantë, SV doli në nëntor 2017 (në atë kohë në statusin beta).
Gjatë më shumë se një viti në përdorim, nuk ka pasur probleme serioze me funksionimin e shërbimit online SV. Ne monitorojmë shërbimin online përmes , mbledhim dhe deployed nga .
Distribucioni i serverit SV ofrohet në formën e pakove nativ: RPM, DEB, MSI. Për më tepër, për Windows ne ofrojmë një instalues të vetëm në formën e një EXE, i cili instalon serverin, Hazelcast dhe Elasticsearch në një makinë. Fillimisht e quajtëm këtë version instalimi "demonstrativ", por tani është e qartë se ky është varianti më i popullarizuar i shpërndarjes.
Burimi: habr.com
