

Ne kemi zhvilluar një dizajn të rrjetit të qendrave të të dhënave, i cili lejon ndërtimin e klasterëve përpunues më të mëdhenj se 100,000 serverë me një brez të pikës bise (bisection bandwidth) mbi një petabajt në sekondë.
Nga raporti i Dmitri Afanasyev, do të mësoni mbi parimet kryesore të dizajnit të ri, zgjerimin e topologjive, problemet që lindin gjatë këtij procesi, opsionet për zgjidhjen e tyre, si dhe karakteristikat e rutimit dhe zgjerimit të funksioneve të planeve të përçueshmërisë në pajisjet e reja të rrjetit në topologji "me densitet të lartë" (densely connected) me një numër të madh rrugësh ECMP. Për më tepër, Dima tha shkurtimisht për organizimin e lidhjes së jashtme, nivelin fizik, sistemin e kabllove dhe metodat për rritjen e kapacitetit të mëtejmë.
— Të gjithë, përshëndetje! Unë quhem Dmitri Afanasyev, jam arkitekt rrjeti në Yandex dhe merrem kryesisht me dizajnin e rrjeteve të qendrave të të dhënave.
Tregimi im do të jetë për rrjetin e përmirësuar të qendrave të të dhënave të Yandex. Ky është, në masë të madhe, një evoluim i dizajnit që kishim, por në të njëjtën kohë ka edhe disa elemente të reja. Kjo është një prezantim i përgjithshëm, pasi duhej të përfshija një sasi të madhe informacioni në një kohë të vogël. Ne do të fillojmë me zgjedhjen e topologjisë logjike. Më pas do të ketë një përmbledhje të planeve të kontrollit dhe problemeve me shkallëzimin e planeve të të dhënave, zgjedhjen e asaj që do të ndodhë në nivelin fizik, do të shikojmë disa karakteristikat e pajisjeve. Pak do të diskutojmë gjithashtu për atë që ndodh në qendrën e të dhënave me MPLS-in, për të cilin ne folëm disa kohë më parë.
Pra, çfarë është Yandex nga perspektiva e ngarkesave dhe shërbimeve? Yandex është një hiper shkallëzues tipik. Nëse shikojmë nga ana e përdoruesve, procesi ynë kryesor është përpunimi i kërkesave të përdoruesve. Po ashtu, shërbime të ndryshme transmetimi dhe ofrimi të të dhënave, pasi ne kemi gjithashtu shërbime të ruajtjes. Nëse shqyrtojmë më afër prapavijën, atje lindin ngarkesa dhe shërbime infrastrukturore, si ruajtjet e objektit të shpërndara, replikimi i të dhënave dhe, natyrisht, radhët e përhershme. Një nga tipet kryesore të ngarkesave është MapReduce dhe sisteme të ngjashme, përpunimi i rrjedhës, mësimi makinerik, etj.
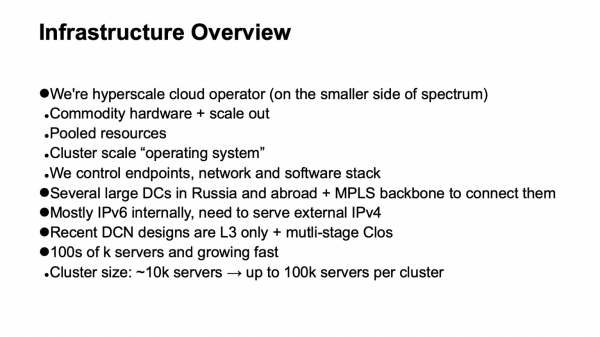
Si zhvillohet infrastruktura mbi të cilën ndodh gjithë ky proces? Përsëri, ne jemi një hiperskalues tipik, ndonëse ndoshta jemi pak më afër atij segmenti të spektrit ku gjenden hiperskaluesit më të vegjël. Por ne kemi të gjitha atributet. Ne përdorim hardware të zakonshëm dhe shkallëzim horizontal sa herë që është e mundur. Ne kemi një praninë e plotë të burimeve të përbashkëta: ne nuk punojmë me makina të veçanta, raftet e veçanta, por i bashkojmë ato në një grup të madh burimesh të ndërrueshme me disa shërbime shtesë që merreshin me planifikimin dhe alokimin, dhe punojmë me tërë këtë grup.
Kështu, na lind niveli tjetër - sistemi operacional i nivelit të grupit të kompjuterëve. Është shumë e rëndësishme që ne kontrollojmë plotësisht gruan e teknologjive që përdoret. Ne kontrollojmë pikët e fundit (hostet), rrjetin dhe gruan softuerike.
Ne kemi disa qendra të mëdha të të dhënave në Rusi dhe jashtë saj. Ato janë të lidhura me një backbone që përdor teknologjinë MPLS. Infrastruktura jonë e brendshme është ndërtuar pothuajse plotësisht mbi IPv6, por pasi duhet të shërbejmë trafikun e jashtëm, i cili ende mbërrin kryesisht nëpërmjet IPv4, ne duhet të gjejmë mënyra për të përçuar kërkesat që vijnë përmes IPv4 në frontend-serverësh, dhe pak të shkojë në internetin e jashtëm IPv4 - për shembull, për indeksimin.
Versionet e fundit të dizajnit të rrjeteve të qendrave të të dhënave përdorin topologji Clos me shumë nivele dhe në to aplikohet vetëm L3. Ne u larguam nga L2 disa kohë më parë dhe u ndjemë të lehtësuar. Në fund, infrastruktura jonë përfshin qindra mijëra instanca të llogaritarëve (serverëve). Madhësia maksimale e grupit disa kohë më parë ishte rreth 10 mijë serverë. Kjo lidhet në mënyrë të konsiderueshme me mënyrën se si mund të funksionojnë ato sisteme operacionale të nivelit të grupit, planifikuesit, alokimi i burimeve etj. Meqenëse ka ndodhur përparim në softin e infrastrukturës, tani madhësia e synuar është rreth 100 mijë serverë në një grup llogaritarësh, dhe kemi detyrën - të jemi në gjendje të ndihmojmë ndërtimin e fabrikave rrjetësore që lejojnë efekti i burimeve në një grup të tillë.
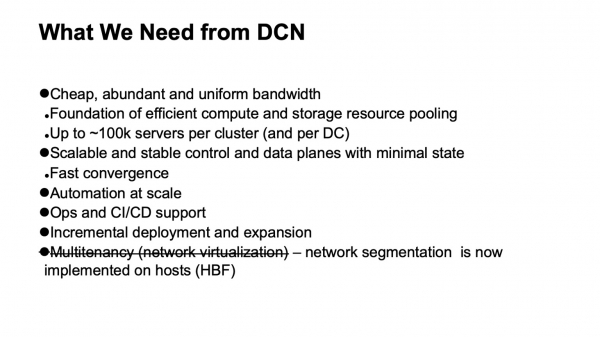
Çfarë presim nga rrjeti i qendrës së të dhënave? Në radhë të parë — shumë kapacitet të lirë dhe mjaft uniform të bandës së kaluar. Sepse rrjeti është baza, përmes së cilës ne mund të realizojmë mbledhjen e burimeve. Madhësia e re e synuar — rreth 100 mijë serverë në një klaster.
Po ashtu, natyrisht, dëshirojmë një plan të kontrollit të shkallëzueshëm dhe të qëndrueshëm, sepse në një infrastrukturë kaq të madhe, ndodhin shumë probleme, madje edhe nga ngjarje rastësore, dhe ne nuk duam që plani i kontrollit të na shkaktojë më shumë dhimbje koke. Në të njëjtën kohë, dëshirojmë të minimizojmë gjendjen në të. Sa më pak gjendje, aq më mirë dhe më qëndrueshëm funksionon gjithçka, më lehtë për diagnostikim.
Natyrisht, na nevojitet automatizimi, sepse menaxhimi manual i kësaj infrastrukture është i pamundur, dhe tashmë për një kohë të gjatë ka qenë i tillë. Na nevojitet për sa më shumë që të jetë e mundur mbështetje për operacionet dhe mbështetje për CI/CD, sa më shumë që mund të sigurohet.
Me përmasat e tilla të qendrave të të dhënave dhe klasterëve, është bërë mjaft urgjente mbështetje për vendosjen inkrementale dhe zgjerimin pa ndërprerje të shërbimit. Nëse në klasterët me një mijë makina, mund të ishim afër dhjetë mijë makinave, ato ende mund të lançohen si një operacion — dmth. ne planifikojmë zgjerimin e infrastrukturës, dhe disa mijë makina shtohen si një operacion, atëherë klasterët me rreth njëqind mijë makina nuk shfaqen menjëherë, ata ndërtohen gjatë një periudhe kohe. Dhe është e dëshirueshme që gjatë gjithë kësaj kohe infrastruktura që është tashmë e vendosur të jetë e aksesueshme.
Dhe një kërkesë që kishim dhe e heqëm: është mbështetja për multitenancy, domethënë virtualizimin ose segmentimin e rrjetit. Tani nuk kemi nevojë ta bëjmë këtë në nivelin e fabrikës së rrjetit, sepse segmentimi është kaluar në hoste, dhe kjo na ka lehtësuar shumë zgjerimin. Falë IPv6 dhe hapësirës së madhe të adresave, nuk kemi pasur nevojë të përdorim adresa të dyfishta në infrastrukturën tonë të brendshme, e gjithë adresimi ishte dhe ashtu unik. Dhe falë faktit se filtrimi dhe segmentimi i rrjetit u kaluan në hoste, nuk kemi nevojë të krijojmë ndonjë entitet të rrjetit virtual në rrjetet e qendrës së të dhënave.
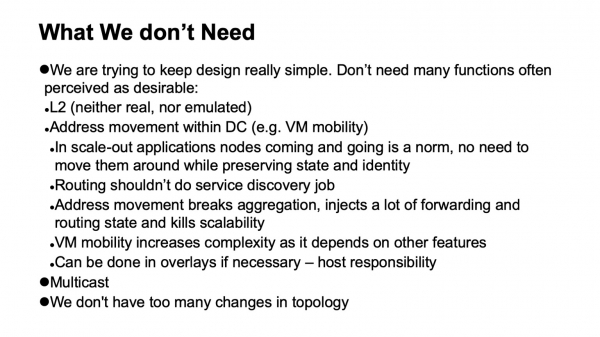
Një gjë shumë e rëndësishme është ajo që nuk na nevojitet. Nëse disa funksione mund të hiqen nga rrjeti, kjo e lehtëson shumë jetën, dhe si rregull, zgjeron zgjedhjen e pajisjeve dhe softuerit të disponueshëm, duke e thjeshtuar shumë diagnostikimin.
Pra, çfarë nuk na nevojitet, nga çfarë kemi mundur të heqim dorë, jo gjithmonë me gëzim në momentin kur ndodhte, por me një lehtësim të madh kur procesi përfundonte?
Së pari, heqja dorë nga L2. Ne nuk na nevojitet L2 as real, as i emuluar. Nuk përdoret në masë të madhe për shkak se ne kontrollojmë stack-un e aplikacioneve. Aplikacionet tona zgjerohen horizontalisht, ato punojnë me adresimin L3, ato nuk shqetësohen shumë nëse ndonjë instancë individuale fiket, thjesht nxjerrin një të re, nuk ka nevojë të dalë në adresën e vjetër, sepse ka një nivel të veçantë të zbuluar shërbimi dhe monitorimi të makinave që janë në klaster. Ne nuk e ngarkojmë këtë detyrë në rrjet. Detyra e rrjetit është të dërgojë paketa nga pika A në pikën B.
Po ashtu, nuk kemi situata ku adresat lëvizin brenda rrjetit dhe kjo duhet të monitorohet. Në shumë dizajne, kjo zakonisht është e nevojshme për të ruajtur lëvizshmërinë e VM-ve. Ne nuk përdorim lëvizshmërinë e makinave virtuale në infrastrukturën tonë të brendshme të madh të Yandex-it, dhe për më tepër, mendojmë se, edhe nëse kjo bëhet, nuk duhet të ndodhë me mbështetje të rrjetit. Nëse është shume e nevojshme, kjo duhet bërë në nivelin e hostëve, dhe të vendosen adresat që mund të migrojnë në overlay, në mënyrë që të mos preken dhe të mos bëhen shumë ndryshime dinamike në sistemin e ruterit të vetë underlay (rrjeti i transportit).
Një teknologji tjetër që ne nuk përdorim është multicast. Atë që duan mund t’u tregoj në detaje se përse. Kjo e lehtëson shumë jetën, sepse, nëse ndokush ka pasur të bëjë me të dhe ka parë se si duket konkretisht plani i kontrollit të multicast-it — në të gjitha instalimet, përveç më të thjeshtave, kjo është një dhimbje e madhe koke. Dhe më tepër, është e vështirë të gjesh një implementim të hapur që funksionon mirë, për shembull.
Dhe për fund, ne projektuam rrjetet tona në mënyrë që të mos ketë shumë ndryshime në to. Ne mund të llogarisim se fluksi i ngjarjeve të jashtme në sistemin e ruterit është i vogël.
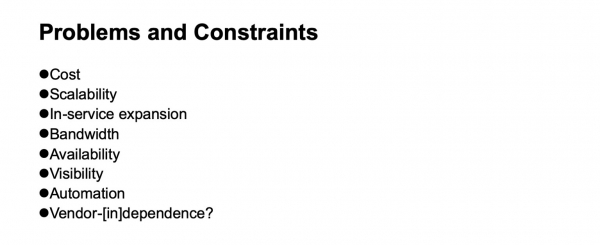
Cilat janë problemet që mund të paraqiten dhe cilat kufizime duhet të kemi parasysh kur zhvillojmë një rrjet data-qendrash? Çmimi, sigurisht. Shkallëzimi, deri në çfarë niveli dëshirojmë të rritemi. Nevoja për zgjerim pa ndërprerë shërbimin. Gjerësia e kanalit, disponueshmëria. Shikueshmëria e asaj që po ndodh në rrjet, për sistemet e monitorimit, për ekipet operative. Mbështetje për automatizimin — përsëri, aq sa është e mundur, pasi detyra të ndryshme mund të zgjidhen në nivele të ndryshme, duke përfshirë nëpërmjet shtimit të shtresave të tjera. Dhe jo-[sa më shumë të jetë e mundur]-varësia nga ofruesit. Megjithatë, në periudha të ndryshme historike, në varësi të asaj se çfarë segmenti shqyrtojmë, kjo pavarësi ka qenë më e lehtë ose më e vështirë për t'u arritur. Nëse marrim një segment të çipave të pajisjeve të rrjetit, deri në kohët e fundit, të flasim për pavarësinë nga ofruesit, nëse do të donim gjithashtu çipa me gjerësi të madhe kanalit, mund të ishte shumë në mënyrë të kushtëzuar.
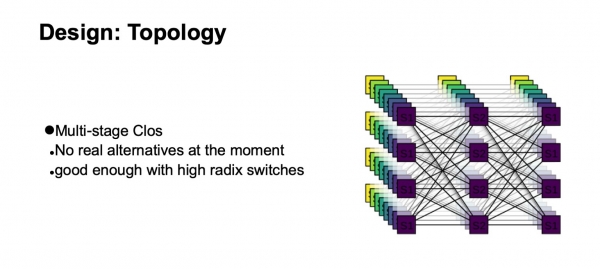
Cila logjikë topologjike do të përdorim për të ndërtuar rrjetin tonë? Do të jetë një Clos me shumë nivele. Për të qenë i sinqertë, në këtë moment nuk ka alternativa reale. Dhe topologjia Clos është mjaft e mirë, madje edhe nëse e krahasojmë me topologjitë e avancuara të ndryshme, të cilat tani janë më shumë në fushën e interesit akademik, nëse kemi switch-e me një radiks të lartë.
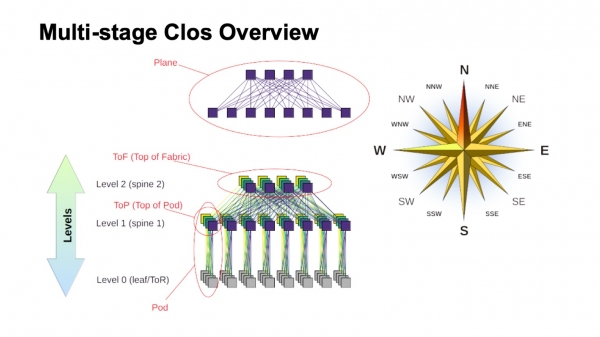
Si është strukturuar përafërsisht një rrjet Clos me shumë nivele dhe si quhen elementët e ndryshëm në të? Së pari, një rozetë ere, për të u orientuar, ku është veriu, ku është jugun, ku është lindja, ku është perëndimi. Rrjetet e këtij tipi zakonisht ndërtohen nga ata që kanë një trafik shumë të madh nga perëndimi në lindje. Sa i përket elementëve të tjerë, në krye është një switch virtual, e përbërë nga switch-e më të vogla. Kjo është ideja kryesore e ndërtimit recursiv të rrjeteve Clos. Ne marrim elemente me një radiks dhe i lidhim në një mënyrë që ajo që kemi arritur të quhet si një switch me një radiks më të madh. Nëse nevojitet edhe më shumë, procedura mund të përsëritet.
Në raste si p.sh., me Clos të dyfishta, kur komponentët e mia që janë vertikale në skemën time mund të identifikohen qartë, ato zakonisht quhen plane. Nëse do të ndiheshim me Clos me tre nivele switch-e spine (të gjitha ato që nuk janë kufitare dhe nuk janë switch-e ToR, dhe përdoren vetëm për transit), atëherë planet do të duken më të komplikura; ato dyfishe duken pikërisht kështu. Bloku i switch-eve ToR ose leaf dhe switch-et e tyre të asociuara të nivelit të parë spine, i quajmë Pod. Switch-et e nivelit spine-1 në krye të Pod-it janë top of Pod, maja e Pod-it. Switch-et që ndodhen në krye të gjithë fabrikës janë shtresa më e lartë e fabrikës, Top of fabric.
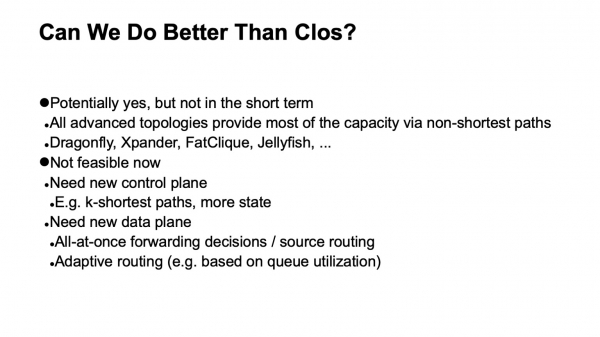
Sigurisht, lind pyetja: Rrjetet Clos janë ndërtuar për një kohë të gjatë, dhe ideja vetë daton nga koha e telefonisë klasike, rrjetet TDM. A mund të ketë dalë diçka më e mirë, a mund të bëhet ndonjëherë më mirë? Po dhe jo. Teoretikisht po, në praktikë në afat të shkurtër me siguri jo. Sepse ka një numër të caktuar topologjish interesante, disa prej tyre përdoren edhe në prodhim, për shembull, Dragonfly përdoret në aplikacione HPC; gjithashtu ka topologji interesante si Xpander, FatClique, Jellyfish. Nëse shihni raportet në konferenca si SIGCOMM ose NSDI së fundmi, mund të zbuloni një numër të konsiderueshëm punimesh mbi topologjitë alternative që kanë disa nga karakteristikat më të mira (kështu apo ashtu) se Clos.
Por të gjitha këto topologji kanë një pronë interesante. Kjo pengon implementimin e tyre në rrjetet e qendrave të të dhënave, që ne përpiqemi të ndërtojmë mbi harduer standard dhe që kushtojnë mjaft para. Në të gjitha këto topologji alternative, pjesa më e madhe e brezit, për fat të keq, nuk është e arritshme përmes rrugëve më të shkurtra. Prandaj ne menjëherë humbasim mundësinë për të përdorur planin tradicional të kontrollit.
Teoretikisht, zgjidhja e problemit është e njohur. Kjo është, për shembull, modifikime të link state duke përdorur k-shortest path, por, përsëri, nuk ka protokolle të tilla që të jenë realizuar në prodhim dhe të jenë masivisht të disponueshme në pajisje.
Për më tepër, pasi pjesa më e madhe e kapacitetit është e disponueshme në rrugë të tjera, ne duhet të modifikojmë jo vetëm plane-në-kontroll, që ai të zgjedhë të gjitha këto rrugë (dhe, për t'u përmendur, kjo është një gjendje shumë më e madhe në plane-në-kontroll). Na nevojitet gjithashtu të modifikojmë plane-në-fowarding, dhe, si rregull, kërkohen të paktën dy karakteristika shtesë. Kjo është mundësia për të marrë të gjitha vendimet rreth përcjelljes së pakove njëherësh, për shembull, në host. Në fakt, kjo është ruterimi i burimeve, ndonjëherë në literaturën e rrjeteve të lidhjes quhet vendime për përcjelljen të gjitha njëherësh. Dhe një ruterim adaptiv - kjo është një funksion që na nevojitet në elementët e rrjetit, i cili përfshin, për shembull, se si zgjedhim hop-in e ardhshëm në bazë të informacionit për ngarkesën më të ulët të radhës. Si shembull, janë të mundshme variante të tjera.
Pra, drejtimi është interesant, por, fatkeqësisht, tani për tani nuk mund ta aplikojmë.
Ok, u ndalëm në topologjinë logjike Clos. Si do ta shkallëzojmë atë? Le të shohim si është e organizuar dhe çfarë mund të bëjmë.
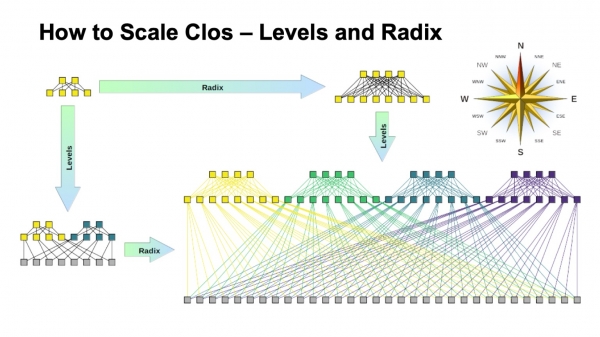
Në rrjetin Clos ka dy parametra kryesorë, të cilët mund t'i variojmë dhe të arrijmë rezultate të ndryshme: radix e elementeve dhe numri i niveleve në rrjet. Kam skematizuar si të dyja ndikojnë në madhësinë. Në mënyrë ideale i kombinojmë të dyja.
Duket se gjerësi finale e rrjetit Clos është prodhimi i të gjitha niveleve të switch-ave spine të radix-it jugor, sa lidhje kemi poshtë, si ndahen ato. Kështu e shkallëzojmë madhësinë e rrjetit.
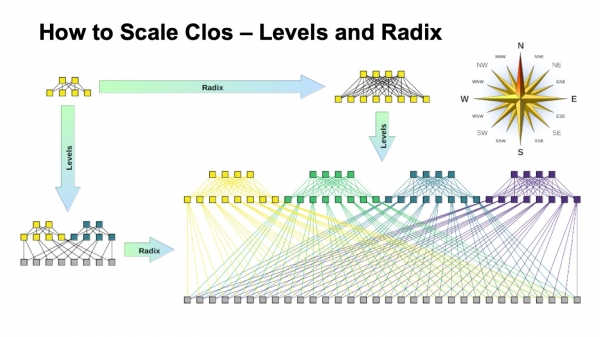
Sa i përket kapacitetit, veçanërisht në switches ToR, ka dy mundësi për shkallëzim. Ose mund të përdorim lidhje më të shpejta duke ruajtur topologjinë totale, ose mund të shtojmë më shumë plane.
Nëse shohim variantin e shtrirë të rrjetit Clos (në këndin e poshtëm të djathtë) dhe kthehemi në këtë imazh me rrjetin Clos në fund...
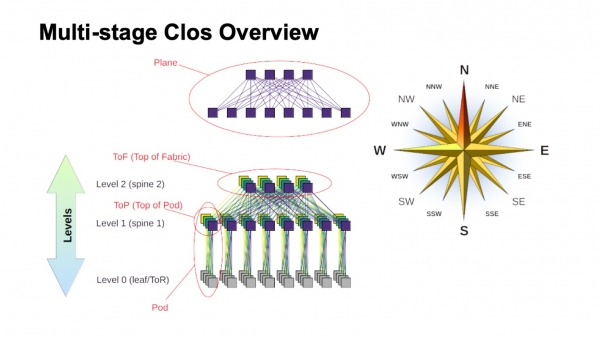
…atëherë kjo është e njëjta topologji, por në këtë slajd është komprime më kompakt dhe planet e fabrikës janë të vendosura njëra mbi tjetrën. Kjo është e njëjta gjë.
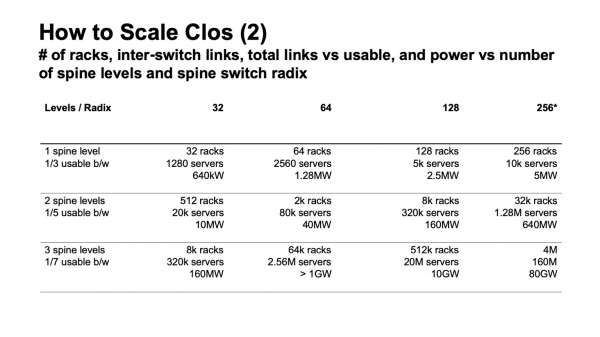
Si duket shkallëzimi i rrjetit Clos në numra? Këtu kam të dhëna për gjerësinë maksimale që mund të arrijë rrjeti, numrin maksimal të raftëve, switches ToR ose switches leaf, nëse ato nuk ndodhen në raftë, që mund të arrijmë në varësi të asaj që kemi radix e switches përdorur për nivelet spine dhe sa nivele po përdorim.
Këtu është treguar se sa stenda mund të kemi, sa serverë dhe sa energji mund të konsumojnë në përllogaritjen 20 kW për stendë. Pak më parë përmenda se ne synojmë një tepërsi klasteri rreth 100,000 serverësh.
Evident është se në të gjithë këtë strukturë interes përbëjnë dy e gjysmë variante. Ka një variant me dy nivele spainesh dhe switch-e 64-portesh, i cili është pak nën nivel. Më pas, ka variante të shkëlqyera për switch-e me 128 porte (me radix 128) me dy nivele, ose switch-e me radix 32 me tre nivele. Në të gjitha rastet ku ka më shumë radix dhe më shumë nivele, mund të krijohet një rrjet shumë të madh, por nëse shqyrtoni konsumimin e pritur, zakonisht atje janë gigavat. Mund të vendosim kabllin, por kaq shumë energji në një vend, vështirë se do ta marrim. Nëse shihni statistikën, të dhënat publike për qendrat e të dhënave — shumë pak mund të gjeni qendra të të dhënave me kapacitet të llogaritur mbi 150 MW. Ata që janë më shumë — zakonisht janë kampuset e qendrave të të dhënave, disa qendra të mëdha të të dhënave që ndodhen mjaft afër njëra-tjetrës.
Ka edhe një parametr tjetër të rëndësishëm. Nëse shihni kolonën e majtë, aty është e shënuar bandwidth usable. Nuk është e vështirë të vëresh se në rrjetin Clos, një pjesë e dukshme e porteve shkon për të lidhur switch-et me njëri-tjetrin. Bandwidth usable, shpejtësia e dobishme, është ajo që mund të japim jashtë, në drejtim të serverëve. Natyrisht, po flas për porte kondicionale dhe pikërisht për bandwidth. Zakonisht, lidhjet brenda rrjetit janë më të shpejta se lidhjet në drejtim të serverëve, por për një njësi bandwidth, sa mund ta japim jashtë për pajisjet tona server, ka akoma disa bandwidth brenda vetë rrjetit. Dhe sa më shumë nivele krijojmë, aq më shumë janë shpenzimet për të siguruar këtë bandwidth jashtë.
Më tej, madje edhe kjo shpejtësi shtesë nuk është krejt siç duhet. Për aq kohë sa kalimet janë të shkurtra, mund të përdorim diçka si DAC (direct attach copper, dmth kabllot twinax), ose optikë multimode, të cilat janë akoma me çmime më, më të arsyeshme. Sa herë që kalojmë në kalime më të gjata — zakonisht është optikë me një mod, dhe kostoja e kësaj shpejtësie shtesë rritet ndjeshëm.
Dhe përsëri, duke u kthyer në slajdin e mëparshëm, nëse ne krijojmë një rrjet Clos pa riparimin, nuk është e vështirë të shohim skemën, të shohim si ndërtohet rrjeti — duke shtuar çdo nivel switch-i spine, ne e përsërisim të gjithë atë bandë që ishte poshtë. Plus niveli — plus e gjithë ajo bandë, aq sa kishte në nivelin e mëparshëm, porte në switch-e, aq shumë transceiverësh. Prandaj, sa më shumë nivele switch-i spine të ketë, aq më mirë që të minimizohet numri i tyre.
Duke u bazuar në këtë figurë, është e qartë se dëshirojmë shumë të ndërtojmë në diçka si switches me radix 128.
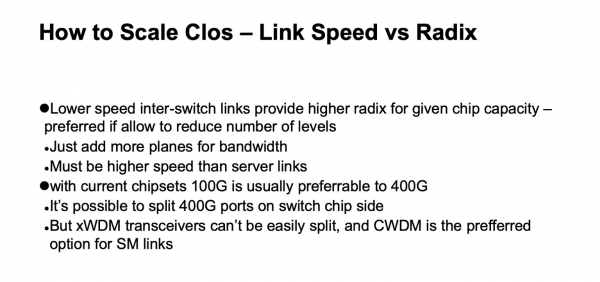
Këtu në parim është gjithçka e njëjtë me atë që kam treguar tani, ky slajd është më shumë për shqyrtim më vonë.
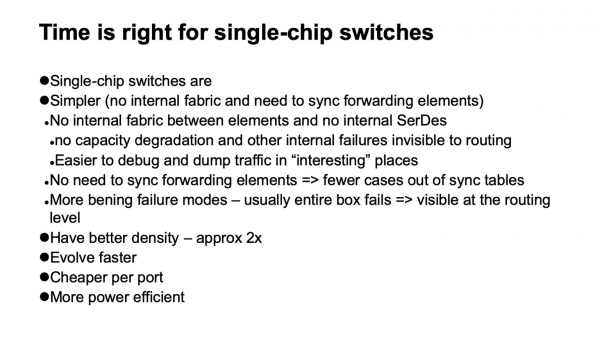
Cilat janë opsionet që mund të zgjedhim si këto switch-e? Një lajm shumë i këndshëm për ne është se tani këto rrjete më në fund mund të ndërtohen mbi switch-e me një çip. Dhe kjo është shumë e shkëlqyer, ata kanë shumë karakteristika të bukura. Për shembull, ata përfshijnë praktikisht strukturën e brendshme. Kjo do të thotë që janë më të prirur për të dështuar. Ata dështojnë, çfarë do të ndodhte, por, për fat të mirë, dështojnë komplet. Në pajisjet modulare ka një numër të madh dështimesh (shumë të pakëndshme), kur nga pikëpamja e fqinjëve dhe planeve të kontrollit duket se funksionojnë, por, për shembull, një pjesë e fabrikës ka dalë jashtë funksionit, dhe funksionin e plotë nuk e arrin. Dhe trafiku balancohet duke marrë parasysh që ato janë plotësisht funksionale, dhe ne mund të përballojmë ngarkesën.
Ose, për shembull, shfaqen probleme me backplane-in, sepse brenda një pajisjeje moduli gjithashtu ka SerDes të lartë — është mjaft kompleks brenda. Ose tableta midis elementëve të forwarding-s sinkronizohen ose jo. Në përgjithësi, çdo pajisje modulare me performancë të lartë, që përbëhet nga shumë elementë, zakonisht përmban atë rrjet Clos, vetëm që është shumë e vështirë për t'u diagnostikuar. Shpesh edhe vetë ofruesi ka vështirësi në diagnostikimin e saj.
Dhe ajo ka një numër të madh skenarësh dështimi, ku pajisja degradohet, por nuk bie plotësisht nga topologjia. Duke qenë se rruga jonë është e madhe, balancimi midis elementeve identike përdoret aktivisht, rruga është shumë e rregullt, që do të thotë një rrugë, ku gjithçka është në rregull, nuk dallohet nga tjetra. Më mirë është thjesht të humbasim një pjesë të pajisjeve nga topologjia, sesa të kemi një situatë kur disa prej tyre duken se funksionojnë, por në të vërtetë nuk funksionojnë.
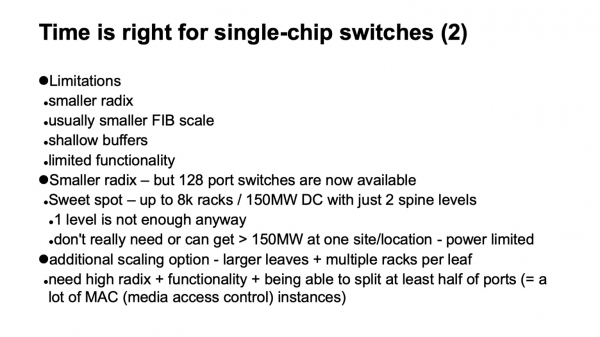
Një karakteristikë tjetër e këndshme e pajisjeve me një çip është se ato evoluojnë më mirë dhe më shpejt. Gjithashtu, ato zakonisht kanë kapacitet më të mirë. Nëse marrim strukturat e mëdha të ndërtuara që kemi, për një rreth, kapaciteti për rreth një njësi po i portave me të njëjtën shpejtësi rezulton të jetë gati dy herë më i mirë se ai i pajisjeve modulare. Pajisjet që ndërtohen rreth një çipi dalin dukshëm më të lira se ato modulare dhe konsumojnë më pak energji.
Por, natyrisht, kjo nuk është ashtu thjesht, ka dhe disavantazhe. Së pari, çuditërisht gjithmonë ka një radiks më të vogël se ato modulare. Nëse mund të marrim një pajisje, e ndërtuar rreth një çipi me 128 porte, atëherë pajisjet modulare mund t'i marrim me disa qindra porte tani tashmë pa probleme të mëdha.
Ky është dukshëm një përmasë më e vogël e tabelave të përparimit dhe, si rregull, të gjithave që lidhen me shkallëzimin e planeve të të dhënave. Buffera të cekëta. Dhe, si rregull, mjaft funksionalitet i kufizuar. Por zbulohet se nëse i dimë këto kufizime dhe kujdesemi në kohë për t’i anashkaluar ose thjesht t’i marrim parasysh, atëherë nuk është kaq e tmerrshme. Faktin që radiksi është më i vogël, në pajisjet e reja që kanë dalë së fundmi me radiks 128 nuk është një problem më, mund të ndërtojmë në dy nivele sprynash. Ndërsa për më pak se dy nuk ka asgjë interesante për ne në ndërtimin e një përmasash të vogël. Me një nivel, dalin klasterë shumë të vegjël. Edhe dizajnet dhe kërkesat tona të mëparshme prapëseprap i kanë tejkaluar ato.
Në të vërtetë, nëse ndonjëherë zgjidhja është në prag, ka një mënyrë tjetër për t'u zgjeruar. Duke qenë se niveli i fundit (apo i parë), ai më i ulët ku lidhen serverët — janë switch-at ToR ose leaf, ne nuk jemi të detyruar të lidhim një raft të vetëm në to. Prandaj, nëse zgjidhja nuk mbulon ndonjë nevojë dyfish, mund të mendojmë thjesht për të përdorur një switch me një radix më të madh në nivelin më të ulët dhe të lidhim, për shembull, dy-tre rafte në një switch. Kjo është gjithashtu një mundësi, ka kostot e veta, por funksionon mjaft mirë dhe mund të jetë një zgjidhje e mirë kur duam të arrijmë dyfishin e madhësisë.
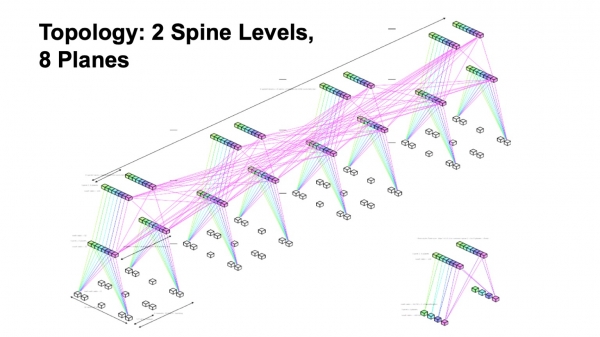
Për të përmbledhur, ne ndërtuam një topologji me dy nivele spine, me tetë shtresa fabrike.
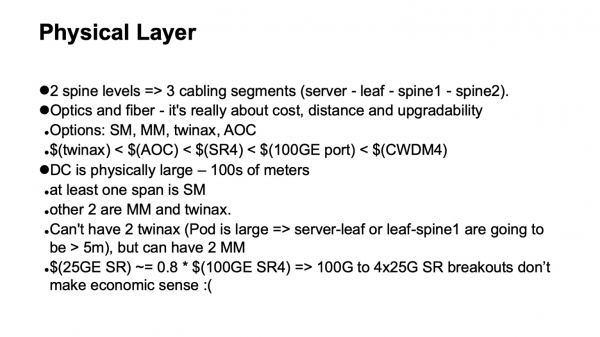
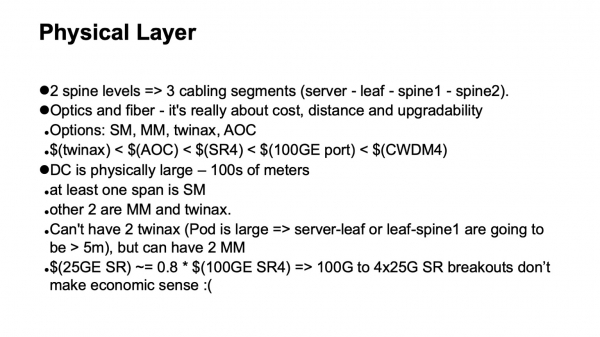
Çfarë do të ndodhë me fizikën? Llogaritje shumë të thjeshta. Nëse kemi dy nivele spine, atëherë ne kemi gjithsej tre nivele switch-esh, dhe presim që në rrjet të ketë tre segmente kabllore: nga serverët në switch-at leaf, në spine 1, në spine 2. Opsionet që mund të përdorim janë twinax, multimode, single mode. Dhe këtu duhet të merret parasysh se çfarë gjerësie është e disponueshme, sa do të kushtojë, çfarë janë përmasat fizike, çfarë distancash mund të kalojmë dhe si do të bëjmë përmirësimin.
Për çmimin, gjithçka mund të vihet në një linjë. Twinax-t janë ndjeshëm më të lira se optika aktive, më të lira se multimode transceiver-at, kur merret për distancë nga fundi, ca më lirë se porti 100-gigabit i switch-it. Dhe, vëmendje, ai është më i lirë se optika single mode, sepse në distancat ku kërkohet single mode, në qendrat e të dhënave për një sërë arsye janë më racionale të përdoren CWDM, punimi me single mode të paralelës (PSM) nuk është shumë i përshtatshëm, rezulton një paketë shumë të madhe fibër, dhe nëse qëndrojmë te këto teknologji, kemi një hierarki të tillë çmimesh.
Një vërejtje tjetër: fatkeqësisht, nuk po funksionon shumë mirë të përdorim portet multimode 100 të ndara në 4x25. Për shkak të veçorive të dizajnit, transceiver-at SFP28 nuk janë shumë më të lira se QSFP28 me 100 Gbit. Dhe kjo ndarje për multimode nuk funksionon shumë.
Një kufizim tjetër është se për shkak të madhësisë së klasterëve kompjuterikë, për shkak të numrit të serverëve, qendrat tona të të dhënave dalin fizikisht të mëdha. Kjo do të thotë se të paktën një ndarje duhet të bëhet me modin e vetme. Përsëri, për shkak të madhësisë fizike të Pods, nuk do të jetë e mundur të kalojmë dy hapësira twinax me kabllo bakri.
Përfundimisht, nëse optimizojmë për çmimin dhe marrim parasysh gjeometrinë e kësaj strukture, ne arrijmë një ndarje me twinax, një ndarje me multimod dhe një ndarje me mod të vetme duke përdorur CWDM. Kjo merr parasysh rrugët e mundshme të përmirësimit.
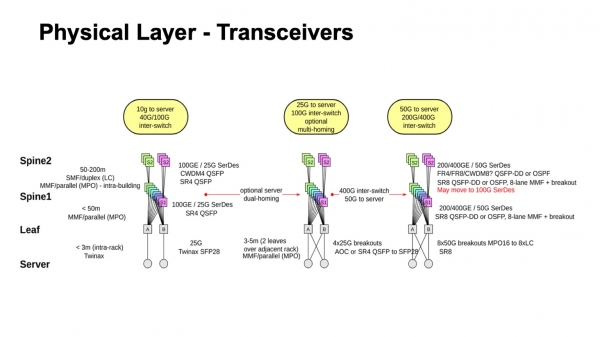
Kështu duket, se çfarë ishte së fundmi, drejt ku po shkojmë dhe çfarë është e mundur. Është e qartë, së paku, si të lëvizim drejt SerDes me 50 gigabit dhe për multimod dhe për mod të vetme. Për më tepër, nëse shikojmë atë që ekziston tani në transiverët me mod të vetme dhe perspektivën për 400G, shpeshherë, kur vijnë SerDes me 50G nga ana elektrike, ato mund të shkojnë deri në 100 Gbps për kanal në optikë. Prandaj, është mjaft e mundur që në vend të kalimit në 50, do të ndodhë kalimi në SerDes me 100-gigabit dhe 100 Gbps për kanal, pasi shumë ofrues e presin disponueshmërinë e tyre mjaft së shpejti. Periudha kur SerDes me 50G ishin më të shpejtit duket se do të jetë mjaft e shkurtër, pasi SerDes me 100G do të lançohet vitin e ardhshëm me mostrat e para. Dhe pas një kohe pas kësaj, ndoshta do të kenë çmime më të arsyeshme.
Një tjetër nuancë në lidhje me zgjedhjen e fizikës. Në parim, tashmë mund të përdorim porte 400 ose 200-gigabit duke përdorur SerDes me 50G. Por rezulton se nuk ka ndonjë kuptim të veçantë, sepse, siç e tregova më parë, ne duam një radix të mjaftueshëm në switch-e, brenda arsyeshmërive, sigurisht. Ne duam 128. Kur kapaciteti i çipëve është i kufizuar dhe ne rrisim shpejtësinë e lidhjes, atëherë radiksi, natyrisht, zvogëlohet, nuk ka mrekulli.
Dhe ne mund ta rrisim kapacitetin total përmes planeve, dhe në këtë rast nuk ka shpenzime të veçanta, mund të shtojmë numrin e planeve. Nëse humbim radiksin, do të na duhet të futim një nivel shtesë, prandaj, me strukturat aktuale, me kapacitetin maksimal të disponueshëm për një çip, del se është më efikase të përdorim porte 100-gigabit, sepse ato lejojnë të arrijmë një radiks më të madh.
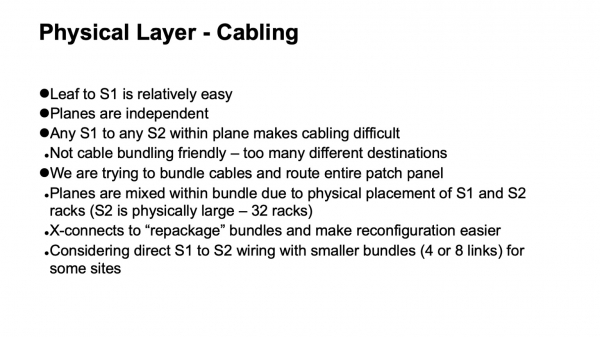
Pyetje tjetër është se si është e organizuar fizika, por tashmë nga këndvështrimi i infrastrukturës kabllore. Zbulohet se ajo është organizuar mjaft argëtuese. Kabelizimi midis switch-eve leaf dhe spine-ve të nivelit të parë - atje nuk ka shumë lidhje, gjithçka është e ndërtuar relativisht thjesht. Por nëse marrim një plan, atë që ndodh brenda - atje duhet të lidhim të gjithë spine-t e nivelit të parë me të gjithë spine-t e nivelit të dytë.
Për më tepër, zakonisht ka disa dëshira se si duhet të duket brenda qendrës së të dhënave. Për shembull, ne dëshironim shumë të bashkonim kabllot në bundl dhe t'i tërheqnim në mënyrë që një panele patch me densitet të lartë të shkonte plotësisht në një panelet patch, për të mos pasur një xhungël me gjatësi të ndryshme. Na arriti të zgjidhnim këtë problem. Nëse e shohim fillimisht topologjinë logjike, është e dukshme se planet janë të pavarura, çdo plan mund të ndërrtohet vetë. Por kur shtojmë një bundl dhe duam t'i tërheqim plotësisht panelet patch në panele patch, atëherë duhet të përziejmë plane të ndryshme brenda një bundli dhe të introduktojmë një konstrukcion të mesëm në formën e cross-connect-eve optike, për të ri-paketuar ato nga ajo se si janë ndërtuar në një segment, në atë se si do të mblidhen në një segment tjetër. Falë kësaj, ne fitojmë një veçori të këndshme: e gjithë komutimi kompleks nuk del përtej rack-eve. Kur ndonjëherë është e nevojshme të shpërndahen shumë, "të shtrihen planet", siç e quajnë ndonjëherë në rrjetet Clos, kjo gjithçka është e përqendruar brenda një stani. Nuk kemi shumë komutime të shpërbëra, madje deri në lidhjet individuale, midis stagnave.
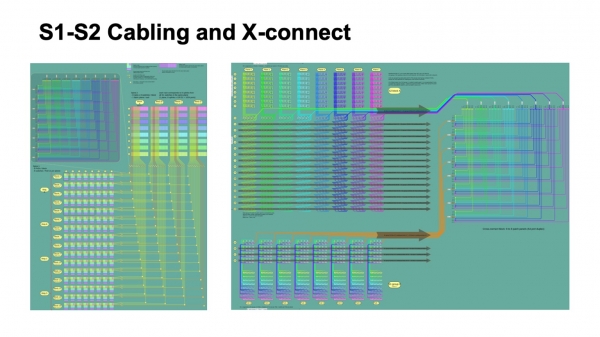
Kështu duket nga këndvështrimi i organizimit logjik të infrastrukturës kabllore. Në imazhin në të majtë, blloqet me ngjyra përfaqësojnë blloqet e switch-eve spine të nivelit të parë, nga tetë dhe katër bundla kabuj që dalin prej tyre, që kalojnë dhe ndërthuren me bundlat që dalin nga blloqet e switch-eve spine-2.
Katërkëndsha e vogla tregon ndërprerjet. Në këndin e majtë lartë është paraqitur një shqyrtim i çdo ndërprerjeje të tillë, që në të vërtetë është një moduli i cross-connect me 512 në 512 porte, të cilat riambalazhojnë kabllot në mënyrë që të arrijnë plotësisht në një kabinë, ku ka vetëm një rrafsh spine-2. Dhe në të djathtë është një shqyrtim pak më i detajuar i kësaj skeme në lidhje me disa Pods në nivelin spine-1, dhe si paketohen në cross-connect, si arrijnë në nivelin spine-2.
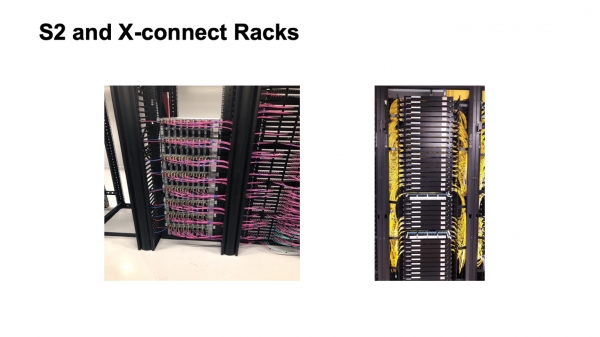
Kështu duket. Një kabinë spine-2 e mbledhur ende jo plotësisht (majtas) dhe kabina e cross-connect. Fatkeqësisht, nuk shihet shumë. E gjithë kjo strukturë po zhvillohet tani në një nga qendrat tona të mëdha të të dhënave, që po zgjerohet. Kjo është një punë në proces, do të duket më bukur, do të mbushet më mirë.
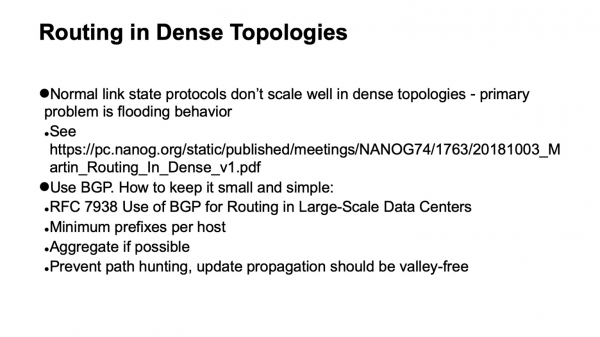
Një pyetje e rëndësishme: zgjodhëm topologjinë logjike, ndërtuam fizikën. Çfarë do të ndodhë me plane-n e kontrollit? Ka të dhëna të njohura nga përvoja operuese, ka një sasi të caktuar të prezantimeve, që protokollet link state janë të mira, është kënaqësi të punosh me to, por, fatkeqësisht, në një topologji të ndërlidhur keq, ato nuk shkallëzohen mirë. Dhe ka një faktor kryesor që pengon këtë — është mënyra se si funksionon përhapja në protokollet link state. Nëse e marrim thjesht algoritmin e përhapjes, dhe e shikojmë siç është struktura e rrjetit tonë, shihet që në çdo hap do të ketë një fanout shumë të madh, dhe do të mbërthejë plane-n e kontrollit me azhurnime. Këto lloje topologjish, në veçanti me algoritmin tradicional të përhapjes në protokollet link state, përzihen shumë keq.
Zgjedhja është të përdorim BGP. Si ta përgatisim atë siç përshkruhet në RFC 7938 për përdorimin e BGP në qendrat e mëdha të të dhënave. Idetë bazë janë të thjeshta: numri minimal i prefikseve për host dhe në përgjithësi numri minimal i prefikseve në rrjet, të përdorim agregimin, nëse është e mundur, dhe të shtypim hunt-in e rrugëve. Duam një shpërndarje të azhurnimeve shumë të kujdesshme, shumë të kontrolluar, atë që quhet valley free. Duam që azhurnimet, duke kaluar përmes rrjetit, të zhvillohen vetëm një herë. Nëse ato origjinojnë poshtë, shkojnë lart, zhvillohen jo më shumë se një herë. Nuk duhet të ketë zig-zaga. Zig-zagat janë shumë të këqija.
Për ta bërë këtë, ne përdorim një skemë mjaft të thjeshtë për të përdorur mekanizmat bazë BGP. Kështu që ne përdorim eBGP që punon në link local, dhe sistemet autonome caktohen në këtë mënyrë: një sistem autonom në ToR, një sistem autonom për të gjithë grupin e switch-ëve spain-1 në një Pod, dhe një sistem autonom të përgjithshëm për të gjithë Top of Fabric. Nuk është e vështirë të shikosh dhe të sigurohesh se madje edhe sjellja normale e BGP na jep atë shpërndarje azhurnimesh që dëshirojmë.
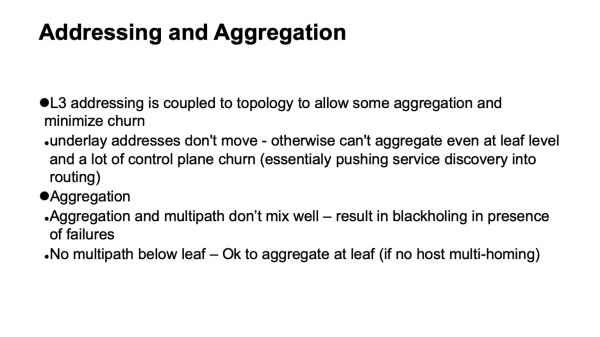
Natyrisht, duhet të dizajnojmë adresimin dhe agregimin e adresave në një mënyrë që të jetë e përputhshme me mënyrën se si është ndërtuar rrugëzimi, që të sigurojë stabilitetin e control plane. L3 adresimi në transport është i lidhur me topologjinë, sepse pa të nuk mund të arrihet agregimi, pa të adresat individuale do të depërtojnë në sistemin e rrugëzimit. Dhe një gjë tjetër — është se agregimi, fatkeqësisht, nuk përzihet shumë mirë me multi-path, sepse kur kemi multi-path dhe kemi agregim, gjithçka është mirë kur e gjithë rr network është funksionale dhe nuk ka defekte. Fatkeqësisht, sa herë që dalin defekte në rrjet, dhe simetria e topologjisë humbet, mund të arrijmë në pikën nga e cila është njoftuar aggregati, dhe nga e cila nuk mund të kalojmë më tutje aty ku na nevojitet. Prandaj, është më mirë të agregojmë atje ku nuk ka më multi-path, në rastin tonë, këtë e bëjnë switch-et ToR.
Në të vërtetë, është e mundur të agregosh, por me kujdes. Nëse mund të bëjmë një dëmë të kontrolluar kur dalin defekte në rrjet. Por kjo është një detyrë mjaft e komplikuar, ne madje e kemi shqyrtuar, a është e mundur që të vendosim automatizim shtesë dhe automatikët fundorë që do të godasin BGP në mënyrë korrekte për të marrë sjelljen e dëshiruar. Fatkeqësisht, përpunimi i rasteve të veçanta është shumë e paqartë dhe e ndërlikuar, dhe duke u bashkuar me BGP pajisje të jashtme, kjo detyrë nuk zgjidhet mirë.
Një punë shumë interesante është bërë në këtë drejtim brenda protokolit RIFT, për të cilin do të flitet në prezantimin e ardhshëm.
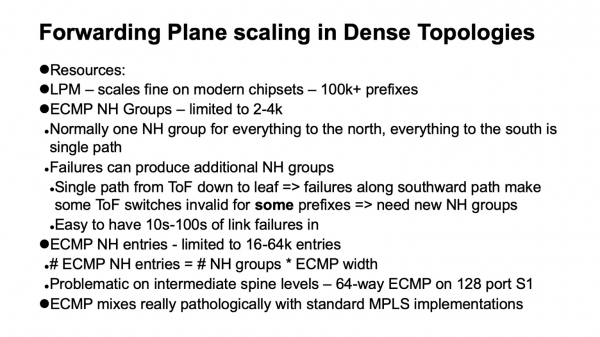
Një gjë tjetër e rëndësishme është se si shkallëzohen data plane në topologji të dendura, ku kemi një numër të madh rrugësh alternative. Në këtë rast, përdoren disa struktura të dhënash shtesë: grupet ECMP, të cilat përfaqësojnë në mënyrë të detajuar grupet Next Hop.
Në një rrjet që funksionon normalisht, pa ndalje, kur ne ngjitemi në topologjinë Clos, mjafton të përdorim vetëm një grup, sepse çdo gjë që nuk është lokale përshkruhet nga defekti; mund të ngjitemi lart. Kur ne shkojmë nga lart-poshtë drejt jugut, të gjitha rrugët nuk janë ECMP, ato janë rrugë me një rrugë të vetme. Është mirë. Problemi është, dhe karakteristika e klasikës së topologjisë Clos është se nëse ne e shohim Topin e fabrikës, në çdo element, deri në çdo element poshtë ka një rrugë të vetme. Nëse gjatë kësaj rruge ndodhin dështime, atëherë ky element konkret në krye të fabrikës bëhet invalid për ata prefikse që ndodhen pas rrugës së prishur. Për të tjerët, ai është valid, dhe na duhet të shqyrtojmë grupet ECMP dhe të futim një gjendje të re.
Si duket shkallëzueshmëria e planeve të dhënave në pajisjet moderne? Nëse ne bëjmë LPM (nënshkrimin më të gjatë), të gjitha shkojnë mjaft mirë, mbi 100k prefikse. Nëse flasim për grupet Next Hop, gjithçka është më keq, 2-4 mijë. Nëse flasim për tabelën që përmban përshkrimin e Next Hops (ose adjacencies), atëherë kjo varion nga 16k deri në 64k. Dhe kjo mund të bëhet një problem. Dhe këtu ne afrohemi me një shpjegim interesant: çfarë ndodhi me MPLS në qendrat e të dhënave? Në thelb, ne donim ta bënim atë.
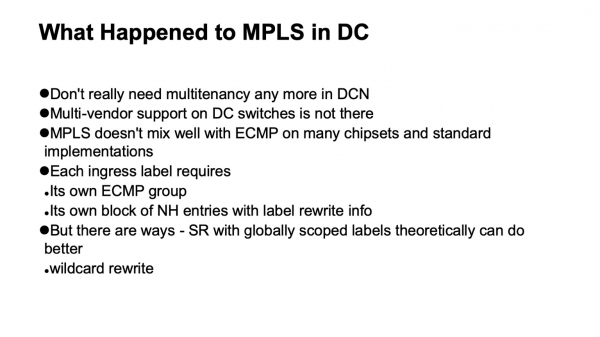
Ndodhi dy gjëra. Ne bëmë mikrosegmentimin në hoste, nuk na nevojitej ta bënim këtë në rrjet. Nuk ishte shumë mirë me mbështetje nga furnizues të ndryshëm dhe për më tepër me implementimet e hapura në kutitë e bardha me MPLS. Dhe, MPLS, të paktën realizimet e tij tradicionale, fatkeqësisht, nuk përputhen shumë mirë me ECMP. Dhe ja pse.
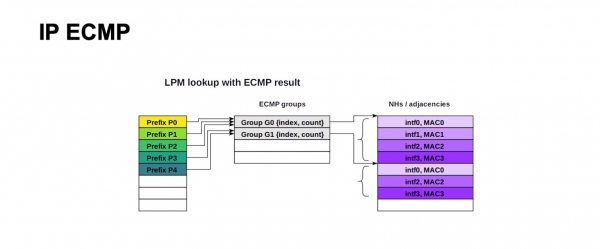
Kjo është struktura e përçimit ECMP për IP. Një numër i madh prefikse mund të përdorin të njëjtin grup dhe të njëjtin bllok Next Hops (ose adjacencies, në dokumentacionin e ndryshëm për pajisje të ndryshme mund të quhet ndryshe). Kuptimi është se kjo përshkruhet si porta dalëse dhe se çfarë të rishkruhet adresa MAC për të arritur në Next Hop të duhur. Për IP gjithçka duket e thjeshtë, mund të përdoret për një numër shumë të madh prefikse në të njëjtin grup, të njëjtin bllok Next Hops.
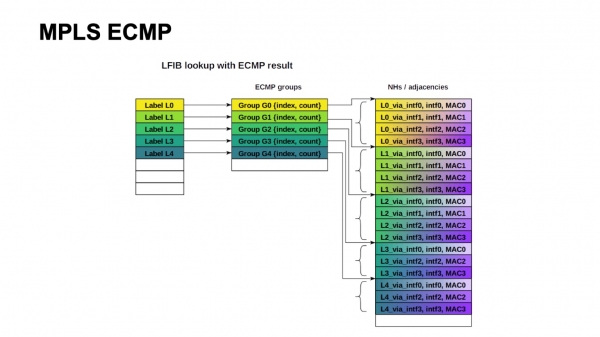
Arkitektura klasike MPLS nënkupton - në varësi të ndërfaqes dalëse, etiketa mund të rishkruhet në vlera të ndryshme. Prandaj, na nevojitet të mbajmë për grupin dhe për bllokun Next Hops për çdo etiketë hyrëse. Dhe, për fat të keq, kjo nuk shkallëzohet.
Nuk është e vështirë të shohësh se në ndërtimin tonë na duheshin rreth 4000 ToR-switch, me gjerësinë maksimale — 64 rrugë ECMP, nëse shkëputemi nga spina-1 në drejtim të spina-2. Po e kalojmë me vështirësi, jemi në kufi, në një tabelë ECMP-grupesh, nëse vetëm një prefiks me ToR largohet, dhe në fakt nuk kalojmë dot në tabelën Next Hops.
Gjithçka nuk është pa shpresë, sepse arkitekturat si Segment Routing nënkuptojnë etiketa globale. Formalisht do të ishte e mundur të shndërroheshin përsëri të gjitha këto blloqe Next Hops. Për këtë nevojitet një operacion si wild card: të marresh etiketën dhe ta rishkruash atë në të njëjtën pa një vlerë specifike. Por fatkeqësisht, në implementimet e disponueshme, kjo nuk është shumë e pranishme.
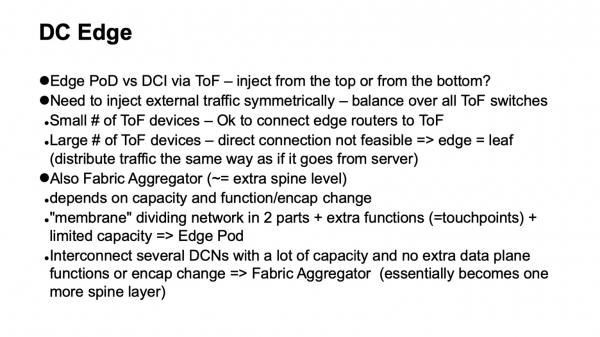
Dhe përfundimisht, na nevojitet që të sjellim trafik të jashtëm në qendrat tona të të dhënave. Si ta bëjmë këtë? Më parë, trafiku dërgohej në rrjetet Clos nga lart. Kështu, kishte ruterë kufitarë që lidhnin me të gjithë pajisjet në Top of fabric. Ky zgjidhje funksionon mjaft mirë për madhësi të vogla dhe të mesme. Fatkeqësisht, për të sjellë trafik në mënyrë simetrike në tërë rrjetin, duhet të arrijmë njëkohësisht në të gjithë elementët e Top of fabric, dhe kur ato rriten mbi qindra, zbulojmë se na nevojitet një radiks i madh edhe te ruterët kufitarë. Në tërësi, kjo ka kosto, sepse ruterët kufitarë janë më funksionalë, portet mbi ta do të jenë më të shtrenjta, dhe kështu krijohet një konstrukcion jo shumë i bukur.
Një opsion tjetër është të sjellim këtë trafik nga poshtë. Nuk është e vështirë të kuptohet se topologjia Clos është ndërtuar në mënyrë që trafiku që hyn nga poshtë, domethënë nga ana e ToR, shpërndahet në mënyrë të barabartë në nivele në tërë Top of fabric për dy iteracione, duke ngarkuar tërë rrjetin. Prandaj, ne prezantojmë një lloj të veçantë Pod, Edge Pod, i cili siguron lidhshmërinë e jashtme.
Ka një opsion tjetër. Për shembull, Facebook e bën këtë. Ata e quajnë këtë Fabric Aggregator ose HGRID. Shtohet një nivel shtesë spine për të lidhur disa qendra date. Kjo ndarje është e mundur nëse nuk kemi funksione shtesë ose ndryshimin e enkapulacionit në nyje. Nëse ka, ato janë pika të tjera kontakti, dhe kjo është e ndërlikuar. Si rregull, krijohen më shumë funksione dhe një lloj membrane, që ndan pjesët e ndryshme të qendrës së të dhënave. Nuk është e mençur të bëhet kjo membranë shumë e madhe, por nëse është e nevojshme, ka kuptim ta shqyrtojmë mundësinë për ta bartur, ta bëjmë sa më të gjerë dhe ta transferojmë në hoste. Kjo bëhet, për shembull, nga shumë operatorë të cloud. Ata kanë overlays që fillojnë me hostet.
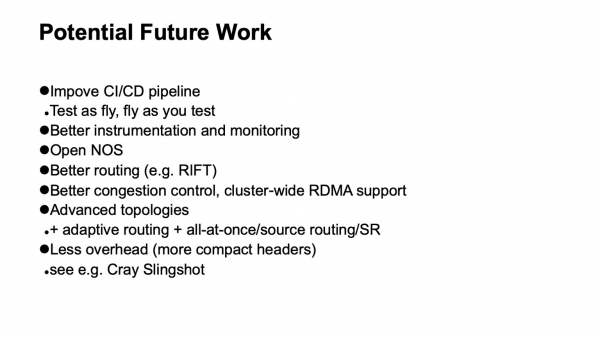
Cilat janë mundësitë që shohim për zhvillim? Së pari — përmirësimi i mbështetjes për CI/CD pipeline. Ne duam të operojmë ashtu si testojmë dhe të testojmë ashtu si operojmë. Kjo nuk po funksionon shumë mirë, sepse infrastruktura është e madhe, dhe është e pamundur ta kopjojmë atë për teste. Duhet të kuptojmë se si të integrojmë elementët e testimit në infrastrukturën operative, pa e prishur atë.
Instrumentimi më i mirë, monitorimi më i mirë nuk është kurrë tepër. Çështja është në ekuilibrin e përpjekjeve dhe rezultateve. Nëse është e mundur të shtohet me mjete të arsyeshme — është shumë e mirë.
Sistemet operuese të hapura për pajisjet rrjetërore. Protokollet më të mira dhe sistemet më të mira të ruterimit, për shembull RIFT. Gjithashtu, kërkohen studime mbi aplikimin e skemave më të mira të kontrollit të ngarkesës dhe, ndoshta, implementimi, të paktën në disa pika, të mbështetjes për RDMA brenda klasterit.
Nëse shohim për të ardhmen më të largët, duhen topologji të avancuara dhe ndoshta rrjete që përdorin overhead më të vogël. Nga gjërat e reja — janë botuar së fundmi publikime mbi teknologjinë e fabrikave për HPC Cray Slingshot, e cila bazohët në Ethernetin e zakonshëm, por me opsionin e përdorimit të kokave shumë më të shkurtra. Si rezultat, overhead reduktohet.
Gjithçka duhet bërë sa më e thjeshtë të jetë e mundur, por jo më thjeshtë. Ndërgjegjësimi është armiku i shkallëzueshmërisë. Thjeshtësia dhe struktura të rregullta janë miqtë tanë. Nëse mund të bëni scale out diku — bëni. Dhe në të vërtetë, tani është e shkëlqyer të merresh me teknologjitë e rrjetit. Po ndodhin shumë gjëra interesante. Faleminderit.
Burimi: habr.com
