

Ne jetojmë në një kohë të jashtëzakonshme, kur mund të lidhen shpejt dhe lehtësisht disa mjete të gatshme të hapura, t'i konfigurojmë ato me "dijeni të çaktivizuar" sipas këshillave nga stackoverflow, pa u shqetësuar për "shumë shkronja", dhe ta nisni atë në përdorim tregtar. Por kur do të vijë koha të përditësohet/zgjerohet ose ndokush rastësisht të rindezë disa makina — do të kuptoni se ka filluar një makth i ngjashëm me një ëndërr, gjithçka është përtej njohjes, rrugë e kthimit s'ka, e ardhmja është e paqartë dhe më e sigurt, përveç programimit, të rritni bletë dhe të bëni djathë.
Nuk është rastësi që kolegët më të përvojshëm, me koke të bardhë nga gabimet e shumta, duke vëzhguar shpërthimin e pabesueshëm të grupeve të "kontejnerëve" në "kubikë" në dhjetra servera në "gjuhë të modës" me mbështetje të integruar për hyrje/ dalje asinkrone dhe jo-bllokuese — buzëqeshin modestisht. Dhe në heshtje vazhdojnë të rishikojnë "man ps", përpiqen deri në gjakderdhje nga sytë në kodin burimor të "nginx" dhe shkruajnë-shkruajnë-shkruajnë teste njësie. Kolegët e dinë se gjëja më interesante do të ndodhë më vonë, kur "të gjitha këto" një natë do të kthehen në një telash për natën e Vitit të Ri. Dhe do t'i ndihmojë vetëm njohja e thellë e natyrës së unix-it, tabela e mësuar e gjendjeve TCP/IP dhe algoritmet themelore të renditjes-kërkimit.
Ah po, ndoshta u nisa pak larg, por shpresoj se kam arritur të transmetoj ndjenjën e pritjes.
Sot dua të ndaj përvojën tonë në zhvillimin e një staku të lehtë dhe të përballueshëm për DataLake, që zgjidh shumicën e problemeve analitike në kompani për strukturat e ndryshme organizative.
Disa kohë më parë arritëm të kuptojmë se kompanitë kanë nevojë gjithnjë e më shumë për frytet e analitikës produktive dhe teknike (pa e përmendur kërcellin mbi tortë në formën e machine learning) dhe për të kuptuar trendet dhe rreziqet — nevojitet të grumbullojmë dhe analizojmë gjithnjë e më shumë metrika.
Analitika themelore teknike në "Bitrix24"
Disa vjet më parë, në të njëjtën kohë me nisjen e shërbimit 'Bitrix24', ne investedh kontribuoi pak kohë dhe burime në krijimin e një platforme analitike të thjeshtë dhe të besueshme, e cila do të ndihmonte në mënyrë të shpejtë që të shiheshin problemet në infrastrukturë dhe të planifikoheshin hapat e ardhshëm. Natyrisht, mjetet preferoheshin t'i merrnim të gatshme dhe sa më të thjeshta dhe të kuptueshme. Si rezultat, u zgjodhën nagios për monitorim dhe munin për analitikë dhe vizualizim. Tani kemi mijëra verifikime në nagios, qindra grafikë në munin dhe kolegët tanë i përdorin ato çdo ditë me sukses. Metodikat janë të qarta, grafikët janë të kuptueshëm, sistemi punon besueshëm për disa vjet tani dhe rregullisht shtohen teste dhe grafikë të rinj: fillojmë një shërbim të ri — shtojmë disa teste dhe grafikë. Në një rrugë të mbarë.
Dora mbi puls — analitika teknike e avancuar
Dëshira për të marrë informacion mbi problemet 'sa më shpejt që të jetë e mundur' na çoi në eksperimentime aktive me mjete të thjeshta dhe të kuptueshme — pinba dhe xhprof.
Pinba na dërgonte statistikën në UDP-paketat për shpejtësinë e funksionimit të pjesëve të faqeve të web-it në PHP dhe ishte e mundur të shihnim në kohë reale në depozita MySQL (pinba vjen me motorin e saj MySQL për analitikë të shpejtë të ngjarjeve) një listë të shkurtër të problemeve dhe të reagonim ndaj tyre. Xhprof në mënyrë automatike lejonte grumbullimin e grafikëve të ekzekutimit të faqeve më të ngadalta PHP të klientëve dhe të analizohej se çfarë mund të kishte çuar në këtë — qetësisht, duke pirë çaj ose diçka më të fortë.
Disa kohë më parë, mjetet e punës u plotësuan me një tjetër motor të thjeshtë dhe të kuptueshëm në bazë të algoritmit të indeksimit invers, i realizuar mjaft mirë në bibliotekën legjendare Lucene — Elastic/Kibana. Ideja e thjeshtë e regjistrimit shumë-faqesh të dokumenteve në indeksin e kthyer Lucene në bazë të ngjarjeve në log dhe kërkimit të shpejtë për to duke përdorur ndarjen e fasetave — vërtet ishte e dobishme.
Pavarësisht pamjes mjaft teknike të vizualizimeve në Kibana me konceptet e nivelit të ulët 'bucket' dhe një gjuhë të rinovuar të algjebrës relacione, instrumenti na ndihmoi mirë në detyrat e mëposhtme:
- Sa gabime PHP kishte klienti Bitrix24 në portalin p1 gjatë orës së fundit dhe çfarë? Kuptoni, falni dhe rregulloni shpejt.
- Sa u bënë thirrje video në platforma në Gjermani gjatë 24 orëve të fundit, me cila cilësi dhe a kishte vështirësi me kanalin/rete?n?
- Sa mirë funksionon funksionaliteti sistematik (shtesa jonë në C për PHP), e ndërtuar nga burimi në përditësimin më të fundit të shërbimit dhe shpërndarë për klientët? A ka segfaults?
- A ruhen të dhënat e klientëve në memorien PHP? A ka gabime që tejkalojnë memorjen e ndarë për proceset: "jashtë memorie"? Gjejini dhe ndaloni.
Ja një shembull konkret. Pavarësisht testimeve të kujdesshme dhe shumë-niveli, një klient përballi një gabim të padëshiruar dhe të papritur në një rast shumë të pazakontë dhe me të dhëna hyrëse të dëmtuara, filloi alarmi dhe procesi për ta rregulluar shpejt atë:
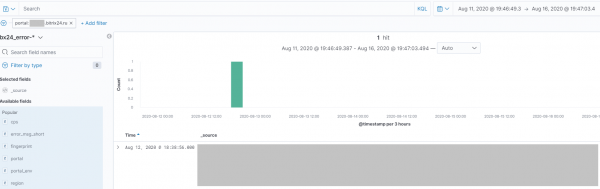
Për më tepër, Kibana mundëson organizimin e njoftimeve për ngjarje të caktuara dhe brenda një kohe të shkurtër, shumica e punonjësve nga departamente të ndryshme — nga mbështetje teknike dhe zhvillimi deri në QA — filluan të përdorin këtë mjet.
Aktiviteti i çdo dege brenda kompanisë u bë lehtë i ndjekshëm dhe i matshëm — në vend të analizës manuale të log-eve në serverë, mjafton që njëherë të konfiguroni parsing-un e log-eve dhe dërgimin e tyre në klasterin elastic, për të shijuar, për shembull, numrin e katërmijësht të koteleve dy-koka, të printuara në 3-d printer për muajin e kaluar hënor.
Analitika e biznesit bazë
Të gjithë dinë se shpesh analitika e biznesit në kompani fillon me përdorimin ekstrem të Excel-it. Por, më e rëndësishmja, është që të mos përfundojë aty. Pushtimi i Google Analytics në re gjithashtu kontribuon në këtë — nisin të bëhesh të shkëlqyer me të.
Në kompaninë tonë, e cila po zhvillohet në mënyrë harmonike, filluan të shfaqen herë pas here "profetë" të punës më intensive me të dhëna më të mëdha. Kërkesat për raporte më thellësisht dhe shumëdimensionale u shfaqën rregullisht dhe me përpjekjet e djemve nga departamente të ndryshme, disa kohë më parë u organizua një zgjidhje e thjeshtë dhe praktike — lidhja ClickHouse dhe PowerBI.
Kjo zgjidhje fleksibile ndihmoi shumë gjatë një periudhe të gjatë, por gradualisht filloi të kuptohej se ClickHouse — nuk është elastik dhe nuk mund të keqinterpretohet.
Është e rëndësishme të kuptoni mirë se ClickHouse, si Druid, si Vertica, si Amazon RedShift (i cili bazohet në Postgres), janë motorë analitikë, të optimizuar për një analizë mjaft të thjeshtë (shuma, agregime, minimum-maksimum për kolonë dhe ndonjëherë mund të bëhen bashkime), pasi janë organizuar për ruajtjen efikase të kolonave të tabelave relacionale, në ndryshim nga MySQL dhe databazat e tjera (me orientim rresht).
Në thelb, ClickHouse është thjesht një «baza» të dhënash më e madhe, me një inserim të pikëzuar jo shumë të përshtatshëm (është menduar kështu, gjithçka është në rregull), por me një analizë të këndshme dhe një grup interesant të funksioneve të fuqishme për punën me të dhënat. Po ashtu, mund të krijoni një klaster — por, e kuptoni, të godasësh me hammer një gozhdë me mikroskop nuk është krejtësisht e duhur dhe ne filluam të kërkojmë zgjidhje të tjera.
Kërkesa për Python dhe analitikët
Në kompaninë tonë ka shumë zhvillues, të cilët shkruajnë kod pothuajse çdo ditë për 10-20 vjet në PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash. Po ashtu, ka shumë administatorë të sistemeve me eksperiencë, që kanë përjetuar jo një, por disa katastrofa të pabesueshme, që nuk përfshihen në ligjet e statistikës (për shembull, kur shkatërrohen shumica e disqeve në RAID-10 nga një goditje e fortë vetëtimash). Në këto kushte, për një kohë të gjatë ka qenë e paqartë se çfarë është një «analist në Python». Python është si PHP, vetëm emri është pak më i gjatë dhe ndotësit e substancave që ndryshojnë mendjen në kodin burimor të interpretorit janë pak më të pakët. Megjithatë, me krijimin e raporteve gjithnjë e më analitike, zhvilluesit e eksperiencës kanë filluar të kuptojnë rëndësinë e specializimit të ngushtë në mjetet si numpy, pandas, matplotlib, seaborn.
Roli vendimtar, me siguri, ka qenë një ndihmë e papritur nga fjetja e punonjësve nga kombinimi i fjalëve «regresioni logjistik» dhe demonstrimi i ndërtimit të raporteve efikase mbi të dhëna voluminoze me anë të pyspark.
Apache Spark, paradigmat e tij funksionale, mbi të cilat bazohet shumë mirë algebra relacional, pati një impakt të tillë te zhvilluesit që ishin mësuar me MySQL, saqë nevoja për të forcuar radhët me analistë të njohur u bë e qartë si dita.
Tentativat e mëtejshme të Apache Spark/Hadoop për të fluturuar dhe se çfarë nuk shkoi krejtësisht sipas skenarit
Megjithatë, së shpejti u bë e qartë se me Spark, duket se diçka nuk ishte sistematikisht në rregull ose thjesht duhen larë më mirë duar. Nëse stoku Hadoop/MapReduce/Lucene ishte zhvilluar nga programues të mjaftueshëm të përvojshëm, çka është evidente nëse shikon me vëmendje kodin burimor në Java ose idetë e Doug Cutting në Lucene, atëherë Spark, papritur, është shkruar në një gjuhë të diskutueshme nga pikëpamja e praktikës dhe tani nuk po zhvillohet, gjuha ekzotike Scala. Përdorimi i rregullt të llogaritjeve në përbërjen Spark për shkak të punësjo të paqartë dhe jo shumë transparente me ndarjen e memories për operacionet e reduktimit (vijnë shumë çelësa menjëherë) — krijoi rreth tij një aurë të diçkaje që ka hapësirë për të u rritur. Shtesë, situata u përkeqësua nga numri i madh i porteve të çuditshme të hapura, skedarëve temporarë që rriteshin në vende të paqartë dhe varësive jar — që shkaktonte ndjenja të njohura tek administruesit e sistemit: një urrejtje e fortë (ndoshta do të duhej të lahnin duar me sapun).
Ne, për pasojë, kemi "kanosur" disa projekte analitike të brendshme që përdorin aktivisht Apache Spark (përfshirë Spark Streaming, Spark SQL) dhe ekosistemin Hadoop (dhe të tjera). Megjithëse me kalimin e kohës mësuam ta përgatisim dhe monitorojmë mjaft mirë dhe "ato" praktikisht ndaluan të bien papritur për shkak të ndryshimit të natyrës së të dhënave dhe disbalancës së heshimit të barabartë RDD, dëshira për të marrë diçka të gatshme, të përditësuar dhe të administruar paktë diku në cloud u intensifikua gjithnjë e më shumë. Pikërisht në këtë kohë, provuam të përdornim një ndërtim cloud të gatshëm nga Amazon Web Services — dhe, më vonë, përpiqeshim të zgjidhim detyrat në të. EMR është një Apache Spark i përgatitur nga Amazon me softuer shtesë nga ekosistemi, diçka si ndërtimet Cloudera/Hortonworks.
"Ruajtja e skedarëve" për analitikë — një nevojë e ngutshme
Eksperienca e "gatimit" të Hadoop/Spark me djegie të ndryshme trupore nuk kaloi kot. Nevoja për të krijuar një depo të vetme të lirë dhe të besueshme u bë gjithnjë e më e qartë, e cila do të ishte e qëndrueshme ndaj depozitave të pajisjeve dhe ku mund të ruajmë skedarë në formate të ndryshme nga sisteme të ndryshme dhe të bëjmë për këto të dhëna zgjedhje efektive dhe që realizohen në kohë të arsyeshme për raporte.
Gjithashtu, doja që azhurnimi i softuerit të kësaj platforme të mos kthehej në një makth të natës së Vitit të Ri me leximin e shënimeve 20-faqëshe të Java dhe analizimin e kilometrave të detajeve të logëve të punës së klasterit me ndihmën e Spark History Server dhe një lupë me ndriçim. Doja të kishim një mjet të thjeshtë dhe transparent, që nuk kërkon një zhytje të rregullt nën kapak, nëse kërkuesi ndalon së ekzekutuari një kërkesë standarde MapReduce kur ndodhin humbjet e memories së punonjësit të të dhënave të reduktimit për shkak të një algoritmi jo shumë të përshtatshëm të ndarjes së të dhënave origjinale.
Amazon S3 — një kandidat për DataLake?
Eksperienca me Hadoop/MapReduce më mësoi se nevojitet një sistem i qëndrueshëm skedarësh që është gjithashtu i shkallëzueshëm dhe sipër tij punëtorë të shkallëzueshëm, "duke ardhur" afër të dhënave, në mënyrë që të mos lëvizin të dhënat përmes rrjetit. Punonjësit duhet të jenë në gjendje të lexojnë të dhënat në formate të ndryshme, por, sa më mirë, të mos lexojnë informacione të panevojshme, dhe që të mund të ruajnë të dhënat paraprakisht në formate të përshtatshme për punonjësit.
Njëherë tjetër — ideja kryesore. Nuk kam dëshirë të "ngarkoj" të dhëna të mëdha në një motor analitik klasterik të vetëm, i cili do të dëshpërohet dhe do të duhet ta ndajmë në mënyrë të pakëndshme. Dua të ruaj skedarë, thjesht skedarë, në një format të kuptueshëm dhe të ekzekutimin e kërkesave efektive analitike në mënyrë të ndryshme, por edhe të kuptueshme. Dhe numri i skedarëve në formate të ndryshme do të jetë gjithnjë e më i madh. Dhe do të ishte më mirë të ndahej jo motori, por të dhënat origjinale. Na nevojitet një DataLake i zgjerueshëm dhe universale, vendosëm ne...
Çfarë nëse ruajmë skedarët në një depo të njohur dhe të shkallëzuar të njohur të Amazon S3, pa u marrë me përgatitjen e vet të pllakave nga Hadoop?
E qartë, të dhënat personale “nuk lejohet”, por të dhënat e tjera nëse i nxjerrim atje dhe i “përpunojmë me efektivitet”?
Ekosistemi analitik të dhënave të mëdha të Amazon Web Services — me fjalë shumë të thjeshta
Duke u bazuar në përvojën tonë me AWS, aty përdoret prej kohësh dhe me intensitet Apache Hadoop/MapReduce nën forma të ndryshme, për shembull në shërbimin DataPipeline (i ziliqem kolegëve, ata e dinë ta përgatisin siç duhet). Këtu kemi vendosur backup nga shërbime të ndryshme nga tabelat DynamoDB:
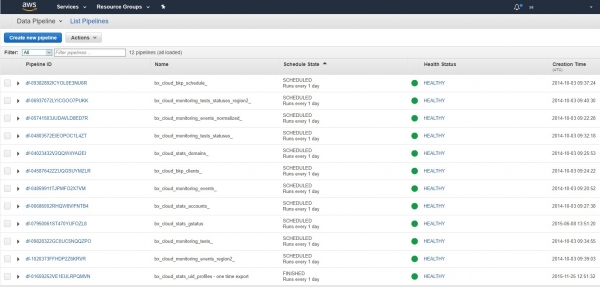
Dhe ato janë duke u ekzekutuar rregullisht në klasteret e integruara Hadoop/MapReduce si orët për disa vite. "Përgatite dhe harroje":
Po ashtu, mund të angazhoheni në datasciencë në mënyrë efektive duke ngritur notebook-ët Jupiter për analistët në cloud dhe duke përdorur shërbimin AWS SageMaker për trajnim dhe vendosjen e modeleve AI në përdorim. Ja si duket kjo në ne:
Dhe, po, mund të ngresh për vete ose për analistët një notebook në cloud dhe ta lidhësh atë me klasterin Hadoop/Spark, të bësh llogaritje dhe pastaj 'të përfundosh' gjithçka:
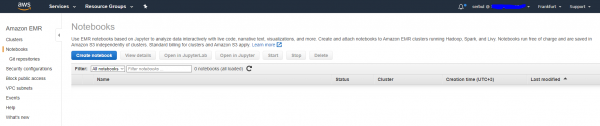
Vërtetë e përshtatshme për projekte analitike të veçanta dhe për disa prej tyre kemi përdorur me sukses shërbimin EMR për kalkulime dhe analitika të mëdha. Por çfarë do të thotë për një zgjidhje sistematike për DataLake, do të funksionojë? Në atë moment ishim në prag të shpresës dhe dëshpërimit dhe vazhduam kërkimin.
AWS Glue — një Apache Spark i paketuar me kujdes 'në steroide'
Doli se AWS ka një version të tijin të stack-ut 'Hive/Pig/Spark'. Rolii i Hive, dmth, katalogu i skedarëve dhe tipeve të tyre në DataLake, ekzekutohet nga shërbimi 'Data catalog', i cili nuk e fsheh kompatibilitetin e tij me formatin Apache Hive. Në këtë shërbim duhen shtuar informacione se ku ndodhen skedarët tuaj dhe në çfarë formati janë. Të dhënat mund të jenë jo vetëm në s3, por edhe në një bazë të dhënash, por për këtë nuk do flasim në këtë postim. Ja si është organizuar katalogu i dhënave DataLake për ne:
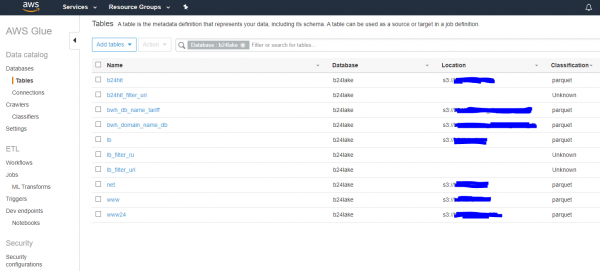
Skedarët janë regjistruar, shkëlqyeshëm. Nëse skedarët janë përditësuar — aktivizojmë manualisht ose sipas një skeduli crawlers, të cilët do të përditësojnë informacionin mbi ta nga liqeni dhe do ta ruajnë. Më pas, të dhënat nga liqeni mund të përpunohen dhe rezultatet diku të skadohen. Në rastin më të thjeshtë — skadojmë gjithashtu në s3. Përpunimi i të dhënave mund të bëhet kudo, por ofrohet që të konfigurohet procesi i përpunimit në klasterin Apache Spark duke përdorur funksionalitetet e avancuara përmes API AWS Glue. Në thelb, mund të marrim kodin e vjetër të njohur në python duke përdorur bibliotekën pyspark dhe të konfigurojmë ekzekutimin e tij në N nodet e klasterit të ndonjë fuqie me monitorim, pa gërmim në thellësitë e Hadoop dhe transportim të kontejnerëve docker-mokers dhe eliminimi i konflikteve të varësisë.
Edhe një herë — një ide e thjeshtë. Nuk është e nevojshme të konfigurohet Apache Spark, duhet vetëm të shkruhet kodi në python për pyspark, ta testosh lokal në desktop dhe pastaj ta aktivizosh në një klaster të madh në cloud, duke treguar ku ndodhen të dhënat burimore dhe ku duhet të vendoset rezultati. Ndonjëherë kjo është e nevojshme dhe e dobishme dhe ja si është konfiguruar për ne:
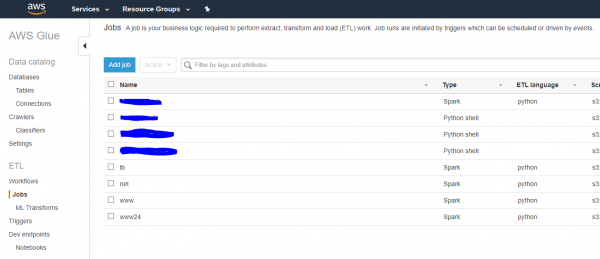
Kështu, nëse kemi nevojë të bëjmë një kalkulim në klasterin Spark mbi të dhënat në s3 — shkruajmë kodin në python/pyspark, e testojmë dhe shkojmë në rrugën e mirë në cloud.
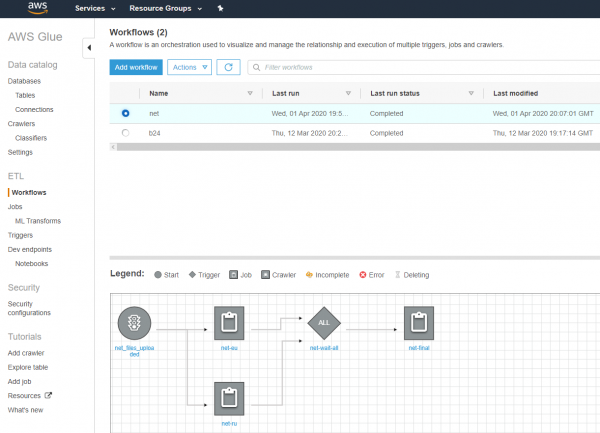
Çfarë ndodhi me orkestrimin? Çfarë bëhet nëse një detyrë dështon dhe humb? Po, propozohet të krijohet një pipeline të bukur në stilin e Apache Pig dhe madje edhe ne e provuam atë, por vendosëm të përdorim orkestrimin tonë të thellë të personalizuar në PHP dhe JavaScript (e kuptoj, ka një disonancë kognitive, por funksionon, për vite me radhë dhe pa gabime).
Formati i skedarëve të ruajtur në liqen — çelësi për performancën
Është shumë, shumë e rëndësishme të kuptojmë edhe dy momente kyçe. Për t'u siguruar që kërkesat për të dhënat e skedarëve në liqen të zbatohen sa më shpejt të jetë e mundur dhe performanca të mos degradohet gjatë shtimit të informacionit të ri, nevojitet:
- Të ruajmë kolonat e skedarëve veçmas (për të mos qenë e nevojshme të lexojmë të gjitha rreshtat për të kuptuar se çfarë ka në kolona). Për këtë, ne morëm formatin parquet me kompresim
- Është shumë e rëndësishme të shardojmë skedarët në dosje si: gjuha, viti, muaji, dita, java. Motorët që kuptojnë këtë lloj shardimi do të shikojnë vetëm në dosjet e nevojshme, pa e përzgjedhur të gjithë informacionin njëlloj.
Shkurtimisht, në këtë mënyrë, ju nxirrni të dhënat origjinale në formën më efikase për motorët analitikë që e dinë si të hyjnë selektivisht në dosjet e sharduara dhe të lexojnë vetëm kolonat e nevojshme nga skedarët. Nuk është nevoja të "derdhni" të dhënat diku (magazina do të shpërthejë) — thjesht vendosini menjëherë në sistemin e skedarëve në formatin e duhur. Natyrisht, këtu duhet të jetë e qartë se ruajtja e një CSV të madh në DataLake, i cili duhet të lexohet rresht për rresht nga klasteri për të nxjerrë kolonat — nuk është shumë e arsyeshme. Mendoni përsëri mbi dy pikat e mësipërme nëse nuk e kuptoni ende pse është e gjitha kjo.
AWS Athena — "djalli" nga kutia
Dhe këtu, duke krijuar liqenin, ne, në një mënyrë, hasëm në Amazon Athena. Papritur u zbulua se duke grumbulluar me kujdes në dosjet e sharduara në formatin e duhur (parquet) skedarët tanë të mëdhenj të logjeve — mund të bëjmë shumë shpejt zgjedhje shumë informuese dhe të ndërtojmë raporte PA, pa klasterin Apache Spark/Glue.
Motori Athena, që punon me të dhënat në s3, bazohet në legjendën — një përfaqësues i familjes MPP (procesimi masiv paralel) të qasjes për përpunimin e të dhënave, duke marrë të dhënat aty ku ndodhen, nga s3 dhe Hadoop te Cassandra dhe skedarët e zakonshëm tekstualë. Thjesht duhet të kërkosh nga Athena të ekzekutojë një kërkesë SQL, dhe pastaj gjithçka "funksionon shpejt dhe vetë". Është e rëndësishme të theksohet se Athena është "e mençur", shkon vetëm në dosjet e nevojshme të ndara dhe lexon vetëm kolonat e nevojshme në kërkesë.
Tarifat për kërkesat në Athena janë gjithashtu interesante. Ne paguajmë për . Pra, jo për numrin e serverëve në klaster çdo minutë, por… për të dhënat që janë realisht skanuar në 100-500 serverë që janë vetëm të nevojshme për të përmbushur kërkesën.
Dhe duke kërkuar vetëm kolonat e nevojshme nga dosjet e duhura të ndara, rezultoi se shërbimi Athena na kushton vetëm disa dhjetëra dollarë në muaj. Well, përshtatshme, thuajse falas, krahasuar me analizën në klasterë!
Ja, si i ndajmë të dhënat tona në s3:
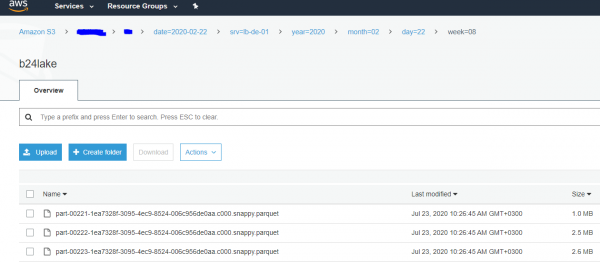
Si pasojë, brenda një kohe të shkurtër, në kompani janë bërë kërkesa aktive në Athena nga departamente të ndryshme, nga siguria informative te analiza, dhe ato marrin shpejt, brenda sekondash, përgjigje të dobishme nga "të dhënat e mëdha" për periudha mjaft të gjera: muaj, gjysmë viti etj.
Por ne shkuam më tej dhe filluam të kërkojmë përgjigje në cloud : analisti në konsolën e tij të zakonshme shkruan një kërkesë SQL, e cila "me pak para" kërkon të dhënat në s3 në 100-500 serverë dhe kthen përgjigjen zakonisht brenda disa sekondash. E ndihmon. Dhe është shpejt. Akoma nuk e besojmë.
Në përfundim, pas vendimit për të ruajtur të dhënat në s3, në një format efikas kolónar dhe me ndarje të arsyeshme të të dhënave në dosje… ne morëm DataLake dhe një mekanizëm analitik të shpejtë dhe të lirë — falas. Dhe ai u bë shumë popullor në kompani, pasi kupton SQL dhe punon shumë më shpejt, sesa përmes ndjekjeve/njohjeve/konfigurimeve të klasterëve. "E nëse rezultati është i njëjtë, pse të paguani më shumë?"
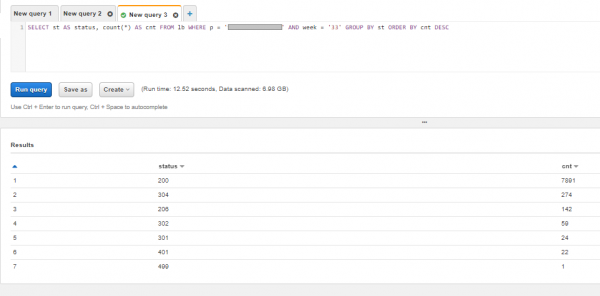
Një kërkesë në Athena duket më pak kështu. Nëse dëshiron, sigurisht, mund të formosh një , por ne do të kufizohemi në një grupim të thjeshtë. Le të shohim se cilat kode përgjigjesh kishte klienti disa javë më parë në log-at e punës së serverit web dhe të sigurohemi që nuk ka gabime:
Përfundimet
Pas duke kaluar nëpër një rrugë që nuk ishte e gjatë, por e dhimbshme, duke vlerësuar vazhdimisht rrezikun dhe nivelin e vështirësisë dhe koston e mbështetjes, gjetëm zgjidhjen për DataLake dhe analizën që na gëzon vazhdimisht me shpejtësinë dhe kostot e zbatimit.
Doli se ndërtimi i një DataLake efektiv, të shpejtë dhe me kosto të ulët për nevojat e një numri të ndryshëm njësish brenda kompanisë - është plotësisht i realizueshëm edhe për zhvilluesit e përvojshëm, të cilët nuk kanë punuar kurrë si arkitektë dhe nuk dinë të vizatojnë katrorë mbi katrorë me shigjeta dhe të njohin 50 terma nga ekosistemi Hadoop.
Në fillim të rrugës, koka më dhembte nga shumica e zvarranikëve të çmendur të software-it të hapur dhe të mbyllur dhe nga ndjenja e përgjegjësisë për brezat e ardhshëm. Thjesht filloni të ndërtoni DataLake-in tuaj me mjete të thjeshta: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3 …, duke mbledhur feedback dhe duke e kuptuar thellë fizikën e proceseve që ndodhin. Çdo gjë që është e komplikuar dhe e paqartë - lini për armiqtë dhe konkurentët.
Nëse nuk dëshironi të shkoni në cloud dhe preferoni të mbështesni, përditësoni dhe aplikoni patches në projekte të hapura, mund të ndërtoni një skemë të ngjashme me tonën lokal, në makina të lira zyre me Hadoop dhe Presto përmbi. E rëndësishme është të mos ndaloni dhe të ecni përpara, të llogaritni, të kërkoni zgjidhje të thjeshta dhe të qarta dhe gjithçka do të dalë në vend! Fat të mirë të gjithëve dhe deri në takimin e ardhshëm!
Burimi: habr.com
