

Përshëndetje, Habr! Gjatë disa muajve të fundit, kemi përjetuar një situatë shumë interesante, dhe do të doja të ndaja historinë tonë të zgjerimit të infrastrukturës. Gjatë kësaj kohe, SberMarket është rritur katërfish në porosi dhe ka lansuar shërbimin në 17 qytete të reja. Rritja eksplozive e kërkesës për dorëzim të produkteve kërkoi nga ne zgjerimin e infrastrukturës. Rreth konkluzioneve më interesante dhe të dobishme lexoni poshtë.
Më quajnë Dima Bobylëv, unë jam drejtor teknik i SberMarket. Duke qenë se ky është posti i parë në blogun tonë, do të them disa fjalë për veten dhe për kompaninë. Në vjeshtën e kaluar, kam marrë pjesë në konkursin e liderëve të rinj të Runet. Për këtë contest unë rreth mënyrës se si ne në SberMarket e shohim kulturën e brendshme dhe qasjen ndaj zhvillimit të shërbimit. Edhe pse nuk arrita të fitoj në konkurs, përkundrazi, kam formuluar për vete parimet themelore të zhvillimit të ekosistemit IT.
Kur menaxhon një ekip, është e rëndësishme të kuptosh dhe të gjesh një balancë mes nevojave të biznesit dhe kërkesave të çdo zhvilluesi të veçantë. Aktualisht, SberMarket po rritet 13 herë nga viti në vit, dhe kjo ndikon në produkt, duke kërkuar rritjen e vazhdueshme të volumit dhe ritmit të zhvillimit. Megjithatë, ne i japim zhvilluesve mjaft kohë për analizën paraprake dhe për një kod të cilësisë së lartë. Qasja e formuar ndihmon jo vetëm në krijimin e një produkti funksional, por gjithashtu në zgjerimin dhe zhvillimin e tij të mëtejshëm. Si rezultat i kësaj rritjeje, SberMarket tashmë është bërë lider ndër shërbimet e dorëzimit të produkteve: ne dorëzojmë rreth 18 mijë porosi çdo ditë, ndonëse në fillim të shkurtit ishin rreth 3500.
Një herë, një klient kërkoi që kurieri i SberMarket të dorëzonte produktet atij në mënyrë pa kontakt — direkt në ballkon.
Por të kaluar te detajet. Gjatë disa muajve të fundit, ne kemi punuar aktivisht në zgjerimin e infrastrukturës së kompanisë sonë. Ky nevojë u justifikua nga faktorë të jashtëm dhe të brendshëm. Në të njëjtën kohë me rritjen e bazës së klientëve, numri i dyqaneve të lidhura u rrit nga 90 në fillim të vitit në më shumë se 200 deri në mes të majit. Sigurisht, ne u përgatitëm, rezervuam infrastrukturën kryesore dhe planifikuam mundësinë e zgjerimit vertikal dhe horizontal të të gjitha makinave virtuale të vendosura në облаkun e Yandex. Megjithatë, praktika tregoi: "Gjithçka që mund të shkojë keq, do të shkojë keq". Dhe sot dua të ndaj situatat më interesante që ndodhen për këto javë. Shpresoj që përvoja jonë të jetë e dobishme për ju.
Slave është në gatishmëri të plotë
Edhe përpara fillimit të pandemisë, u përballëm me një rritje të numrit të kërkesave në serverat tanë backend. Tendenca për të porositur produkte me dorëzim në shtëpi filloi të merrte hov, dhe me futjen e masave të para të vetizolimit për shkak të COVID-19, ngarkesa po rritej dramatikisht para syve tanë gjatë gjithë ditës. U shfaq nevoja për të shkarkuar me urgjencë serverat master të bazës kryesore të të dhënave dhe për të transferuar disa kërkesa për lexim në serverat-replikë (slave).
Ne u përgatitëm paraprakisht për këtë hap, dhe për këtë manovër tashmë ishin aktivizuar 2 servera slave. Ata kryesisht punonin me detyra batch për gjenerimin e feed-eve informative për shkëmbimin e të dhënave me partnerët. Këto procese krijonin një ngarkesë të tepërt dhe ishin krejtësisht të arsyeshme të hiqeshin "jashtë skanave" disa muaj më parë.
Duke qenë se replikimi ndodhte në Slave, ne ndoqëm konceptin që aplikacionet mund të punojnë me to vetëm në mënyrë read only. Plani i Rimëkëmbjes nga Fatkeqësitë parashikonte që në rast katastrofe, ne mund të montonim thjesht Slave në vend të Master dhe të kalonim të gjitha kërkesat për shkrim dhe lexim në Slave. Megjithatë, ne gjithashtu dëshironim të përdornim replikat për nevojat e departamentit të analizave, kështu që serverat nuk u transferuan plotësisht në statusin read only, dhe në çdo host kishte grupin e tij të përdoruesve, dhe disa kishin të drejta shkrimi për të ruajtur rezultatet ndërmjetëse të llogaritjeve.
Der nivel të caktuar ngarkese na mjaftonte një master për të shkruar dhe lexuar gjatë përpunimit të kërkesave http. Në mesin e marsit, pikërisht kur Sbermarket vendosi të kalojë në punë të largët, filluam një rritje të ndjeshme të RPS. Po aq shumë klientë tanë kaluan në vetëizolim ose punë nga shtëpia, gjë që ndikoi në treguesit e ngarkesës.
Performanca e «master» nuk ishte më e mjaftueshme, prandaj filluam të transferonim disa nga kërkesat më të rënda për lexim në replikë. Për të drejtuar transparencën e kërkesave për shkruar në master dhe për lexim në slave, përdorëm gemin ruby «». Krijuam një përdorues të veçantë me postfixin _readonly pa të drejta për shkruar. Por për shkak të një gabimi në konfigurimin e njërit nga hostet, disa kërkesa për shkruar u dërguan në serverin slave me emrin e përdoruesit që kishte të drejtat përkatëse.
Problemi nuk doli në pah menjëherë, sepse ngarkesa e rritur shkaktoi një vonesë tek slavet. Inkonistencat e të dhënave u zbuluan në mëngjes, kur pas importeve të natës, slavet nuk e «arritën» masterin. Ne e arsyetuam këtë me ngarkesën e lartë në vetë shërbimin dhe importin e lidhur me hapjen e dyqaneve të reja. Por ofrimi i të dhënave me një vonesë disa orëshe ishte e papranueshme, dhe ne kaluam proceset në slave-në e dytë analitike, sepse ai kishte mëoshumë burime dhe nuk ishte ngarkuar me kërkesa leximi (çfarë e shpjeguam për veten tonë si mungesë të vonesës në replikim).
Kur arritëm të zgjidhnim arsyet e «shkëputjes» së slave-it kryesor, slave analitik tashmë kishte dalë jashtë funksioni për të njëjtën arsye. Pavarësisht nga pranimi i dy serverëve shtesë, në të cilët planifikuam të transferonim ngarkesën në rast të dështimit të masterit, për shkak të një gabimi të padëshiruar rezultoi se në momentet kritike nuk kishte asnjë.
Por pasi bëmë jo vetëm dump të DB (restorimi në atë moment zgjaste rreth 5 orë), por gjithashtu snapshot të serverit master, arritëm të nisim replikën brenda 2 orëve. Megjithatë, pas kësaj na priste kalimi i logut të replikimit për një periudhë të gjatë (pasi processi zhvillohet në modin njëthëmbësh, por kjo është një histori tjetër krejtësisht).
Përfundimi: Pas një incident të tillë, u bë e qartë se duhej hequr dorë nga praktika e kufizimit të regjistrimit për përdoruesit dhe të shpallej në mënyrë readonly e gjithë serveri. Me një qasje të tillë, mund të mos dyshohet se replikat do të ishin të disponueshme në një moment kritik.
Optimizimi edhe i një kërkese të rëndë mund të "kthejë në jetë" DB-në.
Megjithëse ne vazhdimisht përditësojmë katalogun në sit, kërkesat që ne i dërgonim në serverët Slave toleronin një vonesë të vogël nga Master. Koha për të zbuluar dhe eliminuar problemin e "slave-ve që papritmas dolën nga gara" ishte më e gjatë se "bariera psiko-kologjike" (në atë kohë mund të kishte ndodhur një përditësim çmimesh dhe klientët do të shihnin të dhëna të skaduara), dhe ne u detyruam të kalonim të gjitha kërkesat në serverin kryesor të DB-së. Si rezultat, siti punoi ngadalë... por së paku funksionoi. Dhe derisa Slave po rikuperohej, nuk na mbetej asgjë tjetër përveç optimizimit.
Ndërsa serverët Slave po rikuperoheshin, minutat kalonin ngadalë, Master mbetej i ngarkuar, dhe ne hodhëm të gjitha forcat në optimizimin e detyrave aktive sipas "Rregullit të Paretos": zgjodhëm kërkesat TOP që jepnin pjesën më të madhe të ngarkesës dhe filluam tuning. Kjo bëhej në mënyrë të drejtpërdrejtë.
Një efekt interesant ishte se MySQL, e mbushur deri në pikën kryesore, përgjigjej edhe ndaj përmirësimit të vogël të proceseve. Optimizimi i disa kërkesave që jepnin vetëm 5% të ngarkesës totale tregoi tashmë një ulje të dukshme të CPU-së. Si rezultat, arritëm të siguronim një rezervë të pranueshme burimesh për të punuar Master me bazën e të dhënave dhe të merrnim kohën e nevojshme për rikuperimin e replikave.
Përfundimi: Edhe një optimizim i vogël lejon "të mbijetosh" gjatë ngarkesës për disa orë. Na mjaftoi kjo kohë për rikuperimin e serverëve me replikat. Për rrethanat teknike të optimizimit të kërkesave, do ta diskutojmë në një nga postimet e ardhshme. Prandaj, abonohuni në blogun tonë nëse kjo mund të jetë e dobishme për ju.
Organizoni monitorimin e funksionimit të shërbimeve partnere.
Ne merremi me përpunimin e porosive nga klientët, dhe për këtë arsye shërbimet tona vazhdimisht ndërveprojnë me API e jashtme — këto janë porta për dërgimin e SMS-ve, platformat e pagesave, sistemet e routing-ut, geokoduesi, shërbimi i FNSH-së dhe shumë sisteme të tjera. Dhe kur ngarkesa filloi të rritej shpejt, filluam të hasim kufizimet e API-ve të shërbimeve partnere, për të cilat nuk kishim menduar më parë.
Një tejkalim i papritur i kuotave të shërbimeve partnere mund të çojë në ndjekjen e rënies së shërbimeve tuaja. Shumë API bllokojnë klientët që tejkalojnë kufijtë, dhe në disa raste, një numër i madh kërkesash mund të ngarkojë prodhimin e partnerit.
Për shembull, në momentin e rritjes së numrit të dërgesave, shërbimet ndihmëse nuk arrinin të përballonin detyrat e tyre për shpërndarje dhe përcaktim rrugësh. Si rezultat, ndodhte që porositë ishin bërë, por shërbimi që krijonte rrugën nuk funksiononte. Duhet të them se logjistët tanë bënë atë që dukej pothuajse e pamundur në këto kushte, dhe ndërveprimi i qartë i ekipit ndihmoi në kompensimin e dështimeve të përkohshme të shërbimeve. Por një volum kaq i madh porosish nuk mund të përballohej vazhdimisht me dorë, dhe pas një kohë do të përballeshim me një ndërprerje të papranueshme mes porosive dhe ekzekutimeve të tyre.
U miratua një sërë masash organizative dhe puna e përbashkët e kolektivit ndihmoi të fitonin disa kohë, derisa ne u dakorduam për kushtet e reja dhe prisnim modernizimin e shërbimeve nga disa partnerë. Ekzistojnë edhe API të tjera që gëzojnë qëndrushmëri të lartë dhe tarifa të larta në rastin e trafikut të madh. Për shembull, në fillim përdorshim një API të njohur për hartat për përcaktimin e adresës së pikës së dërgesës. Por pas përfundimit të muajit, morëm një faturë të madhe prej gati 2 milion rubla. Pas kësaj, vendosëm ta zëvendësonim atë menjëherë. Nuk do të merrem me reklamim, por do të them se shpenzimet tona u ulën ndjeshëm.
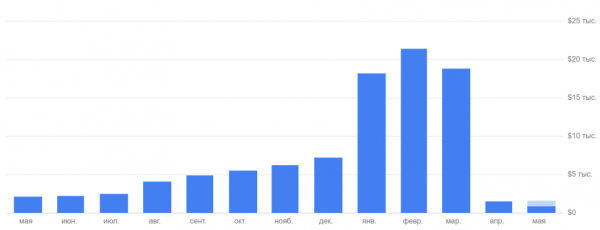
Përfundimi: Duhet patjetër të monitoroni kushtet e punës së të gjitha shërbimeve partnere dhe t'i keni parasysh. Edhe nëse sot duket se ato kanë 'rezerva të mëdha', kjo nuk do të thotë se nesër ato nuk do të bëhen një pengesë për rritjen. Dhe, sigurisht, është më mirë të arrini marrëveshje për kushtet financiare të rritjes së kërkesave për shërbimin paraprakisht.
Ndonjëherë rezulton se '' (c) nuk ndihmon
Jemi mësuar me "ngërçet" në bazën e të dhënave kryesore ose në serverat e aplikacioneve, por gjatë shkallëzimit, problemet mund të shfaqen atje ku nuk i prisni. Për kërkimin me tekst të plotë në sit, ne përdorim motorin Apache Solr. Me rritjen e ngarkesës, ne vështruam rënien e kohës së përgjigjes, dhe ngarkesa e procesorit të serverit arriti tashmë në 100%. Çfarë mund të jetë më e thjeshtë — t'i japim kontejnerit me Solr më shumë burime.
Në vend të rritjes së pritur të performancës, serveri thjesht "vdiq". Ai menjëherë ngarkohej në 100% dhe përgjigjej edhe më ngadalë. Fillimisht kishim 2 bërthama dhe 2 GB RAM. Vendosëm të bëjmë atë që zakonisht ndihmon — i dhamë serverit 8 bërthama dhe 32 GB. Të gjitha u bënë shumë më keq (si dhe pse, do të tregojmë në një postim tjetër).
Në disa ditë, ne kuptuam hollësitë e kësaj çështjeje dhe arritëm performancën optimale me 8 bërthama dhe 32 GB. Kjo konfigurim na lejon edhe sot të vazhdojmë të rrisim ngarkesën, që është shumë e rëndësishme, sepse rritja po ndodh jo vetëm për klientët, por edhe për numrin e dyqaneve të lidhura — brenda 2 muajve, numri i tyre u rrit dyfish.
Përfundimi: Metodat standarde si "shtoni më shumë harduer" nuk funksionojnë gjithmonë. Prandaj, gjatë shkallëzimit të çdo shërbimi, është e rëndësishme të kuptohet mirë si përdor burimet dhe të testohet paraprakisht funksionimi i tij në kushte të reja.
Stateless — çelësi për shkallëzimin horizontal të thjeshtë
Në përgjithësi, ekipi ynë ndjek qasjen e njohur: shërbimet nuk duhet të kenë një gjendje të brendshme (stateless) dhe duhet të jenë të pavarura nga mjedisi ekzekutues. Kjo na lejoi të përballonim rritjen e ngarkesës përmes shkallëzimit horizontal të thjeshtë. Por kishim një shërbim përjashtim — përpunuesin e detyrave të gjata në sfond. Ai merrej me dërgimin e email-eve dhe SMS-ve, përpunimin e ngjarjeve, gjenerimin e feed-eve, importimin e çmimeve dhe stokut, përpunimin e imazheve. Siç ndodhi, ai varej nga ruajtja lokale e skedarëve dhe ishte në një ekzemplar të vetëm.
Kur rritet numri i detyrave në radhën e përpunuesit (gjë që ndodhi natyrshëm me rritjen e numrit të porosive), performanca e host-it, ku ishin vendosur përpunuesi dhe ruajtja e skedarëve, u bë faktori kufizues. Si rezultat, ndaloi përditësimi i asortimentit dhe çmimeve, dërgimi i njoftimeve për përdoruesit dhe shumë funksione të tjera kritike që mbetën ngujuar në radhë. Ekipi i Ops migroi menjëherë ruajtjen e skedarëve në një ruajtje rrjeti të ngjashme me S3, dhe kjo na lejoi të ngrinim disa makina të fuqishme për të shkallëzuar përpunuesin e detyrave të prapambetura.
Përfundimi: Rregulli Stateless duhet të respektohet për të gjitha komponentët pa përjashtim, edhe nëse duket "se nuk do të hasim ndonjë problem këtu". Më mirë të kalosh pak kohë për organizimin e duhur të punës së të gjitha sistemeve, sesa më vonë të shkruash përsëri kodin dhe të riparosh shërbimin që po përjeton ngarkesë.
7 parime për rritje intensive
Megjithëse ekziston disponueshmëria e kapaciteteve shtesë, gjatë procesit të rritjes ne hasëm disa pengesa. Gjatë kësaj periudhe, numri i porosive u rrit më shumë se 4 herë. Tani ne tashmë po dërgojmë më shumë se 17,000 porosi në ditë në 62 qytete dhe planifikojmë të zgjerojmë akoma më shumë gjeografinë - në gjysmën e parë të vitit 2020 pritet të nisë shërbimi në të gjithë Rusinë. Për të përballuar ngarkesën në rritje, duke marrë parasysh pengesat e kaluara, ne kemi nxjerrë për vete 7 parime kryesore të punës në kushte rritje të vazhdueshme:
- Menaxhimi i incidenteve. Ne krijuam një tabelë në Jira, ku çdo incident pasqyrohet në formën e një tiketi. Kjo do të ndihmojë në përparimin dhe realizimin e detyrave të lidhura me incidentin. Sepse në thelb nuk është e frikshme të gabosh - është e frikshme të gabosh dy herë për të njëjtin arsyesh. Për rastet, kur incidentet përsëriten para se të mund të rregullohet shkaku, duhet të jetë gati një udhëzues veprimi, sepse gjatë ngarkesës së madhe është e rëndësishme të reagosh me shpejtësi.
- Monitorimi kërkohet për të gjithë elementët e infrastrukturës pa përjashtim. Pikërisht falë tij ne ishim në gjendje të parashikonim rritjen e ngarkesës dhe të zgjedhim saktë "ngushticat" për t'u përpriorizuar në zgjidhjen e tyre. Shumë gjasa, në raste ngarkese të lartë, do të prishet ose fillojë të ngadalësohet gjithçka që nuk keni menduar. Prandaj është më mirë të krijoni alerte të reja menjëherë pas ndodhisë së incidenteve të para, për të monitoruar dhe parandaluar ato.
- Alerte të duhura janë të domosdoshme kur ngarkohet ndjeshëm sistemi. Së pari, ato duhet të njoftojnë saktësisht se çfarë është prishur. Së dyti, nuk duhet të ketë shumë alerte, sepse mbizotërimi i alerteve jo kritike çon në injorimin e të gjitha njoftimeve në përgjithësi.
- Aplikacionet duhet të jenë pa shtet. Ne u siguruam që për këtë rregull nuk duhet të ketë përjashtime. Duhet të ekzistojë një pavarësi e plotë nga mjedisi i ekzekutimit. Për këtë, ju mund të ruani të dhëna të ndara në DB ose, për shembull, direkt në S3. E akoma më mirë të ndiqni rregullat. Gjatë rritjes së papritur në kohë, optimizimi i kodit nuk është mundësi, dhe do të duhet të përballeni me ngarkesën me anë të rritjes direkte të burimeve kompjuterike dhe shkallëzimit horizontal.
- Kota dhe performanca e shërbimeve të jashtme. Në rastin e rritjes së shpejtë, problemi mund të ndodhi jo vetëm në infrastrukturën tuaj, por edhe në shërbimin e jashtëm. E më e keqe është kur kjo ndodh jo për shkak të një defekti, por për shkak të arritjes së kuotave ose limiteve. Prandaj, shërbimet e jashtme duhet të shkallëzohen po aq mirë sa dhe ju.
- Ndarja e proceseve dhe radhëve. Kjo ndihmon shumë kur ndonjë nga portat has një bllokim. Nuk do të përballeshim me vonesa në transmetimin e të dhënave nëse radhët e mbushura për dërgimin e SMS-ve nuk do të pengonin shkëmbimin e njoftimeve midis sistemeve informative. Po ashtu, do të ishte më e lehtë të rriteshin numri i punëtorëve nëse ata do të punonin veçmas.
- Realitetet financiare. Kur ndodhet një rritje eksplozive e fluksit të të dhënave, nuk ka kohë për të menduar për tarifa dhe abonime. Por ato duhet të mbahen mend, sidomos nëse jeni një kompani e vogël. Një faturë e madhe mund të lëshohet nga çdo pronar API, si dhe nga ofruesi juaj i hostimit. Pra, është e rëndësishme të lexoni kontratat me kujdes.
Përfundim
Nuk kishte humbje, por e kaluam këtë fazë, dhe sot përpiqemi të respektojmë të gjitha parimet e zbuluara, me çdo makinë që ka mundësinë për rritje të lehtë të kapacitetit deri në 4 herë, për t’u përballur me ndonjë papërgatitje.
Në postimet e ardhshme do të ndajmë përvojën tonë në hetimin e rënies së performancës në Apache Solr, gjithashtu do të flasim për optimizimin e pyetjeve dhe si bashkëpunimi me FNS ndihmon kompaninë të kursjë para. Abonohuni në blogun tonë që të mos humbisni asgjë dhe na tregoni në komentet nëse keni përjetuar ndonjëherë disa nga këto çështje gjatë rritjes së trafikut.
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
A keni përjetuar ngadalësim/rënien e shërbimeve në rast të rritjes drastike të ngarkesës për shkak të:
55,6%Pamundësisë për të shtuar burime llogaritëse në mënyrë të shpejtë10
16,7%Kufijve të infrastrukturës së ofruesit të hosting3
33,3%Kufijve të API-ve të treta6
27,8%Shkeljeve të parimeve stateless të aplikacioneve tuaja5
88,9%Optimizimit të kodit të shërbimeve tuaja16
18 përdorues votuan. 6 përdorues u abstenuan.
Burimi: habr.com
