

Sot një kërkesë e lartë për disponueshmëri të shërbimeve gjithmonë dhe kudo, jo vetëm në projektet e mëdha dhe të shtrenjta. Façat e paqëndrueshme me mesazhin "Na falni, po kryhet mirëmbajtje teknike" ende hasen, por zakonisht shkaktojnë vetëm një buzëqeshje indiferente. Le të shtojmë jetën në re, ku për të nisur një server shtesë mjafton një thirrje në API, pa pasur nevojë të mendojmë për shfrytëzimin "e hekurudhës". Dhe nuk mbetet asnjë justifikim përse një sistem kritik nuk ishte ndërtuar me besueshmëri duke përdorur teknologjitë e klasterit dhe ruajtjen rezervë.
Ne do t'ju tregojmë se cilat zgjidhje kemi shqyrtuar për të siguruar besueshmërinë e bazave të të dhënave në shërbimet tona dhe çfarë arritëm. Për më tepër, do të ketë një demo me përfundime të thella.
Legaci në arkitekturën e sigurisë së lartë të disponueshmërisë
Kjo shihet akoma më mirë përmes zhvillimit të sistemeve të ndryshme opensource. Zgjidhjet e vjetra ishin të detyruara të përgjidheshin me teknologjitë e disponueshmërisë së lartë gjatë rritjes së kërkesës. Dhe cilësia e tyre ka qenë e ndryshme. Zgjidhjet e brezit të ri vendosin disponueshmërinë e lartë në themel të arkitekturës së tyre. Për shembull, MongoDB e pozicionon klasterin si opsionin kryesor të përdorimit. Klasteri shkallëzohet horizontalisht, që është një avantazh i fortë konkurrues për këtë DBMS.
Të kthehemi te PostgreSQL. Ky është një nga projektet më të vjetra dhe më popullore opensource, me lëshimin e parë që ndodhi në vitin 1995. Ekipi i projektit për një kohë të gjatë nuk e konsideronte disponueshmërinë e lartë një detyrë që duhej të zgjidhej nga sistemi. Prandaj, teknologjia e replikimit për të krijuar kopje të të dhënave u bë e integruar vetëm në versionin 8.2 në vitin 2006, por ajo ishte me skedarë (log shipping). Në vitin 2010, në versionin 9.0 u prezantua replikimi në rrjedhë, dhe ai është baza për krijimin e klastereve të ndryshme. Kjo, në fakt, i habit njerëzit që njohin PostgreSQL pas Enterprise SQL ose NoSQL moderne — zgjidhja standarde nga komuniteti është thjesht një çift master-replica me replikim sinkron ose asinkron. Në të njëjtën kohë, në stok, kalimi i masterit bëhet manualisht, dhe çështja e kalimit të klientëve gjithashtu sugjerohet të zgjidhet vetë.
Si vendosëm të krijojmë një PostgreSQL të besueshëm dhe çfarë zgjidhëm për këtë
Megjithatë, PostgreSQL nuk do të ishte kaq i njohur nëse nuk do të ekzistonin një numër shumë të madh projektesh dhe mjetesh që ndihmojnë në ndërtimin e një zgjidhjeje që nuk kërkon vëmendje të vazhdueshme. Në re (MCS) që nga fillimi i DBaaS, ishin në dispozicion serverë të vetëm PostgreSQL dhe çift master-replikë me replikim asinkron.
Natyrisht, ne donim të thjeshtonim jetën e gjithkujt dhe të ofronim një instalim të tillë PostgreSQL që mund të shërbente si baza për shërbime me disponueshmëri të lartë, për të cilin nuk do të duhej të vigjilonte vazhdimisht e të zgjohej natën për të bërë kalimin. Në këtë segment ka si zgjidhje të vjetra të provuara, ashtu edhe një brez të ri mjetesh që përdorin arritjet më të fundit.
Sot, problemi i disponueshmërisë së lartë nuk është rezervimi (kjo është e natyrshme), por konsensusi — algoritmi për zgjedhjen e liderit (Leader election). Shpesh aksidentet e mëdha ndodhin jo për shkak të mungesës së serverëve, por për probleme me konsensusin: një lider i ri nuk është zgjedhur, dalin dy liderë në dyqanet e ndryshme etj. Një shembull — aksidenti në klasterin MySQL të Github — ata shkruan .
Baza matematikore në këtë çështje është shumë serioze. Nga njëra anë, ka , e cila vendos kufizime teorike mbi mundësitë për të ndërtuar zgjidhje HA, nga ana tjetër — algoritme të provuara matematikisht për përcaktimin e konsensusit, të tilla si dhe . Në këtë bazë ekzistojnë disa DCS (sistemat e konsensusit decentralizuar) mjaft të njohura — Zookeeper, etcd, Consul. Prandaj, nëse sistemi i vendimmarrjes funksionon me ndonjë algoritëm të vetin, të shkruar vetë, duhet t'i qasemi atij me shumë kujdes. Pas analizës së një numri të madh sistemesh ne u ndalëm te Patroni — një sistem opensource, kryesisht i zhvilluar nga kompania Zalando.
Si do ta thoni, ne gjithashtu shqyrtuam zgjidhjet multi-master, që do të thotë grupe që mund të shkallëzohen horizontalisht për të shkruar. Megjithatë, për dy arsye kryesore, vendosëm të mos krijojmë një grup të tillë. Së pari, këto zgjidhje kanë një kompleksitet të lartë dhe, për rrjedhojë, më shumë pika të ndjeshme. Do të ishte e vështirë të bëhet një zgjidhje e qëndrueshme për të gjitha rastet. Së dyti, në këtë rast PostgreSQL nuk mbetet i pastër (nativ), disa funksione do të jenë të paarritshme dhe disa aplikacione mund të hasin në bllokime të fshehta gjatë funksionimit.
Patroni
Pra, si funksionon Patroni? Zhvilluesit nuk e morën përsipër të shpiknin biçikletën dhe sugjeruan të përdorin si bazë një nga zgjidhjet DCS të provuara. Atij i jepet përgjegjësia për të gjitha çështjet me sinkronizimin e konfigurimeve, zgjedhjen e liderit dhe kuorumit. Ne zgjodhëm për këtë etcd.
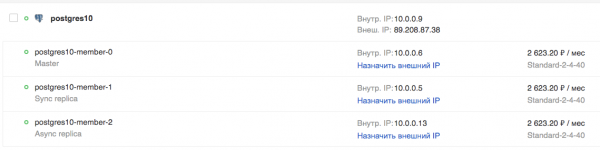
Më pas, Patroni merret me aplikimin e duhur të të gjitha konfigurimeve në PostgreSQL dhe konfigurimin e replikimit, si dhe me ekzekutimin e komandave për kalim dhe dështim (domethënë — kalimi standard dhe jo-standard i masterit). Konkretisht në cloud MCS mund të krijoni një grup nga masteri, një replikë sinkrone dhe një ose më shumë replika asinkrone. Prania e një repliqe sinkrone siguron ruajtjen e të dhënave në të paktën 2 serverë, dhe kjo replikë do të jetë kandidati kryesor për master.
Duke qenë se etcd njihet në të njëjtit serverë, rekomandohet numri i serverave të jetë 3 ose 5, për një vlerë optimale të kuorumit. Ky grup shkallëzohet horizontalisht për lexim (për shkallëzimin e shkrimit kam shkruar më sipër). Megjithatë, duhet të merret parasysh se replikat asinkrone kanë prirjen të mbeten pas, veçanërisht me ngarkesa të larta.
Përdorimi i këtyre replikave për lexim (hot standby) është i justifikuar për detyra raportimi ose analitik dhe shkrin ngarkesën e serverit master.
Nëse dëshironi të krijoni një grup të tillë vetë, do t'ju nevojitet:
- të përgatitni 3 ose më shumë servera, të konfiguroni adresat IP dhe rregullat e firewall-it midis tyre;
- të instaloni paketat për shërbimet etcd, Patroni, PostgreSQL;
- të konfiguroni grupin etcd;
- të konfiguroheni shërbimin patroni për punë me PostgreSQL.
Pra të arritur rezultatin e dëshiruar, është e nevojshme të përgatitet saktësisht një duzinë skedash konfigurimi dhe të mos ketë gabime. Për këtë, është e domosdoshme të përdorni një mjet menaxhimi të konfigurimeve, si Ansible, për shembull. Megjithatë, këtu nuk ka një balancues TCP me disponueshmëri të lartë. Të krijosh një të tillë është një punë e veçantë.
Për ata që kanë nevojë për një klaster të gatshëm, por nuk duan të merret me të gjithë këtë proces, ne përpiqemi t’i lehtësojmë jetën dhe kemi krijuar një klaster të gatshëm në Patroni në re, të cilin mund ta testoni pa pagesë. Përveç vetë klasterit, ne kemi realizuar:
- Balancues TCP; për porta të ndryshme ai gjithmonë tregon aktualin master, replikën sinkrone ose asinkrone, përkatësisht;
- API për ndërrimin e masterit aktiv të Patroni.
Ata mund të lidhen dhe përmes API-së së cloud MCS, si dhe nga konsola në internet.
Demo
Për të testuar kapacitetet e klasterit PostgreSQL në cloud MCS, le të shikojmë se si do të sillet një aplikacion funksional në rast të problemeve me DBMS.
Më poshtë është kodi i aplikacionit, i cili do të logojë ngjarje artificiale dhe do t’i raportojë ato në ekran. Në rast gabimesh, ai do të informojë për to dhe do të vazhdojë punën e tij në një cikël, derisa ta ndalim me kombinimin Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Connection opened to", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Logged a value, overall count: {}".format(record[0]))
    except Exception as error:
        print ("Error while connecting to PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Connection closed")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Caught error:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("exit")
Aplikacioni ka nevojë për PostgreSQL për të funksionuar. Le të krijojmë një klaster në cloud MCS, duke përdorur API. Në terminalin normal, ku variabla OS_TOKEN mbart tokenin për qasje në API (mund të merret me komandën openstack token issue), të shkruajmë komandat:
Krijojmë klasterin:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
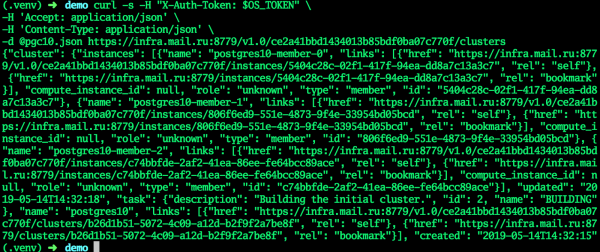
Kur përklasiet klasteri në statusin ACTIVE, të gjitha fushat do të marrin vlera aktuale - klasteri është gati.
Në GUI:
Të bëjmë një provë për t'u lidhur dhe krijuar një tabelë:
psql -h 89.208.87.38 -U admin -d myproddb
Fjalëkalimi për përdoruesin admin:
psql (11.1, server 10.7)
Shkruani "help" për ndihmë.

myproddb=> Krijo Tabelën log (event_id integer NOT NULL);
Krijo Tabelën
myproddb=> Shtoj në log vlerën (1),(2),(3);
Shtoi 0 3
myproddb=> Zgjidh * Nga log;
 event_id
----------
        1
        2
        3
(3 rreshta)

myproddb=>
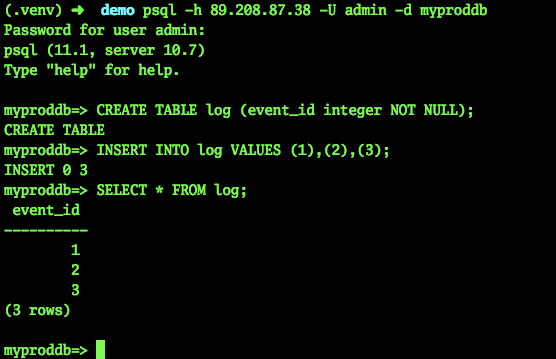
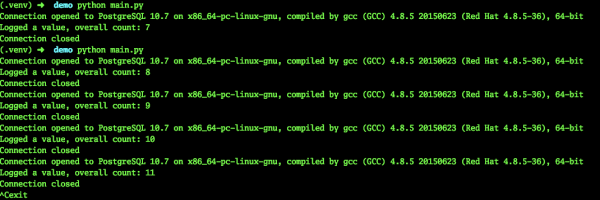
Në aplikacion do të japim konfigurimet aktuale për lidhjen me PostgreSQL. Do të japim adresën e balancuesit TCP, kështu që nuk do të jetë nevoja për kalim manual në adresën e masterit. Le ta aktivizojmë. Siç shihet, ngjarjet janë regjistruar me sukses në bazën e të dhënave.
Kalimi i planifikuar i masterit
Tani do të testojmë funksionimin e aplikacionit tonë gjatë kalimit të planifikuar të masterit:
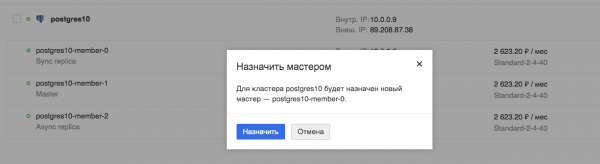
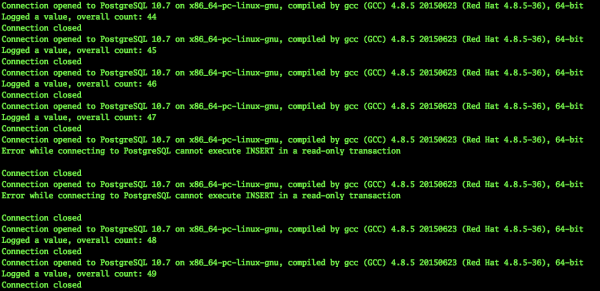
Po e vëzhgojmë aplikacionin. Shikojmë se funksionimi i aplikacionit përndryshe ndalet, por zgjat vetëm disa sekonda, në këtë rast, maksimumi 9.
Rënia e makinës
Tani do të përpiqemi të simulojmë rënien e makinës virtuale, masterit aktual. Mund të kishim thjesht fikur makinën virtuale përmes ndërfaqes Horizon, por kjo do të ishte fikje e zakonshme. Një kalim i tillë do të trajtohet nga të gjitha shërbimet, duke përfshirë Patroni.
Na nevojitet një fikje e paparashikueshme. Prandaj, kërkova nga administratorët tanë që për qëllime testimi të fiknin makinën virtuale - masterin aktual - në një mënyrë të parregullt.
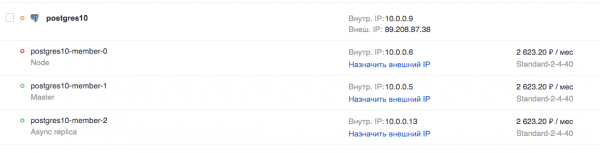
Në të njëjtën kohë, aplikacioni ynë vazhdoi të punojë. Natyrisht, një kalim i tillë i menjëhershëm të masterit nuk mund të kalojë pa u vënë re.
2019-03-29 10:45:56.071234
Koneksioni u hap për PostgreSQL 10.7 në x86_64-pc-linux-gnu, e kompiluar nga gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
E regjistruar një vlerë, numri total: 453
Koneksioni u mbyll
2019-03-29 10:45:59.205463
Koneksioni u hap për PostgreSQL 10.7 në x86_64-pc-linux-gnu, e kompiluar nga gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
E regjistruar një vlerë, numri total: 454

Koneksioni u mbyll
2019-03-29 10:46:02.661440
Gabim gjatë lidhjes me serverin PostgreSQL, lidhja u mbyll papritur
        Kjo ndoshta do të thotë që serveri u përfundua në mënyrë të papritur
        para ose gjatë përpunimit të kërkesës.

Gabimi i kapur:
 variabla lokale 'connection' u referua para caktimit
……………………………………………………….. - këtu ka disa gabime
2019-03-29 10:46:30.930445
Gabim gjatë lidhjes me serverin PostgreSQL, lidhja u mbyll papritur
        Kjo ndoshta do të thotë që serveri u përfundua në mënyrë të papritur
        para ose gjatë përpunimit të kërkesës.

Gabimi i kapur:
 variabla lokale 'connection' u referua para caktimit
2019-03-29 10:46:31.954399
Koneksioni u hap për PostgreSQL 10.7 në x86_64-pc-linux-gnu, e kompiluar nga gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
E regjistruar një vlerë, numri total: 455
Koneksioni u mbyll
2019-03-29 10:46:35.409800
Koneksioni u hap për PostgreSQL 10.7 në x86_64-pc-linux-gnu, e kompiluar nga gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
E regjistruar një vlerë, numri total: 456
Koneksioni u mbyll
^Cexit
Siç duket, aplikacioni arriti të vazhdojë punën e tij për më pak se 30 sekonda. Po, një numër i caktuar përdoruesish mund ta vërejnë problemin. Megjithatë, kjo është një defekt serioz i serverit, që ndodh jo shpesh. Ndërkohë, një person (administrator) ndoshta nuk do të kishte mundur të reagonte kaq shpejt, përveç nëse nuk ishte ulur në konsollë i gatshëm me skenarin e kalimit.
Përfundimi
Mendoj se një cluster i tillë ofron një avantazh të jashtëzakonshëm për administratorët. Në thelb, defektet serioze dhe dështimet e serverëve të DB-së nuk do të jenë të dukshme për aplikacionin dhe, për rrjedhim, për përdoruesin. Nuk do të nevojitet të riparojnë diçka me ngut dhe të kalojnë në konfigurime, serverë, etj. Dhe nëse kjo zgjidhje përdoret si një shërbim i gatshëm në cloud, nuk do të nevojitet të shpenzoni kohë për përgatitjen e saj. Do të keni mundësi të merret me diçka më interesante.
Burimi: habr.com
