

Unë quhem Pavel Parkhomenko, dhe jam zhvillues ML. Në këtë artikull, do të doja të flas për strukturën e shërbimit Yandex.Zen dhe të ndaja përmirësimet teknike që kanë lejuar rritjen e cilësisë së rekomandimeve. Nga ky postim do të mësoni se si, për vetëm disa milisekonda, të gjeni mes miliona dokumenteve ato më të rëndësishme për përdoruesin; si të bëni një shpërndarje të vazhdueshme të një matrice të madhe (e cila përbëhet nga miliona kolona dhe dhjetëra miliona rreshta) që dokumentet e reja të fitojnë vektorin e tyre për qindra minuta; si të ripërdorni shpërndarjen e matrices përdorues-artikulli, për të marrë një përfaqësim të mirë vektorial për videot.
Baza jonë e rekomandimeve përmban miliona dokumenteve në formate të ndryshme: artikuj tekstualë, të krijuar në platformën tonë dhe të marrë nga faqet e jashtme, video, narrative dhe postime të shkurtra. Zhvillimi i një shërbimi të tillë lidhet me një numër të madh sfidash teknike. Ja disa prej tyre:
- Të ndahen detyrat llogaritëse: të gjitha operacionet e rënda të bëhen offline, ndërsa në kohë reale të ekzekutohen vetëm aplikimet e shpejta të modeleve për të përmbushur rendimentin për 100-200 ms.
- Të merren parasysh veprimet e përdoruesit shpejt. Për këtë është e nevojshme që të gjitha ngjarjet të dërgohen menjëherë në rekomandues dhe të ndikojnë në rezultatin e punës së modeleve.
- Të bëhet kanali i tillë që për përdoruesit e rinj ai të përshtatet shpejt me sjelljen e tyre. Njerëzit që sapo hynë në sistem duhet të ndjejnë se feedback-u i tyre ndikon në rekomandimet.
- Të kuptohet shpejt se kujt t'i rekomandohet një artikull i ri.
- Të reagohet shpejt ndaj shfaqjes së vazhdueshme të përmbajtjes së re. Dhjetëra mijëra artikuj publikohen çdo ditë, dhe shumë prej tyre kanë një jetëgjatësi të kufizuar (le të themi, lajme). Kjo është dallimi midis tyre dhe filmeve, muzikës dhe përmbajtjeve të tjera me jetëgjatësi të gjatë dhe të kushtueshme për t'u krijuar.
- Të transferohen njohuritë nga një fushë domain në një tjetër. Nëse në sistemin e rekomandimeve ka modele të trajnuara për artikuj tekstualë dhe ne i shtojmë video, mund të ripërdorim modelet ekzistuese në mënyrë që përmbajtja e tipit të ri të rangoset më mirë.
Do të flas për mënyrën se si i zgjidhëm këto sfida.
Përzgjedhja e kandidatëve
Si le të shkurtojmë shumë dokumente në mijëra herë brenda disa milisekondash, pa e përkeqësuar në mënyrë të konsiderueshme cilësinë e renditjes?
Supozoni se kemi trajnuar shumë modele ML, kemi gjeneruar karakteristika mbi bazën e tyre dhe kemi trajnuar një model tjetër që rendit dokumentet për përdoruesin. Të gjitha do ishin mirë, por nuk mund të llogarisim të gjitha karakteristikat për të gjitha dokumentet në kohë reale, veçanërisht nëse këto dokumente janë miliona dhe rekomandimet duhet të ndërtohen brenda 100-200 ms. Detyra është të zgjedhim nga miliona një nën-grup të caktuar që do të renditet për përdoruesin. Ky etap zakonisht quhet seleksionimi i kandidatëve. Atij i kërkohen disa kushte. Së pari, seleksionimi duhet të ndodhë shumë shpejt, për ta lënë sa më shumë kohë për renditje. Së dyti, duke reduktuar ndjeshëm numrin e dokumenteve për renditje, ne duhet të ruajmë sa më plotësisht dokumentet relevante për përdoruesin.
Principi ynë i seleksionimit të kandidatëve është zhvilluar evolucionarisht, dhe tani kemi arritur në një skemë me disa nivele:
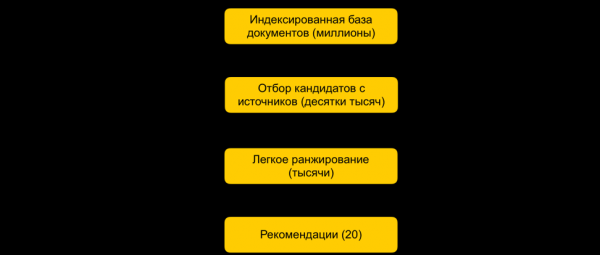
Fillimisht, të gjitha dokumentet ndahen në grupe, dhe nga çdo grup merren dokumentet më të njohura. Grupe mund të jenë faqet, temat, klasteret. Për çdo përdorues, mbi bazën e historisë së tij, zgjidhen grupet më të afërta dhe nga ato merren dokumentet më të mira. Gjithashtu, ne përdorim indeksin kNN për të gjetur dokumentet më të afërta me përdoruesin në kohë reale. Ekzistojnë disa metoda për ndërtimin e indeksit kNN, dhe për ne është funksionuar më së miri (Grafet Hierarkikisht Navigueshëm të Botës të Vogël). Ky është një model hierarkik që lejon gjetjen e N vektorëve më të afërt për përdoruesin nga një bazë prej milion dokumentesh brenda disa milisekondash. Fillimisht, ne indeksojmë tërë bazën tonë të dokumenteve offline. Duke qenë se kërkimi në indeks funksionon mjaft shpejt, nëse kemi disa embedding-u të forta, mund të krijojmë disa indekse (një për çdo embedding) dhe t'i qasemi secilit prej tyre në kohë reale.
Ne na mbeten dhjetëra mijëra dokumentesh për çdo përdorues. Kjo është ende një shumë e madhe për të numëruar të gjitha karakteristikat, prandaj në këtë fazë aplikohet një rangim i lehtë - një model i lehtësuar i rangimit të rëndë me një numër më të vogël karakteristikash. Detyra është të parashikojmë cilat dokumente do të jenë në krye nga modeli i rëndë. Dokumentet me parashikimin më të lartë do të përdoren në modelin e rëndë, domethënë në fazën e fundit të rangimit. Kjo qasje lejon që në disa milisekonda të reduktojmë bazën e dokumenteve të shqyrtuara për përdoruesin nga miliona në mijëra.
Hapi ALS në kohën e ekzekutimit
Si të merret parasysh feedback-u i përdoruesit menjëherë pas klikimit?
Një faktor i rëndësishëm në rekomandime është koha e reagimit ndaj feedback-ut të përdoruesit. Kjo është veçanërisht e rëndësishme për përdoruesit e rinj: kur një person sapo fillon të përdorë sistemin rekomandues, ai merr një rrjedhë të papersonalizuar të dokumenteve me një gamë të ndryshme temash. Siç bëhet kliku i parë, është e nevojshme ta marrim parasysh menjëherë këtë dhe t'i përshtatemi interesave të tij. Nëse llogariten të gjitha faktorët offline, reagimi i shpejtë i sistemit do të bëhet i pamundur për shkak të vonesës. Prandaj, është e nevojshme të procesohen veprimet e përdoruesit në kohë reale. Për këto qëllime, ne përdorim hapin ALS në kohën e ekzekutimit për të ndërtuar një përfaqësim vektorial të përdoruesit.
Le të supozojmë se për të gjitha dokumentet kemi një përfaqësim vektorial. Për shembull, ne mund të ndërtoshim embedding-e offline në bazë të tekstit të artikullit duke përdorur ELMo, BERT ose modele të tjera të mësimit të makinerisë. Si mund të kemi një përfaqësim vektorial të përdoruesve në të njëjtin hapësirë në bazë të ndërveprimeve të tyre në sistem?
Principi i përgjithshëm i formimit dhe shpërbërjes së matricës përdorues-dokumentLe të kemi m përdorues dhe n dokumente. Për disa përdorues dihet relacioni i tyre me disa dokumente. Këtë informacion mund ta paraqesim në formën e një matrice m x n: rreshtat i përkojnë përdoruesve, ndërsa kolonat — dokumenteve. Duke qenë se shumica e dokumenteve nuk janë parë nga ndonjë person, pjesa më e madhe e qelizave të matrices do të mbeten të zbrazëta, ndërsa të tjerat do të jenë të mbushura. Për çdo ngjarje (pëlqim, mospëlqim, klikim) në matricë është parashikuar një vlerë — por le të shqyrtojmë një model të thjeshtëzuar, në të cilin një pëlqim i përgjigjet 1, ndërsa një mospëlqim –1.
Le të ndajmë matricën në dy: P (m x d) dhe Q (d x n), ku d është dimensioni i përfaqësimit vektorial (zakonisht një numër i vogël). Atëherë çdo objekt i përgjigjet një vektori d-dimensional (përdoruesit — rreshti në matricën P, dokumentit — kolona në matricën Q). Këta vektorë do të jenë embedding-et e objekteve përkatëse. Për të parashikuar nëse një dokument do t'i pëlqejë përdoruesit, mjafton të shumohen embedding-et e tyre.
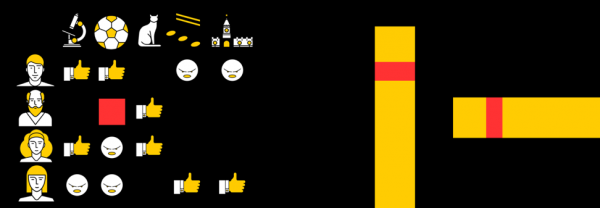
Një nga mënyrat e mundshme për ndarjen e matrices është ALS (Alternating Least Squares). Ne do të optimizojmë funksionin e mëposhtëm të humbjes:

Këtu rui është interaksioni i përdoruesit u me dokumentin i, qi është vektori i dokumentit i, pu është vektori i përdoruesit u.
Atëherë vektori optimal nga pikëpamja e gabimit mesatar të katrorëve të përdoruesit (me vektorët e dokumenteve të fiksuar) gjendet analitikisht duke zgjidhur regresionin përkatës linear.
Kjo quhet “hapi ALS”. Dhe algoritmi ALS përbëhet nga fakti se ne alternativisht fiksojmë një nga matricat (përdoruesit dhe artikujt) dhe azhurnojmë tjetrën, duke gjetur zgjidhjen optimale.
Fatmirësisht, gjetja e përfaqësimit vektorial të përdoruesit është një operacion mjaft i shpejtë, që mund të bëhet në kohën e ekzekutimit, duke përdorur instrukcione vektoriale. Ky trik lejon të merret parasysh menjëherë feedback-u i përdoruesit në renditje. I njëjti embedding mund të përdoret gjithashtu në indeksin kNN për të përmirësuar filtrimin e kandidaturave.
Filtrimi kolaborativ i shpërndarë
Si të bëjmë faktorizimin e matrices inkrmental dhe shpërndarës dhe të gjejmë shpejt përfaqësimin vektorial të artikujve të rinj?
Përmbajtja nuk është burimi i vetëm i sinjaleve për rekomandime. Një burim tjetër i rëndësishëm është informacioni kolaborativ. Shkallëzime të mira në renditje tradicionalisht mund të nxirren nga dekompozimi i matricës përdorues-dokument. Por gjatë përpjekjes për ta bërë këtë dekompozim, ne u përballëm me probleme:
1. Ne kemi miliona dokumente dhe dhjetëra miliona përdorues. Matrica nuk mund të përfitohet e tëra në një makinë, dhe dekompozimi do të zgjasë shumë.
2. Për shumicën e përmbajtjes në sistem, koha e jetës është e shkurtër: dokumentet mbeten relevante vetëm për disa orë. Prandaj, është e nevojshme të ndërtohet sa më shpejt përfaqësimi i tyre vektorial.
3. Nëse bëjmë dekompozim menjëherë pas publikimit të dokumentit, nuk do të kenë pasur kohë të mjaftueshme për ta vlerësuar një numër i mjaftueshëm përdoruesish. Prandaj, përfaqësimi i tij vektorial ka shumë të ngjarë të mos jetë shumë i mirë.
4. Nëse përdoruesi ka dhënë një pëlqim ose një kundërshtim, ne nuk do të mund ta marrim parasysh këtë menjëherë në dekompozim.
Për të zgjidhur problemet e përmendura, ne realizuam një dekompozim të shpërndarë të matricës përdorues-dokument me përditësim incremental të shpeshtë. Si funksionon kjo?
Supozoni se kemi një klaster prej N makinash (N është në qindra) dhe ne duam të bëjmë një dekompozim të shpërndarë të matricës, e cila nuk përfiton në një makinë. Pyetja është — si ta kryejmë këtë dekompozim, që, nga njëra anë, në secilën makinë të ketë mjaft të dhëna dhe, nga ana tjetër, llogaritjet të jenë të pavarura?
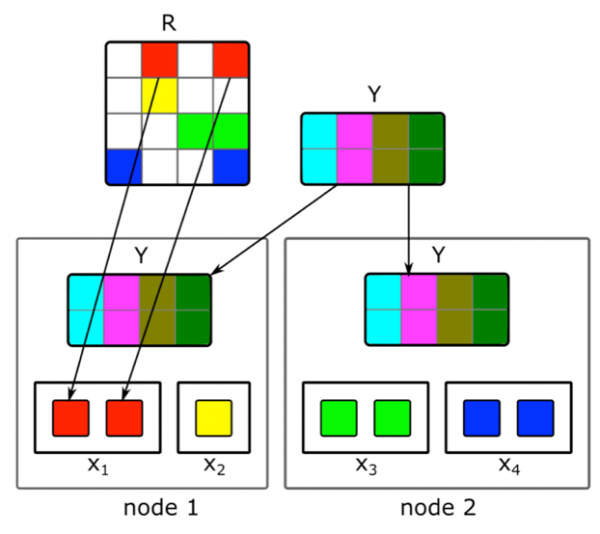
Do të përdorim algoritmin e dekompozimit të përshkruar më sipër, ALS. Le të shohim se si të realizojmë një hap të vetëm të ALS në mënyrë të shpërndarë — hapat e tjerë do të jenë të ngjashëm. Supozoni se kemi fixuar matricën e dokumenteve dhe duam të ndërtojmë matricën e përdoruesve. Për këtë, do ta ndajmë atë në N pjesë sipas rreshtave, secila pjesë do të përmbajë më shumë rreth të njëjtit numër rreshtash. Do t’i dërgojmë çdo makine qelizat e plota përkatëse të rreshtave, si dhe matricën e embedimeve të dokumenteve (në tërësi). Duke qenë se ajo ka një madhësi të vogël, ndërsa matrica përdorues-dokument zakonisht është shumë e hollë, këto të dhëna do të përmbahen në një makinë normale.
Ky kyç mund të përsëritet për disa epoka deri sa të arrihet konvergjenca e modelit, duke ndërruar ndonjëherë matricën e fiksuar. Por edhe atëherë, shpërbërja e matricës mund të zgjasë disa orë. Dhe kjo nuk zgjidh problemin se duhet të marrim shpejt embedimet e dokumenteve të reja dhe të përditësojmë embedimet e atyre që kishin pak informacion gjatë ndërtimit të modelit.
Na ndihmoi implementimi i një përditësimi të shpejtë incremental të modelit. Supozoni se ne kemi një model të trajnuar aktualisht. Që nga trajnimi i tij janë shfaqur artikuj të rinj, me të cilët përdoruesit tanë kanë ndërvepruar, si dhe artikuj që kishin pak ndërveprime gjatë trajnimit. Për të marrë shpejt embedimin e këtyre artikujve, ne përdorim embedimet e përdoruesve të marra gjatë trajnimit të parë të madh të modelit dhe kryejmë një hap ALS për të llogaritur matricën e dokumenteve me matricën e përdoruesve të fiksur. Ky proces na lejon të marrim embedime mjaft shpejt - brenda disa minutash pas publikimit të dokumentit - dhe të përditësojmë shpesh embedimet e dokumenteve të reja.
Për të marrë parasysh menjëherë veprimet e njeriut për rekomandimet, në kohën e ekzekutimit ne nuk përdorim embedimet e përdoruesve të marra në offline. Në vend të kësaj, ne bëjmë një hap ALS dhe marrim vektorin aktual të përdoruesit.
Kalimi në një fushë tjetër domene
Si të përdorim feedback-un e përdoruesit ndaj artikujve tekstorë për të ndërtuar një përfaqësim vektorial të videove?
Fillimisht, ne rekomandonim vetëm artikujt tekstorë, kështu që shumë nga algoritmët tanë ishin të përshtatur për këtë lloj përmbajtjeje. Por me shtimin e përmbajtjes së llojit tjetër, u ballafaquam me nevojën për adaptimin e modeleve. Si e zgjidhëm këtë çështje me shembullin e videove? Një nga mundësitë është të ri-trajnojmë të gjitha modelet nga zero. Por kjo zgjat, për më tepër, disa algoritma kërkojnë një volum të madh të mostrave për ta, i cili nuk është në sasinë e nevojshme për përmbajtjen e këtij lloji në momentet e para të jetës së saj në shërbim.
Ne kemi ndjekur një rrugë tjetër dhe kemi ripërdorur modelet e teksteve për video. Në krijimin e përfaqësimeve vektoriale të videove na ndihmoi po ai truk me ALS. Ne morëm përfaqësimin vektorial të përdoruesve në bazë të artikujve tekstualë dhe bëmë një hap ALS, duke përdorur informacionin mbi shikimet e videove. Kështu ne morëm lehtësisht përfaqësimin vektorial të videove. Dhe në kohën e ekzekutimit ne thjesht llogarisim afërsinë mes vektorit të përdoruesit, i marrë në bazë të artikujve tekstularë, dhe vektorit të videos.
Përfundim
Zhvillimi i bërthamës së sistemit rekomandues në kohë reale është i lidhur me shumë detyra. Duhet të përpunohen shpejt të dhënat dhe të aplikohen metodat e ML për përdorim efektiv të këtyre të dhënave; të ndërtohen sisteme të shpërndara komplekse, të cilat mund të përpunojnë sinjalet e përdoruesve dhe njësitë e reja të përmbajtjes në minimumin e kohës; dhe shumë detyra të tjera.
Në sistemin aktual, struktura e të cilit e kam përshkruar, cilësia e rekomandimeve për përdoruesin rritet së bashku me aktivitetin e tij dhe kohën e qëndrimit në shërbim. Por sigurisht, këtu qëndron edhe vështirësia kryesore: sistemi ka vështirësi të kuptojë menjëherë interesat e një njeriu që ka pasur pak ndërveprime me përmbajtjen. Përmirësimi i rekomandimeve për përdoruesit e rinj është detyra jonë kryesore. Ne do të vazhdojmë të optimizojmë algoritmet, në mënyrë që përmbajtja relevante për personin të arrijë më shpejt në feed-in e tij, ndërsa ajo që nuk është relevante të mos shfaqet.
Burimi: habr.com
