

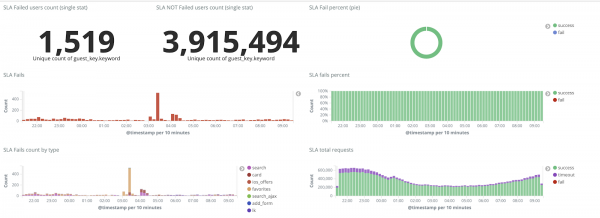
Përshëndetje të gjithëve, unë quhem Aleksandër, punoj në CIAN si inxhinier dhe merrem me administrimin e sistemeve dhe automatizimin e proceseve infrastrukturore. Në komentet e njërit prej artikujve të kaluar, na u kërkua të flasim mbi burimin prej 4 TB log-eve në ditë dhe çfarë bëjmë me to. Po, kemi shumë log-e dhe për procesimin e tyre është krijuar një grup infrastrukture i veçantë që na lejon të zgjidhim problemet në mënyrë operative. Në këtë artikull, do të flas për mënyrën se si e kemi adaptuar atë gjatë një viti për të punuar me fluksin në rritje të të dhënave.
Si e nisëm
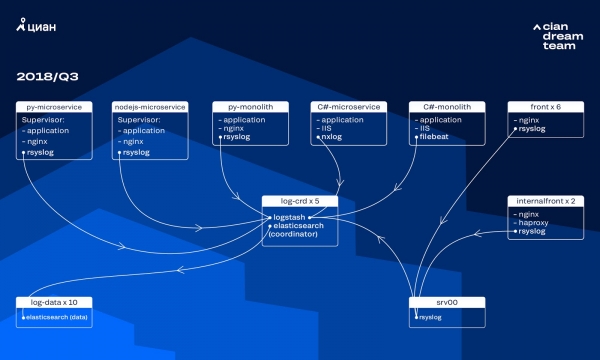
Gjatë disa viteve të fundit, ngarkesa në cian.ru u rrit shumë shpejt, dhe në tremujorin e tretë të vitit 2018, vizitat në burim arritën 11.2 milion përdorues unikë në muaj. Në ato momente kritike, ne humbnim deri në 40% të log-eve, duke e bërë të pamundur të merreshim me incidentet në kohë dhe duke shpenzuar shumë kohë dhe energji për t'i zgjidhur ato. Po ashtu, shpesh nuk mund të gjenim shkakun e problemit dhe ai ripërsëritej pas një kohë. Kjo ishte një ferr prej të cilit na duhej të bënim diçka.
Në atë kohë, për ruajtjen e log-eve përdornim një grup prej 10 nodave të dhënash me ElasticSearch version 5.5.2 me konfigurime standarde të indekseve. E implementuam atë më shumë se një vit më parë si një zgjidhje të njohur dhe të përballueshme: atëherë fluksi i log-eve nuk ishte aq i madh, prandaj nuk kishte kuptim të krijonim konfigurime jo standarde.
Për procesimin e log-eve të ardhura, Logstash funksiononte në ports të ndryshme në pesë koordinatorë ElasticSearch. Një indeks, pavarësisht nga madhësia, ishte përbërë nga pesë shard. Kemi organizuar rotacionin çdo orë dhe ditor, kështu që çdo orë në grupin tonë shfaqeshin rreth 100 shard të rinj. Ndërsa log-eve nuk ishin shumë, grupi përballonte situatën dhe askush nuk e vuri re konfigurimin e tij.
Problemet e rritjes së shpejtë
Vëllimi i log-eve të gjeneruara po rritej shumë shpejt, pasi dy procese sigurisht po ndërfuten. Nga njëra anë, numri i përdoruesve të shërbimit po rritej gjithnjë e më shumë. Nga ana tjetër, filluam të kalojmë aktivisht në një arkitekturë mikroshërbimesh duke ndarë monolitët tanë të vjetër në C# dhe Python. Disa dhjetëra mikroshërbime të reja, që zëvendësuan pjesë të monolitit, gjeneronin ndjeshëm më shumë log-e për grupin infrastrukturore.
Saktësisht shkallëzimi na çoi në një situatë ku klasteri u bë praktikisht i pakontrolueshëm. Kur logat filluan të vijnë me shpejtësi prej 20 mijë mesazhesh në sekundë, rotacioni i shpeshtë i padobishëm e rriti numrin e shardëve në 6 mijë, ndërsa një nyje kishte më shumë se 600 shardë.
Kjo çonte në probleme me ndarjen e memories, ndërsa kur një nyje binte, ndodhte një transferim i menjëhershëm i të gjithë shardëve, duke shumëzuar trafikun dhe ngarkuar nyjet e tjera, gjë që e bënte thuajse të pamundur regjistrimin e të dhënave në klaster. Gjatë kësaj periudhe, ne ishim pa loga. Dhe kur kishte problem me server ne humbisnim 1/10 të klasterit në thelb. Numri i madh i indekseve të vogla e shtonte kompleksitetin.
Pa loga, nuk kuptonim arsyet e incidentit dhe mund të përballeshim herët ose vonë me të njëjtat probleme përsëri, dhe kjo në ideologjinë tonë ekipore ishte e papranueshme, pasi të gjithë mekanizmat tanë të punës ishin të dizajnuar për të mos i përsëritur ndonjëherë të njëjtat probleme. Për këtë na duhej një vëllim i plotë logash dhe dërgimi i tyre praktika në kohë reale, pasi ekipi i inxhinierëve vigilent monitoronte alarmin jo vetëm nga metrikat, por edhe nga logat. Për të kuptuar shkallën e problemit - në atë kohë, vëllimi total i logëve ishte rreth 2 TB në ditë.
Ne vendosëm një detyrë - të eliminojmë plotësisht humbjen e logëve dhe të shkurtomë kohën e dërgimit në klasterin ELK maks 15 minuta gjatë rasteve urgjente (në këtë shifër më vonë mbështeteshim si KPI të brendshëm).
Mekanizmi i ri i rotacionit dhe nyjet hot-warm
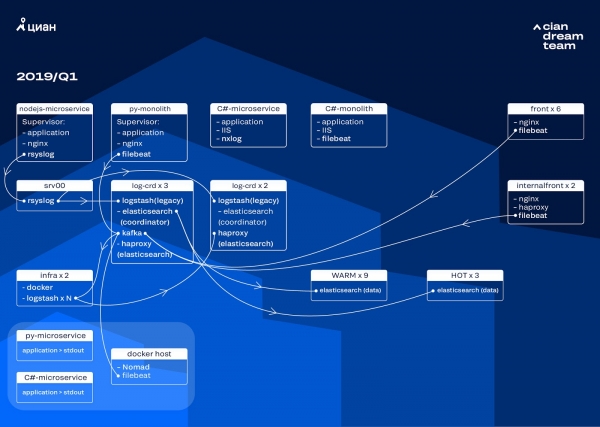
Ne filluam transformimin e klasterit me përditësimin e versionit ElasticSearch nga 5.5.2 në 6.4.3. Klasteri ynë i versionit 5 përsëri ra, dhe vendosëm ta fikim dhe ta përditësojmë plotësisht - nuk kishte loga. Pra, këtë kalim e bëmë për vetëm disa orë.
Transformimi më i madh në këtë fazë ishte implementimi në tri nodet me një koordinатор si një tampon ndërmjetës Apache Kafka. Brokeri i mesazheve na çliroi nga humbja e logëve gjatë problemeve me ElasticSearch. Në të njëjtën kohë, ne shtuam 2 node në kluster dhe kaluam në arkitekturën hot-warm me tri nodet "të nxehta", të vendosura në shtylla të ndryshme në qendër të të dhënave. Atje ne redirektuam logët që nuk duhet të humben kurrë — nginx, si dhe logët e gabimeve të aplikacioneve. Tek nodet e tjera shkonin logët e dorës së dytë — debug, warning, etj., dhe pas 24 orëve, logët "e rëndësishme" nga nodet "të nxehta" kalonin.
Për të mos rritur numrin e indekseve të vogla, ne kaluam nga rotacioni sipas kohës në mekanizmin e rollover. Në forume kishte shumë informacione se rotacioni sipas madhësisë së indeksit ishte shumë i pabesueshëm, prandaj vendosëm të përdorim rotacionin sipas numrit të dokumenteve në indeks. Ne analizuam çdo indeks dhe regjistruam numrin e dokumenteve, pas të cilit duhej të aktivizohej rotacioni. Kështu arritëm madhësinë optimale të shard-it — jo më shumë se 50 GB.
Optimizimi i klasterit
Megjithatë, ne nuk u çlirëm plotësisht nga problemet. Fatkeqësisht, ndiheshin ende indekse të vogla: ato nuk arrinin volumet e caktuara, nuk rotacionoheshin dhe hiqeshin me pastrimin global të indekseve më të vjetra se tri ditë, pasi ne e hoqëm rotacionin sipas datës. Kjo çoi në humbje të të dhënave për shkak se indeksi zhdukej plotësisht nga klasteri, ndërsa përpjekjet për të shkruar në një indeks që nuk ekzistonte prishnin logjikën e curator-it, që ne përdornim për menaxhim. Alias-i për shkruarje transformohej në indeks dhe prishte logjikën e rollover-it, duke shkaktuar rritjen e pakontrolluar të disa indekseve deri në 600 GB.
Për shembull, për konfigurimin e rotacionit:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
Në mungesë të rollover alias, ndodhte një gabim:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  : Unable to perform index rollover with alias "nginx_write".
Zgjidhjen e këtij problemi e lanë për iteracionin e ardhshëm dhe u morëm me një çështje tjetër: kaluam në logjikën pull të punës së Logstash-it, i cili merret me procesimin e logëve hyrëse (ndalimin e informacionit të tepërt dhe pasurimin e tij). E vendosëm atë në docker, të cilin e ekzekutojmë përmes docker-compose, atje po ashtu vendosëm logstash-exporter, i cili jep metrika në Prometheus për monitorimin operacional të fluksit të logëve. Kështu e dhamë vetës mundësinë të ndryshojmë gradualisht numrin e instancave të logstash-it, që ishin përgjegjës për procesimin e çdo lloji logu.
Ndërkohë që po përmirsonim klasterin, vizitueshmëria e cian.ru u rrit në 12.8 milion përdorues unikë në muaj. Si rezultat, ndodhi që transformimet tona paksa nuk arritën pas ndryshimeve në prodhim, dhe u përballëm me faktin se nodet "të ngrohta" nuk e përballonin ngarkesën dhe ngadalësuan të gjithë shpërndarjen e logëve. Të dhënat "të nxehta" i merrnim pa ndërprerje, por për shpërndarjen e të tjerave duhej të intervenonim dhe të bënim rollover manual për të shpërndarë në mënyrë të barabartë indekset.
Megjithatë, shkallëzimi dhe ndryshimi i konfigurimeve të instancave të logstash-it në klaster u komplikuar nga fakti se ishte një docker-compose lokal, dhe të gjitha veprimet kryheshin manualisht (për të shtuar skajet e reja kishte nevojë të kalonim manualisht në të gjitha serverat dhe të bënim docker-compose up -d kudo).
Rredistribuimi i logëve
Në shtator të këtij vitit, ne ende po vazhdonim të shpërbënim monolit, ngarkesa në klaster po rritej, dhe fluksi i logëve po arriti në gati 30 mijë mesazhe në sekondë.
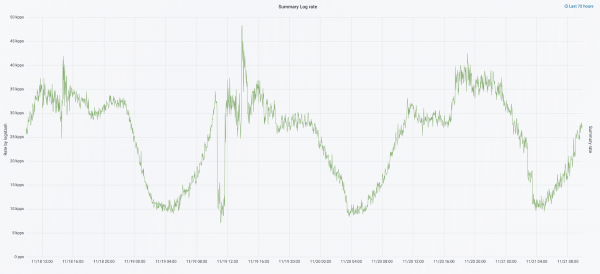
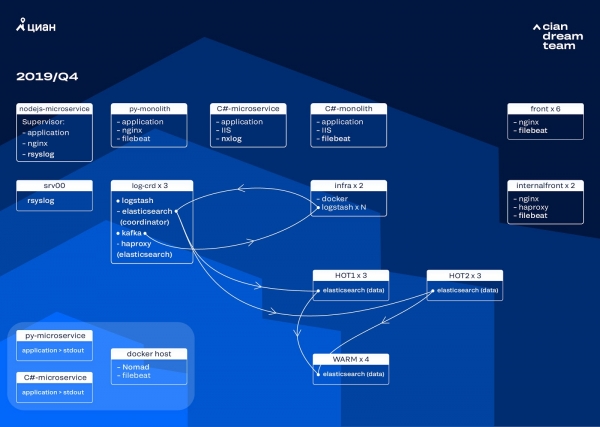
Iteracionin e ardhshëm e filluam me përmirësimin e harduerit. Nga pesë koordinatorë kaluam në tre, zëvendësuam nodet e dhënave dhe fituam në kosto dhe kapacitet ruajtjeje. Për nodet përdorim dy konfiguracione:
- Për nodet "të nxehta": E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 për Hot1 dhe 3 për Hot2).
- Për nodet "të ngrohta": E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
Në këtë iteracion, ne nxorrëm indeksin me logët e aksesit të mikroshërbjeve, i cili zë po aq hapësirë sa logët e nginx-it të përparshëm, në grupin e dytë nga tre nodet "të nxehta". Të dhënat në nodet "të nxehta" tani i ruajmë për 20 orë, dhe më pas i transferojmë në "të ngrohta" me logët e tjera.
Ne zgjidhëm problemin e zhdukjes së indekseve të vogla duke rikonfiguruar rotacionin e tyre. Tani indekset rotacionohen çdo 23 orë, pavarësisht se sa të dhëna ka. Kjo çoi në një rritje të numrit të shardëve (arritëm rreth 800), por nga këndi i performancës së klasterit, kjo është e përballueshme.
Si rezultat, në klaster kemi gjashtë nodet 'të nxehta' dhe vetëm katër 'të ngrohta'. Kjo shkakton një vonesë të vogël në kërkesat për periudha të gjata, por rritja e numrit të nodëve në të ardhmen do ta zgjidhë këtë problem.
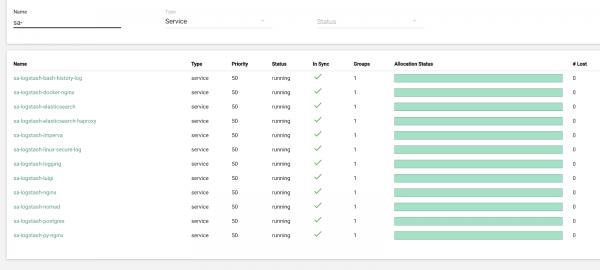
Në këtë iteracion, ne e patëm edhe problemin e mungesës së shkallëzimit gjysmëautomatik. Për këtë, ne kemi vendosur një klaster infrastrukture Nomad — i ngjashëm me atë që tashmë kemi në prodhim. Deri tani, numri i Logstash nuk ndryshon automatikisht në varësi të ngarkesës, por ne do të arrijmë atje.
Planet për të ardhmen
Konfigurimi i realizuar bëhet shkallëzues shumë mirë, dhe tani ruajmë 13.3 TB të dhënash — të gjithë loget për 4 ditë, që është e nevojshme për analizat emergjente të alerteve. Pjesën e logëve e transformojmë në metrikë, të cilat i mbledhim në Graphite. Për të lehtësuar punën e inxhinierëve, kemi metrikë për klasterin e infrastrukturës dhe skripte për riparimin gjysmëautomat të problemeve tipike. Pas rritjes së numrit të nodëve të dhënash që është planifikuar për vitin e ardhshëm, do të kalojmë nga ruajtja e të dhënave për 4 në 7 ditë. Kjo do të jetë e mjaftueshme për të punuar në mënyrë efikase, pasi gjithmonë përpiqemi të hetojmë incidentet sa më shpejt të jetë e mundur, dhe për hetimet afatgjata, kemi të dhëna telemetri.
Në tetor 2019, vizitueshmëria e cian.ru u rrit në 15.3 milion përdorues unikë në muaj. Kjo ishte një provë serioze për zgjidhjen arkitektonike të dorëzimit të logëve.
Aktualisht po përgatitemi të përditësojmë ElasticSearch në versionin 7. Megjithatë, për këtë do të duhet të përditësojmë mapping-un e shumë indekseve në ElasticSearch, pasi ato kaluan nga versioni 5.5 dhe u shpallën si të vjetruara në versionin 6 (në versionin 7 thjesht nuk ekzistojnë). Kjo do të thotë se gjatë procesit të përditësimit do të ketë ndonjë ngjarje të papritur, e cila për një kohë do të na lërë pa log. Nga versioni 7, presim më shumë Kibana me një ndërfaqe të përmirësuar dhe filtra të rinj.
Ne arritëm qëllimin tonë kryesor: ndaluam humbjen e logjeve dhe reduktuam kohën e ndërprerjes së infrastrukturës nga 2-3 rënie në javë në disa orë punë të shërbimit në muaj. I gjithë ky punë në prodhim është pothuajse e padukshme. Megjithatë, tani mund të përcaktojmë saktësisht se çfarë po ndodh me shërbimin tonë, mund ta bëjmë këtë shpejt në një mënyrë të qetë dhe të mos shqetësohemi për humbjen e logjeve. Në përgjithësi, jemi të kënaqur, të lumtur dhe po përgatisim për sfida të reja, të cilat do t'ju tregojmë më vonë.
Burimi: habr.com
