

Ky dërguar në këtë artikull janë disa shembuj të zakonshëm që ndihmojnë inxhinierët të punojnë me shërbime të mëdha, të cilave iu drejtohen miliona përdorues.
Sipas eksperiencës së autorit, ky nuk është një listë përfundimtare, por me të vërtetë këshilla efektive. Pra, le të fillojmë.
Përkthyer me mbështetje nga .
Niveli i fillestar
Masat e listuara më poshtë janë mjaft të lehta për t'u zbatuar, por ofrojnë një kthim të lartë. Nëse nuk i keni ndërmarrë ato më parë, do të habiteni nga përmirësimet e konsiderueshme.
Infrastruktura si kod
Pjesa e parë e këshillave është të implementoni infrastrukturën si kod. Kjo do të thotë që duhet të keni një mënyrë programore për të shpërndarë të gjithë infrastrukturën. Tingëllon e komplikuar, por në të vërtetë flasim për kodin e mëposhtëm:
Shpërndarja e 100 mjeteve virtuale
- me Ubuntu
- 2 GB RAM në secilin
- ata do të kenë këtë kod
- me këto parametra.
Ju mund të monitoroni ndryshimet në infrastrukturë dhe të riktheheni shpejt me ndihmën e sistemit të menaxhimit të versioneve.
Modernisti brenda meje thotë se mund të përdorim Kubernetes/Docker për të bërë të gjitha ato që u përmendën më parë, dhe ai ka të drejtë.
Për më tepër, automatizimi mund të arrihet duke përdorur Chef, Puppet ose Terraform.
Integrimi dhe dërgimi i vazhdueshëm
Për të krijuar një shërbim të shkallëzuar është e rëndësishme të keni një tubacion ndërtimi dhe testimi për çdo kërkesë tërheqjeje. Edhe nëse testi është më i thjeshtë, ai garanton së paku se kodi që po e shpërndan, kompilon.
Çdo herë në këtë fazë ju përgjigjeni pyetjes: a do të kompiloj montimi im dhe do të kalojë testet, a është valid? Kjo mund të duket si një prag i ulët, por zgjidh shumë probleme.
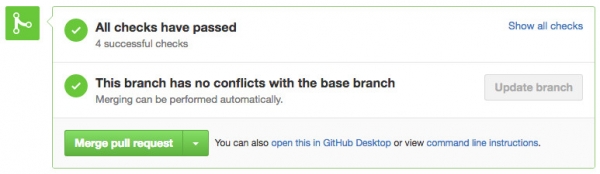
Nuk ka asgjë më të bukur se sa të shohësh këto shenja kontrolli.
Për këtë teknologji mund të vlerësoni Github, CircleCI ose Jenkins.
Balancuesit e ngarkesave
Pra, ne duam të aktivizojmë një balancues ngarkese për të ridrejtuar trafikun dhe të sigurojmë ngarkesë të barabartë në të gjitha nyjat ose funksionimin e shërbimit në rast dështimi:
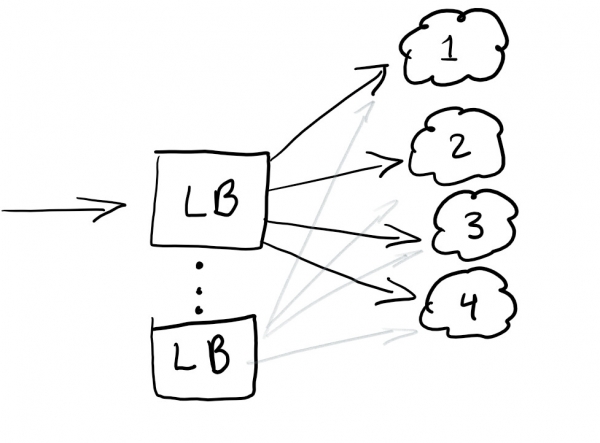
Balancuesi i ngarkesave, zakonisht ndihmon mirë në shpërndarjen e trafikut. Praktika më e mirë është mbrojtja e tepruar që të mos keni një pikë të vetme dështimi.
Zakonisht balancuesit e ngarkesave vendosen në atë cloud që po përdorni.
RayID, ID e koherencës ose UUID për kërkesat.
A keni hasur ndonjëherë një gabim në aplikacion me një mesazh të tillë: «Diçka shkoi keq. Ruajeni këtë id dhe dërgojeni në shërbimin tonë të mbështetjes»?
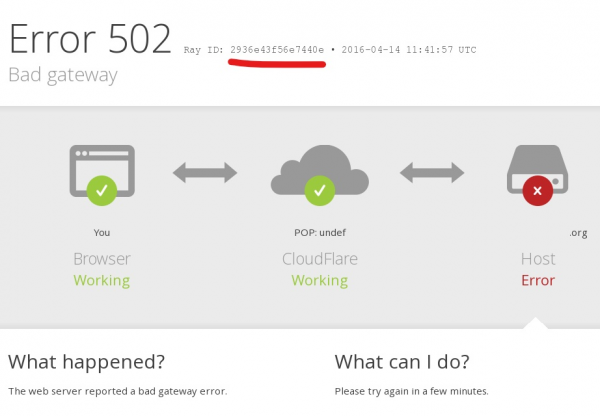
Identifikuesi unik, correlation ID, RayID ose ndonjë nga variantet — është një identifikues unik që lejon ndjekjen e kërkesës gjatë gjithë ciklit të saj të jetës. Kjo lejon ndjekjen e të gjithë rrugës së kërkesës në regjistrat.
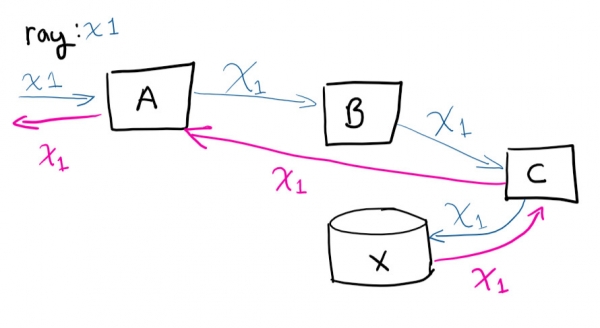
Përdoruesi bën një kërkesë në sistemin A, pastaj A lidhet me B, B lidhet me C, ruan në X dhe pastaj kërkesa kthehet në A
Nëse do të lidheshit në distancë me makinat virtuale dhe do të përpiqeshit të ndiqni rrugën e kërkesës (dhe të përputhni manualisht se cilat thirrje ndodhin), do të çmendeshit. Pasja e një identifikuesi unik e lehtëson shumë jetën. Kjo është një nga gjërat më të thjeshta që mund të bëni për të kursyer kohë ndërsa shërbimi rritet.
Niveli mesatar
Këtu këshillat janë më të komplikuara se ato të mëparshmet, por mjetet e duhura e zvogëlojnë ndjeshëm vështirësinë, duke siguruar kthim të investimeve edhe për kompanitë e vogla dhe të mesme.
Menaxhimi i centralizuar i regjistrave
Urime! Ju keni vendosur 100 makina virtuale. Të nesërmen, drejtori ekzekutiv vjen dhe ankohet për një gabim që kishte marrë gjatë testimit të shërbimit. Ai raporton identifikuesin përkatës, për të cilin folëm më lart, por ju do të duhet të shqyrtoni regjistrat e 100 makinave për të gjetur atë që shkaktoi dështimin. Dhe ju duhet ta gjeni para prezantimit nesër.
Megjithëse kjo tingëllon si një aventurë argëtuese, është më mirë të siguroheni që keni mundësinë e kërkimit në të gjithë regjistrat nga një vend. Unë zgjidhja problemin e centralizimit të regjistrave me funksionalitetin e integruar të grupit ELK: këtu mbështetet mbledhja e regjistrave me mundësi kërkimi. Kjo do të ndihmojë në zgjidhjen e problemit me gjetjen e regjistrit të caktuar. Si bonus, mund të krijoni diagrame dhe gjëra të tjera interesante.
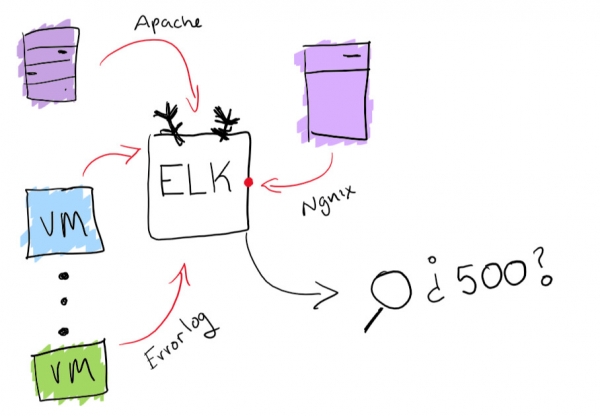
Funksionaliteti i grupit ELK
Agjentët e monitorimit
Tani që shërbimi juaj është vënë në punë, duhet të siguroheni që ai funksionon pa ndërprerje. Mënyra më e mirë për ta bërë këtë është të nisin disa agjentë, të cilët punojnë paralelisht dhe verifikojnë se ai funksionon dhe që operacionet bazë po kryhen.
Në këtë fazë ju kontrolloni se Ndërtesa e nisur po sillet mirë dhe funksionon normalisht.
Për projekte të vogla dhe të mesme, rekomandoj Postman për monitorimin dhe dokumentimin e API. Por në përgjithësi, thjesht duhet të siguroheni që keni një mënyrë për të ditur kur ka ndodhur një dështim dhe të merrni njoftim në kohë.
Automatizimi i shkallës në përputhje me ngarkesën
Është shumë e thjeshtë. Nëse keni një makinë virtuale që shërben kërkesa dhe ajo po i afrohet 80% të përdorimit të memorjes, atëherë mund të rritni burimet e saj, ose të shtoni më shumë makina virtuale në grumbull. Ekzekutimi automatik i këtyre operacioneve është shumë i përshtatshëm për ndryshimin elastic të fuqisë nën ngarkesë. Por ju gjithmonë duhet të jeni të kujdesshëm se sa para shpenzoni dhe të vendosni kufij të arsyeshëm.
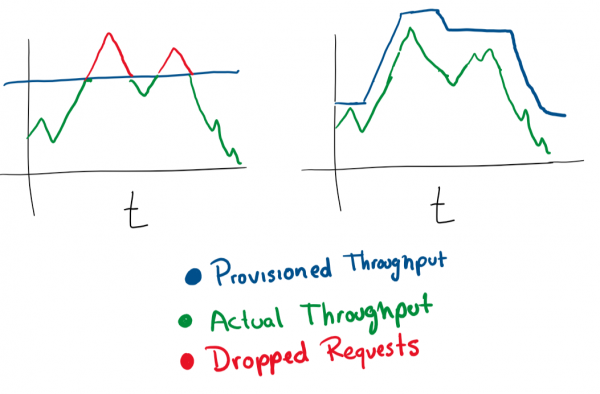
Në shumicën e shërbimeve cloud, mund të konfiguroheni automatizmin e shkallës duke përdorur më shumë serverë ose serverë më të fuqishëm.
Sistemi i eksperimenteve
Një mënyrë e mirë për të zbatuar përditësime në mënyrë të sigurt është mundësia për të testuar diçka për 1% të përdoruesve për një orë. Sigurisht, keni parë mekanizma të tillë në veprim. Për shembull, Facebook-i i tregon një grupi të audiencës një ngjyrë tjetër ose ndryshon madhësinë e shkrimit për të parë se si përdoruesit e perceptojnë ndryshimet. Kjo quhet testi A/B.
Madje, lëshimi i një funksioni të ri mund të nisë si një eksperiment, dhe më pas të përcaktoni se si të lëshohet. Gjithashtu, merrni mundësinë për të "tërhequr" ose ndryshuar konfigurimin në fluks, duke marrë parasysh funksionin që shkakton degradimin e shërbimit tuaj.
Niveli i avancuar
Këtu janë këshilla që janë mjaft të vështira për t'u realizuar. Probabilisht do t'ju nevojiten më shumë burime, kështu që një kompania e vogël ose e mesme do të ketë të vështirë me këtë.
Zhvillimet blu-gjelbër
Kjo është ajo që e quaj mënyrën "Erlang" të zhvillimit. Erlang u përdor gjerësisht kur u shfaqën kompanitë telefonike. Për ruterimin e thirrjeve telefonike, u aplikuan ndërprerës programorë. Detyra kryesore e software-it të këtyre ndërprerësve ishte të mos përplaste thirrjet gjatë përditësimit të sistemit. Erlang ka një mënyrë të shkëlqyer për të ngarkuar një modulin e ri pa rënë poshtë nga i mëparshmi.
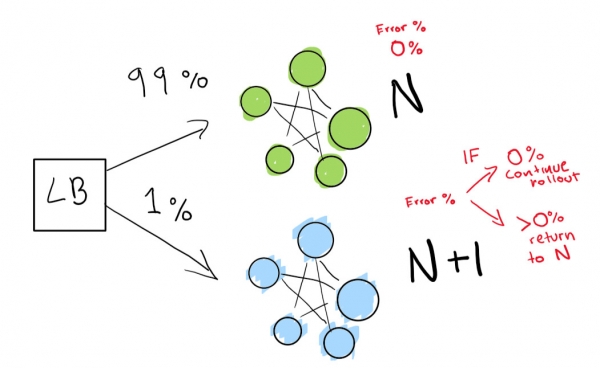
Ky kyç varet nga disponueshmëria e balancuesit të ngarkesës. Le të mendojmë se keni versionin N të softuerit tuaj, dhe tani dëshironi të lançoni versionin N+1.
Ju mund të thjesht ndaloni shërbimin dhe lançoni versionin tjetër në kohën që e konsideroni të përshtatshme për përdoruesit tuaj, dhe të merrni një kohë të caktuar ndalese. Por le të supozojmë se keni vërtetë kushtet të rrepta SLA. Pra, SLA 99.99% do të thotë se mund të jeni offline të për 52 minuta në vit.
Nëse vërtet doni të arrini këto tregues, nevojiten dy lançime në të njëjtën kohë:
- ai që kemi tani (N);
- versioni tjetër (N+1).
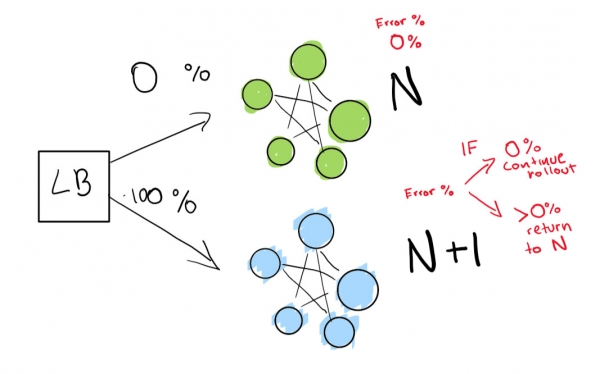
Ju tregoni balancuesit të ngarkesës të ridrejtojë një përqindje të trafikut në versionin e ri (N+1), ndërsa ju aktivisht monitoroni regresionet.
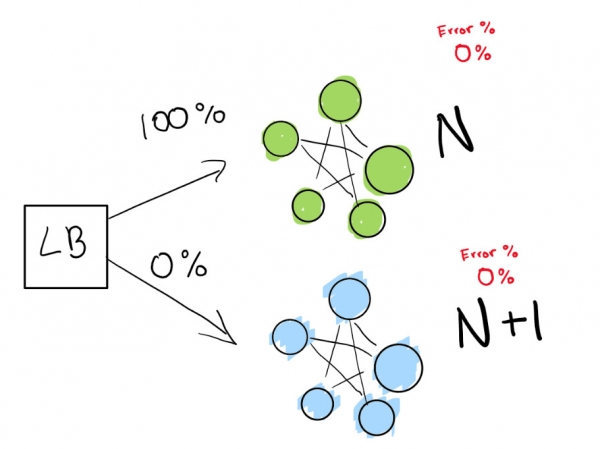
Këtu kemi një lançim të gjelbër N, i cili po funksionon normalisht. Po përpiqemi të kalojmë në versionin tjetër të këtij lançimi
Së pari ne dërgojmë një test shumë të vogël për të parë nëse lançimi ynë N+1 funksionon me një sasi të vogël trafik:
Në fund, kemi një grup kontrollesh automatike që ne përfundojmë të ekzekutojmë derisa lançimi ynë të jetë përfunduar. Nëse jeni shumë-mjaft të kujdesshëm, gjithashtu mund të mbani lançimin tuaj N përgjithmonë për një rikthim të shpejtë në rast të regresionit të keq:
Nëse dëshironi të kaloni në një nivel më të avancuar, le të zgjedhë gjithçka në lançimin blu-jeshil të bëhet automatikisht.
Zbulimi i anomali dhe zbutja automatike e pasojave
Duke marrë parasysh se keni regjistrim të centralizuar dhe një mbledhje të mirë të log-eve, tashmë mund të vendosni qëllime më të larta. Për shembull, të parashikoni gjithçka që mund të dështojë. Në monitorët dhe regjistrat, ndiqen funksionalitetet dhe krijohen grafika të ndryshme - dhe mund të parashikoni se çfarë do të shkojë keq:
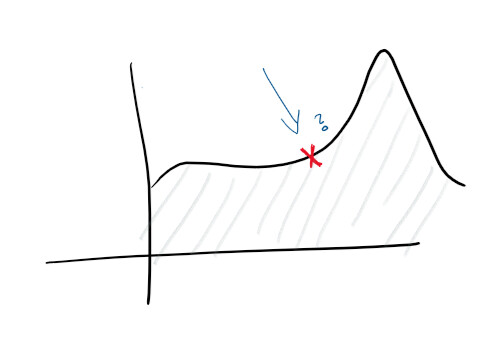
Me zbulimin e anomalisë, filloni të studioni disa tregues që jep shërbimi. Për shembull, një shpërthim i ngarkesës CPU mund të tregojë që disku i fortë është në rrezik, ndërsa një shpërthim i numrit të kërkesave do të thotë se duhet të shkallëzoni. Ky lloj statistike e bën shërbimin proaktiv.
Duke këtyre të dhënave analitike, mund të shkallëzoni në çdo dimension, duke ndryshuar proaktivisht dhe reaktivisht karakteristikat e makinave, bazave të të dhënave, lidhjeve dhe burimeve të tjera.
Këtu është gjithçka!
Ky listë prioritete do t'ju ndihmojë të evitoni shumë probleme nëse po rrisni një shërbim cloud.
Autori i artikullit origjinal fton lexuesit të lënë komentet e tyre dhe të bëjnë ndryshime. Artikulli shpërndahet si open source, kërkesat për tërheqje i pranon autori .
Çfarë tjetër për të lexuar në lidhje me temën:
Burimi: habr.com
