

Performanca e lartë është një nga kërkesat kryesore gjatë punës me të dhënat e mëdha. Ne në menaxhimin e ngarkesës së të dhënave në Sber merremi me procesimin e praktikisht të gjitha transaksioneve në cloudin tonë të të dhënave mbi bazën e Hadoop dhe prandaj përballemi me rrjedha të vërteta të mëdha informacioni. Natyrisht, gjithmonë jemi duke kërkuar mënyra për të përmirësuar performancën, dhe tani dëshirojmë të tregojmë se si arritëm të modifikojmë RegionServer HBase dhe klientin HDFS, duke rritur ndjeshëm shpejtësinë e operacioneve të leximit.
Megjithatë, përpara se të kalojmë në thelbin e përmirësimeve, është e rëndësishme të përmendim limitet që, në princip, nuk janë të mundura për t'u anashkaluar nëse përdorim HDD.
Pse HDD dhe leximi i shpejtë aksesi të rastësishëm janë të papajtueshme
Siç dihet, HBase, si dhe shumë DB të tjera, ruajnë të dhënat në blloqe me një madhësi prej disa dhjetëra kilobajtesh. Në mënyrë standarde, kjo është rreth 64 Kb. Tani le të imagjinojmë se na nevojitet të nxjerrim vetëm 100 bajta dhe kërkojmë që HBase të na japë këto të dhëna sipas një çelësi të caktuar. Duke qenë se madhësia e bllokut në HFiles është 64 Kb, ajo që do të kërkohet do të jetë 640 herë më shumë (për një minutë!) se ajo që ne na nevojitet.
Më pas, pasi kërkesa do të kalojë përmes HDFS dhe mekanizmit të saj të cache-imit të metadhenave ShortCircuitCache (i cili lejon qasje të drejtpërdrejtë në skedarët), kjo çon në leximin e 1 Mb nga disku. Megjithatë, kjo mund të rregullohet me parametër dfs.client.read.shortcircuit.buffer.size dhe në shumë raste ka kuptim të zvogëlohet kjo vlerë, p.sh. deri në 126 Kb.
Supozoni që ne e bëjmë këtë, por përveç kësaj, kur fillojmë të lexojmë të dhëna përmes java api, me funksione si FileChannel.read dhe kërkojmë nga sistemi operativ të lexojë sasinë përkatëse të të dhënave, ai lexon «për çdo rast» 2 herë më shumë, domethënë në 256 Kb në rastin tonë. Kjo ndodh sepse në java nuk ka një mundësi të thjeshtë për të vendosur flamurin FADV_RANDOM, i cili parandalon një sjellje të tillë.
Si rezultat, për të marrë mbi 100 bajta, në sfond po lexohen 2600 herë më shumë. Duket se zgjidhja është e qartë, le të zvogëlojmë madhësinë e bllokut në një kilobajt, të vendosim flamurin e përmendur dhe të arrijmë një ndriçim të madh me shpejtësinë. Por fatkeqësisht, duke zvogëluar madhësinë e bllokut me 2 herë, ne gjithashtu zvogëlojmë sasinë e bajtëve të lexuar në një njësi kohe po me 2 herë.
Disa disa me ngritjen e flamurit FADV_RANDOM mund të përfitoni, por vetëm nëse ka shumë procese paralel dhe me një madhësi blloku nga 128 KB, por kjo është maksimumi disa përqindësh:
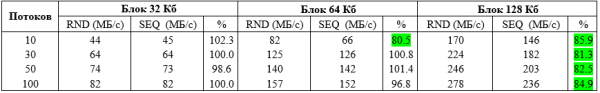
Testet u kryen me 100 skedarë, secili me një madhësi prej 1 GB dhe të vendosur në 10 disqe HDD.
Le të llogarisim se për çfarë mund të presim me këtë shpejtësi:
Le të supzojmë se lexojmë nga 10 disqe me shpejtësi 280 MB/sec, dmth 3 milion herë nga 100 byte. Por siç e mbajmë mend, të dhënat që na duhen shfaqen 2600 herë më pak se sa ato të lexuara. Pra, ndajnë 3 milionët me 2600 dhe marrim 1100 regjistrime në sekondë.
Për të ardhur keq, apo jo? Kjo është natyra aksesit të rastësishëm në të dhënat HDD — pavarësisht nga madhësia e bllokut. Kjo është kufiri fizik i aksesit të rastësishëm dhe asnjë DB nuk mund të nxjerrë më shumë në këto kushte.
Si arrijnë atëherë bazat të arrijnë një shpejtësi shumë më të lartë? Për të përgjigjur këtë pyetje, le të shikojmë se çfarë ndodh në figurën tjetër:
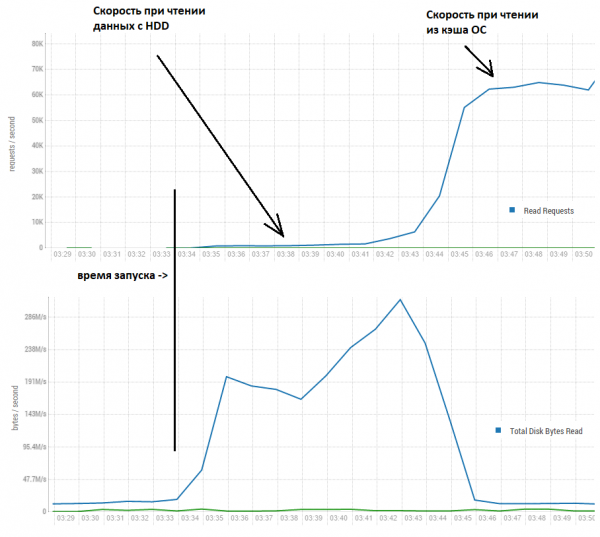
Këtu shohim se në minutat e para shpejtësia vërtet është rreth një mijë regjistrime në sekondë. Megjithatë, më vonë, falë faktit se lexohen shumë më tepër se sa u kërkua, të dhënat vendosen në buff/cache-in e sistemit operativ (linux) dhe shpejtësia rritet në më shumë se 60 mijë në sekondë.
Pra, më vonë do të merremi me përmirësimin e aksesit vetëm në ato të dhëna që janë në cache-in e OS ose ndodhen në burime të ngjashme me shpejtësi të aksesit si SSD/NVMe.
Në rastin tonë, ne do të kryejmë teste në një skenë me 4 serverë, secili e ngarkuar si më poshtë:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 threads.
Memorie: 730 GB.
java version: 1.8.0_111
Dhe këtu është çelësi — sasia e të dhënave në tabela, që duhet të lexohen. Çështja është se nëse lexoni të dhënat nga një tabelë, e cila plotësisht hyn në cache-in HBase, atëherë leximi nga buff/cache-in e sistemit operativ as që do të ndodhë. Sepse HBase në mënyrë default ndan 40% të memories për një strukturë që quhet BlockCache. Në thelb, kjo është një ConcurrentHashMap, ku çelësi është emri i skedarit + offset-i i bllokut, dhe vlera janë të dhënat për këtë offset.
Pra, kur leximi ndodh vetëm nga kjo strukturë, ne , duke kalimi miliona kërkesave në sekondë. Por le të imagjinojmë se nuk mund të ndajmë qindra gigabajt të memories ekskluzivisht për nevojat e DB, sepse në këto servera funksionojnë shumë gjëra të tjera të dobishme.
Për shembull, në rastin tonë, volumi i BlockCache në një RS është rreth 12 GB. Ne kemi vendosur dy RS në një nod, pra për BlockCache janë rezervuar 96 GB në të gjitha nodet. Dhe të dhënat janë disa herë më shumë, le të themi se kemi 4 tabela, për 130 rajone, ku skedarët janë me madhësi prej 800 MB, të kompresuar me FAST_DIFF, duke shkuar në një total prej 410 GB (këto janë të dhëna të pastra, pra pa marrë parasysh faktorët e replikimit).
Kështu, BlockCache përbën vetëm rreth 23% të sasisë totale të të dhënave dhe kjo është shumë më afër kushteve reale të asaj që quhet BigData. Dhe këtu fillon e gjithë puna interesante — sepse është e qartë se sa më pak goditje në memorie, aq më keq është performanca. Sepse në rastin e humbjes do të duhet të kryhen shumë punë — pra do të shkojmë deri te thirrjet e funksioneve sistemore. Megjithatë, kjo nuk mund të shmanget, ndaj le të shqyrtojmë një aspekt tjetër — çfarë ndodh me të dhënat brenda caches?
Le të thjeshtojmë situatën dhe të supozojmë se kemi një cache në të cilin vendoset vetëm një objekt. Ja shembulli i asaj që do të ndodhë kur përpiqemi të punojmë me një volum të dhënash që është 3 herë më i madh se cache, do të na duhet:
1. Të vendosim bllokun 1 në cache
2. Të heqim bllokun 1 nga cache
3. Të vendosim bllokun 2 në cache
4. Të heqim bllokun 2 nga cache
5. Të vendosim bllokun 3 në cache
Këto janë bërë 5 veprime! Megjithatë, nuk mund ta quajmë këtë situatë normale, në të vërtetë ne po e detyrojmë HBase të kryejë shumë punë krejtësisht të panevojshme. Ai përhershëm po lexon të dhëna nga cache i OS-së, i vendos ato në BlockCache, vetëm për t'i hequr ato shumë shpejt, sepse ka mb arrived një sasi të re të dhënash. Animacioni në fillim të postit ilustron thelbin e problemit — Garbage Collector është jashtë masash, atmosfera ngrohet, Greta e vogël në Suedinë e largët dhe të nxehtë është e shqetësuar. Dhe ne si IT-istë e urrejmë shumë kur fëmijët janë të trishtuar, prandaj fillojmë të mendojmë se çfarë mund të bëjmë me këtë.
Por çfarë ndodh nëse vendosim në cache jo të gjitha blloqet, por vetëm një përqindje të caktuar të tyre, në mënyrë që cache të mos teprohet? Le ta fillojmë thjesht duke shtuar disa rreshta kodi në fillim të funksionit të vendosjes së të dhënave në BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Këtu kuptohet se, offset-i është pozita e bllokut në skedar dhe numrat e fundit janë shpërndarë rastësisht dhe në mënyrë të barabartë nga 00 në 99. Prandaj, do të hutojmë vetëm ato që bien në intervalin tonë të nevojshëm.
Për shembull, le të vendosim cacheDataBlockPercent = 20 dhe të shohim se çfarë do të ndodhë:
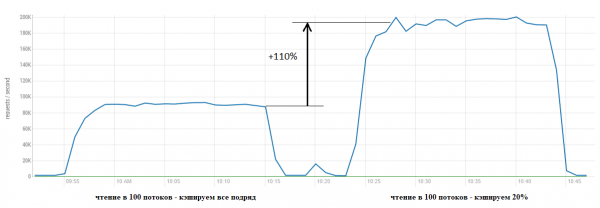
Rezultati është në dritë. Në grafikët më poshtë bëhet e qartë se përmes çfarë ndodhi një përshpejtim i tillë — ne kursim një sasi të madhe burimesh GC duke mos u angazhuar në një përpjekje të kota për të vendosur të dhënat në cache vetëm për t'i hedhur më vonë në ecjen marse.
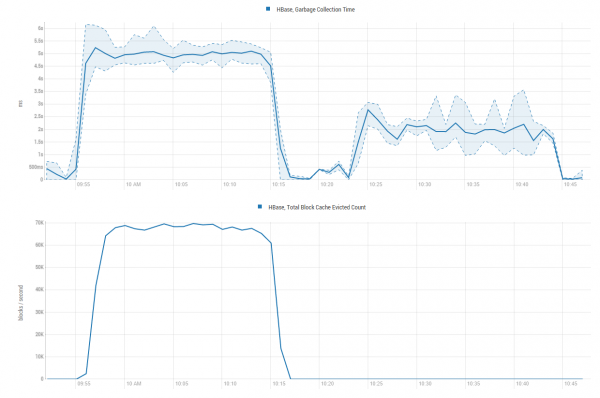
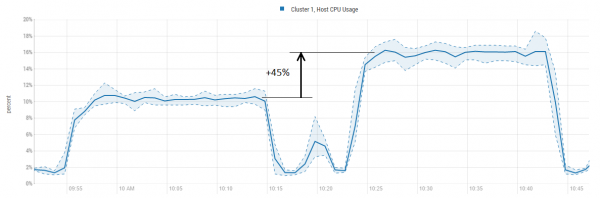
Përqindja e përdorimit të CPU rritet, por megjithatë shumë më pak se prodhimi:
Këtu vlen të theksohet se blloqet që ruhen në BlockCache janë të ndryshme. Një pjesë e madhe, rreth 95%, janë të dhëna reale. Ndërsa e gjithë pjesa tjetër është metadatë, si filtra Bloom ose LEAF_INDEX. . Këto të dhëna janë të pakta, por shumë të dobishme, sepse përpara se të kontribuoni drejtpërdrejt në të dhëna, HBase kthehet te metadata për të kuptuar nëse është e nevojshme të kërkojmë më tutje dhe nëse po, atëherë ku ndodhet blloku që e intereson.
Prandaj, në kod ne shohim kushtin e kontrollit buf.getBlockType().isData() dhe falë kësaj metadate ne do të lëmë gjithmonë në cache.
Tani le të rrisim ngarkesën dhe njëkohësisht të optimizojmë pak funksionin. Në testin e parë kemi vendosur përqindjen e prerjes = 20 dhe BlockCache ishte pak nën ngarkuar. Tani do të vendosim 23% dhe do të shtojmë 100 thjeshtësi çdo 5 minuta, për të parë në çfarë momenti ndodh saturimi:
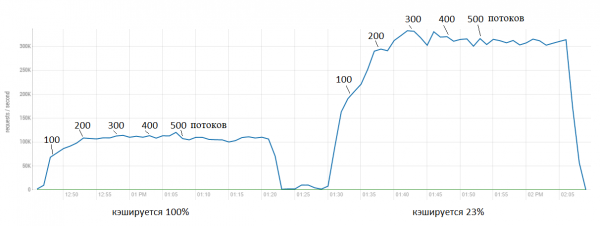
Këtu shohim se versioni origjinal pothuajse menjëherë arrin një kufi rreth 100 mijë kërkesash në sekondë. Ndërsa patch-i jep një përshpejtim deri në 300 mijë. Në të njëjtën kohë, është e qartë se përshpejtimi i mëtejshëm nuk është aq "falas", përdorimi i CPU gjithashtu rritet.
Megjithatë, kjo nuk është një zgjidhje shumë e rafinuar, pasi ne paraprakisht nuk e dimë se sa përqind e blloqeve duhet të ruhet në cache, kjo varet nga profili i ngarkesës. Prandaj, është realizuar një mekanizëm automatik për rregullimin e kësaj parametri në varësi të aktivitetit të operacioneve të leximit.
Për menaxhimin e kësaj janë shtuar tre parametra:
hbase.lru.cache.heavy.eviction.count.limit — përcakton se sa herë duhet të ekzekutohet procesi i zhvendosjes së të dhënave nga cache, para se të fillojmë të përdorim optimizimin (dmth. të kalojmë blloqet). Nga e drejta, kjo është MAX_INT = 2147483647 dhe në fakt do të thotë se karakteristika nuk do të fillojë kurrë të funksionojë me këtë vlerë. Sepse procesi i zhvendosjes ekzekutohet çdo 5 — 10 sekonda (kjo varet nga ngarkesa) dhe 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 vjet. Megjithatë ne mund ta vendosim këtë parametër në 0 dhe ta detyrojmë karakteristikën të funksionojë menjëherë pas fillimit.
Megjithatë, ka edhe një ngarkesë të dobishme në këtë parametër. Nëse ngarkesa jonë është e tillë që shkurtimisht ndërhyhet mes leximeve afatshkurtra (le të themi gjatë ditës) dhe leximet afatgjata (në mbrëmje), atëherë mund të bëjmë që karakteristika të aktivizohet vetëm kur ndodhin operacione të zgjatura leximi.
Për shembull, e dimë se leximet afatshkurtra zakonisht zgjatin rreth 1 minutë. Nuk duhet të fillojmë të largojmë blloqet, cache nuk do të ketë kohë të vjetërojë dhe atëherë mund ta vendosim këtë parametër në rreth 10. Kjo do të çonte në faktin se optimizimi do të fillojë të funksionojë vetëm kur të fillojnë leximet e zgjatura aktive, dmth. pas 100 sekondash. Kështu, nëse kemi lexim afatshkurtër, të gjitha blloqet do të futen në cache dhe do të jenë të disponueshme (përveç atyre që do të zhvendosen nga algoritmi standard). Dhe kur bëjmë lexime afatgjata, karakteristika aktivizohet dhe ne do të kemi një performancë shumë më të lartë.
hbase.lru.cache.heavy.eviction.mb.size.limit — përcakton se sa megabajt do të doja të vendosja në cache (dhe natyrisht të zhvendosja) çdo 10 sekonda. Karakteristika do të përpiqet të arrijë këtë vlerë dhe ta mbajë atë. Kuptimi është si vijon, nëse ngjeshim në cache gigabajt, atëherë do të kenë për të zhvendosur edhe gigabajt, e cila, siç e pamë më sipër, është shumë e kushtueshme. Megjithatë, nuk duhet të përpiqeni ta vendosni shumë të vogël, sepse kjo do të çonte në një dalje të parakohshme nga moda e kalimit të blloqeve. Për serverët e fuqishëm (rreth 20-40 bërthamave fizike) është optimal të vendosni rreth 300-400 MB. Për klasën mesatare (~10 bërthama) 200-300 MB. Për sistemet e dobëta (2-5 bërthama) mund të jetë e pranueshme 50-100 MB (në ato nuk është testuar).
Le të shohim se si funksionon: le të supozojmë se kemi vendosur hbase.lru.cache.heavy.eviction.mb.size.limit = 500, ndodhet një ndLoad (lexim) dhe atëherë çdo ~10 sekonda ne llogarisim se sa byte janë çliruar me formulën:
Overhead = Shuma e Byte-eve të Çliruara (MB) * 100 / Kufiri (MB) — 100;
Nëse në fakt janë çliruar 2000 MB, atëherë Overhead rezulton të jetë:
2000 * 100 / 500 — 100 = 300%
Algoritmet përpiqen të mbajnë jo më shumë se disa dhjetëra përqind, kështu që funksioni do të reduktojë përqindjen e bllokove të keqes, duke realizuar kështu një mekanizëm auto-regullimi.
Megjithatë, nëse ngarkesa bie, le të supozojmë se janë çliruar vetëm 200 MB dhe Overhead ka bërë një ndërlikim negativ (e quajtur overshooting):
200 * 100 / 500 — 100 = -60%
Atëherë funksioni do të rrisë përqindjen e bllokove të keqes derisa Overhead të bëhet pozitiv.
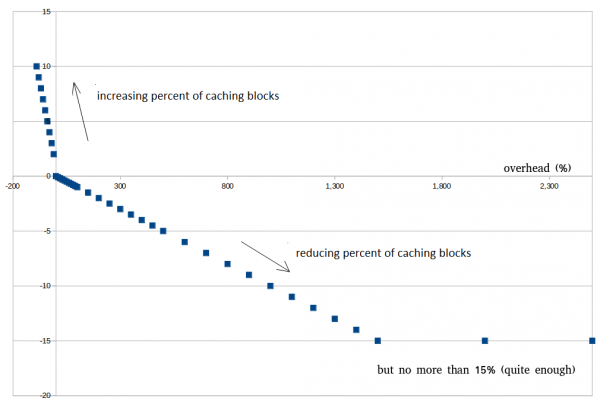
Më poshtë do të shihni një shembull se si duket kjo në të dhëna reale. Mos u përpoqni të arrini 0%, kjo është e pamundur. Kaçëndrojnë rreth 30 — 100%, kjo ndihmon për të shmangur daljen e parakohshme nga mënyra e optimizimit në rritje të shkurtër.
hbase.lru.cache.heavy.eviction.overhead.coefficient — vendos si shpejt duam të marrim rezultatet. Nëse jemi të sigurt se leximet tona kryesisht janë të gjata dhe nuk duam të presim, ne mund ta rrisim këtë koeficient dhe të marrim performancë më të lartë më shpejt.
Për shembull, ne vendosim këtë koeficient = 0.01. Kjo do të thotë se Overhead (shih më lart) do të shumëzohet me këtë numër në rezultatin e marrë dhe do të ulet përqindja e bllokove të keqes. Le të supozojmë se Overhead = 300%, dhe koeficienti = 0.01, atëherë përqindja e bllokove të keqes do të ulet me 3%.
Një logjikë e tillë "Backpressure" është implementuar gjithashtu për vlerat negative të Overhead (overshooting). Sepse gjithmonë janë të mundshme luhatje të shkurtra të volumit të leximeve dhe çlirimeve, ky mekanizëm ndihmon në shmangien e daljes së parakohshme nga mënyra e optimizimit. Backpressure ka logjikë të përmbysur: sa më e madhe të jetë overshooting, aq më shumë blloqe do të keqen.
Kodi i implementimit
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict()/1024/1024;
        /*
        * Ndonëher ne po lexojmë më shumë të dhëna se sa mund të përshtaten në BlockCache
        * dhe kjo shkakton një normë të lartë të eviktimeve.
        * Kjo, nga ana tjetër, çon në punën e rëndë të Garbage Collector.
        * Pra, shumë blloqe futen në BlockCache por kurrë nuk lexohen,
        * por shpenzojnë shumë burime CPU.
        * Këtu do të analizojmë sa byte janë liruar dhe do të vendosim
        * nëse është koha për të reduktuar numrin e blloqeve të memorizuara.
        * Kjo ndihmon në shmangien e futjes së shumë blloqeve në BlockCache
        * kur evict() punon shumë aktiv dhe ruan CPU për punë të tjera.
        * Më shumë detaje: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Së pari, ne duhet të kontrollojmë sa kohë
        // ka kaluar që nga evict() i mëparshëm
        // Kjo duhet të jetë pothuajse e njëjtë në kohë (+/- 10s)
        // sepse marrim vëllime të krahasueshme të byte të liruar çdo herë.
        // 10s sepse ky është periudha e paracaktuar për të funksionuar evict() (shih më lart këtë.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Këtu duhet të kalkulojmë se çfarë situate kemi.
          // Ne kemi limitin "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // dhe mund të kalkulojmë mbingarkesën mbi të.
          // Ne do ta përdorim këtë informacion për të vendosur,
          // si të ndryshojmë përqindjen e blloqeve të memorizuara.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Tani jemi në situatën kur jemi mbi limit
            // Por ndoshta do të injorojmë sepse kjo do të përfundojë shumë shpejt
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Kjo po zgjat për një kohë të gjatë dhe ne duhet të reduktojmë numrin e blloqeve të memorizuara
              // tani. Pra, ne kalkulojmë këtu se sa blloqe duam të anashkalojmë.
              // Kjo varet nga:
              // 1. Mbingarkesa - nëse mbingarkesa është e madhe ne mund të jemi më agresivë
              // duke reduktuar numrin e blloqeve të memorizuara.
              // 2. Sa shpejt duam të arrijmë rezultatin. Nëse e dimë se
              // leximi i rëndë po zgjat për një kohë të gjatë, nuk duam të presim dhe mund
              // të rrisim koeficientin dhe të arrijmë një performancë të mirë shumë shpejt.
              // Por nëse nuk jemi të sigurt mund ta bëjmë ngadalë dhe kjo mund të parandalojë
              // daljen e parakohshme nga ky modalitet. Pra, kur koeficienti është
              // më i lartë, mund të arrijmë performancë më të mirë kur leximi i rëndë është stabil.
              // Por kur leximi është në ndryshim mund të rregullojmë këtë dhe të vëmë
              // koeficientin në një vlerë më të ulët.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Por praktika tregon se një reduktim prej 15% është mjaft i mjaftueshëm.
              // Ne nuk jemi lakmitarë (kjo mund të çojë në dalje të parakohshme).
              change = Math.min(15, change);
              change = Math.max(0, change); // Mendoni se kjo nuk do të ndodhë kurrë, por kontrolloni për siguri
              // Pra, kjo është pika kryesore, këtu po reduktojmë % e blloqeve të memorizuara
              cache.cacheDataBlockPercent -= change;
              // Nëse shkojmë shumë poshtë ne duhet të ndalojmë këtu, 1% në çdo rast duhet të jetë.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Mirë, kemi marr një mbingarkesë.
            // Ndoshta është thjesht një ndryshim afatshkurtër dhe ne mund të qëndrojmë në këtë modalitet.
            // Kjo ndihmon në shmangien e daljes të parakohshme gjatë ndryshimeve të përkohshme.
            // Nëse mbingarkesa është më pak se 90%, ne do të përpiqemi të rrisim përqindjen e
            // blloqeve të memorizuara dhe shpresojmë se është e mjaftueshme.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Logjika e thjeshtë: më shumë mbingarkese - më shumë blloqe memorizimi (presion mbrapa)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Por nuk mund të jetë më shumë se 100%, kështu që kontrolloni.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Duket se leximi i rëndë ka përfunduar.
              // Thjesht dalim nga ky modalitet.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache evicted (MB): {}, overhead (%): {}, " +
            "heavyeviction counter: {}, " +
            "current caching DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Tani do ta shqyrtojmë me një shembull të vërtetë. Kemi skenarin e mëposhtëm për testim:
- Fillojmë të bëjmë Scan (25 threads, batch = 100)
- Pas 5 minutash shtojmë multi-gets (25 threads, batch = 100)
- Pas 5 minutash ndalojmë multi-gets (mbetet përsëri vetëm scan)
Bëjmë dy përgatitje, së pari hbase.lru.cache.heavy.eviction.count.limit = 10000 (çka faktikisht ndalon funksionin), dhe pastaj vendosim limit = 0 (e aktivizon).
Në log-un më poshtë shohim si aktivizohet funksioni, duke resetuar Overshooting deri në 14-71%. Herë pas here ngarkesa bie, çka aktivizon Backpressure dhe HBase sërish cache të blloqeve më shumë.
Log RegionServer
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, heavy eviction counter: 1, current caching DataBlock (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, heavy eviction counter: 2, current caching DataBlock (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, heavy eviction counter: 3, current caching DataBlock (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, heavy eviction counter: 4, current caching DataBlock (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, heavy eviction counter: 5, current caching DataBlock (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, heavy eviction counter: 6, current caching DataBlock (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, heavy eviction counter: 7, current caching DataBlock (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, heavy eviction counter: 8, current caching DataBlock (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, heavy eviction counter: 9, current caching DataBlock (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, heavy eviction counter: 10, current caching DataBlock (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, heavy eviction counter: 11, current caching DataBlock (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, heavy eviction counter: 12, current caching DataBlock (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, heavy eviction counter: 13, current caching DataBlock (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, heavy eviction counter: 14, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 15, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 16, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, heavy eviction counter: 17, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, heavy eviction counter: 18, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, heavy eviction counter: 19, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, heavy eviction counter: 20, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, heavy eviction counter: 21, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, heavy eviction counter: 22, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, heavy eviction counter: 23, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, heavy eviction counter: 24, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, heavy eviction counter: 25, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, heavy eviction counter: 26, current caching DataBlock (%): 19
i larguar (MB): 456, raporti 0.17, mbingesë (%): 128, numri i lartë i largimeve: 27, blloku aktual i të dhënave (DataBlock) në cache (%): 18 < shtesë merr (por tabela e njëjtë)
i larguar (MB): 456, raporti 0.15, mbingesë (%): 128, numri i lartë i largimeve: 28, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 342, raporti 0.13, mbingesë (%): 71, numri i lartë i largimeve: 29, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 342, raporti 0.11, mbingesë (%): 71, numri i lartë i largimeve: 30, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 342, raporti 0.09, mbingesë (%): 71, numri i lartë i largimeve: 31, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 228, raporti 0.08, mbingesë (%): 14, numri i lartë i largimeve: 32, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 228, raporti 0.07, mbingesë (%): 14, numri i lartë i largimeve: 33, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 228, raporti 0.06, mbingesë (%): 14, numri i lartë i largimeve: 34, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 228, raporti 0.05, mbingesë (%): 14, numri i lartë i largimeve: 35, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 228, raporti 0.05, mbingesë (%): 14, numri i lartë i largimeve: 36, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 228, raporti 0.04, mbingesë (%): 14, numri i lartë i largimeve: 37, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 109, raporti 0.04, mbingesë (%): -46, numri i lartë i largimeve: 37, blloku aktual i të dhënave (DataBlock) në cache (%): 22 < presion i prapë
i larguar (MB): 798, raporti 0.24, mbingesë (%): 299, numri i lartë i largimeve: 38, blloku aktual i të dhënave (DataBlock) në cache (%): 20
i larguar (MB): 798, raporti 0.29, mbingesë (%): 299, numri i lartë i largimeve: 39, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 570, raporti 0.27, mbingesë (%): 185, numri i lartë i largimeve: 40, blloku aktual i të dhënave (DataBlock) në cache (%): 17
i larguar (MB): 456, raporti 0.22, mbingesë (%): 128, numri i lartë i largimeve: 41, blloku aktual i të dhënave (DataBlock) në cache (%): 16
i larguar (MB): 342, raporti 0.16, mbingesë (%): 71, numri i lartë i largimeve: 42, blloku aktual i të dhënave (DataBlock) në cache (%): 16
i larguar (MB): 342, raporti 0.11, mbingesë (%): 71, numri i lartë i largimeve: 43, blloku aktual i të dhënave (DataBlock) në cache (%): 16
i larguar (MB): 228, raporti 0.09, mbingesë (%): 14, numri i lartë i largimeve: 44, blloku aktual i të dhënave (DataBlock) në cache (%): 16
i larguar (MB): 228, raporti 0.07, mbingesë (%): 14, numri i lartë i largimeve: 45, blloku aktual i të dhënave (DataBlock) në cache (%): 16
i larguar (MB): 228, raporti 0.05, mbingesë (%): 14, numri i lartë i largimeve: 46, blloku aktual i të dhënave (DataBlock) në cache (%): 16
i larguar (MB): 222, raporti 0.04, mbingesë (%): 11, numri i lartë i largimeve: 47, blloku aktual i të dhënave (DataBlock) në cache (%): 16
i larguar (MB): 104, raporti 0.03, mbingesë (%): -48, numri i lartë i largimeve: 47, blloku aktual i të dhënave (DataBlock) në cache (%): 21 < ndërprerje merr
i larguar (MB): 684, raporti 0.2, mbingesë (%): 242, numri i lartë i largimeve: 48, blloku aktual i të dhënave (DataBlock) në cache (%): 19
i larguar (MB): 570, raporti 0.23, mbingesë (%): 185, numri i lartë i largimeve: 49, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 342, raporti 0.22, mbingesë (%): 71, numri i lartë i largimeve: 50, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 228, raporti 0.21, mbingesë (%): 14, numri i lartë i largimeve: 51, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 228, raporti 0.2, mbingesë (%): 14, numri i lartë i largimeve: 52, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 228, raporti 0.18, mbingesë (%): 14, numri i lartë i largimeve: 53, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 228, raporti 0.16, mbingesë (%): 14, numri i lartë i largimeve: 54, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 228, raporti 0.14, mbingesë (%): 14, numri i lartë i largimeve: 55, blloku aktual i të dhënave (DataBlock) në cache (%): 18
i larguar (MB): 112, raporti 0.14, mbingesë (%): -44, numri i lartë i largimeve: 55, blloku aktual i të dhënave (DataBlock) në cache (%): 23 < presion i prapë
i larguar (MB): 456, raporti 0.26, mbingesë (%): 128, numri i lartë i largimeve: 56, blloku aktual i të dhënave (DataBlock) në cache (%): 22
i larguar (MB): 342, raporti 0.31, mbingesë (%): 71, numri i lartë i largimeve: 57, blloku aktual i të dhënave (DataBlock) në cache (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 58, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 59, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 60, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 61, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 62, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 63, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.32, ngarkesa (%): 71, numri i lartë i shkëputjeve: 64, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 65, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 66, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.32, ngarkesa (%): 71, numri i lartë i shkëputjeve: 67, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 68, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.32, ngarkesa (%): 71, numri i lartë i shkëputjeve: 69, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.32, ngarkesa (%): 71, numri i lartë i shkëputjeve: 70, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 71, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 72, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 73, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 74, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 75, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 342, raporti 0.33, ngarkesa (%): 71, numri i lartë i shkëputjeve: 76, DataBlock aktual i ruajtjes (%): 22
shkëputur (MB): 21, raporti 0.33, ngarkesa (%): -90, numri i lartë i shkëputjeve: 76, DataBlock aktual i ruajtjes (%): 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
Skemat ishin të nevojshme për të ilustruar këtë proces ndryshe në një grafik që tregon raportin midis dy pjesëve të caches — single (ku hynë blloqet që nuk janë kërkuar asnjëherë) dhe multi (këtu ruhen të dhënat që janë 'kërkuar' të paktën një herë):
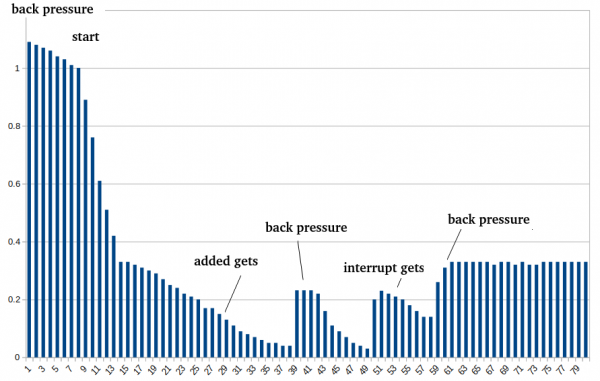
Dhe në fund si duket funksionimi i parametrave në formën e një grafiku. Për krahasim, cache ishte plotësisht i çaktivizuar në fillim, pastaj HBase u aktivizua me keqruajtjen dhe u vonua fillimi i optimizimit për 5 minuta (30 cikle shkëputjeje).
Kodi i plotë mund të gjendet në Pull Request në github.
Megjithatë, 300 mijë lexime në sekondë nuk janë e gjitha që mund të nxirren nga kjo pajisje në këto kushte. Kjo për shkak se kur është e nevojshme të aksesohen të dhënat përmes HDFS, përdoret mekanizmi ShortCircuitCache (SSC), i cili lejon aksesin direkt në të dhëna, duke shmangur ndërveprimet rrjet.
Profilizimi tregoi se ky mekanizëm, ndonëse ofron një fitim të madh, në një moment gjithashtu bëhet një ngushticë, sepse praktisktisht të gjitha operacionet e rënda ndodhin brenda lock, çka çon në bllokime për shumicën e kohës.
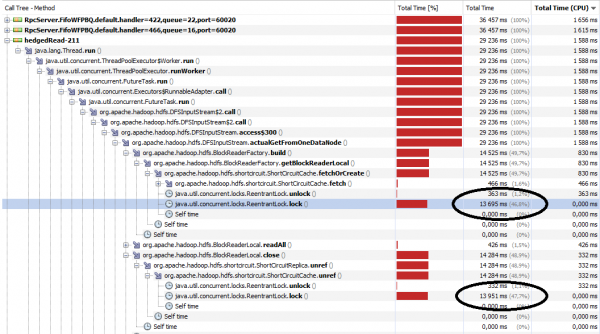
Duke e kuptuar këtë, ne kuptuam se problemi mund të anashkalohet nëse krijojmë një array të SSC-ve të pavarura:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Dhe më tej të punojmë me to, duke përjashtuar ndërprerjet gjithashtu sipas numrit të fundit të offset-it:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Tani mund të fillojmë me testet. Për këtë do të lexojmë skedarët nga HDFS me një aplikacion të thjeshtë shumëthërmirë. Vendosim parametrat:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); //default = 1 MB dhe kjo ngadalëson leximin shumë, prandaj është më mirë ta përshtatim me nevojat reale
conf.set("dfs.client.short.circuit.num", num); // nga 1 në 10
Dhe thjesht lexojmë skedarët:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Ky kod ekzekutohet në thërrmija të veçanta dhe ne do të rrisim numrin e skedarëve që lexohen njëkohësisht (nga 10 në 200 — boshti horizontal) dhe numrin e cache-ve (nga 1 në 10 — grafikët). Boshti vertikal tregon përshpejtimin që jep rritja e SSC në krahasim me rastin kur cache është vetëm një.
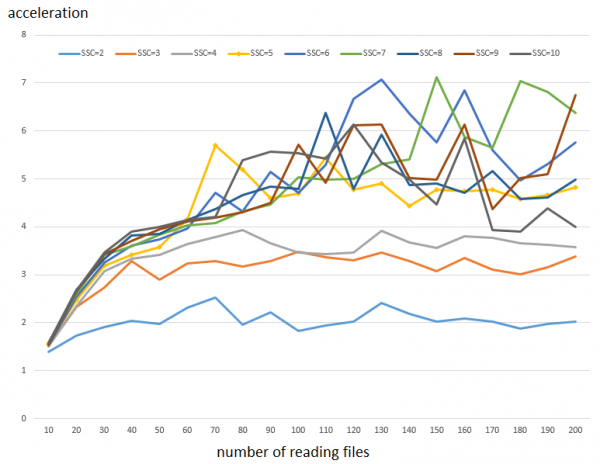
Si të lexoni grafikën: koha e ekzekutimit të 100 mijë leximeve në blloqe prej 64 KB me një cache kërkon 78 sekonda. Ndërsa me 5 cache, kjo përfundon për 16 sekonda. Kështu, kemi një përshpejtim prej ~5 herë. Siç duket nga grafiku, në një numër të vogël leximesh paralele efekti nuk është shumë i dukshëm, kjo fillon të luajë një rol të dukshëm kur leximet e thërrmijave janë më shumë se 50. Gjithashtu është e dukshme se rritja e numrit të SSC nga 6 e sipër jep përfitim ndjeshëm më të vogël të performancës.
Shënim 1: pasi rezultatet e testimit janë mjaft të ndryshueshme (shih më poshtë), janë kryer 3 rishtas dhe vlerat e marra janë mësuar.
Shënim 2: Rritja e performancës nga konfigurimi për aksese të rastësishme është e njëjtë, ndonëse vetë aksesi është pak më i ngadalshëm.
Megjithatë, është e nevojshme të saktësohet se ndryshe nga rasti me HBase, kjo përshpejtim nuk është gjithmonë falas. Këtu ne më tepër "çlirojmë" mundësitë e CPU për të kryer punën, në vend që të ngecim në bllokime.
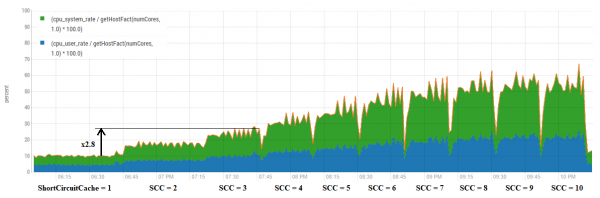
Këtu mund të vërehet se, në përgjithësi, rritja e numrit të këshillave jep një rritje proporcionalisht të përdorimit të CPU. Megjithatë, ka disa kombinacione më fitimprurëse.
Për shembull, le të shikojmë më afër konfigurimin SSC = 3. Rritja e performancës në këtë gamë është rreth 3.3 herë. Më poshtë janë rezultatet e të tre ekzekutimeve të veçanta.
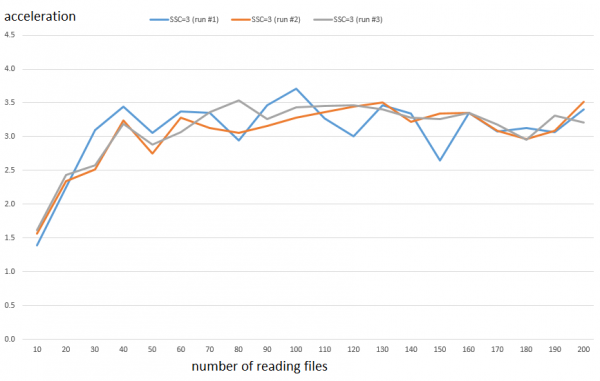
Ndërsa konsumimi i CPU rritet rreth 2.8 herë. Diferenca nuk është shumë e madhe, por Greta e vogël tashmë është e lumtur dhe ndoshta do të ketë kohë për të vizituar shkollën dhe mësimet.
Prandaj, kjo do të ketë një efekt pozitiv për çdo mjet që përdor qasje masive në HDFS (për shembull Spark etj.), me kusht që kodi aplikativ të jetë i lehtë (dmth. bllokimi është pikërisht në anën e klientit HDFS) dhe ka kapacitete të lira të CPU. Për të verifikuar, le të testojmë se çfarë efekti jep kombinimi i optimizimit BlockCache dhe tuningut SSC për leximin nga HBase.
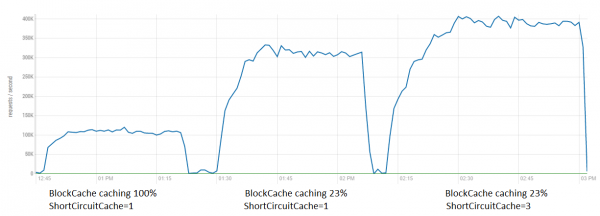
Këtu shihet se në këto kushte efekti nuk është aq i madh sa në testet e rafinuara (leximi pa asnjë përpunim), megjithatë është plotësisht e mundur të nxjerrim 80K shtesë këtu. Së bashku, të dy optimizimet japin një përshpejtim deri në 4 herë.
Po ashtu, për këtë optimizim u realizua një PR , i cili u bashkua dhe kjo funksionalitet do të jetë i disponueshëm në lëshimet e ardhshme.
Dhe përfundimisht, ishte interesante të krahasojmë performancën e leximit të një baze të dhënash wide-column si Cassandra dhe HBase.
Për këtë, u ekzekutuan shembuj të utilitarit standard të testimit të ngarkesës YCSB nga dy host-e (së bashku 800 threads). Në anën e serverit — 4 instanca të RegionServer dhe Cassandra në 4 host-e (jo ato ku janë ekzekutuar klientët, për të shmangur ndikimin e tyre). Leximet ishin nga tabela me përmasa:
HBase — 300 GB në HDFS (100 GB të dhëna të pastra)
Cassandra — 250 GB (faktori i riprodhimit = 3)
Pra, volumet ishin përafërsisht të njëjta (në HBase pak më shumë).
Parametrat e HBase:
dfs.client.short.circuit.num = 5 (optimizimi i klientit HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 — kjo do të thotë se patchi do të fillojë të funksionojë pas 30 dëbimeve (~5 minuta)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — volumi i synuar i caching dhe dëbimeve
Logët e YCSB u përpunuan dhe u përmbledhën në grafikë Excel:
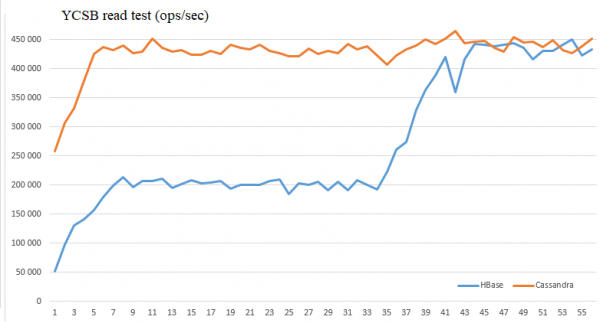
Si e duket, të dhënat e optimizimit lejojnë të barazojmë performancën e këtyre DB-ve në këto kushte dhe të arrijmë 450 mijë lexime në sekondë.
Shpresojmë që kjo informacion mund t'i ndihmojë dikujt në luftën interesante për performancën.
Burimi: habr.com
