

Hyrje
Ka ardhur koha për të blerë një sistem ruajtjeje. Cilin të zgjedh, kë të dëgjoj? Vendi A tregon për vendorin B, dhe pastaj ka integruesin C, i cili flet të kundërtën dhe rekomandon vendorin D. Në një situatë të tillë, edhe një arkitekt i përvojës në sistemet e ruajtjes do të shpërqendrohet, veçanërisht me të gjithë vendorët e rinj dhe me modat e sotme si SDS dhe konvergjenca e hiper.
Tani, si të kuptojmë gjithçka këtë dhe të mos përfundojmë si budallenj? Ne ( Anton Zhbankov dhe Evgeny Elizarov) do të përpiqemi ta shpjegojmë këtë në gjuhën ruse në mënyrë të qartë.
Artikulli në një farë mase është një ripërsëritje, dhe në fakt është një shtrirje e “” në lidhje me zgjedhjen e sistemeve të ruajtjes së të dhënave dhe shqyrtimin e teknologjive të ruajtjes. Ne do të shqyrtojmë shkurtimisht teorinë e përgjithshme, por rekomandojmë të shikoni edhe artikullin e përmendur.
Pse
Shpesh mund të vërehet situata kur një person i ri hyn në forum ose në një chat të specializuar, siç është Storage Discussions, dhe bën një pyetje: “Më ofrohen dy mundësi për sistemet e ruajtjes — ABC SuperStorage S600 dhe XYZ HyperOcean 666v4, çfarë rekomandoni”?
Dhe fillon matja e cilit ka cilësi dhe veçori të realizimit të frikshme dhe të paqarta, të cilat për një person të papërgatitur janë si dokumentet kineze.
Pra, pyetje kryesore dhe e para që duhet t'i bëni vetes shumë para se të filloni të krahasoni specifikimet në ofertat komerciale — PSE? Pse e nevojitet ky sistem ruajtjeje?
Përgjigja do të jetë befasuese, dhe shumë në stilin e Tony Robbins — për të ruajtur të dhënat. Faleminderit, kapiten! Megjithatë, ndonjëherë ne thellohemi aq shumë në krahasimin e detajeve, sa harrojmë përse e bëjmë gjithë këtë.
Pra, detyra e sistemit të ruajtjes së të dhënave është ruajtja dhe ofrimi i qasjes në TË DHËNAT me një performancë të caktuar. Nga të dhënat do të fillojmë.
Të dhënat
Lloji i të dhënave
Çfarë të dhënash planifikojmë të ruajmë? Është një pyetje shumë e rëndësishme që mund të përjashtojë shumë sisteme ruajtjeje nga shqyrtimi. Për shembull, planifikohet ruajtja e videove dhe fotografive. Menjëherë mund të përjashtohen sistemet që janë të dedikuara për aksesin e rastësishëm me blloqe të vogla, ose sistemet me karakteristika të patentuara për kompresion / deduplication. Këto mund të jenë sisteme të shkëlqyera, nuk duam të themi ndonjë gjë të keqe për to. Por në këtë rast, pikat e tyre të forta do të bëhen pika të dobëta (video dhe foto nuk kompresohen) ose do të rrisin ndjeshëm koston e sistemit.
Dhe e kundërta, nëse përdorimi i synuar është një DB tranzaksional e ngarkuar, atëherë sistemet e shkëlqyera të rrjedhës për multimedia, të cilat mund të japin gigabajt në sekondë, do të ishin një zgjedhje e keqe.
Vëllimi i të dhënave
Sa të dhëna planifikojmë të ruajmë? Sasia gjithmonë kthehet në cilësi, këtë nuk duhet ta harrojmë kurrë, veçanërisht në kohën tonë të rritjes eksponenciale të vëllimit të të dhënave. Sistemet e klasës petabajt tani nuk janë të pazakonta, por sa më shumë petabajt të ketë, aq më specifike bëhet sistemi, aq më pak funksionaliteti i zakonshëm i sistemeve me akses të rastësishëm të vogël e të mesëm do të jetë i disponueshëm. Kjo ndodh sepse vetëm tabelat e statistikave të aksesit për blloqet bëhen më të mëdha se vëllimi i disponueshëm të memories të përkohshme në kontrollet. Pavarësisht nga kompresimi / tieringu. Le të supozojmë se duam të kalojmë në një algoritëm kompresimi më të fuqishëm dhe të kompresojmë 20 petabajt të dhënash. Sa do të zgjasë: gjashtë muaj, një vit?
Në anën tjetër, pse të ndërtojmë një sistem të madh, nëse na nevojitet të ruajmë dhe të procesojmë vetëm 500 GB të dhënash? Pothuajse 500. SSD-të e zakonshme (me DWPD të ulët) të këtij vëllimi kushtojnë vetëm pak. Pse të ndërtojmë një fabrikë Fiber Channel dhe të blejmë një sistem ruajtjeje të jashtëm të klasës së lartë që kushton si një urë prej hekuri?
Cili përqindje e përgjithshme e të dhënave të nxehta? Sa e pabarabartë është ngarkesa sipas sasisë së të dhënave? Këtu teknologjia e ruajtjes me shumë nivele ose Flash Cache mund të ndihmojë shumë, nëse sasia e të dhënave të nxehta është shumë e vogël në krahasim me totalin. Ose përkundrazi, në rast të një ngarkese të barabartë në të gjithë volumet, e cila është e zakonshme në sistemet e transmetimit (monitorimi video, disa sisteme analitikë) teknologjitë e tilla nuk do të ofrojnë asgjë, dhe vetëm do të rrisin kostot / kompleksitetin e sistemit.
IS
Anës tjetër e të dhënave është një sistem informatik që përdor këto të dhëna. IS ka një grup kërkesash që trashëgohen nga të dhënat. Më shumë rreth IS shih te “Dizajni i Qendrës së Dhënave të Virtualizuara”.
Kërkesat për qëndrueshmëri / disponueshmëri
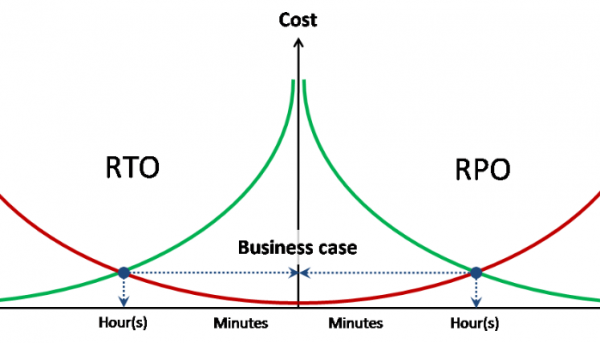
Kërkesat për qëndrueshmëri / disponueshmëri të të dhënave trashëgohen nga IS që i përdor ato dhe shprehen në tre numra — RPO, RTO, disponueshmërinë.
Disponueshmëria — pjesa për një periudhë të caktuar kohore, gjatë së cilës të dhënat janë të disponueshme për t'u përdorur. Kjo zakonisht shprehet në numrin e 9. Për shembull, dy nënat në vit do të thotë që disponueshmëria është 99%, ose ndryshe lejohet 95 orë mungesë në vit. Treshe 9 — 9.5 orë në vit.
RPO / RTO — këto janë tregues jo të përmbledhura, por për çdo incident (fatkeqësi), ndryshe nga disponueshmëria.
RPO — sasia e të dhënave të humbura gjatë një fatkeqësie (në orë). Për shembull, nëse bëhet kopjim rezervë çdo ditë, atëherë RPO = 24 orë. P.sh., në rast të një fatkeqësie dhe humbjes totale të SHT, mund të humben të dhëna deri në 24 orë (që prej kopjimit të rezervës). Bazuar në RPO-në e caktuar për IS, për shembull, do të hartohet një rregullore për kopjimet rezervë. Gjithashtu, nga RPO, mund të kuptohet sa e nevojshme është replikimi i të dhënave në mënyrë sinkrone / asinkrone.
RTO — koha e rikuperimit të shërbimit (qasje në të dhëna) pas një fatkeqësie. Bazuar në vlerën e caktuar RTO mund të kuptojmë nëse nevojitet një metrokaster, ose mjafton replikimi njëanësh. A është e nevojshme një SHT e klasës hi-end me shumë kontrollues — gjithashtu.
Kërkesat për performancë
Megjithëse kjo është një pyetje mjaft e qartë, me të ndodhin shumica e vështirësive. Në varësi të faktit nëse ju tashmë keni ndonjë infrastrukturë apo jo dhe se si do të ndërtohen rrugët për mbledhjen e statistikave të nevojshme.
Nëse keni një sistem të ruajtes së të dhënave dhe jeni duke kërkuar një zëvendësues ose dëshironi të blini një tjetër për të zgjeruar kapacitetin. Këtu është e thjeshtë. Ju e kuptoni se cilat shërbime keni aktualisht dhe cilat planifikoni të implementoni në të ardhmen e afërt. Duke u mbështetur në shërbimet aktuale, keni mundësinë të mblidhni të dhëna për performancën. Duhet të përcaktoni numrin aktual të IOPS dhe vonesat e tani - si janë këto tregues dhe a mjaftojnë për nevojat tuaja? Këtë e bëni si në sistemin e ruajtes së të dhënave, ashtu edhe nga ana e hosteve që lidhen me të.
Por, duhet të shikoni jo vetëm ngarkesën aktuale, por për një periudhë (më mirë një muaj). Shihni se cilat janë pikat maksimale në orët e ditës, çfarë ngarkese krijon kopjimi rezervë, etj. Nëse sistemi juaj i ruajtes së të dhënave ose softueri i tij nuk ju jep një gamë të plotë të këtyre të dhënave, mund të përdorni RRDtool falas, që di të punojë me shumicën e sistemeve më të njohura të ruajtes së të dhënave dhe switch-eve dhe mund të ofrojë statistika të detajuara për performancën. Gjithashtu, është e rëndësishme të monitoroni ngarkesën edhe në hostet që punojnë me këtë sistem ruajtjeje, për makina virtuale specifike ose çfarëdo që po punon në këtë host.
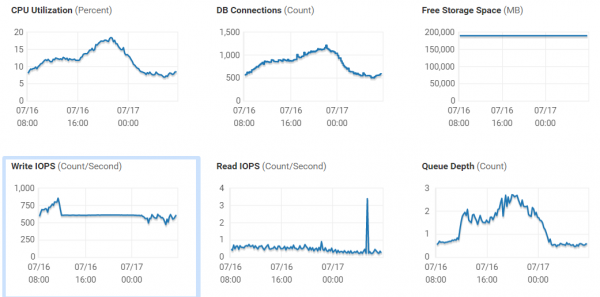
Merita veçanërisht e përmendshme është se nëse vonesat në volum dhe datastorin që ndodhet në këtë volum dallohen ndjeshëm - duhet të vini re rrjetin tuaj SAN, ka mundësi të lartë që ka probleme, dhe para se të blini një sistem të ri, duhet të merret me këtë çështje, pasi ka një mundësi shumë të madhe për të rritur performancën e sistemit aktual.
Ju po ndërtoni infrastrukturë nga e para, ose po blini një sistem për ndonjë shërbim të ri, për të cilin nuk keni njohuri për ngarkesat. Këtu ka disa mundësi: flisni me kolegët në burimet përkatëse, për të përpiquar të merrni informacion dhe të parashikoni ngarkesën, kontaktoni me një integrues, i cili ka përvojë në implementimin e shërbimeve të tilla dhe që mund të llogarisë ngarkesën për ju. Dhe opsioni i tretë (zakonisht më i komplikuari, veçanërisht nëse kjo përfshin aplikacione të krijuara vetë ose të pazakonta) është të përpiqeni të zbuloni kërkesat për performancë nga zhvilluesit e sistemit.
Dhe, vëmendje, opsioni më i saktë nga pikëpamja e përdorimit praktik është një pilot në pajisjet aktuale, ose pajisje e siguruar për testim nga ofruesi / integratori.
Kërkesat e veçanta
Kërkesat e veçanta janë gjithçka që nuk bie nën kërkesat për performancën, qëndrueshmërinë dhe funksionalitetin në përpunimin dhe ofrimin e të dhënave.
Një nga kërkesat më të thjeshta për sistemin e ruajtjes së të dhënave mund të quhet "media informacioni të shkëputshme". Menjëherë bëhet e qartë se ky sistem ruajtjeje duhet të përfshijë një bibliotekë kasetash ose thjesht një streamer, në të cilin ruhet një kopje rezervë. Pas kësaj, një person i trajnuar posaçërisht nënshkruan kasetën dhe krenarisht e çon atë në një shtëpi të sigurisë.
Një shembull tjetër i kërkesës së veçantë është përfundimi i mbrojtur nga goditjet.
Ku
Pjesa tjetër e rëndësishme në zgjedhjen e këtij ose atij sistemi të ruajtjes së të dhënave është informacioni se KU do të vendoset ky sistem. Duke filluar nga gjeografia ose kushtet klimatike, deri te stafi.
Klienti
Për kë është planifikuar ky sistem i ruajtjes së të dhënave? Pyetja ka disa baza të tjera:
Klienti shtetëror / komercial.
Klienti komercial nuk ka asnjë kufizim dhe nuk ka detyrim të organizojë tenderë, përveç rregullave të tij të brendshme.
Klienti shtetëror është një tjetër rast. Ligji 44-FZ dhe lehtësitë e tjera me tenderët dhe specifikimet teknike që mund të kontestohen.
Klienti nën sanksione
Këtu pyetja është shumë e thjeshtë - zgjedhja kufizohet vetëm në ofertat e disponueshme për këtë klient.
Rregullat e brendshme / ofruesit e lejuar për blerje / modelet
Pyetja gjithashtu është jashtëzakonisht e thjeshtë, por duhet mbajtur mend.
Ku fizikisht
Në këtë pjesë shqyrtojmë të gjitha çështjet me gjeografinë, kanalet e komunikimit dhe mikroklimën në ambientin e vendosjes.
Stafi
Kush do të punojë me këtë sistem të ruajtjes së të dhënave? Kjo është po aq e rëndësishme sa ajo që sistemi i ruajtjes së të dhënave mund të bëjë.
Pavarësisht se sa e perspektivshme, e mrekullueshme dhe e shkëlqyer është një sistem ruajtjeje të dhënash nga ofruesi A, nuk ka shumë kuptim ta vendosësh atë nëse stafi di vetëm të punojë me ofruesin B, dhe nuk planifikohet blerja e mëtejshme dhe bashkëpunimi i vazhdueshëm me A.
Dhe sigurisht, ana tjetër e çështjes është sa i qasshëm është stafi i kualifikuar në këtë vendgjiografi, si brenda kompanisë ashtu edhe në tregun potencial të punës. Për rajonet, ka një rëndësi të madhe zgjedhja e STH-ve me ndërfaqe të thjeshta ose me mundësi menaxhimi të centralizuar në distancë. Ndryshe, në një moment, mund të bëhet mjaft e dhimbshme. Interneti është plot histori se si një punonjës i ri, një student i djeshëm, ka konfiguruar diçka që e ka bllokuar tërë kompaninë.
Mjedisi
Po ashtu, një çështje mjaft e rëndësishme është në cilin ambient do të punojë ky STH.
- Si është furnizimi me energji / ftohja?
- Cila është lidhja?
- Ku do të montohen?
- Etj.
Shpesh këto pyetje merren si të kuptueshme dhe nuk shqyrtohen shumë, por ndonjëherë ato mund të përmbysin gjithçka në mënyrën e duhur.
Çfarë?
Furnizuesi
Sot (mes viti 2019), tregu rus i STH-ve mund të ndahet në pesë kategori të kushtëzuara:
- Divizioni më i lartë — kompani të njohura me një linjë të gjerë nga raftet më të thjeshta të disqeve deri te hi-end (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Divizioni i dytë — kompani me një linjë të kufizuar, lojtarë të nişëzuar, furnizues të rëndësishëm të SDS ose start-up-et prometheiane (Fujitsu, Datacore, Infinidat, Huawei, Pure etj.)
- Divizioni i tretë — zgjidhje të nişëzuara në rangun low end, SDS të lira, produkte të përbashkëta mbi ceph dhe projekte të tjera të hapura (Infortrend, Starwind etj.)
- Segmenti SOHO — STH të vogla dhe jashtëzakonisht të vogla në nivelin e shtëpisë / zyrës së vogël (Synology, QNAP etj.)
- STH të importuara — përfshijnë si pajisjet e divizionit të parë me etiketa të ripara, ashtu edhe përfaqësues të rrallë të divizionit të dytë (RAIDIX, do t'u japim atyre një bonus të dytë), por në tërësi është divizioni i tretë (Aerodisk, Baum, Depo etj.)
Ndarja është mjaft e kushtëzuar dhe nuk do të thotë aspak se segmenti i tretë ose SOHO është i dobët dhe nuk mund të përdoret. Në projekte specifike me një grup të qartë të të dhënave dhe profilin e ngarkesës, ata mund të funksionojnë shumë mirë, duke tejkaluar edhe divizionin e parë në raportin çmim / cilësi. Është e rëndësishme fillimisht të vendosni objektivat, perspektivat e rritjes, funksionalitetin e kërkuar — dhe atëherë Synology do t'ju shërbejë besnikërisht, duke bërë që flokët tuaj të bëhen të butë dhe të fryra.
Një nga faktorët e rëndësishëm në përzgjedhjen e ofruesit është ambienti aktual. Sa dhe çfarë SĸD (Sistemet e Ruajtjes së të Dhënave) keni, me cilat SĸD mund të punojnë inxhinierët. Ju nevojitet një ofrues tjetër, një pikë kontakti tjetër, do ta migroni gradualisht gjithë ngarkesën nga ofruesi A te ofruesi B?
Nuk duhet të krijoni entitete më shumë se sa e nevojshme.
iSCSI / FC / File
Në lidhje me protokollet e qasjes, nuk ka një mendim të njëtrajtshëm mes inxhinierëve, dhe debatet duken më shumë si diskurse teologjike sesa inxhinierike. Por në përgjithësi, mund të theksohen disa pika:
FCoE më shumë është i vdekur sesa i gjallë.
FC vs iSCSI. Një nga avantazhet kryesore të FC në 2019 ndaj SĸD IP, fabrika e dedikuar për qasje në të dhëna, anashkalon rrjetin e dedikuar IP. Nuk ka avantazhe globale të FC ndaj rrjeteve IP dhe mbi IP mund të ndërtohen SĸD të çdo niveli ngarkese, deri në sisteme për SGBD të rënda për ABS të një banke të madhe. Nga ana tjetër, vdekja e FC është parashikuar për disa vite, por gjithmonë ka diçka që e pengon. Sot, për shembull, disa lojtarë në tregun e SĸD po zhvillojnë aktivisht standardin NVMEoF. Nëse ai do të ndihmojë në ndarjen e fatit të FCoE — vetëm koha do ta tregojë.
Qasja në skedar po ashtu nuk është diçka që nuk meriton vëmendje. NFS / CIFS përformojnë shkëlqyeshëm në ambientet produktive dhe, me projektimin e duhur, nuk kanë më shumë ankesa se protokollet bllokuese.
Hibrid / All Flash Array
SĸD klasike janë të dy llojeve:
- AFA (All Flash Array) — sisteme të optimizuara për përdorimin e SSD.
- Hibrid — që lejojnë përdorimin e HDD dhe SSD ose kombinimin e tyre.
Dallimi kryesor është teknologjitë mbështetëse për efikasitetin e ruajtjes dhe nivelin maksimal të performancës (shifrat e larta IOPS dhe vonesat e ulëta). Të dy sistemet (në shumicën e modeleve të tyre, përveç segmenteve low-end) mund të funksionojnë si pajisje blloku, ashtu edhe si skedarë. Nga niveli i sistemit varet gjithashtu funksionaliteti i mbështetur, dhe për modelet më të ulëta, ai shpesh herë është reduktuar në nivelin minimal. Kjo është diçka për të cilën duhet të keni parasysh kur studioni karakteristikat e një modeli të caktuar, dhe jo thjesht mundësitë e gjithë linjës në përgjithësi. Sigurisht, nga niveli i sistemit varet gjithashtu karakteristikat e tij teknike, si procesori, kapaciteti i memories, cache, numri dhe llojet e porteve etj. Nga ana e menaxhimit, AFA dallon nga sistemet hibride (disk) vetëm në çështjet e realizimit të mekanizmave të punës me SSD, dhe madje nëse e përdorni SSD në një sistem hibrid, kjo nuk do të thotë se do të arrini një nivel performance në nivelin e sistemit AFA. Në shumicën e rasteve, mekanizmat inline për ruajtje efikase në sistemet hibride janë të çaktivizuar, dhe aktivizimi i tyre çon në humbje të performancës.
Sistemet e specializuara të ruajtjes
Përveç sistemeve të ruajtjes së përgjithshme, të orientuara kryesisht për përpunimin e të dhënave në kohë reale, ekzistojnë sisteme të specializuara të ruajtjes me parime kyçe, të ndryshme nga ato të zakonshmet (vonesa e ulët, shumë IOPS):
Media.
Këto sisteme janë të destinuara për ruajtjen dhe përpunimin e skedarëve mediatikë, të cilët karakterizohen nga një madhësi e madhe. Përkatësisht, vonesa bëhet praktikisht e parëndësishme, ndërsa fokusimi kalon në aftësinë për të dërguar dhe pranuar të dhëna me një gjerësi të madhe të kanalit në shumë rrjedha paralele.
Sistemet e ruajtjes së deduplikimit për kopje rezervë.
Duke pasur parasysh se kopjet rezervë zakonisht dallohen nga njëra-tjetra (kopja mesatare rezervë ndryshon nga ajo e djeshme në 1-2%), ky klas i sistemeve paketon shumë efektivisht të dhënat që ruhen në një numër të vogël fizik të mbajtësve. Për shembull, në disa raste, koeficientët e kompresimit të të dhënave mund të arrijnë 200 ndaj 1.
Sistemet e ruajtjes objektive.
Në këto SHT nuk ka volume me akses bllokues dhe ndarje skedarësh si zakonisht, por më shumë ngjajnë me një bazë të madhe të dhënash. Aksesi në një objekt të ruajtur në një sistem të tillë bëhet përmes një identifikatori unik, ose përmes metadatat (p.sh. të gjitha objektet në formatin JPEG, me datë krijimi midis XX-XX-XXXX dhe YY-YY-YYYY).
Sistemet e përputhshmërisë.
Nuk janë aq të zakonshme në Rusi sot, por duhet t'i përmendim. Qëllimi i këtyre SHT-ve është ruajtja e garantuar e të dhënave për të përmbushur politikat e sigurisë ose kërkesat e rregullatorëve. Në disa sisteme (p.sh. EMC Centera) është realizuar funksioni i ndalimit të fshirjes së të dhënave - sa herë që çelësi kthehet dhe sistemi kalon në këtë mod, as administratorët, as askush tjetër fizikisht nuk mund të fshijnë të dhënat e regjistruara tashmë.
Teknologjitë e markës
Flash cache
Flash Cache është termi i përgjithshëm për të gjitha teknologjitë e markës që përdorin memorjen flash si një cache të nivelit të dytë. Kur përdoret Flash Cache, SHT zakonisht llogaritet për të përballuar ngarkesën e vendosur nga diskët magnetikë, ndërsa ngarkesa pike e mbështet nga cache.
Në këtë rast është e nevojshme të kuptohet profili i ngarkesës dhe shkalla e lokalizimit të kërkesave për blloqet e ruajtjes. Flash cache është teknologji për ngarkesa me lokalizim të lartë të kërkesave, dhe thuajse nuk aplikohet për volume të ngarkuar njëlloj (si për shembull në sistemet analitike).
Në treg janë për të dy implementimet e Flash Cache:
- Read Only. Në këtë rast, cache përdoret vetëm për të dhëna në lexim, ndërsa shkrimi ndodh menjëherë në disqe. Disa prodhues, si p.sh. NetApp, besojnë se shkrimi në SHT-të e tyre ndodh optimalisht dhe cache nuk ndihmon në aspak.
- Read/Write. Jo vetëm leximet por edhe shkrimet e cache-ohen, duke mundësuar buferimin e fluksit dhe uljen e ndikimit të RAID Penalty, dhe si pasojë rrit performancën totale për SHT-të me mekanizma shkrimi jo aq optimal.
Tiering
Ruajtja me shumë nivele (tiering) është teknologjia që bashkon në një grup disqesh nivele me performancë të ndryshme, si p.sh. SSD dhe HDD. Në rastin e një shpërndarjeje të theksuar të qasjes në blloqet e të dhënave, sistemi do të jetë në gjendje të balancojë automatikisht blloqet e të dhënave, duke transferuar ato të ngarkuara në nivele me performancë të lartë, dhe ato të ftohta, përkundrazi, në nivele më të ngadalta.
Sistemet hibride të klasës së ulët dhe mesme përdorin ruajtje në nivele me lëvizjen e të dhënave midis niveleve sipas një orari. Në këtë rast, madhësia e bllokut të ruajtjes në nivele në modelet më të mira është 256 MB. Këto karakteristika nuk lejojnë që teknologjia e ruajtjes në nivele të konsiderohet teknologji për të rritur performancën, siç gabimisht mendon shumë. Ruajtja në nivele në sistemet e klasës së ulët dhe mesme është një teknologji për optimizimin e kostos së ruajtjes për sistemet me ngarkesa të dukshme jo të barabarta.
Snapshot
Pavar se sa do të flasim për besueshmërinë e sistemit të ruajtjes, ekzistojnë shumë mundësi për të humbur të dhëna, të pa lidhura me problemet harduerike. Këto mund të jenë viruse, hakerë ose çdo fshirje/mbetje të paqëllimshme të të dhënave. Për këtë arsye, kopjimi i të dhënave produktive është një pjesë e pandashme e punës së inxhinierit.
Snapsoti është një imazh i volumit në një moment të caktuar. Gjatë punës me shumicën e sistemeve, si virtualizimi, Baza e të Dhënave, etj., na nevojitet të krijojmë një imazh të tillë nga i cili do të kopjojmë të dhënat në një kopje rezervë, ndërkohë që sistemet tona do të mund të vazhdojnë të punojnë normalisht me këtë volum. Por duhet të kujtojmë - jo të gjitha snapsotet janë të njëjta në përdorim. Furnizues të ndryshëm kanë qasje të ndryshme lidhur me krijimin e snapsoteve, të lidhura me arkitekturën e tyre.
CoW (Copy-On-Write). Kur përpiqemi të shkruajmë një bllok të dhënash, përmbajtja e tij origjinale kopjohet në një zonë të veçantë, pas së cilës shkrimi kalon normalisht. Kështu parandalojmë dëmtimin e të dhënave brenda snapsotit. Natyrisht, të gjitha këto "manipulime parazite" me të dhënat shkaktojnë ngarkesë shtesë në sistemin e ruajtjes dhe për këtë arsye furnizuesit me implementime të tilla nuk rekomandojnë përdorimin e më shumë se dhjetë snapsoteve, dhe në volumin me ngarkesë të lartë, të mos i përdorin fare.
RoW (Redirect-on-Write). Në këtë rast, volumi origjinal ngjitet natyrshëm, dhe kur përpiqet të shkruajë një bllok të dhënash, sistemi i ruajtjes shkruan të dhënat në një zonë të veçantë në hapësirën e lirë, duke ndryshuar lokacionin e këtij blloku në tabelën e metadatas. Kjo lejon reduktimin e numrit të operacioneve të ripërsëritjes, çka në përfundim e neutralizon rënien e performancës dhe heq kufizimet mbi snapsotet dhe numrin e tyre.
Snapsotet gjithashtu ndahen në dy tipe në lidhje me aplikacionet:
Application consistent. Në momentin e krijimit të snapsotit, sistemi i ruajtjes aktivizon agjentin në sistemin operativ të përdoruesit, i cili detyron që të kesh burimet e diskut të shkarkuara nga memorja në disk dhe e detyron aplikacionin ta bëjë këtë. Në këtë rast, kur rikuperohet nga snapsoti, të dhënat do të jenë të qëndrueshme.
Crash consistentNë këtë rast, asgjë e tillë nuk ndodh dhe snapshot-i krijohet ashtu siç është. Në rast të rikthimit nga një snapshot të tillë, pamja është identike sikur të ishte ndalur papritur energjia dhe është e mundur një humbje e caktuar të të dhënave, të cilat ishin ngulur në cache dhe nuk arritën kurrë në disk. Snapshot-et e tilla janë më të lehta në zbatim dhe nuk shkaktojnë rënie të performancës në aplikacione, por janë më pak të besueshme.
Pse nevojiten snapshot-et në sistemet e ruajtjes së të dhënave?
- Backup-i pa agjent direkt nga SÇD
- Krijimi i mjediseve testuese mbi të dhëna reale
- Në rastin e SÇD-ve të skedarëve, mund të përdoret për të krijuar mjedise VDI duke përdorur snapshot-et e SÇD-së në vend të hipervizorit
- Sigurimi i RPO-ve të ulëta duke krijuar snapshot-e në një program me një frekuencë shumë më të lartë se frekuenca e backup-it
Kloni
Klonimi i volumit funksionon sipas një principi analog me snapshot-et, por shërben jo thjesht për të lexuar të dhënat, por për të punuar plotësisht me to. Ne kemi mundësinë të marrim një kopje të saktë të volumit tonë, me të gjitha të dhënat e tij, pa krijuar një kopje fizike, çka do të ndihmojë në ruajtjen e hapësirës. Zakonisht, klonimi i volumeve përdoret ose në Test & Dev ose nëse dëshironi të verifikoni funksionimin e disa përditësimeve në sistemin tuaj të informacionit. Klonimi do të lejojë që kjo të bëhet maksimalisht shpejt dhe ekonomikisht në aspektin e burimeve diskore, pasi do të shkruhen vetëm blloqet e dhënave të ndryshuara.
Replikimi / regjistrimi
Replikimi është një mekanizëm për krijimin e një kopje të të dhënave në një SÇD tjetër fizike. Zakonisht ekziston një teknologji markë për çdo furnizues, e cila funksionon vetëm brenda linjës së tij të produkteve. Por gjithashtu ka zgjidhje të jashtme, përfshirë ato që punojnë në nivelin e hipervizorit, si për shembull VMware vSphere Replikimi.
Funksionaliteti i teknologjive të markës dhe lehtësia e përdorimit të tyre zakonisht janë shumë superiore ndaj atyre universale, por janë jo të aplikueshme kur, për shembull, nevojitet të bëhet një replikë nga NetApp në HP MSA.
Replikimi ndahet në dy nënkatësh:
Sinkron. Në rastin e replikimit sinkron, operacioni i shkruar transmetohet menjëherë në sistemin e dytë të ruajtjes dhe nuk konfirmohet deri sa sistemi i largët të konfirmojë. Kjo rrit vonesën e aksesit, por na jep një kopje të saktë refleksive të të dhënave. Kjo do të thotë që RPO = 0 në rast të humbjes së sistemit kryesor të ruajtjes.
Asinkron. Operacionet e shkruara kryhen vetëm në sistemin kryesor të ruajtjes dhe konfirmohen menjëherë, duke u grumbulluar në një tufë për transferim në sistemin e largët të ruajtjes. Ky lloj replikimi është i aplikueshëm për të dhëna më pak të vlefshme, ose për kanale me kapacitet të ulët ose me vonesa të larta (karakteristike për distanca mbi 100 km). Prandaj, RPO = frekuenca e dërgimit të tufave.
Shpesh, së bashku me replikimin ekziston një mekanizëm të regjistrimit të operacioneve diskore. Në këtë rast, rezervuar një zonë të veçantë për regjistrim dhe ruhen operacionet e shkruara në një thellësi të caktuar në kohë, ose të kufizuara në volumin e regjistrit. Për disa teknologji markë, siç është EMC RecoverPoint, ekziston integrimi me softuerin sistemor, i cili lejon lidhjen e shënimeve të caktuara me regjistrin. Falë kësaj, është e mundur që të rikthehet gjendja e volumit (ose të krijohet një kopje) jo thjesht në 23 Prill në orën 11:59:13, por në momentin që i paraprinte “DROP ALL TABLES; COMMIT”.
Metro cluster
Metro cluster është një teknologji që lejon krijimin e një replikimi sinkron dykahësor midis dy sistemeve të ruajtjes në një mënyrë që nga jasht duket si një sistem i vetëm i ruajtjes. Përdoret për të krijuar klasterë me degë gjeografikisht të shpërndara në distanca metro (më pak se 100 km).
Me një shembull të përdorimit në ambientin e virtualizimit, metroklusteri lejon krijimin e një datastori me makinat virtuale, të aksesueshme për shkrim menjëherë nga dy qendra të të dhënave. Në këtë rast, krijohet një klaster në nivelin e hipervizorëve, i përbërë nga hostname në qendra të ndryshme fizike të të dhënave, të lidhura me këtë datastor. Kjo lejon
- Automatizimi i plotë i procesit të rikuperimit pas vdekjes së një nga qendravë të të dhënave. Pa ndihma të tjera, të gjitha VM-të që funksiononin në qendrën e të dhënave të vdekur do të rilidhen automatikisht në atë që ka mbetur. RTO = koha e pritjes së klasterit të aksesit të lartë (15 sekonda për VMware) + koha e ngarkimit të sistemit operativ dhe fillimit të shërbimeve.
- Shmangia e katastrofave. Nëse janë të planifikuara punime në energjinë elektrike në qendrën e të dhënave 1, atëherë ne paraprakisht, para fillimit të punimeve, kemi mundësinë të migrojmë të gjithë ngarkesën e rëndësishme në qendrën e të dhënave 2 në vazhdim.
Virtualizimi
Virtualizimi i SXYD-së është përdorimi teknik i volumeneve nga SXYD të tjera si disqe. Virtualizatori i SXYD-së mund të kalojë thjesht volumin e huaj tek konsumatori si të vetin, duke e pasqyruar në një SXYD tjetër, ose madje të krijojë RAID nga volumin e jashtëm.
Përfaqësuesit klasikë në klasën e virtualizimit të SXYD-së janë EMC VPLEX dhe IBM SVC. Natyrisht, SXYD me funksion virtualizimi — NetApp, Hitachi, IBM / Lenovo Storwize.
Pse mund të jetë e nevojshme?
- Rezervimi në nivelin e SXYD-së. Krijohet një pasqyrë midis volumeneve, ku një gjysmë mund të jetë në HP 3Par, ndërsa tjetra në NetApp. Dhe virtualizatori nga EMC.
- Migrimi i të dhënave me minimun downtime midis SXYD-ve të prodhuesve të ndryshëm. Supozoni që të dhënat duhet të migrohen nga një 3Par i vjetër, i cili do të hidhet, në një të re Dell. Në këtë rast, konsumatorët fiksohen nga 3Par, volumet kalojnë nën VPLEX dhe prezantohen sërish tek konsumatorët. Duke qenë se asnjë bit në volum nuk është ndryshuar, puna vazhdon. Në sfond, fillon procesi i pasqyrosjes së volumit në Dell-in e ri, dhe pas përfundimit pasqyra çahen dhe 3Par fiket.
- Organizimi i metrokasterëve.
Kompresimi / deduplicimi
Kompresimi dhe deduplicimi janë teknologjitë që ju lejojnë të kurseni hapësirë disk në SXYD-në tuaj. Duhet përmendur aq shpejt se jo të dhëna të gjitha janë të përshtatshme për kompresim dhe/ose deduplicim në princip, megjithatë disa lloje të dhënash përpunohen dhe deduplikohet më mirë, ndërsa të tjera — përkundrazi.
Kompresimi dhe deduplicimi janë dy lloje:
Inline — kompresimi dhe deduplikohet e blloqeve të dhënash ndodh para se të shkruhen këto të dhëna në disk. Kështu, sistemi llogarit vetëm hash-in e bllokut dhe e krahasohet me tabelën e blloqeve që tashmë ekzistojnë. Së pari, kjo kryhet më shpejt sesa thjesht shkruani në disk, së dyti, ne nuk shpenzojmë hapësirë të tepërt në disk.
Post — kur këto operacione kryhen tashmë mbi të dhënat e shkruara, të cilat ndodhen në disqe. Përkatësisht, të dhënat fillimisht shkruhen në disk, dhe vetëm më pas, llogaritet hash-i dhe ndodhi heqja e bllokëve të tepërt dhe çlirimi i burimeve të diskut.
Duhet thënë se shumica e ofruesve përdorin të dy llojet, çka lejon optimizimin e këtyre proceseve dhe për rrjedhojë rritjen e efikasitetit të tyre. Shumica e ofruesve të ruajtjes së dhënash kanë në dispozicion mjete që lejojnë analizimin e grupeve tuaja të dhënash. Këto mjete, punojnë sipas logjikës që është zbatuar edhe në ruajtjen e dhënave, ndaj niveli i vlerësimit të efikasitetit do të përputhet. Gjithashtu, nuk duhet harruar se shumë ofrues kanë programe garancie efikasiteti, që premtojnë se niveli nuk do të jetë më i ulët se ai i deklaruar për një (apo të gjitha) llojet e dhënave. Dhe nuk duhet injoruar ky program, pasi duke llogaritur sistemin sipas nevojave tuaja, duke marrë parasysh koeficientin e efikasitetit të sistemit të caktuar, mund të kurseni në volum. Gjithashtu duhet marrë parasysh se këto plane janë të dizajnuara për sistemet AFA, por duke blerë një volum më të vogël SSD sesa HDD në sistemet klasike, kjo do të mundësojë uljen e kostos, dhe nëse jo të arrijë koston e sistemit disk, atëherë shumë afër saj.
Modeli
Dhe këtu arrijmë te pyetja e saktë.
“Më ofrohen dy opsione për ruajtjen e dhënave — ABC SuperStorage S600 dhe XYZ HyperOcean 666v4, çfarë do të më këshillonit?”
Shndërrohet në “Më ofrohen dy opsione për ruajtjen e dhënave — ABC SuperStorage S600 dhe XYZ HyperOcean 666v4, çfarë do të më këshillonit?
Ngarkesa e targetuar janë makinat virtuale të përziera VMware me ciklet prodhim / testim / zhvillim. Testi = prodhimi. 150 TB për çdo njësisë me performancë maksimale 80,000 IOPS me bllok 8kb 50% qasje të rastësishme 80/20 lexim-shkruar. 300 TB për zhvillim, 50,000 IOPS është e mjaftueshme, 80 aksese rastësore, 80 shkruar.
Prodhimi supozohet në metrokluster RPO = 15 minuta RTO = 1 orë, zhvillimi në replikim asinkron RPO = 3 orë, testi në një lokacion.
Do të ketë 50TB të DB-së, do të ishte mirë për ta të kishte regjistrim.
Kemi serverë Dell kudo, magazinat e vjetra Hitachi, që po e kanë të vështirë, planifikojmë një rritje prej 50% të ngarkesës në volum dhe performancë.
Siç thonë, në një pyetje të formuluar mirë është 80% e përgjigjes.
Informacione shtesë
Çfarë duhet të shqyrtohet më tej sipas autorëve
Libra
- Oliefer dhe Olifer “Rrjetet kompjuterike”. Libri do t'ju ndihmojë të sistematizoni dhe ndoshta të kuptoni më mirë se si funksionon mjedisi i transmetimit të të dhënave për sistemet IP / Ethernet të ruajtjes.
- “EMC Informacioni për Ruajtjen dhe Menaxhimin”. Një libër i shkëlqyer mbi bazat e magazinimit, pse, si dhe përse.
Forumet dhe bisedat
Rekomandime të përgjithshme
Çmimet
Tani, sa i përket çmimeve - në përgjithësi çmimet e magazinave, nëse i hasim, zakonisht janë çmimi listë, nga i cili çdo klient merr zbritje individuale. Shuma e zbritjes formohet nga shumë parametra, kështu që të parashikosh se çfarë çmimi përfundimtar do të marrë pikërisht kompania juaj, pa pyetje për distributorin është thjesht e pamundur. Por kohët e fundit, modelet e ulta kanë filluar të shfaqen në dyqane kompjuterike normale, si, për shembull, ose . Në to mund të blini menjëherë sistemin që ju intereson me një çmim të fixuar, si çdo komponent kompjuterik.
Por dua të theksoj menjëherë se krahasimi i drejtpërdrejtë sipas TB/$ nuk është i saktë. Nëse qasemi nga kjo pikëpamje, zgjidhja më e lirë do të ishte një JBOD i thjeshtë + serveri, që nuk do të ofronte as fleksibilitetin, as besueshmërinë që ofron një magazinë e plotë me dy kontrolerë. Kjo nuk do të thotë se JBOD është diçka e keqe, thjesht duhet, përsëri, të kuptoni shumë qartë se si dhe për cilat qëllime do ta përdorni këtë zgjidhje. Shpesh dëgjohet se në JBOD nuk ka asgjë që mund të dështojë, pasi ka vetëm një blekplejn. Sidoqoftë, edhe blekplejnët ndonjëherë dështojnë. Çdo gjë dëmtohet herët a vonë.
Përveç kësaj
Krahasimi i sistemeve midis tyre duhet të bëhet jo vetëm sipas çmimit, ose jo vetëm sipas performancës, por sipas një kumpule të gjitha treguesve.
Bleni HDD vetëm nëse jeni të sigurt se ju nevojiten HDD. Për ngarkesa të ulta dhe lloje të dhënash të pa kompresuara, ndryshe, duhet të shikoni programet e garancisë së efikasitetit të ruajtjes në SSD, të cilat tani i ka shumica e ofruesve (dhe ato vërtet funksionojnë, madje edhe në Rusi), por këtu gjithçka varet nga aplikacionet dhe të dhënat që do të vendosen në këtë SAN.
Mos ndiqni koston e ulët. Ndonjëherë nën këtë fshihet shumë problematika, një nga të cilat Evgeniy Elizarov e përshkroi në artikujt e tij rreth . Dhe se, në fund të fundit, kjo kosto e ulët mund t'ju dalë juve kosto. Mos harroni — "i kurti paguan dy herë".
Burimi: habr.com
