

Shumë njerëz përballen me Elasticsearch. Por çfarë ndodh kur dëshiron të ruash log-e "në një masë të madhe" me ndihmën e tij? Ndonjëherë, si mund ta kalosh pa dhimbje dështimin e ndonjë qendre të të dhënave? Si duhet të jetë arkitektura dhe cilat janë pengesat që mund të hasësh?
Ne në Odnoklassniki vendosëm të zgjidhim çështjen e menaxhimit të log-eve me elasticsearch dhe tani po ndajmë me Habr përvojën tonë: për arkitekturën dhe pengesat.
Unë jam Pyotr Zaitsev, punoj si administrator sistemi në Odnoklassniki. Përpara se të isha administrator, kam punuar me Manticore Search, Sphinx Search, Elasticsearch. Ndoshta, nëse do të shfaqet ndonjë …search tjetër, do të punoj edhe me të. Gjithashtu, marr pjesë në disa projekte open-source në mënyrë vullnetarizmi.
Kur erdha në Odnoklassniki, thashë me guxim në intervistën e punës se di të punoj me Elasticsearch. Pasi e mësova dhe bëra disa detyra të thjeshta, më dhanë një detyrë të madhe për reformimin e sistemit të menaxhimit të log-eve që ekzistonte në atë kohë.
Kërkesat
Kërkesat për sistemin u formuluan si më poshtë:
- Si frontend duhej të përdorej Graylog. Sepse në kompani tashmë kishte përvojë me këtë produkt, programuesit dhe testuesit e dinin, ishte i njohur dhe i lehtë për t'u përdorur.
- Vëllimi i të dhënave: në mesatare 50-80 mijë mesazhe në sekondë, por nëse diçka thyhet, trafiku nuk është i kufizuar, mund të jetë 2-3 milion rreshta në sekondë.
- Pas diskutimit të kërkesave me klientët për shpejtësinë e përpunimit të kërkesave në kërkim, ne kuptuam se modeli tipik i përdorimit të këtij sistemi është: njerëzit kërkojnë log-et e aplikacionit të tyre për dy ditët e fundit dhe nuk duan të presin më shumë se një sekondë për rezultatin e kërkesës së formuluar.
- Adminët Insistuan që sistemi të ishte i lehtë për t'u shkallëzuar në rast nevoje, pa kërkuar prej tyre një kuptim të thellë se si ishte ndërtuar.
- Përveç kësaj, në Odnoklassniki ekziston një traditë e shkëlqyer teknike: çdo shërbim që nisim duhet të përballojë dështimin e qendrës së të dhënave (papritur, pa planifikim dhe në çdo kohë).
- Gjithashtu, përveç kësaj, ka një traditë të shkëlqyer teknike në Odnoklassniki: çdo shërbim që ne nisem duhet të përballojë dështimin e qendrës së të dhënave (papritur, pa plan dhe në çdo kohë).
Kërkesat më të fundit për realizimin e këtij projekti na kanë kushtuar më së shumti, për të cilën do të flas më në detaje.
Mjedisi
Ne punojmë në katër qendra të të dhënave, ndërsa nodet e Elasticsearch mund të vendosen vetëm në tri (për disa arsye joteknike).
Në këto katër qendra të të dhënave ndodhen rreth 18,000 burime të ndryshme të logëve — pajisje, kontejnerë, makina virtuale.
Një veçori e rëndësishme: nisja e klasterit ndodh në kontejnerë jo në makina fizike, por në . Konejnerëve u garantohet 2 bërthama, të ngjashme me 2.0Ghz v4 me mundësi për të shfrytëzuar bërthamën tjetër, në rast se ato janë të papunuara.
Me fjalë të tjera:
Topologjia
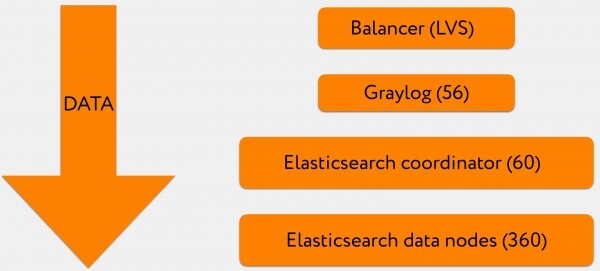
Pamja e përgjithshme e zgjidhjes më është dukur fillimisht si më poshtë:
- 3-4 VIP qëndrojnë pas A-record-it të domenit Graylog, kjo është adresa ku dërgohen logët.
- çdo VIP është një balancues LVS.
- Pas tij, logët kalojnë në një grumbull Graylog, disa të dhëna janë në formatin GELF, disa në formatin syslog.
- Pastaj, të gjitha këto shkruhen në mënyrë të madhe në një grumbull të koordinatoreve Elasticsearch.
- Dhe ata, nga ana e tyre, dërgojnë kërkesa për shkruanie dhe lexim te nodet përkatëse.
Terminologjia
Ndoshta, jo të gjithë janë të njohur me terminologjinë, prandaj do të doja të ndalesha pak mbi të.
Në Elasticsearch ka disa lloje nodash — master, coordinator, data node. Ka edhe dy lloje të tjera për transformime të ndryshme të logëve dhe lidhjen mes klastereve të ndryshme, por ne kemi përdorur vetëm ato të përmendura.
Master
Pingar çdo nod në klaster, mbështet hartën aktuale të klasterit dhe e shpërndan atë mes nodave, përpunon logjikën e ngjarjeve dhe merret me lloje të ndryshme të mirëmbajtjes në nivel klasteri.
Koordinatori
Kryen një detyrë të vetme: pranon kërkesat nga klientët për lexim ose shkruanie dhe organizon këtë trafik. Në rast se kërkesa është për shkruanie, është shumë e mundshme që ai të pyesë master-in se në cilin shard të indeksit përkatës ta vendosë atë dhe ta ridrejtojë kërkesën më tej.
Data node
Ruaj të dhënat, përpunon kërkesat e kërkimit që vijnë nga jashtë dhe operacione mbi shard-et e vendosura aty.
Graylog
Kjo është diçka si një përzierje Kibana me Logstash në ELK-stack. Graylog kombinon UI dhe procesin e përpunimit të skedarëve të logjeve. Nën kapak, në Graylog punojnë Kafka dhe Zookeeper, të cilat sigurojnë lidhshmërinë e Graylog si një klaster. Graylog mund të ruajë logjet (Kafka) për rastet kur Elasticsearch nuk është i arritshëm dhe të përsërisë kërkesat e dështuara për lexim dhe shkrim, duke grupuar dhe etiketuar logjet sipas rregullave të vendosura. Ashtu si Logstash, Graylog ka funksionalitetin për të modifikuar stringjet përpara se t'i shkruajë në Elasticsearch.
Për më tepër, në Graylog ka një zbulesë shërbimi të integruar, e cila lejon që, mbi bazën e një njësie të disponueshme Elasticsearch, të merret e gjithë karta e klasterit dhe ta filtrojë atë sipas një etikete të caktuar, duke e bërë të mundur dërgimin e kërkesave në konteinerë të caktuar.
Vishevisht kjo duket kështu:

Kjo është një screenshot nga një instancë specifike. Këtu ne ndërtojmë histogramin në bazë të kërkesës, duke shfaqur stringjet relevante.
Indeksi
Duke u kthyer në arkitekturën e sistemit, do të doja të ndalesha më në hollësi mbi se si ne ndërtuam modelin e indekseve, në mënyrë që gjithçka të funksionojë saktë.
Në skemën e përmendur më parë, ky është niveli më i ulët: Elasticsearch data nodes.
Indeksi është një ent virtual i madh, që përbëhet nga shardet e Elasticsearch. Çdo shard është asgjë tjetër, veçse një indeks Lucene. Dhe çdo indeks Lucene, nga ana e tij, përbëhet nga një ose më shumë segmente.
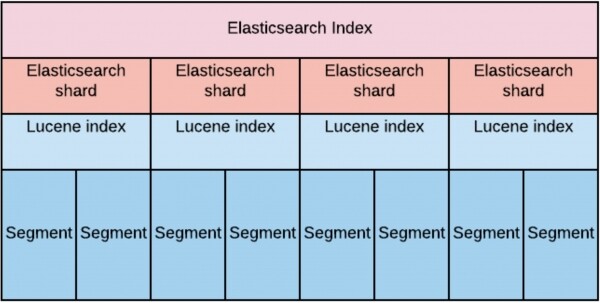
Gjatë projektimit, ne parashikuam se për të përmbushur kërkesën për shpejtësinë e leximit mbi një volum të madh të dhënash, na duheshin të ‘shpërndanim’ këto të dhëna në mënyrë të barabartë në data nodes.
Kjo rezultoi në faktin se numri i shardeve për indeks (me replikat) duhet të jetë strikt njësoj me numrin e data nodes. Së pari, për të siguruar një faktor replikimi të barabartë me dy (pra mund të humbasim gjysmën e klasterit). Dhe, së dyti, për të përpunuar kërkesat për lexim dhe shkrim, si minimalisht, në gjysmën e klasterit.
Koha e ruajtjes fillimisht u përcaktua si 30 ditë.
Shpërndarja e shardëve mund të paraqitet grafike kështu:
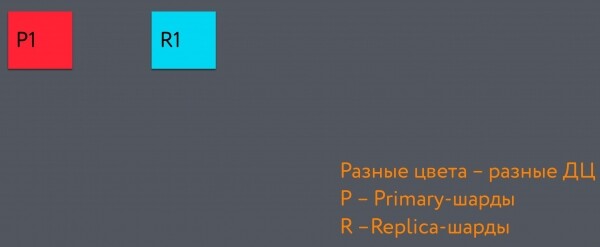
E gjithë drejtkëndëshi i errët është indeksi. Kuadrati i kuq në të majtë është primary shard, i pari në indeks. Ndërsa kuadrati blu është replica shard. Ato ndodhen në data-centra të ndryshëm.
Kur ne shtojmë një shard tjetër, ai shkon në qendrën e të dhënave të tretë. Dhe, në fund, ne marrim këtë strukturë, e cila siguron mundësinë e humbjes së DC pa humbje të konsistencës së të dhënave:
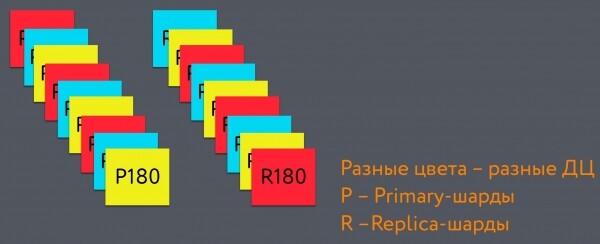
Rrotacioni i indekseve, pra krijimi i një indeksi të ri dhe fshirja e indeksit më të vjetër, e bëmë të barabartë me 48 orë (sipër bazës së përdorimit të indeksit: për 48 orët e fundit kërkohet më shpesh).
Ky interval rrotacioni i indekseve është i lidhur me arsyet e mëposhtme:
Kur në një nodë të dhënash vjen një kërkesë kërkimi, nga pikëpamja e performancës është më e favorshme kur pyetet një shard, nëse dimensioni i tij është i krahasueshëm me madhësinë e hips së nodës. Kjo lejon mbajtjen e pjesës "të nxehtë" të indeksit në hip dhe qasjen ndaj saj me shpejtësi. Kur bëhen shumë "pjesë të nxehta", shpejtësia e kërkimit në indeks degradohet.
Kur një nodë fillon të ekzekutojë një kërkesë kërkimi në një shard, ajo ndan numrin e thredhjeve, të barabartë me numrin e bërthamave të hyper-threaded të makinës fizike. Nëse kërkesa e kërkimit prek një numër të madh shard-esh, atëherë numri i thredhjeve rritet në proporcjon. Kjo reflektohet negativisht në shpejtësinë e kërkimit dhe ndikon negativisht në indeksimin e të dhënave të reja.
Për të siguruar latency-n e nevojshme të kërkimit, ne vendosëm të përdorim SSD. Për procesimin e shpejtë të kërkesave, makinat në të cilat ishin vendosur këto konteinerë duhej të kishin të paktën 56 bërthama. Numri 56 është zgjedhur si një vlerë e kondicionuar e mjaftueshme, që përcakton numrin e thredhëve që do të gjenerojë Elasticsearch gjatë funksionimit. Në Elasticsearch, shumë parametra të thread pool varen drejtpërdrejt nga numri i bërthamave të disponueshme, që nga ana tjetër ndikon drejtpërdrejt në numrin e nevojshëm të nodave në klaster sipas parimit "më pak bërthama - më shumë nodë".
Si rezultat, na doli se, në mesatare, një shard ka rreth 20 gigabajt, dhe për 1 indeks ka 360 shard-e. Prandaj, nëse i rrotatojmë çdo 48 orë, do të kemi 15 prej tyre. Çdo indeks përfshin të dhënat për 2 ditë.
Skemat e shkruajtjes dhe leximit të të dhënave
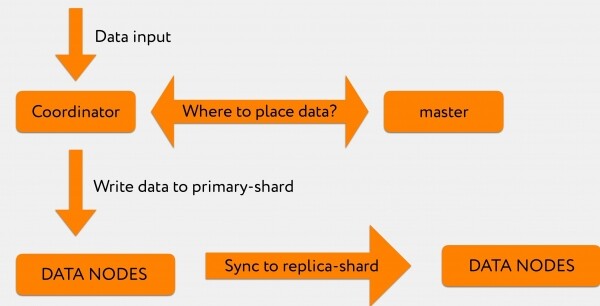
Le të shqyrtojmë se si regjistrohen të dhënat në këtë sistem.
Supozoni se nga Graylog na vjen një kërkesë në koordinator. Për shembull, duam të indeksojmë 2-3 mijë rreshta.
Kordinatori, pasi merr një kërkesë nga Graylog, pyet masterin: "Në kërkesën për indeksim, ne specifikisht kemi treguar indeksin, por nuk është e specifikuar se në cilin shard duhet të shkruajmë."
Masteri përgjigjet: "Shkruaj këtë informacion në shard numër 71", pas të cilit ajo dërgohet drejtpërdrejt në nodën përkatëse të të dhënave, ku ndodhet primary-shard numër 71.
Pas kësaj, logu i transaksioneve repliktohet në replica-shard, i cili ndodhet tashmë në një qendër të dhënash tjetër.
Nga Graylog, në kordinatorin vjen një kërkesë për kërkim. Kordinatorin e redirecton atë sipas indeksit, ndërsa Elasticsearch ndan kërkesat midis primary-shard dhe replica-shard në mënyrë round-robin.
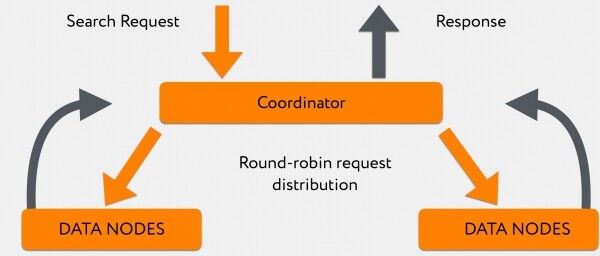
Nodet, në numër prej 180, përgjigjen në mënyrë të paekuilibruar, dhe, ndërsa ato përgjigjen, kordinatorin mbledh informacionin që është "përshtatur" në të nga nodet më të shpejta të të dhënave. Pas kësaj, kur ose të gjithë informacioni ka ardhur, ose është arritur kufiri i kërkesës, i jep të gjitha drejtpërdrejt klientit.
E gjithë kjo sistem mesatarisht përpunon kërkesat për kërkim për 48 orët e fundit brenda 300-400ms, duke përjashtuar ato kërkesa që kanë leading wildcard.
"Lule" me Elasticsearch: Konfigurimi i Java-s.
Për të bërë që gjithçka të funksionojë siç e donim fillimisht, ne e kemi rregulluar për një kohë të gjatë një sërë gjërash në klaster.
Pjesa e parë e problemeve të zbuluara ishte e lidhur me mënyrën se si Java është e parakonfiguruar nga Elasticsearch.
Problemi i parë.
Ne vëzhguam një numër të madh njoftimesh se në nivelin Lucene, kur janë aktivizuar punët në sfond, bashkimet e segmenteve Lucene përfundojnë me gabim. Në log nuk dukej se ka patur OutOfMemoryError. Nga telemetria, ne pamë se hapi ishte i lirë, dhe nuk ishte e qartë se pse kjo operacion dështonte.
Doli se bashkimet e indekseve Lucene ndodhnin jashtë hapësirës së memories. Dhe kontejnerët ishin shumë ashpër të kufizuar në burimet e përdorura. Në këto burime hynte vetëm hapi (vlera heap.size ishte afërsisht e barabartë me RAM-in), dhe disa operacione off-heap dështonin me gabim alokimi, nëse për një arsye të ndonjë lloj nuk përputheshin në ato ~500MB që mbeteshin deri në limit.
Zgjidhja ishte mjaft triviale: ne rritëm sasinë e RAM-it të disponueshëm për kontejnerin, pas së cilës harrojmë për këto probleme që kemi pasur.
Problemi i dytë.
Pas 4-5 ditësh nga aktivizimi i klasterit, ne vëzhguam se nodet e të dhënave fillojnë të dalin periodikisht nga klasteri dhe të hyjnë në të pas 10-20 sekondash.
Kur na filluam të shqyrtonim, u sendeua se kjo memorie off-heap në Elasticsearch nuk kontrollohet pothuajse fare. Kur i dhamë kontejnerit më shumë memorie, morëm mundësinë të mbushnim direkt grupet e tamponëve me informacion të ndryshëm, dhe ajo u pastrua vetëm pasi kishte filluar GC eksplicit nga Elasticsearch.
Në disa raste, kjo operacion ndodhte mjaft ngadalë, dhe gjatë kësaj kohe klasteri kishte arritur ta shënonte këtë nod si të dalë. Ky problem është përshkruar mirë. .
Zgjidhja ishte si më poshtë: ne kufizuam Java-n që të përdorë pjesën më të madhe të memories jashtë heap për këto operacione. Ne e kufizuam deri në 16 gigabajt (-XX:MaxDirectMemorySize=16g), duke arritur që GC eksplicit të thirrej shumë më shpesh dhe të punonte shumë më shpejt, duke mos e destabilizuar kështu klasterin.
Problemi i tretë
Nëse mendoni se problemet me "nodet që lënë klasterin në momentin më të papritur" përfundojnë këtu, jeni në gabim.
Kur konfiguruam punën me indekset, ne vendosëm për mmapfs, për të në sharda të freskëta me segmentim të madh. Kjo ishte një gabim mjaft i rëndë, sepse me përdorimin e mmapfs, skedari mapohet në memorien operuese, dhe pastaj ne punojmë me skedarin e mapuar. Për këtë arsye, kur GC përpiqet të ndalë thread-et në aplikacion, ne shkojmë shumë ngadalë në safepoint, dhe në rrugen drejt tij, aplikacioni ndalet të përgjigjet ndaj kërkesave të masterit për të kuptuar nëse është akoma aktiv. Për pasojë, master-i mendon se nodi nuk është më në klaster. Pas rreth 5-10 sekondave, garbage collector punon, nodi rikthehet, futet përsëri në klaster dhe fillon inicializimin e shardave. Gjithë kjo shumë më shumë i ngjante "prodhimit që e merituam" dhe nuk ishte e përshtatshme për ndonjë gjë serioze.
Për të shpëtuar nga ky sjellje, ne së pari kaluam në standardin niofs, dhe më pas, kur migruam nga versionet pesë të Elastic në të gjashtat, provuam hybridfs, ku ky problem nuk u reproduktua. Më shumë për llojet e ruajtjes mund të lexoni. .
Problemi i katërt
Pastaj kishte një problem tjetër shumë interesante, të cilin e trajtuam për një kohë rekord. E kapëm atë për 2-3 muaj, sepse ishte krejtësisht e paqartë mënyra e saj.
Ndonjëherë koordinuesit tanë shkonin në Full GC, zakonisht diku pas drekës, dhe nga aty nuk ktheheshin më. Gjatë regjistrimit të vonesave të GC, kjo dukej kështu: gjithçka shkonte mirë, mirë, mirë, pastaj papritmas – dhe gjithçka bëhej ndryshe.
Fillimisht menduam se kishim një përdorues të keq që po ekzekutonte një kërkesë, e cila po nxirrte koordinuesin nga funksionimi. Kemi regjistruar gjatë për kërkesat, duke u munduar të zbulojmë çfarë po ndodhte.
Në fund u zbulua se në momentin kur ndonjë përdorues po ekzekutonte një kërkesë të madhe dhe ajo i kalonte në një koordinues specifik Elasticsearch, disa nodet përgjigjeshin më ngadalë se të tjerët.
Dhe koha që koordinuesi priste përgjigjet nga të gjitha nodet, ai mblidhnin rezultate të dërguara nga nodet që kishin përfunduar. Për GC, kjo do të thotë se modeli i përdorimit të heap-it ndryshonte shumë shpejt. Dhe ai GC që ne përdorëm, nuk përballonte këtë detyrë.
I vetmi zgjidhje që gjetëm për të ndryshuar sjelljen e klasit në një situatë të tillë ishte migrimi në JDK13 dhe përdorimi i mbledhësit të mbetjeve Shenandoah. Kjo e zgjidhi problemin, koordinuesit tanë nuk ranë më.
Me këtë problemin me Java e mbyllëm dhe filluam problemet me kapacitetin.
«Frutat» me Elasticsearch: kapaciteti
Problemet me kapacitetin nënkuptojnë se klasteri ynë funksionon me stabilitet, por në pikun e numrit të dokumenteve të indeksuara dhe gjatë manovrave, performanca është e pamjaftueshme.
Simptoma e parë e hasur: gjatë disa «eksplodimeve» në prodhim, kur gjenerohej papritur një numër shumë i madh logësh, në Graylog shpesh shfaqej gabimi i indeksimit es_rejected_execution.
Kjo ndodhte për shkak se thread_pool.write.queue në një nodë të dhënash, deri në momentin kur Elasticsearch është në gjendje të përpunojë kërkesën për indeksimin dhe të dërgojë informacionin në shardin në disk, sipas parazgjedhjes është në gjendje të ruajë vetëm 200 kërkesa. Dhe në për këtë Parametër thuhet shumë pak. Tregohet vetëm numri maksimal i thread-ëve dhe madhësia e parazgjedhur.
Sigurisht, ne shkuam ta rregullojmë këtë vlerë dhe zbuluam këtë: konkretisht në konfigurimin tonë, ruhet mjaft mirë deri në 300 kërkesa, ndërsa një vlerë më e madhe është e rrezikshme sepse ne sërish shkojmë në Full GC.
Për më tepër, duke qenë se këto janë grupe mesazhesh që vijnë brenda një kërkese, ishte e nevojshme të rregullohej Graylog që të shkruante jo shpesh dhe me grupe të vogla, por me grupe të mëdha ose çdo 3 sekonda, nëse grupi ende nuk është plot. Në këtë rast, informata që shkruajmë në Elasticsearch bëhet e доступshme jo brenda dy sekondave, por brenda pesë (çka na përshtatet mjaft), por numri i ritrajeve që duhet të bëjmë për të shtyrë një grup të madh informacioni zvogëlohet.
Kjo është veçanërisht e rëndësishme në ato momente kur ndodhi ndonjë problem dhe gjëra të tilla për të mos marrë një Elastic të mbushur plot, dhe pas një kohe — node të pa funksionueshme për shkak të mbushjes së buferëve të Graylog.
Për më tepër, kur ndodhnin këto shpërthime në prodhim, merrnim ankesa nga programuesit dhe testuesit: në momentin që u duhej shumë këto log-e, ato jepeshin shumë ngadalë.
Filluam të hetonim. Nga njëra anë, ishte e qartë se kërkesat e kërkimit dhe kërkesat për indeksim punonin, në thelb, në të njëjtat makina fizike, dhe në çdo rast do të kishte disa ulje.
Por kjo mund të evitohej pjesërisht për shkak se në versionet e gjashta të Elasticsearch doli një algoritëm që lejonte shpërndarjen e kërkesave midis data-node-ve përkatëse jo në një mënyrë të rastësishme round-robin (kontejneri që merret me indeksimin dhe mban primary-shard mund të jetë shumë i ngarkuar, nuk do të kishte mundësi të përgjigjej shpejt), por për të drejtuar këtë kërkesë në një kontejner më pak të ngarkuar me replica-shard, i cili do të përgjigjej ndjeshëm më shpejt. Në fjalë të tjera, arritëm në use_adaptive_replica_selection: true.
Pamja e leximit fillon të duket kështu:
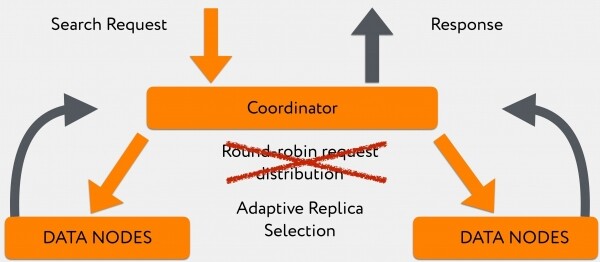
Kalimi në këtë algoritëm lejoj të përmirësohej ndjeshëm koha e kërkimit në ato momente kur kishte një fluks të madh log-esh për të shkruar.
Së fundmi, problemi kryesor ishte dalja pa dhimbje e datacenter-it.
Çfarë doja nga klasteri menjëherë pas humbjes së lidhjes me një DC:
- Nëse në datacenter-in e humbur ndodhet master aktual, ai do të rivotësohet dhe do të kalojë si rol në një node tjetër në një DC tjetër.
- Masteri do të përjashtojë shpejt nga klasteri të gjitha node-të e pa akses.
- Duke u bazë të atyre që kanë mbetur, ai do të kuptojë: në qendrën e të dhënave të humbura kemi pasur këto primary-shard, do t'i promovojë shpejt shard-et e replikuara në qendrat e mbetura të të dhënave, dhe indeksoni të dhënat do të vazhdojë.
- Si rezultat, kapaciteti i shkrimit dhe leximit të klasterit do të degradojë ngadalë, megjithatë në përgjithësi gjithçka do të funksionojë, ndonëse me ngadalësi, por me stabilitet.
Siç doli, ne doja diçka si kjo:
Dhe morëm këtë:
Si ndodhi kjo?
Në momentin e rënies së qendrës së të dhënave, pika jonë e ngushtë ishte masteri.
Pse?
E gjithë çështja është se në master ka një TaskBatcher, që është përgjegjës për shpërndarjen e detyrave dhe aktiviteteve të caktuara në klaster. Çdo dalje e nodës, çdo promovim i shard-it nga replica në primary, çdo detyrë për të krijuar ndonjë shard diku — gjithçka kalon fillimisht në TaskBatcher, ku përpunohen një pas një dhe në një rrjedhë.
Në momentin e daljes së një qendre të dhënash, dukej se të gjithë nodat e mbetura në qendrat e mbetura të dhënash besonin se ishte detyra e tyre t'i thonin masterit 'ne humbëm këto shard dhe këto data-node.'
Ndërsa node-t e mbetura dërgonin të gjithë këtë informacion te masteri aktual dhe përpiqeshin të prisnin konfirmimin se ai e kishte pranuar. Ata nuk prisnin këtë, pasi masteri merrte detyrat më shpejt se sa arrinte të përgjigjej. Nodat përsërisnin kërkesat pas skadimit, ndërsa masteri në atë kohë nuk përpiqej as të përgjigjej, por ishte plotësisht i zënë me detyrën e renditjes së kërkesave sipas prioriteteve.
Në formën e fundit, dukej se nodat e të dhënave po bombarduan masterin deri sa ai shkonte në full GC. Pas kësaj, roli i masterit kalonte në ndonjë nodë tjetër, me të cilën ndodhte krejtësisht e njëjta gjë, dhe përfundimisht klasteri shkatërrohej plotësisht.
Ne bëmë matje dhe deri në versionin 6.4.0, ku ky problem u zgjidh, ishte mjaft për të nxjerrë njëkohësisht vetëm 10 data-node nga 360 që të bllokonim plotësisht klasterin.
Kjo dukej në këtë mënyrë:
Pas versionit 6.4.0, ku ky defekt serioz u korrigjua, node-t e të dhënave nuk e vrisnin më masterin. Por ai nuk bëhej 'më i zgjuar' nga kjo. Saktësisht: kur ne nxjerrim 2, 3 ose 10 (çdo numër përveç një) data-node, masteri merr një mesazh të parë që thotë se nodi A doli dhe përpiqet të tregojë për këtë për nodin B, nodin C, nodin D.
Dhe në momentin aktual, kjo mund të luftohet vetëm duke vendosur një kohë të caktuar për tentativat për të treguar dikujt diçka, që është rreth 20-30 sekonda, dhe kështu të menaxhohet shpejtësia e daljes së qendrës së të dhënave nga klasteri.
Në parim, kjo përputhet me kërkesat që ishin fillimisht vendosur për produktin përfundimtar në kuadër të projektit, por nga pikëpamja e 'shkencës së pastër' kjo është një defekt. Ky, për të cilin, me të vërtetë, ishte rregulluar me sukses nga zhvilluesit në versionin 7.2.
Gjithashtu, kur një nod i dhënash dilte, rezultonte se përhapja e informacionit rreth daljes së saj ishte më e rëndësishme se të tregoheshin të gjithë klasterit se në të ishin këto primary-shard (për të promovuar replica-shard në një qendër tjetër të të dhënave në primary, dhe aty mund të shkruhej informacioni).
Prandaj, kur gjithçka 'ka shkuar', nodet e dalura nuk shënohen si stale menjëherë. Për rrjedhojë, ne jemi të detyruar të presim deri sa të kalojnë të gjitha pings për nodet e dalura dhe vetëm pas kësaj klasteri ynë fillon të tregojë se atje, atje dhe atje duhet të vazhdohet regjistrimi i informacionit. Më shumë detaje mund të lexoni për këtë. .
Më në fund, operacioni i daljes së qendrës së të dhënave sot zë rreth 5 minuta në orët e pikut. Për një makinë kaq të madhe dhe të ngadaltë, ky është një rezultat mjaft i mirë.
Më në fund, ne arritëm në zgjidhjen në vazhdim:
- Ne kemi 360 nodet e dhënash me disqe 700 gigabajt.
- 60 koordinatorë për të rregulluar trafikun në këto nodet e dhënash.
- 40 mastera, të cilat na kanë mbetur si një trashëgimi nga versionet para 6.4.0 – për të përballuar daljen e qendrës së të dhënave, ne ishim psikologjikisht të gatshëm të humbnim disa makina, për të garantuar që edhe në skenarin më të keq të kishim një kuorum masterash.
- Çdo përpjekje për të bashkuar role në një kontejner na hasi në faktin se herët a vonë nodi thyhej nën ngarkesë.
- Në të gjithë klasterin përdoret heap.size, i barabartë me 31 gigabajt: të gjitha përpjekjet për të zvogëluar madhësinë çoi në atë që në kërkesat e rënda të kërkimit me wildcard të paracaktuar ose vrasin disa nodet, ose thyen circuit breaker në vetë Elasticsearch.
- Përveç kësaj, për të siguruar performancën e kërkimit, ne përpiqeshim të mbajmë numrin e objekteve në klaster sa më minimal të jetë e mundur, për të përpunuar sa më pak ngjarje në vendin më të ngushtë që kemi arritur në master.
Në fund për monitorimin
Për të siguruar që gjithçka të funksionojë siç pritej, ne monitorojmë:
- Çdo data-node raporton në re se ajo ekziston dhe ka këto sharda të vendosur. Kur ne fikim diçka, klasteri raporton pas 2-3 sekondash se ne në qendrën A kemi fikur node 2, 3, dhe 4 — kjo do të thotë se në qendrat e tjera të të dhënave, ne nuk mund të fikim ato nodes ku ka sharda të vetme.
- Duke njohur karakterin e sjelljes së master, ne monitorojmë me kujdes numrin e detyrave në pritje. Sepse edhe një detyrë e ngecur, nëse nuk është bërë timeout në kohë, teorikisht në një situatë emergjente mund të bëhet shkaku që nuk do të funksionojë, le të themi, promovimi i replica-shard në primary, duke shkaktuar ndalimin e indeksimit.
- Po ashtu, ne shikojmë me vëmendje vonesat e garbage collector, sepse kemi pasur vështirësi të mëdha me këtë gjatë optimizimit.
- Të rejektuarit sipas threadave, për të kuptuar paraprakisht ku ndodhet "ngushtica".
- Dhe metrikat standarde, si heap, RAM dhe I/O.
Kur ndërtojmë monitorimin, patjetër duhet të marrim parasysh veçoritë e Thread Pool në Elasticsearch. përshkruan mundësitë e konfigurimit dhe vlerat e paracaktuara për kërkimin, indeksimin, por e hesht plotësisht për thread_pool.management. Këto thread-e trajtojnë, për shembull, kërkesat e tipit _cat/shards dhe të tjera të ngjashme, që janë të dobishme për shkrimin e monitorimit. Sa më i madh të jetë klasteri, aq më shumë kërkesa të tilla kryhen brenda një njësie kohe, dhe thread_pool.management i përmendur më lart jo vetëm që nuk është përfaqësuar në dokumentacionin zyrtar, por ka edhe një limit të përcaktuar prej 5 thread-a, që shpenzohet shumë shpejt, pas së cilës monitorimi ndalon së funksionuari siç duhet.
Çfarë do doja të thosha përfundimisht: ne arritëm! Ne arritëm t'u japim programuesve dhe zhvilluesve tanë një mjet që pothuajse në çdo situatë mund të ofrojë shpejt dhe saktë informacionin rreth asaj që po ndodh në prodhim.
Po, kjo u bë mjaft e komplikuar, por megjithatë, arritëm t'i përshtatim dëshirat tona në produktet ekzistuese që nuk e kishim nevojë t'i patch-ojmë ose t'i shkruajmë nga e para.
Burimi: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish