

Në artikujt e kaluar filluam të tregojmë se çfarë është Proxmox VE dhe si funksionon. Sot do t'ju tregojmë se si mund të përdorni mundësinë e grumbullimit dhe do të tregojmë përfitimet që sjell ajo.
Çfarë është grumbulli dhe përse nevojitet? Grumbulli (nga anglishtja cluster) është një grup serverash të lidhur me kanale të shpejta komunikimi, që funksionon dhe paraqitet për përdoruesin si një entitet i vetëm. Ekzistojnë disa skenarë themelorë të përdorimit të grumbullit:
- Sigurimi i qëndrueshmërisë së shërbimeve (High-availability).
- Balancimi i ngarkesës (Load Balancing).
- Rritja e performancës (High Performance).
- Kryerja e llogaritjeve të shpërndara (Distributed computing).
Çdo skenar ka kërkesat e tij specifike për komponentët e grumbullit. Për shembull, për një grumbull që kryen llogaritje të shpërndara, kërkesa kryesore është shpejtësia e lartë në ekzekutimin e operacioneve me numra me presje dhe latenca e ulët e rrjetit. Të tillë grumbuj përdoren shpesh për qëllime kërkimore.
Pasi e përmendëm temën e llogaritjeve të shpërndara, dëshirojmë të theksojmë se ekziston edhe një koncept tjetër i quajtur sistemi grid (nga anglishtja grid — rrjet). Megjithëse kanë disa ngjashmëri, nuk duhet të ngatërrohet sistemi grid me grumbullin. Grid nuk është një grumbull në kuptimin e zakonshëm. Ndryshe nga grumbulli, nyjat në grid shpesh janë të ndryshme dhe kanë disponueshmëri të ulët. Ky qasjet lehtëson zgjidhjen e problemeve të llogaritjeve të shpërndara, por nuk lejon krijimin e një entiteti të vetëm nga nyjat.
Një shembull i qartë i sistemit grid është platforma e njohur e llogaritjeve (Berkeley Open Infrastructure for Network Computing). Kjo platformë fillimisht u krijua për projektin (Search for Extra-Terrestrial Intelligence at Home), e cila merret me problemin e kërkimit të inteligjencës extraterrestre duke analizuar sinjalet radio.
Si funksionon kjoNjë sasi e madhe të dhënash të marra nga radioteleskopët ndahet në shumë copëza të vogla, dhe ato dërgohen në nyjat e sistemit grid (në projektin SETI@home, roli i këtyre nyjeve përfaqësohet nga kompjuterët e vullnetarëve). Të dhënat përpunohen në nyja dhe, pasi të përfundojë përpunimi, dërgohen në serverin qendror të projektit SETI. Kështu projekti zgjidh një problem të komplikuar global, pa pasur kapacitetet e nevojshme të llogaritjeve.
Tani kur kemi një kuptim të qartë se çfarë është një klaster, le të shqyrtojmë se si mund ta krijojmë dhe ta përdorim atë. Do të përdorim një sistem virtualizimi me burës kod të hapur. .
Veçanërisht e rëndësishme para se të fillojmë të krijojmë një klaster, është të kuptojmë qartë kufizimet dhe kërkesat sistemore të Proxmox, pra:
- numri maksimal i nodave në klaster është 32;
- të gjithë nodat duhet të kenë versionin e njëjtë të Proxmox (ka përjashtime, por ato nuk rekomandohen për produkte);
- nëse planifikohet të përdoret funksionin e Disponueshmërisë së Lartë, atëherë klasteri duhet të ketë të paktën 3 nodas;
- për të mundësuar bashkëveprimin e nodave mes tyre, duhet të jenë të hapura portet UDP/5404, UDP/5405 për corosync dhe TCP/22 për SSH;
- këputja në rrjet midis nodave nuk duhet të kalojë 2 ms.
Krijimi i cluster-it
E rëndësishme! Konfigurimi në vazhdim është testues. Mos harroni të verifikoni me Proxmox VE.
Për të nisur një klaster testues, ne morëm tre servera me hipervizorin Proxmox të instaluar me të njëjtin konfigurim (2 bërthama, 2 GB RAM).
Nëse dëshironi të dini se si mund ta instaloni Proxmox, ne ju rekomandojmë të lexoni artikullin tonë të mëparshëm — .
Fillimisht, pas instalimit të sistemit operativ, një server i vetëm punon në Standalone-mode.
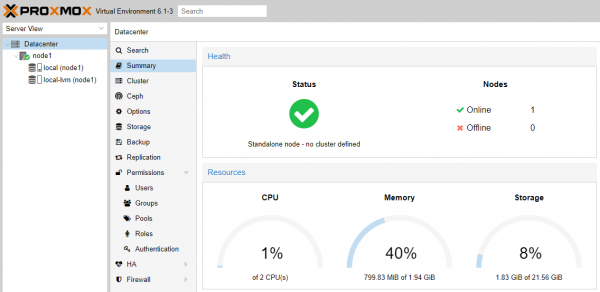
Të krijojmë një klaster, klikoni në butonin Create Cluster në seksionin përkatës.
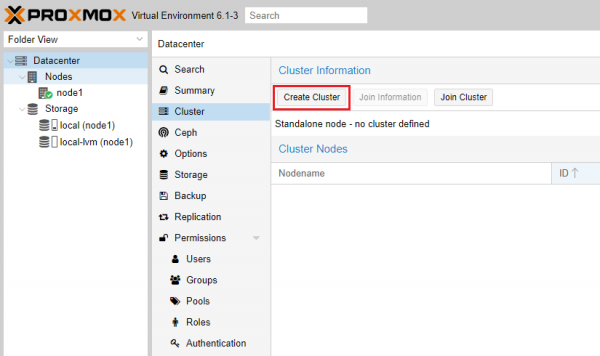
Vendosim emrin e klasterit të ardhshëm dhe zgjedhim lidhjen aktive të rrjetit.
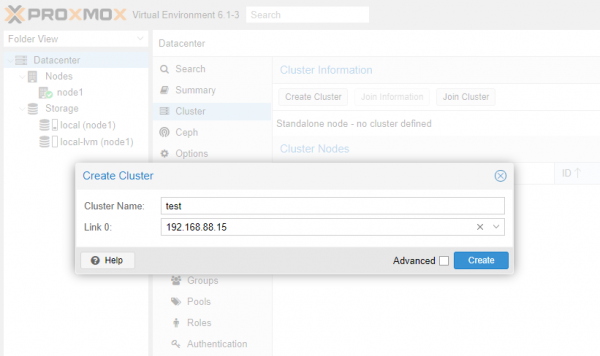
Klikoni butonin Create. Serveri do të gjenerojë një çelës 2048-bit dhe do ta regjistrojë atë së bashku me parametrat e klasterit të ri në skedarët e konfigurimit.
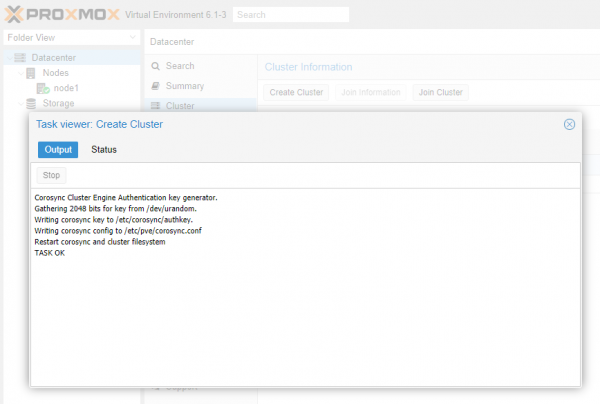
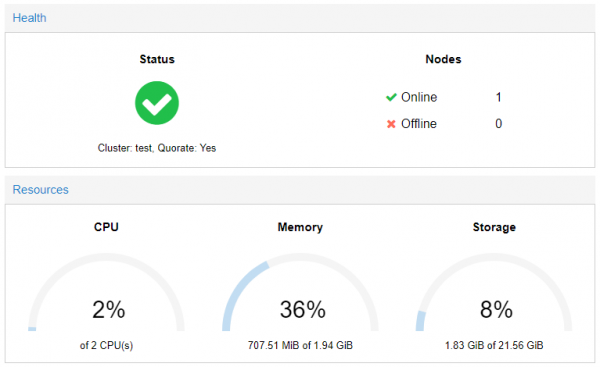
Shkrimi TASK OK tregon për një operacion të suksesshëm. Tani, duke parë informacionin e përgjithshëm për sistemin, është e qartë se serveri ka kaluar në modalitetin e klasterit. Deri tani, klasteri përbëhet vetëm nga një nod, pra akoma nuk ka ato mundësi për të cilat është e nevojshme një klaster.
Pranimi në klaster
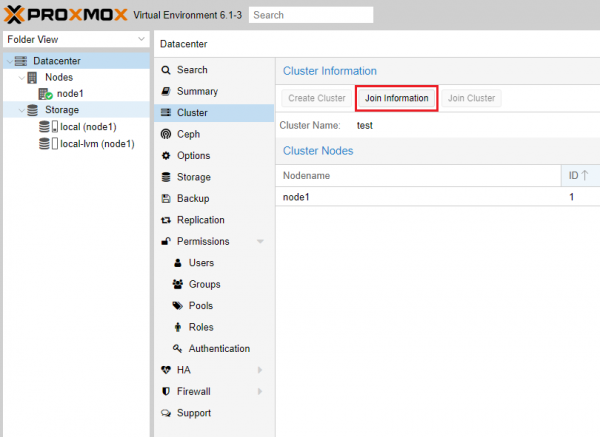
Para se të lidhemi me klasterin e krijuar, na nevojitet të marrim informacionin për të kryer lidhjen. Për këtë, hyjmë në seksionin Klaster dhe shtypim butonin Join Information.
Në dritarën që hapet, na intereson përmbajtja e fushës me të njëjtin emër. Duhet ta kopjojmë atë.
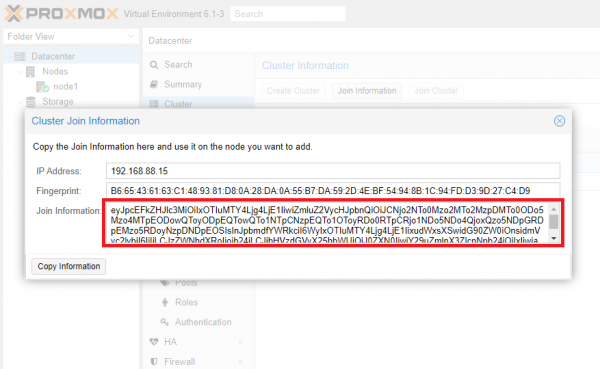
Këtu janë koduar të gjitha parametrat e nevojshëm për lidhje: adresa e serverit për lidhjen dhe gishtprëthja numerike. Shkoni në serverin që duhet të përfshihet në klaster. Klikoni butonin Join Cluster dhe në dritaren që hapet, ngjisim përmbajtjen e kopjuar.

Fushat Adresa Peer dhe Fingerprint do të plotësohen automatikisht. Futim fjalëkalimin root të nodit numër 1, zgjedhim lidhjen rrjet dhe klikojmë butonin Bashkohu.
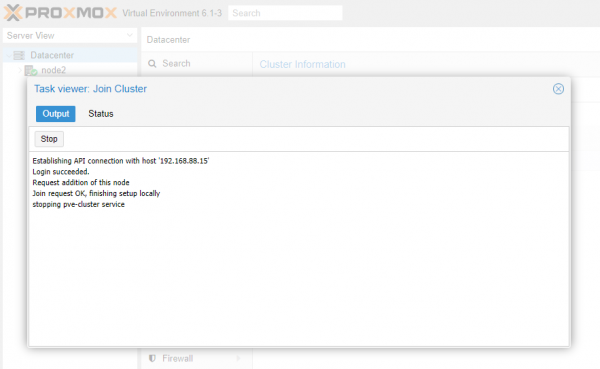
Gjatë procesit të bashkimit me grupin, faqja GUI mund të ndalojë së përditësuari. Kjo është normale, thjesht rikthejmë faqen. Pikërisht në të njëjtën mënyrë shtojmë një nod tjetër dhe në fund kemi një grup të plotë me 3 node funksionale.
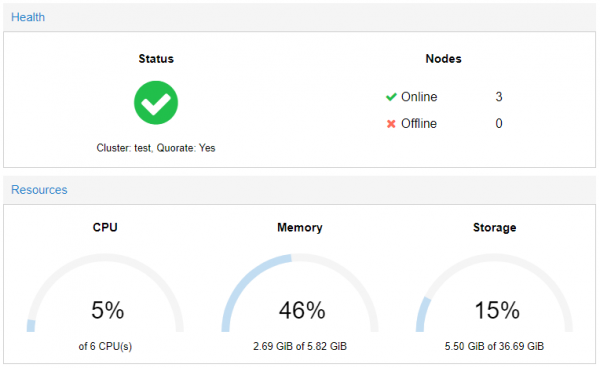
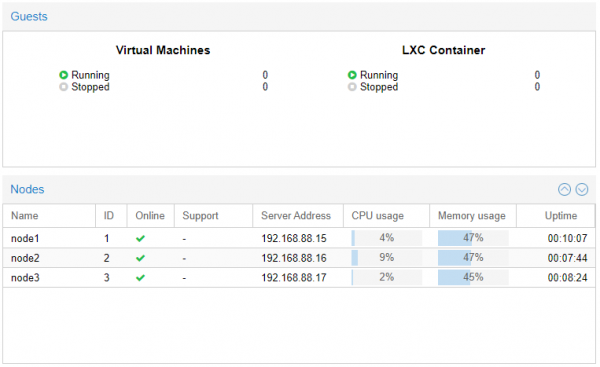
Tani ne mund të kontrollojmë të gjitha nodet e grupit nga një GUI.
Krijimi i High Availability
Proxmox "nga kutia" ofron funksionalitetin e krijimit të HA si për makinat virtuale ashtu edhe për kontejnerët LXC. Utiliteti ha-manager identifikon dhe menaxhon gabimet dhe dështimet, duke realizuar një kalim emergjent nga nodi i dështuar në atë funksional. Për të funksionuar si duhet, makinat virtuale dhe kontejnerët duhet të kenë një depo të përbashkët.
Pas aktivizimit të funksionalitetit të High Availability, struktura e softuerit ha-manager do të fillojë të monitorojë vazhdimisht gjendjen e funksionimit të makinës virtuale ose kontejnerit dhe të bashkëpunojë asinkronisht me nodet e tjera të grupit.
Bashkojmë depo të përbashkët
Për shembull, ne kemi vendosur një depo të vogël NFS në adresën 192.168.88.18. Për të lejuar që të gjitha nodet e grupit ta përdorin, duhet të kryejmë këto manipulime.
Zgjidhim në menunë e ndërfaqes së uebit Datacenter — Storage — Shto — NFS.
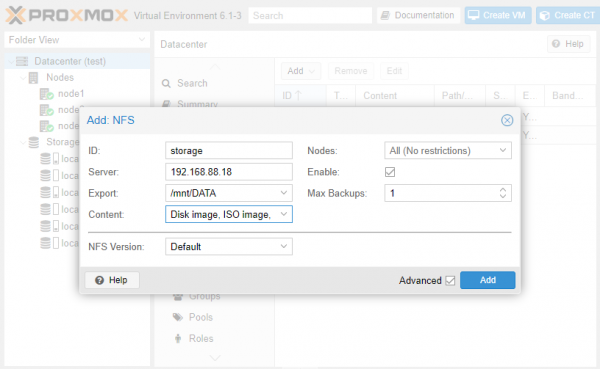
Plotësojmë fushat ID dhe Server. Në listën e rënë Eksporto zgjedhim dosjen e nevojshme nga ato të disponueshme dhe në listën Përmbajtja — llojet e nevojshme të të dhënave. Pasi të klikojmë butonin Shto depoja do të lidhët me të gjitha nodet e grupit.
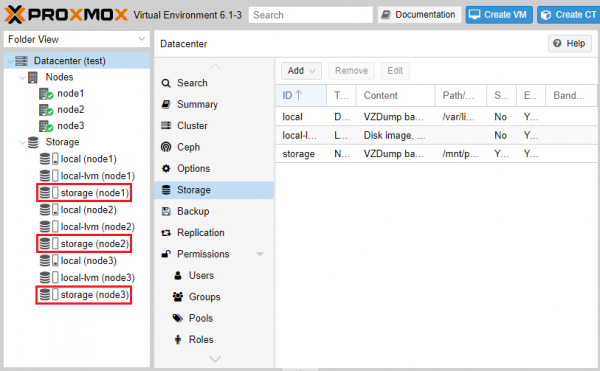
Kur krijojmë makina virtuale dhe kontejnerë në ndonjë nga nodet, tregojmë tonin storage si depo.
Konfigurojmë HA
Për shembull, do të krijojmë një kontejner me Ubuntu 18.04 dhe do ta konfigurojmë për High Availability. Pas krijimit dhe nisjes së kontejnerit, hyjmë në seksionin Datacenter — HA — Shto. Në fushën që hapet, tregojmë ID-në e makinës virtuale/konteinerit dhe numrin maksimal të përpjekjeve për rikthim dhe transferim mes nodëve.
Nëse ky numër tejkalohet, hipervizori do ta shënojë VM si dështim dhe do ta kalojë në gjendjen Error, pas së cilës do të ndalojë të kryejë ndonjë veprim me të.
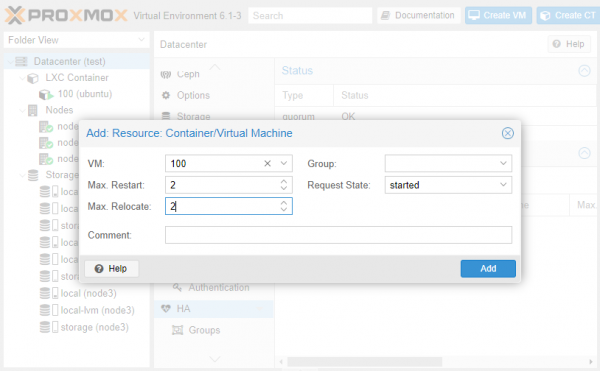
Pas klikimit të butonit Shto njësia ha-manager do të njoftojë të gjitha nodet e grupit për këtë, se tani VM me ID-në e treguar kontrollohet dhe në rast dështimi, ajo duhet të rifillojë në një nod tjetër.
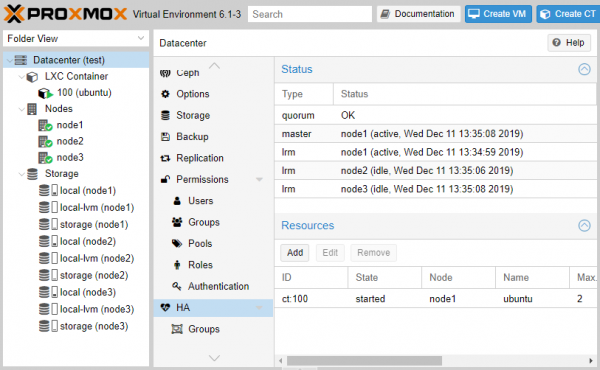
Ne do të shkaktojmë një dështim
Për të parë se si funksionon mekanizmi i kalimit, do të fikim papritur node1 nga energjia. Po shikojmë nga një nodo tjetër se çfarë ndodh me klasterin. Shohim se sistemi e ka regjistruar dështimin.
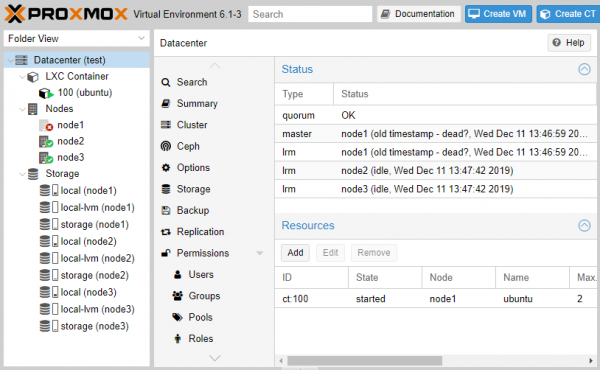
Funksionimi i mekanizmit HA nuk do të thotë vazhdimësi të punës së VM. Sapo nodi "ra", puna e VM përkohësisht ndalet deri në momentin e rindizjes automatikë në një nod tjetër.
Dhe këtu fillon "magjia" - klasteri në mënyrë automatike riaranzhoi nodin për të kryer VM-në tonë dhe brenda 120 sekondave puna u rikthye automatikisht.

Fikim node2 nga energjia. Le të shohim nëse klasteri do ta përballojë dhe nëse VM do të rikthehet automatikisht në gjendje pune.
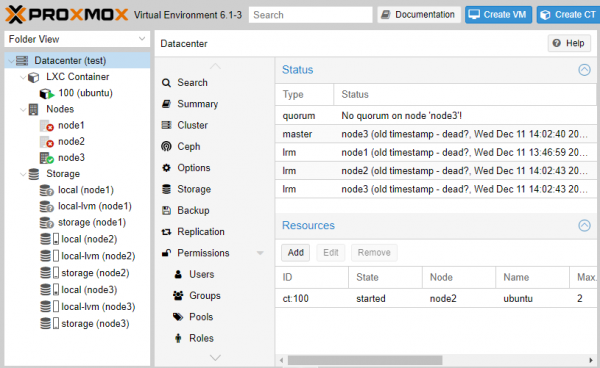
Për fat të keq, siç shohim, kemi një problem se në nodin e vetme të mbetur të gjallë nuk ka më kuorum, që automatikisht çon në çaktivizimin e punës së HA. Jepni në konsolën komandën për vendosjen e detyrueshme të kuorumit.
pvecm priste 1 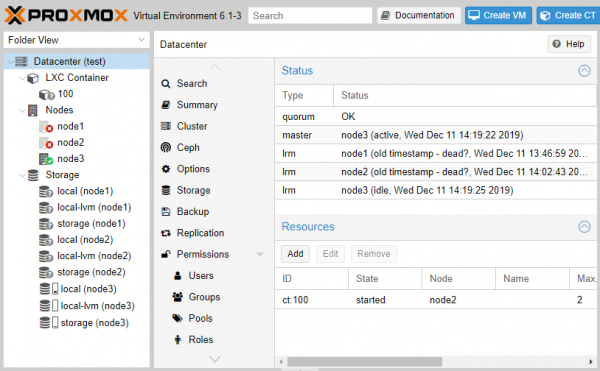
Pas 2 minutash, mekanizmi HA kaloi saktë dhe pasi nuk gjeti node2, nisi VM-në tonë në node3.
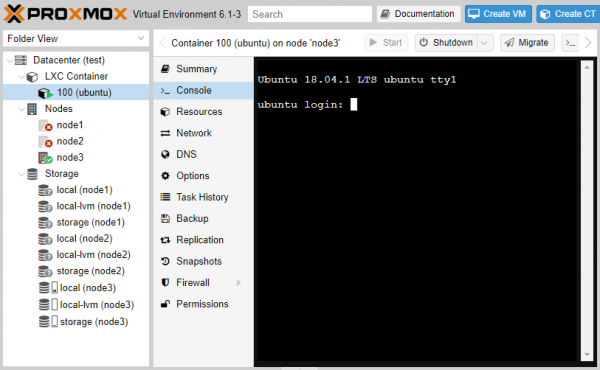
Sapo ndezëm përsëri node1 dhe node2, puna e klasterit u rikthye plotësisht. Vini re se VM nuk migron automatikisht përsëri në node1, por kjo mund të bëhet manualisht.
Të shohim përfundimet
Ne ju folëm për mënyrën se si funksionon mekanizmi i klasterizimit në Proxmox, si dhe treguam se si konfigurohet HA për makinat virtuale dhe konteinerët. Përdorimi i mençur i klasterizimit dhe HA rrit ndjeshëm besueshmërinë e infrastrukturës dhe siguron rikuperimin pas dështimeve.
Para se të krijoni një klaster, duhet të planifikoni menjëherë për cilat qëllime do të përdoret dhe sa do të nevojitet të zgjerohen në të ardhmen. Gjithashtu duhet të kontrolloni infrastrukturën rrjetore për gatishmërinë për të punuar me vonesa minimale, në mënyrë që klasteri i ardhshëm të punojë pa dështime.
Na tregoni - a po e përdorni mundësitë e klasterizimit në Proxmox? Po ju presim në komentet.
Artikujt e mëparshëm mbi hipervizorin Proxmox VE:
Burimi: habr.com
