

Çfarë do të flasim:
Si të shpërndajmë shpejt një magazinë të përbashkët për dy serverë mbi zgjidhjet drbd+ocfs2.
Kujt do t'i shërbejë kjo:
Ky tutorial do të jetë i dobishëm për administratorët e sistemeve dhe për të gjithë ata që kërkojnë një mënyrë për të implementuar një magazinë ose dëshirojnë të provojnë zgjidhjen.
Cilat zgjidhje ne i hodhëm poshtë dhe përse
Shpesh ne përballë me situatën kur duhet të implementojmë një magazinë të përbashkët në një web-klustër të vogël me performancë të mirë në leximin - shkruajtjen. Ne kemi provuar konfigurime të ndryshme për të implementuar magazinën për projektet tona, por pak gjëra ishin në gjendje të plotësonin menjëherë disa tregues. Tani do t’jua tregojmë pse.
- Glusterfs nuk na përmbushi në performancë në lexim dhe shkruarje, pati probleme me leximin e një numri të madh skedareve si dhe kishte ngarkesë të lartë në CPU. Problemi me leximin e skedarëve mund të zgjidhet duke i kërkuar ato direkt në brick-e, por kjo nuk është gjithmonë e aplikueshme dhe përgjithësisht është e gabuar.
- Ceph nuk na pëlqeu për kompleksitetin e tepruar, i cili mund të jetë i dëmshëm në projektet me 2-4 serverë, sidomos nëse projekti më pas administronhet. Përsëri, ka kufizime serioze në performancë, që detyrojnë ndërtimin e klastereve të veçanta të magazinës, ashtu si me glusterfs.
- Përdorimi i një serveri nfs për të implementuar një magazinë të përbashkët i jep pyetje në lidhje me qëndrueshmërinë.
- s3 është një zgjidhje e shkëlqyer dhe e njohur për një rang të caktuar detyrash, por gjithashtu nuk është një sistem skedarësh, që e ngushton fushën e aplikimit.
- lsyncd. Nëse kemi filluar të flasim për "jo-sistemet e skedarëve", është e arsyeshme të kalojmë edicion në këtë zgjidhje të njohur. Jo vetëm që nuk është e përshtatshme për shkëmbim dypërshellesh (por nëse dëshirohet shumë, mund të bëhet), por gjithashtu nuk punon stabilisht me një numër të madh skedarësh. Një shtesë e këndshme është se ajo është njëpërçendrore. Arsyeja është në arkitekturën e programit: ajo përdor inotify për të monitoruar objektet e punës, që vendosen gjatë nisjes dhe gjatë ripërgatitjes. Si mjet transferimi përdoret rsync.
Tutorial: si të implementojmë një magazinë të përbashkët mbi drbd+ocfs2
Një nga zgjidhjet më të përshtatshme për ne ishte lidhja ocfs2+drbd. Tani do t'ju tregojmë si mund të shpërndajmë shpejt një magazinë të përbashkët për dy serverësh në bazën e zgjidhjeve. Por fillimisht disa fjalë për komponentët:
DRBD — një sistem ruajtjeje i cili vjen standard me Linux, i cili lejon replikimin e të dhënave midis serverëve me blloqe. Përdorimi kryesor është ndërtimi i ruajtjeve të qëndrueshme.
OCFS2 — një sistem skedarësh që siguron përdorimin e përbashkët të të njëjtit ruajtje nga disa sisteme. Ai është pjesë e paketës Linux dhe përbëhet nga një modul bërthamë dhe mjete për përdoruesit për të punuar me FS. OCFS2 mund të përdoret jo vetëm mbi DRBD, por edhe mbi iSCSI me lidhje të shumta. Në shembullin tonë ne përdorim DRBD.
Të gjitha veprimet kryhen në serverin ubuntu 18.04 në konfigurimin minimal.
Hapi 1. Konfigurojmë DRBD:
Në skedarin /etc/drbd.d/drbd0.res përshkruajmë pajisjen tonë virtuale të bllokut /dev/drbd0:
resource drbd0 {
    syncer { rate 1000M; }
    net {
        allow-two-primaries;
        after-sb-0pri discard-zero-changes;
        after-sb-1pri discard-secondary;
        after-sb-2pri disconnect;
    }
    startup { become-primary-on both; }
    on drbd1 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.192:7789;
}
    on drbd2 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.193:7789;
}
}
meta-disk internal — përdorimi i të njëjtit bllok për ruajtjen e të dhënave të metadata
device /dev/drbd0 — përdorimi i /dev/drbd0 si rrugë në drbd.
disk /dev/vdb1 — përdorimi i /dev/vdb1
syncer { rate 1000M; } — përdorimi i gjigabit të kapacitetit të kanaleve
allow-two-primaries — një opsion i rëndësishëm që lejon pranimin e ndryshimeve në dy servera kryesorë
after-sb-0pri, after-sb-1pri, after-sb-2pri — opsione që përcaktojnë veprimet e nyjës kur zbulohet splitbrain. Mund të shihni më shumë në dokumentacion.
become-primary-on both — vendos të dy nyjat në kryesor.
Në rastin tonë kemi dy VM të njëjta, me një rrjet virtual me kapacitet prej 10 gigabit.
Në shembullin tonë emrat rrjetësorë të dy nyjave të grupit janë drbd1 dhe drbd2. Për të funksionuar siç duhet, duhet të maponi emrat dhe adresat IP të nyjave në /etc/hosts.
10.10.10.192 drbd1
10.10.10.193 drbd2
Hapi 2. Konfigurojmë nyjat:
Në të dy serverët kryejmë:
drbdadm create-md drbd0 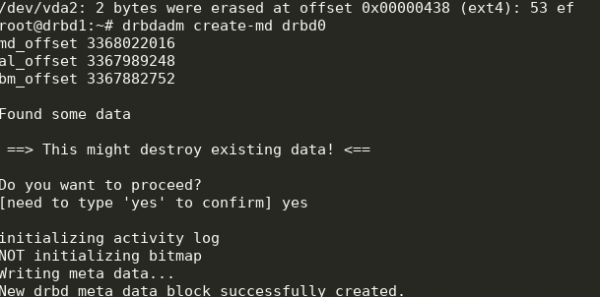
modprobe drbd
drbdadm up drbd0
cat /proc/drbd
Kemi rezultatet si më poshtë:
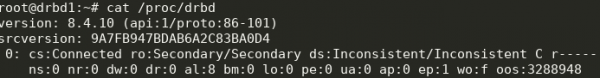
Mund të filloni sinkronizimin. Në nyjën e parë, duhet të ekzekutoni:
drbdadm primary --force drbd0Shikoni statusin:
cat /proc/drbd 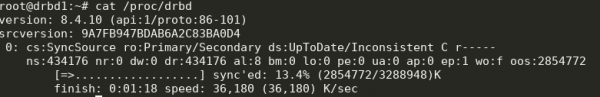
Shkëlqyeshëm, filloi sinkronizimi. Presim që të përfundojë dhe shohim pamjen:
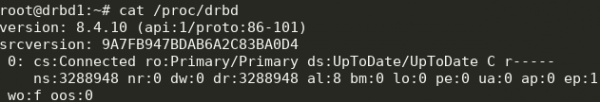
Hapi 3. Fillojmë sinkronizimin në nyjën e dytë:
drbdadm primary --force drbd0
Kemi rezultatet si më poshtë:
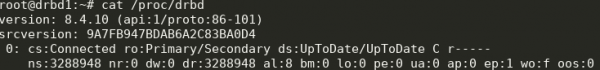
Tani mund të shkruajmë në drbd nga të dy serverët.
Hapi 4. Instalimi dhe konfigurimi i ocfs2.
Ne do të përdorim një konfigurim mjaft triviale:
kluster:
     numri_i_nodit = 2
     emri = ocfs2cluster

nodi:
     numri = 1
     kluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.192
     emri = drbd1

nodi:
     numri = 2
     kluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.193
     emri = drbd2
Kjo duhet të shkruhet në /etc/ocfs2/cluster.conf në të dy nodet.
Krijojmë FS në drbd0 në çdo nod:
mkfs.ocfs2 -L "testVol" /dev/drbd0
Këtu krijuam FS me etiketën testVol në drbd0, duke përdorur parametrat e parazgjedhur.
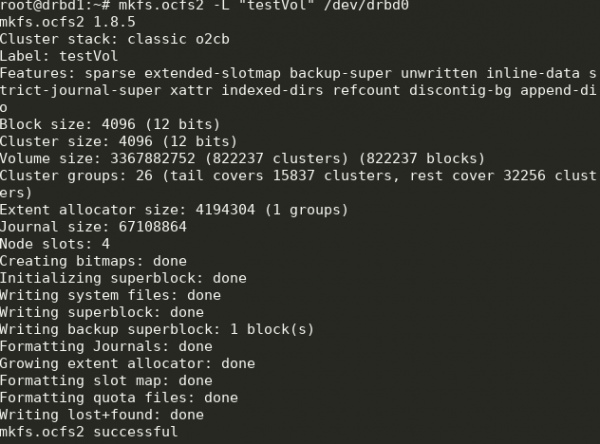
Në /etc/default/o2cb duhet të vendoset (si në skedarin tonë të konfigurimit)
O2CB_ENABLED=true
O2CB_BOOTCLUSTER=ocfs2cluster
dhe të ekzekutohet në çdo nod:
o2cb register-cluster ocfs2clusterPas kësaj aktivizojmë dhe shtojmë në nisjen automatike të gjithë unit-et që na duhen:
systemctl enable drbd o2cb ocfs2
systemctl start drbd o2cb ocfs2
Pjesa më e madhe e kësaj do të jetë e aktivizuar gjatë procesit të konfigurimit.
Hapi 5. Shtojmë pikat e montimit në fstab në të dy nodet:
/dev/drbd0 /media/shared ocfs2 defaults,noauto,heartbeat=local 0 0Direktorinë /media/shared duhet të krijohet më parë.
Këtu përdorim opsionet noauto, që do të thotë se FS nuk do të montojë në nisje (preferoj të montojë FS të rrjetit përmes systemd) dhe heartbeat=local, që do të thotë përdorimi i shërbimit heartbeat në çdo nod. Ekziston gjithashtu global heartbeat, i cili është më i përshtatshëm për klastere të mëdha.
Më pas mund të montohet /media/shared dhe të verifikohet sinkronizimi i përmbajtjeve.
Gati! Si rezultat, ne marrim një ruajtje më të qëndrueshme me mundësi për shkallëzim dhe një performancë të konsiderueshme.
Burimi: habr.com
