

Dëshiroj të flas për një mekanizëm interesant të punës me konfigurimin e një sistemi të shpërndarë. Konfigurimi paraqitet drejtpërdrejt në një gjuhë të kompilueshme (Scala) duke përdorur lloje të sigurta. Në këtë post, synohet të shqyrtohet një shembull i tillë konfigurimi dhe të shqyrtohen aspekte të ndryshme të integrimit të konfigurimit të kompilueshëm në procesin e zhvillimit të përgjithshëm.
()
Hyrje
Ndërtimi i një sistemi të besueshëm të shpërndarë nënkupton se në të gjitha nyjet përdoret një konfigurim i saktë, i sinkronizuar me nyjet e tjera. Zakonisht përdoren teknologjitë DevOps (terraform, ansible ose diçka e ngjashme) për gjenerimin automatik të skedarëve të konfigurimit (shpesh specifikë për çdo nyje). Ne gjithashtu duam të jemi të sigurt se në të gjitha nyjet që ndërveprojnë përdoren protokolle identike (përfshirë versionin e njëjtë). Në të kundërt, do të ketë një moskompatibilitet në sistemin tonë të shpërndarë. Në botën e JVM-së, një nga pasojat e një kërkese të tillë është nevoja për të përdorur gjithandej versionin e njëjtë të bibliotekës që përmban mesazhet e protokollit.
Çfarë mendoni për testimin e sistemit të shpërndarë? Natyrisht, ne supozojmë se për të gjitha komponentët janë parashikuar teste unitare, para se të kalojmë në testimin integrues. (Që të mund të ekstrapolojmë rezultatet e testimit në runtime, ne gjithashtu duhet të sigurojmë një set identik bibliotekash gjatë testimit dhe në runtime.)
Kur punojmë me teste integruese, shpesh është më e lehtë të përdorim një classpath të njëjtë në të gjitha nyjet. Na mbetet vetëm të sigurojmë që e njëjta classpath të përdoret edhe në runtime. (Megjithatë, është krejtësisht e mundur të ekzekutoni nyje të ndryshme me classpath të ndryshme, por kjo krijon komplikime në të gjithë konfigurimin dhe vështirësi në implementimin dhe testet integruese.) Në këtë post, ne supozojmë se të gjitha nyjet do të përdorin të njëjtën classpath.
Konfigurimi zhvillohet së bashku me aplikacionin. Për të identifikuar faza të ndryshme të evolucionit të programeve, ne përdorim versionet. Duket logjike gjithashtu të identifikojmë versionet e ndryshme të konfigurimeve. Po ashtu, konfigurimin e vendosim në një sistem kontrolli versionesh. Nëse në production ekziston një konfigurim i vetëm, mund të përdorim thjesht numrin e versionit. Nëse përdoren shumë instanca produksioni, do na duhen disa
dega konfigurimi dhe një etiketë shtesë përveç versionit (për shembull, emri i degës). Kështu do të jemi në gjendje të identifikojmë me saktësi konfigurimin e saktë. Çdo identifikues konfigurimi përputhet saktësisht me një kombinim të caktuar të nyjeve të shpërndara, porteve, burimeve të jashtme, versioneve të bibliotekave. Në kuadër të këtij postimi, ne do ta konsiderojmë se ka vetëm një degë dhe mund ta identifikojmë konfigurimin në mënyrë të zakonshme duke përdorur tre numra të ndarë me pikë (1.2.3).
Në ambientet moderne, skedarët e konfigurimit krijohen manualisht mjaft rrallë. Më shpesh ata gjenerohen gjatë shpërndarjes dhe zakonisht nuk preken më (që të ). Lind një pyetje logjike, pse ende e përdorim formatin tekstual për ruajtjen e konfigurimit? Një alternativë e qëndrueshme duket të jetë përdorimi i kodit të zakonshëm për konfigurim dhe të përfitosh përparësitë nga verifikimet gjatë kompilim.
Në këtë postim ne do të shqyrtojmë pikërisht idenë e paraqitjes së konfigurimit brenda artefaktit të kompiliuar.
Konfigurimi i kompiliuar
Në këtë seksion do të shqyrtojmë një shembull të konfigurimit statik të kompiluar. Realizohen dy shërbime të thjeshta — shërbimi echo dhe klienti i shërbimit echo. Në bazë të këtyre dy shërbimeve ndërtohen dy variante të sistemit. Në një variant të dy shërbimet ndodhen në një nyje, ndërsa në variantin tjetër — në nyje të ndryshme.
Zakonisht një sistem i shpërndarë përmban disa nyje. Nyjet mund të identifikohen me vlera të një lloji të caktuar NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ose
case class NodeId(hostName: String)apo madje
object Singleton
type NodeId = Singleton.type
Nyjet kryejnë role të ndryshme, ato kanë shërbime të instaluara dhe midis tyre mund të ketë lidhje TCP/HTTP.
Për të përshkruar lidhjen TCP, nevojitet të paktën numri i portit. Ne gjithashtu do të donim të reflektornim protokollin që mbështetet në këtë port, për të garantuar që si klienti ashtu edhe serveri përdorin të njëjtin protokoll. Do të përshkruajmë lidhjen me klasën e tillë:
kasa klasa TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])ku Port — vetëm një numër të plotë Int me tregimin e intervaleve të vlerave të lejuara:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Llojet e sqaruara
Shiko bibliotekën dhe . Për arsye të shkurtër, biblioteka lejon të shtohen kufizime në lloje, të cilat kontrollohen në fazën e kompilimit. Në këtë rast, vlerat e lejuara të numrit të portit janë numra të plotë 16-bitë. Për konfigurimin e kompiluar, përdorimi i bibliotekës refined nuk është detyrueshëm, por përmirëson mundësitë e kompiluesit për kontrollin e konfigurimit.
Për protokollet HTTP (REST) përveç numrit të portit, mund të na nevojitet gjithashtu një rrugë drejt shërbimit:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
kasa klasa PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Llojet fantazmë
Për identifikimin e protokollit gjatë fazës së kompilimit, ne përdorim një parametr të llojit, që nuk përdoret brenda klasës. Kjo zgjidhje lidhet me faktin se në runtime ne nuk përdorim instancën e protokollit, por do të donim që kompiluesi të kontrollonte compatibilitetin e protokolleve. Përmes specifikimit të protokollit, ne nuk mund të dërgojmë një shërbim të papërshtatshëm si varësi.
Një nga protokollet më të zakonshme është REST API me serializimin Json:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]ku RequestMessage — lloji i kërkesës, ResponseMessage — lloji i përgjigjes.
Natyrisht, mund të përdoren edhe përshkrime të tjera të protokolleve, që sigurojnë saktësinë e kërkuar të përshkrimit.
Për qëllimet e këtij postimi, ne do të përdorim një version të thjeshtuar të protokollit:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Këtu kërkesa përfaqëson një varg, i cili shtohet në url, dhe përgjigjja — vargu që kthehet në trupin e përgjigjes HTTP.
Konfigurimi i shërbimit përshkruhet nga emri i shërbimit, portet dhe varësitë. Këto elemente mund të paraqiten në Scala në disa mënyra (p.sh., HList-a, lloje algebrike të të dhënave). Për qëllimet e këtij postimi, ne do të përdorim Cake Pattern dhe do të paraqesim modulet me trait‘at. (Cake Pattern nuk është një element i detyrueshëm i qasjes së përshkruar. Kjo është thjesht një nga realizimet e mundshme.)
Varësitë midis shërbimeve mund të paraqiten si metoda, që kthejnë portet EndPoint‘a të nyjeve të tjera:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Për të krijuar një shërbim echo, mjafton të kemi numrin e portit dhe të specifikojmë se ky port mbështet protokollin echo. Mund të mos e specifikojmë portin konkret, pasi trait’ët lejojnë shpalljen e metodave pa realizim (metoda abstrakte). Në këtë rast, kur krijonim një konfigurim konkret, kompajleri do të kërkonte nga ne të siguronim realizimin e metodës abstrakte dhe të ofronim numrin e portit. Tani që kemi realizuar metodën, kur krijojmë një konfigurim konkret nuk kemi nevojë të specifikojmë ndonjë port tjetër. Do të përdoret vlera e paracaktuar.
Në konfigurimin e klientit shpallim varësinë nga shërbimi echo:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Varësia ka të njëjtin tip si shërbimi i eksportuar shërbimi echo. Në veçanti, në klientin echo kërkojmë të njëjtin protokoll. Prandaj, kur lidhen dy shërbime, mund të jemi të sigurt se gjithçka do të funksionojë siç duhet.
Implementimi i shërbimeve
Për të nisur dhe ndaluar shërbimin kërkohet një funksion. (Mundësia e ndalimit të shërbimit është kritikisht e rëndësishme për testimin.) Përsëri, ka disa mundësi për implementimin e një funksioni të tillë (p.sh., mund të përdorim klasa tipesh në bazë të tipit të konfigurimit). Për qëllimet e këtij posti do të përdorim Cake Pattern. Do ta paraqesim shërbimin përmes një klase cats.Resource, pasi në këtë klasë janë parashikuar mjetet për çlirimin e sigurt dhe të garantuar të burimeve në rast probleme. Për të marrë burimin, na nevojitet konfigurimi dhe konteksti i gatshëm runtime. Funksioni i nisjes së shërbimit mund të ketë pamjen e mëposhtme:
  tipi ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
ku
Konfigurimi— tipi i konfigurimit për këtë shërbimAddressResolver— objekti i kohës së ekzekutimit, i cili lejon të njohim adresat e nyjave të tjera (shih më poshtë)
dhe tipet e tjera nga biblioteka cats:
F[_]— tipi i efektit (në rastin më të thjeshtëF[A]mund të jetë thjesht një funksion() => A. Në këtë post do të përdorimcats.IO.)Reader[A,B]— më shumë ose pak sinonim i funksionitA => Bcats.Resource— burimi, i cili mund të merret dhe çlirohetTimer— timer (lejon të flejë për njëfarë kohe dhe mat intervalet e kohës)ContextShift— ekuivalentExecutionContextApplicative— klasa e tipit të efektit, e cila lejon bashkimin e efekteve të veçanta (gati monada). Në aplikacione më komplekse, duket se është më mirë të përdoretMonad/ConcurrentEffect.
Duke përdorur këtë nënshkrim funksioni, mund të implementojmë disa shërbime. Për shembull, një shërbim që nuk bën asgjë:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Shih. , ku janë implementuar shërbime të tjera — ,
dhe .)
Nod është një objekt që mund të nisë disa shërbime (nisja e zinxhirit të burimeve sigurohet falë Cake Pattern):
objekti SingleNodeImpl extend ZeroServiceImpl[IO]
  me EchoServiceService
  me EchoClientService
  me FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] me EchoClientConfig[String] me FiniteDurationLifecycleConfig
}
Kujdes, ne përcaktojmë llojin e saktë të konfigurimit që kërkohet për këtë nod. Nëse harrojmë të specifikojmë ndonjë nga llojet e konfigurimit të nevojshme për një shërbim të caktuar, do të ketë një gabim kompilimi. Gjithashtu, nuk do të mund të nisim nodin nëse nuk ofrojmë një objekt me një lloj të përshtatshëm me të gjitha të dhënat e nevojshme.
Zgjidhja e emrave të nodit
Për të u lidhur me një nod të largët, na nevojitet një adresë IP reale. Ka të ngjarë që adresa të bëhet e njohur më vonë se pjesët e tjera të konfigurimit. Prandaj, na nevojitet një funksion që shndërron identifikuesin e nodit në adresë:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Mund të sugjerojmë disa mënyra për të implementuar një funksion të tillë:
- Nëse adresat bëhen të njohura para deploy-imit, mund të gjenerojmë kod Scala me
adresat dhe pastaj të ekzekutojmë ndërtimin. Në këtë rast, do të kryhet kompilimi dhe do të ekzekutohen testet.
Në këtë rast, funksioni do të jetë i njohur statikisht dhe mund të paraqitet në kod si një shndërrimMap[NodeId, NodeAddress]. - Në disa raste, adresa e vlefshme bëhet e njohur vetëm pas nisjes së nodit.
Në këtë rast, mund të implementojmë një «shërbim zbulimi» (discovery), i cili niset para nodave të tjera dhe të gjithë nodet regjistrohen në këtë shërbim dhe kërkojnë adresat e nodave të tjera. - Nëse mund ta modifikojmë
/etc/hosts, mund të përdorim emra hostesh të paracaktuar (siç janënyja-kryesore-miadheecho-backend) dhe thjesht t'i lidhim këta emra
me adresat IP gjatë deploy-imit.
Në këtë postim nuk do të shqyrtojmë këto raste më në detaje. Për shembullin tonë
lojë, të gjithë nodet do të kenë një adresë IP — 127.0.0.1.
Tani do të shqyrtojmë dy variante të një sistemi të shpërndarë:
- Vendosja e të gjithë shërbimeve në një nod.
- Dhe vendosja e shërbimit echo dhe klientit echo në nodet të ndryshme.
Konfigurimi për :
Konfigurimi për një nod
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikuesi i nodit të vetëm
  \/\/ konfigurimi i serverit
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Specifikimi i portit të shërbimit të sigurt. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfigurimi i klientit

  \/** Ne do të përdorim shërbimin që ofrohet nga hosti të njëjtë. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfigurimi i kontrolluesit të ciklit të jetës
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0.5 sekonda të tjera në mënyrë që të ketë 10 kërkesa, jo 9.
}
Objekti implementon konfigurimin e klientit dhe serverit. Gjithashtu përdoret konfigurimi i jetëgjatësisë, për të përfunduar programin pas një intervalu jetës shkëputësi gjithashtu funksionon dhe çliron në mënyrë korrekte të gjithë burimet.)
Të njëjtin grup trait’esh konfigurimi dhe implementimesh mund të përdorim për të krijuar një sistem që përbëhet nga :
Konfigurimi për dy nyje
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specifikimi i varësisë
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0.5 sekonda të tjera në mënyrë që të ketë 10 kërkesa, jo 9.

    def testMessage: String = "dolly"
  }
Është e rëndësishme! Vini re se si kryhet lidhja e shërbimeve. Ne specifikojmë shërbimin e implementuar nga një nyje si implementim të metodës së varësisë së një nyje tjetër. Lloji i varësisë kontrollohet nga kompilatori, pasi përmban llojin e protokollit. Kur nisemi, varësia do të përmbajë identifikuesin e saktë të nyjes cible. Falë kësaj skeme, ne specifikojmë numrin e portit saktësisht një herë dhe përherë drejtohemi në portin e duhur.
Implementimi i dy nyjeve të sistemit
Për këtë konfigurim, ne përdorim të njëjtat implementime shërbimesh pa ndryshime. E vetmja dallim është se tani kemi dy objekte që implementojnë grupe të ndryshme shërbimesh:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Nyja e parë implementon serverin dhe ka nevojë vetëm për konfigurimin e serverit. Nyja e dytë implementon klientin dhe përdor një pjesë tjetër të konfigurimit. Gjithashtu, të dy nyjet kanë nevojë për menaxhimin e jetëgjatësisë. Nyja e serverit funksionon pa kufizime derisa të ndalet SIGTERMndërsa nyja e klientit përfundon pas një kohe. Shih. .
Procesi i përgjithshëm i zhvillimit
Le të shohim se si ky qasje për konfigurimin ndikon në procesin e përgjithshëm të zhvillimit.
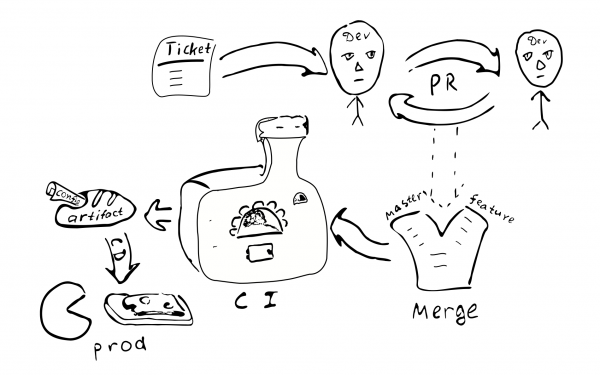
Konfigurimi do të kompilojë së bashku me kodin tjetër dhe do të gjenerohet një artefakt (.jar). Ka kuptim të vendosim konfigurimin në një artefakt të veçantë. Kjo është për shkak se mund të ketë shumë konfigurime të bazuara në të njëjtin kod. Përsëri, mund të gjenerohen artefakte që korrespondrojnë me degë të ndryshme konfigurimi. Së bashku me konfigurimin ruhen varësitë nga versionet specifike të bibliotekave dhe këto versione ruhen përgjithmonë, kurdo që ne të vendosim të zbatojmë këtë version të konfigurimit.
Çdo ndryshim i konfigurimit kthehet në një ndryshim kodesh. Prandaj, çdo një
ndryshim do të mbulohet nga procesi i zakonshëm i garantimit të cilësisë:
Ticket në bug-tracker -> PR -> rishikim -> bashkimi me degët përkatëse ->
integrimi -> përhapja
Pasojat kryesore të implementimit të konfigurimit që mund të kompilohen:
Konfigurimi do të pajtohet në të gjitha nyjet e sistemit të shpërndarë. Për shkak se të gjitha nyjet marrin të njëjtën konfigurim nga një burim të vetëm.
Është problematike të ndryshosh konfigurimin vetëm në një nga nyjet. Prandaj, "çrregullimi i konfigurimit" (configuration drift) është shumë i pamundur.
Bëhet më e vështirë të bëhen ndryshime të vogla në konfigurim.
Shumica e ndryshimeve në konfigurim do të ndodhin brenda procesit të përgjithshëm të zhvillimit dhe do të jenë subjekt i rishikimit.
A është e nevojshme një depo e veçantë për ruajtjen e konfigurimit të prodhimit? Në një konfigurim të tillë mund të përfshihen fjalëkalime dhe informacion tjetër sekret, për të cilin do të doja të kufizohej qasja. Duke u bazuar në këtë, duket se ka kuptim të ruhet konfigurimi përfundimtar në një depo të veçantë. Mund të ndahet konfigurimi në dy pjesë - njëra që përmban parametra të hapur dhe tjetra që përmban parametra të kufizuar. Kjo do t'u lejonte shumicës së zhvilluesve të kishin qasje në parametrat e zakonshëm. Një ndarje e tillë nuk është e vështirë për t'u arritur, duke përdorur trait-e ndërmjetësorë që përmbajnë vlera standarde.
Variacionet e mundshme
Le të përpiqemi të krahasojmë konfigurimin e kompiluar me disa alternativa të njohura:
- Një skedar tekstual në makinën e synuar.
- Një depoqitë qendrore çelës-vlerë (
etcd/zookeeper). - Komponentët e procesit, të cilët mund të konfigurohen/rinisem pa rinisur procesin.
- Ruajtja e konfigurimit jashtë artefaktit dhe kontrollit të versioneve.
Skedarët tekstualë ofrojnë fleksibilitet të konsiderueshëm në aspektin e ndryshimeve të vogla. Administratorët e sistemit mund të hyjnë në nyjën e largët, të bëjnë ndryshime në skedarët përkatës dhe të rinstalin shërbimin. Për sistemet e mëdha, megjithatë, kjo fleksibilitet mund të jetë e padëshiruar. Ndryshimet e bëra nuk lënë gjurmë në sistemet e tjera. Askush nuk kryen rishikimin e ndryshimeve. Është e vështirë të përcaktohet kush në të vërtetë bëri ndryshimet dhe për çfarë arsye. Ndryshimet nuk testohet. Nëse sistemi është i shpërndarë, administratori mund të harrojë të bëjë ndryshimin përkatës në nyjet e tjera.
(Po ashtu, duhet theksuar se përdorimi i konfigurimit të kompiliuar nuk e mbyll mundësinë e përdorimit të skedarëve tekstorë në të ardhmen. Mjafton të shtohet një parser dhe një validues, duke dhënë si rezultat të njëjtin tip Konfigurimi, dhe mund të përdoren skedarë tekstorë. Kështu që, rezulton se kompleksiteti i sistemit me konfigurim të kompiliuar është paksa më i vogël se ai i sistemit që përdor skedarë tekstorë, pasi për skedarët tekstorë kërkohet kod shtesë.)
Një depo qendrore çelës-vlerë është një mekanizëm i mirë për shpërndarjen e meta-parametrave të një aplikacioni të shpërndarë. Duhet të përcaktojmë se çfarë janë parametrat e konfigurimit dhe çfarë janë vetëm të dhëna. Le të kemi një funksion C => A => B, dhe parametrat C rrallë ndryshojnë, ndërsa të dhënat A — shpesh. Në këtë rast, mund të themi se C — parametrat e konfigurimit, ndërsa A — të dhënë. Duket se parametrat e konfigurimit dallojnë nga të dhënat në kuptimin se ata ndryshojnë në përgjithësi më rrallë se sa të dhënat. Gjithashtu, të dhënat zakonisht vijnë nga një burim (nga përdoruesi), ndërsa parametrat e konfigurimit nga një tjetër (nga administrator i sistemit).
Nëse parametrat që ndryshojnë rrallë kërkojnë përditësim pa rinisjen e programit, shpeshherë kjo mund të çojë në ndërlikimin e programit, sepse na nevojitet ndonjë mënyrë për të shpërndarë parametrat, për t'i ruajtur, për t'i analizuar dhe verifikuar, si dhe për të trajtuar vlerat e papërshtatshme. Prandaj, nga pikëpamja e zvogëlimit të kompleksitetit të programit, ka kuptim të reduktohet numri i parametrave që mund të ndryshojnë gjatë funksionimit të programit (ose të mos mbahen fare të tillë).
Nga pikëpamja e këtij postimi, ne do të bëjmë ndarjen ndërmjet parametrave statikë dhe dinamikë. Nëse logjika e funksionimit të shërbimit kërkon ndryshimin e parametrave gjatë ekzekutimit të programit, atëherë do t'i quajmë këta parametra dinamikë. Përndryshe, parametrat janë statikë dhe mund të konfigurohen duke përdorur konfigurimin e kompilueshëm. Për rikonfigurimin dinamik mund të na nevojitet një mekanizëm për rinisjen e pjesëve të programit me parametra të rinj, ashtu siç ndodh me rinisjen e proceseve të sistemit operativ. (Sipas mendimit tonë, është e dëshirueshme që të shmangim rikonfigurimin në kohë reale, pasi kjo rrit kompleksitetin e sistemit. Nëse është e mundur, është më mirë të përdoren mundësitë standarde të OS për rinisjen e proceseve.)
Një nga aspektet e rëndësishme të përdorimit të konfigurimit statik, i cili i bën njerëzit të shqyrtojnë rikonstrukcionin dinamik, është koha që shfrytëzohet nga sistemi për të rinisur pas përditësimit të konfigurimit (downtime). Në të vërtetë, nëse na duhet të bëjmë ndryshime në konfigurimin statik, do të duhet të rinisim sistemin për të zbatuar vlerat e reja. Problemi i downtime-t ka intensitet të ndryshëm për sisteme të ndryshme. Në disa raste, mund të planifikohet rinisja në një kohë kur ngarkesa është minimale. Në rastin kur kërkohet të sigurohet shërbim i vazhdueshëm, mund të realizohet . Në këtë mënyrë, kur na nevojitet të rinisim sistemin, ne fillojmë një instancë paralele të këtij sistemi, kalojmë balancuesin tek ajo, dhe presim derisa të përfundojnë lidhjet e vjetra. Pasi të përfundojnë të gjitha lidhjet e vjetra, ne fikim instancën e vjetër të sistemit.
Tani, le të shqyrtojmë çështjen e ruajtjes së konfiguracionit brenda artefaktit ose jashtë tij. Nëse e ruajmë konfigurimin brenda artefaktit, atëherë, të paktën, kemi pasur mundësinë gjatë ndërtimit të artefaktit të sigurohemi për saktësinë e konfiguracionit. Në rast se konfigurimi është jashtë artefaktit të kontrolluar, është e vështirë të ndjekim se kush dhe për çfarë arsyeje ka bërë ndryshime në këtë skedar. Sa e rëndësishme është kjo? Në mendimin tonë, për shumë sisteme në prodhim është e rëndësishme të kemi një konfiguracion stabil dhe me cilësi të lartë.
Versioni e artefaktit lejon të përcaktojë kur është krijuar, çfarë vlerash përmban, cilat funksione janë të aktivizuara/dizaktivuara dhe kush është përgjegjës për ndryshimet në konfigurim. Natyrisht, ruajtja e konfigurimit brenda artefaktit kërkon disa përpjekje, kështu që duhet të merrni një vendim të informuar.
Për dhe kundra
Dëshiroj të ndalem te përparësitë dhe disavantazhet e teknologjisë së propozuar.
Përfitimet
Më poshtë është lista e mundësive kryesore të konfigurimit të kompaktuar të sistemit të shpërndarë:
- Kontrolli statik i konfigurimit. Lejon të sigurohemi se
konfigurimi është i saktë. - Një gjuhë e pasur konfigurimi. Zakonisht, mënyrat e tjera të konfigurimit kufizohen maksimumi në zëvendësimin e variablave të strinjave. Me përdorimin e Scala-s, bëhet e arritshme një gamë e gjerë mundësish gjuhësore për të përmirësuar konfigurimin. Për shembull, ne mund të përdorim
trait' për vlerat e paracaktuara, përmes objekteve grupojmë parametrat, mund të referohemi në val' të shpallura një herë (DRY) në fushën përfshirëse. Mund të instancojmë drejpërdrejt brenda konfigurimit çdo klasë (Sekuencë,Hartë, klasat e përdoruesve). - DSL. Në Scala ka një sërë mundësish gjuhësore që lehtësojnë krijimin e DSL. Mund të shfrytëzoni këto mundësi dhe të realizoni një gjuhë konfigurimi, e cila do të ishte më e lehtë për grupin e synuar të përdoruesve, për sa kohë që konfigurimi do të ishte së paku i lexueshëm nga specialistët e fushës. Specialistët mund, për shembull, të marrin pjesë në procesin e rishikimit të konfigurimit.
- Integriteti dhe sinkronizimi midis nyjeve. Një nga përfitimet që ka konfigurimi i tërë një sistemi të shpërndarë duke u ruajtur në një pikë të vetme është se të gjitha vlerat shpallen një herë dhe më pas ripërdoren kudo ku janë të nevojshme. Përdorimi i tipeve fantazmë për shpalljen e porteve garanton që në të gjitha konfigurimet e sakta të sistemit nyjet të përdorin protokolle të përputhshme. Prania e varësive të qarta e detyrueshme midis nyjeve garanton që të gjitha shërbimet do të jenë të lidhura me njëra-tjetrën.
- Cilësi e lartë e ndryshimeve. Ndryshimi i konfiguracionit, duke përdorur një proces të zakonshëm zhvillimi, e bën të mundur që standardet e larta të cilësisë të jenë të disponueshme gjithashtu për konfigurimin.
- Përditësimi i njëkohshëm i konfiguracionit. Zbatimi automatik i sistemit pas ndryshimeve në konfiguracion garanton që të gjitha nyjat do të përditësohen.
- Thjeshtimi i aplikacionit. Aplikacioni nuk ka nevojë për parsimim, kontroll të konfiguracionit dhe përpunim të vlerave të pasakta. Kështu, kompleksiteti i aplikacionit zvogëlohet. (Disa komplikime të konfiguracionit që vërehen në shembullin tonë nuk janë një atribut i konfiguracionit të kompiluara, por një vendim i vetëdijshëm që buron nga dëshira për të siguruar një siguri më të madhe të tipave.) Është mjaft e lehtë të kthehesh në konfiguracionin e zakonshëm — mjafton të realizosh pjesët e mungesës. Prandaj, mund të fillosh, për shembull, me konfiguracionin e kompiluara, duke e lënë zbatimin e pjesëve të tepërta për një kohë kur kjo në të vërtetë do të nevojitet.
- Konfiguracioni me versionim. Ndërsa ndryshimet në konfiguracion ndjekin fatin e zakonshëm të çdo ndryshimi tjetër, rezultati është një artifakt me një version unik. Kjo na lejon p.sh. të kthehemi në versionin e mëparshëm të konfiguracionit në rast nevoje. Ne madje mund të përdorim konfiguracionin e një viti më parë dhe në të njëjtën kohë sistemi do të punojë ashtu siç duhet. Konfiguracioni stabil përmirëson parashikueshmërinë dhe besueshmërinë e një sistemi të shpërndarë. Pasi konfiguracioni është i fiksuar në fazën e kompilimit, është mjaft e vështirë ta falsifikosh në prodhim.
- Modulariteti. Çdo kornizë e propozuar është modular dhe modulet mund të kombinohen në variante të ndryshme për të krijuar sisteme të ndryshme. Në veçanti, në një variant mund të konfigurohet sistemi për të funksionuar në një nyje, ndërsa në variantin tjetër — në disa nyje. Mund të krijohen disa konfiguracione për instanca prodhimi të sistemit.
- Testimi. Duke zëvendësuar shërbimet e veçanta me objekte mock, mund të krijohen disa versione të sistemit që janë të përshtatshme për testim.
- Testimi integrues. Prania e një konfigurimi të vetëm për të gjithë sistemin e shpërndarë siguron mundësinë e aktivizimit të të gjithë komponentëve në një mjedis të kontrolluar brenda kuadrit të testimit integrues. E lehtë për të imituar, për shembull, situatën kur disa nyje bëhen të paarritshme.
Disavantazhet dhe kufizimet
Konfigurimi i kompiluara ndryshon nga qasje të tjera ndaj konfigurimit dhe për disa aplikacione mund të mos jetë i përshtatshëm. Më poshtë janë disa disavantazhe:
- Konfigurimi statik. Ndonjëherë është e nevojshme të korrigjosh shpejt konfigurimin në prodhim, duke anashkaluar të gjitha mekanizmat mbrojtës. Në kuadër të këtij afati, mund të jetë më e ndërlikuar. Të paktën, kompilimi dhe deploy automatik përsëri do të kërkohen. Kjo është njëkohësisht një tipar i dobishëm i qasjes dhe një disavantazh në disa raste.
- Gjenerimi i konfigurimit. Në rastin kur skedari i konfigurimit gjenerohet nga një mjet automatik, mund të kërkohen përpjekje të mëtejshme për integrimin e skriptit të ndërtimit.
- Mjetet. Aktualisht, utilitetet dhe metodat e destinuara për të punuar me konfigurimin janë të bazuara në skedarë tekstorë. Jo të gjitha këto utilitete/metoda do të jenë të aksesueshme në rastin e konfigurimit të kompiluara.
- Kërkohet ndryshimi i perspektivës. Zhvilluesit dhe DevOps janë mësuar me skedarë tekstorë. Ideja e kompilimit të konfigurimit mund të jetë disi befasuese dhe e pazakontë dhe të shkaktojë refuzim.
- Kërkohet një proces zhvillimi i cilësisë së lartë. Për të përdorur me rehati konfigurimin e kompiluara, kërkohet automatizim i plotë i procesit të ndërtimit dhe deploy të aplikacionit (CI/CD). Ndryshe, do të jetë mjaft e pakëndshme.
Le të ndalemi gjithashtu në disa kufizime të shembujve të shqyrtuara, të papara nga ideja e konfigurimit të kompiluara:
- Nëse ne ofrojmë informacion të tepërt konfigurimi, i cili nuk përdoret nga nyja, atëhere kompilatori nuk do të na ndihmojë të zbulojmë mungesën e implementimit. Ky problem mund të zgjidhet, nëse heqim dorë nga Cake Pattern dhe përdorim tipe më të forta, për shembull,
HListapo tipe algebraike të dhënash (klasa rastesh) për të paraqitur konfigurimin. - Në skedarin e konfigurimit ka rreshta, të cilat nuk i përkasin saktësisht konfigurimit: (
paketë,import, shpalljet e objekteve;të anuloj def‘ për parametrat, të cilët kanë vlera me parazgjedhje). Pjesërisht mund të shmanget kjo, nëse implementoni një DSL të vetë. Për më tepër, lloje të tjera konfigurimi (për shembull, XML), gjithashtu imponojnë kufizime të caktuara në strukturën e skedarit. - Brenda këtij posti ne nuk po shqyrtojmë rinovimin dinamik të një klustër të nodeve të ngjashme.
Përfundim
Në këtë post, ne shqyrtuam idenë e paraqitjes së konfigurimit në kodin burimor duke përdorur mundësitë e avancuara të sistemit të tipave Scala. Ky qasje mund të gjejë aplikim në aplikacione të ndryshme si një zëvendësim për metodat tradicionale të konfigurimit bazuar në skedarë me xml ose tekst. Megjithëse shembulli ynë është implementuar në Scala, idetë e njëjta mund të transferohen në gjuhë të tjera kompiluese (si Kotlin, C#, Swift, ...). Ky qasje mund të testohet në njërin nga projektet e ardhshme, dhe në rast se nuk përshtatet, mund të kaloni në skedarë tekstual, duke shtuar detajet e munguar.
Natyrisht, konfigurimi i compiluar kërkon një proces zhvillimi të cilësisë së lartë. Në këmbim, sigurohet cilësi e lartë dhe besueshmëri e konfigurimeve.
Qasja e shqyrtuar mund të jetë e zgjerueshme:
- Mund të përdoren makros për të kryer kontrolle gjatë kompilimit.
- Mund të implementohet një DSL për të paraqitur konfigurimin në një format të aksesueshëm për përdoruesit final.
- Mund të implementohet menaxhimi dinamik i burimeve me rregullimin automatik të konfigurimit. Për shembull, kur ndryshon numri i nodeve në kluster, është e nevojshme që (1) çdo node të marrë një konfigurim pak më të ndryshëm; (2) menaxheri i klusterit të marrë informacion për node të rinj.
Faleminderit
Dëshiroj të falënderoj Andrei Saksonov, Pavel Popov dhe Anton Nehaev për kritikën konstruktive të draftit të artikullit.
Burimi: habr.com
