

Po shpesh e përjetojmë kërkesat nga klientët: "Dëshirojmë diçka si Amazon RDS, por më lirë"; "Dëshirojmë si RDS, por kudo, në çdo infrastrukturë". Për të realizuar një zgjidhje të tillë të menaxhuar në Kubernetes, ne shqyrtuam gjendjen aktuale të operatorëve më të njohur për PostgreSQL (Stolon, operatorët nga Crunchy Data dhe Zalando) dhe bëmë zgjedhjen tonë.
Ky artikull është përvoja që kemi marrë dhe nga aspekti teorik (përmbledhje e zgjidhjeve) dhe nga ana praktike (çfarë u zgjodh dhe çfarë dolën nga kjo). Por fillimisht, le të përcaktojmë se cilat janë kërkesat që kërkohen për një zëvendësim potencial të RDS...
Çfarë është RDS
Kur njerëzit flasin për RDS, nga përvoja jonë, ata kuptojnë një shërbim të menaxhuar (managed) të DBMS-it, i cili:
- lehtë konfigurohet;
- ka mundësinë e punës me snapshot dhe rikthimit prej tyre (preferohet — me mbështetje për );
- lejon krijimin e topologjive master-slave;
- ka një listë të pasur të zgjerimeve;
- ofron auditimin dhe menaxhimin e përdoruesve/accesseve.
Në përgjithësi, qasjet për realizimin e detyrës së vendosur mund të jenë shumë të ndryshme, megjithatë rruga me Ansible-nin e kushtuar nuk është në afërsi me ne. (Mund të arrijmë në përfundimin e ngjashëm si kolegët nga 2GIS si rezultat i për të krijuar "një mjet për shpërndarjen e shpejtë të një klasteri të qëndrueshëm mbi Postgres".)
Operatorët janë qasja e pranuar gjerësisht për të zgjidhur këto lloj problemesh në ekosistemin Kubernetes. Më shumë rreth tyre në lidhje me bazat e të dhënave që drejtohen brenda Kubernetes-it, tashmë ka folur drejtori teknik i "Flant", , në .
NB: Për krijimin e shpejtë të operatorëve të thjeshtë, ne rekomandojmë të kushtoni vëmendje ndaj utilitarit tonë Open Source . Duke e përdorur, mund ta bëni këtë pa njohuri mbi Go, por me mënyra më të njohura për administratorët: në Bash, Python etj.
Për PostgreSQL ekzistojnë disa operatorë të njohur K8s:
- Stolon;
- Operatori PostgreSQL i Crunchy Data;
- Operatori Postgres i Zalando.
Le të hedhim një vështrim më të afërt në to.
Zgjedhja e operatorit
Përveç mundësive të rëndësishme që tashmë u përmendën më sipër, ne - si inxhinierë të operacioneve për infrastrukturen në Kubernetes - gjithashtu prisnim nga operatorët të tjerë:
- deplojim nga Git dhe me ;
- mbështetje për anti-affinity për pod-in;
- instalimin e node affinity ose node selector;
- instalimin e tolerancave;
- prezenca e mundësive të optimizimit;
- teknologjitë dhe madje komandat e kuptueshme.
Duke mos u theksuar në detaje për secilin nga atributet (pyesni në komentet nëse kanë mbetur pyetje pas leximit të gjithë artikullit), do të theksoja se këto parametra janë të nevojshme për një përshkrim më të saktë të specializimit të nyjave të klasit, me qëllim që të porositën ato për aplikacione specifike. Kështu, mund të arrijmë një balancim optimal midis performancës dhe kostos.
Tani — tek vetë operatorët PostgreSQL.
1. Stolon
nga kompania italiane Sorint.lab në u shqyrtua si një model ndër operatorët për DBMS. Ky është një projekt mjaft i vjetër: publikimi i tij i parë ndodhi nëntor 2015(!), dhe repozitoriumi në GitHub gëzon pothuajse 3000 yje dhe 40+ kontribues.
Dhe vërtet, Stolon është një shembull i shkëlqyer i arkitekturës së menduar:
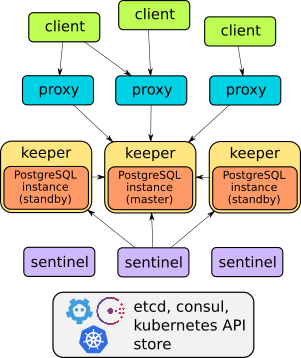
Për funksionimin e këtij operatori në detaje mund të konsultoheni me referatin ose . Në përgjithësi, mjafton të thuhet se ai di të bëjë gjithçka të përmendur: dështim mbi kërkesë, proxy për akses transparent të klientëve, rezervë… Gjithashtu, proxy ofrojnë akses përmes një pikë shërbimi — ndryshe nga dy zgjidhjet e tjera që do të shqyrtohen më poshtë (ato kanë dy shërbime për akses në bazë).
Megjithatë, Stolon , gjë që e bën të pamundur për ta vendosur në mënyrë të tillë që të krijohen shpejt dhe lehtë — "si tortat e nxehta" — ekzemplarë DBMS në Kubernetes. Menaxhimi bëhet përmes utilitarit stolonctl, ndërrimi bëhet përmes Helm-chart, dhe përdoruesit përcaktohen në ConfigMap.
Nga njëra anë, duket se operatori nuk është shumë operator (sepse ai nuk përdor CRD). Por nga ana tjetër — është një sistem fleksibël që lejon konfigurimin e burimeve në K8s ashtu siç ju konvenon.
Duke përmbledhur, personalisht për ne nuk dukej optimal të krijonim një chart të veçantë për secilën DB. Prandaj filluam të kërkojmë alternativa.
2. Crunchy Data PostgreSQL Operator
, një startup amerikan i ri, dukej si një alternativë logjike. Historia e tij publike fillon me publikimin e parë në mars 2017, që nga ajo kohë repozitoriumi në GitHub ka marrë pak më pak se 1300 yje dhe 50+ kontribues. Publikimi i fundit nga shtatori është testuar për punë me Kubernetes 1.15—1.18, OpenShift 3.11+ dhe 4.4+, GKE dhe VMware Enterprise PKS 1.3+.
Arkitektura e Crunchy Data PostgreSQL Operator gjithashtu përputhet me kërkesat e shpallura:
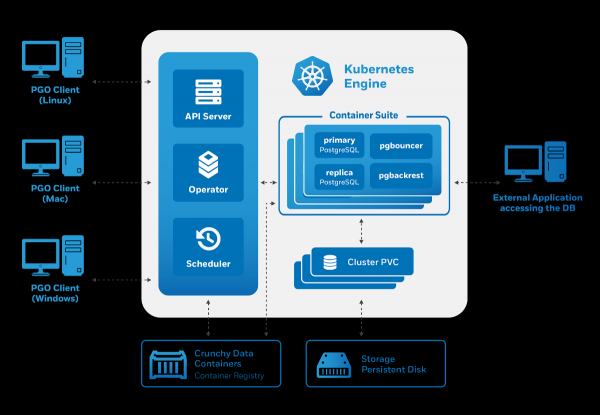
Menaxhimi ndodh përmes utilitarit pgo, megjithatë, ajo nga ana e saj gjeneron Burime të Personalizuara për Kubernetes. Prandaj, na gëzoi si përdorues potencial operatori:
- ka menaxhim përmes CRD;
- menaxhim i lehtë i përdoruesve (po ashtu përmes CRD);
- integrare me komponente të tjera — një koleksion i specializuar i imazheve të kontejnerëve për PostgreSQL dhe mjeteve për të punuar me të (përfshirë pgBackRest, pgAudit, zgjerime nga contrib, etj.).
Megjithatë, përpjekjet për të filluar përdorimin e operatorit nga Crunchy Data zbuluan disa probleme:
- Nuk kishte mundësi tolerimesh — parashikohej vetëm nodeSelector.
- Pod’ët e krijuar ishin pjesë e një Deployment’i, ndonëse ne po e deploy-omim një aplikacion stateful. Ndryshe nga StatefulSet, Deployment’ët nuk dinë të krijojnë disqe.
Disavantazhi i fundit çon në momente qesharake: në ambientin testues arritëm të fillonin 3 replika me një disk ruajtje lokale, si rezultat operatori raportoi se 3 replika po funksiononin (ndonëse kjo nuk ishte e vërtetë).
Një tjetër karakteristikë e këtij operatori është integrimi i tij i gatshëm me sisteme të ndryshme ndihmëse. Për shembull, është e lehtë të instalosh pgAdmin dhe pgBounce, dhe në shihen Grafana dhe Prometheus të parakonfiguruara. Në lansimin e fundit veçanërisht shënohet përmirësimi i integrimit me projektin , duke ofruar kështu një vizualizim të qartë të metrikave për PgSQL “nga fabrikat”.
Megjithatë, zgjedhja e çuditshme e burimeve të gjeneruara nga Kubernetes na çoi në nevojën për të gjetur një zgjidhje tjetër.
3. Zalando Postgres Operator
Produktet e Zalando na janë të njohura për një kohë të gjatë: kemi përvojë në përdorimin e Zalenium dhe, sigurisht, kemi provuar — zgjidhja e tyre popullore HA për PostgreSQL. Eprori i kompanisë për ndërtimin e e tregoi një nga autorët e tij — Aleksei Klyukin — në transmetimin , dhe na pëlqeu.
Ky është zgjidhja më e re nga ato të shqyrtuara në këtë artikull: lëshimi i parë ndodhi në gusht 2018. Megjithatë, edhe pse kishte një numër të vogël lëshimesh formale, projekti ka kaluar një rrugë të gjatë, tashmë duke e tejkaluar në popullaritet zgjidhjen nga Crunchy Data me 1300+ yje në GitHub dhe numrin maksimal të kontributors (70+).
«Nën kapak» ky operator përdor zgjidhje të provuara me kohë:
- Patroni dhe për menaxhim,
- — për backup-e,
- — si një pishinë lidhjesh.
Ja si paraqitet arkitektura e operatorit nga Zalando:
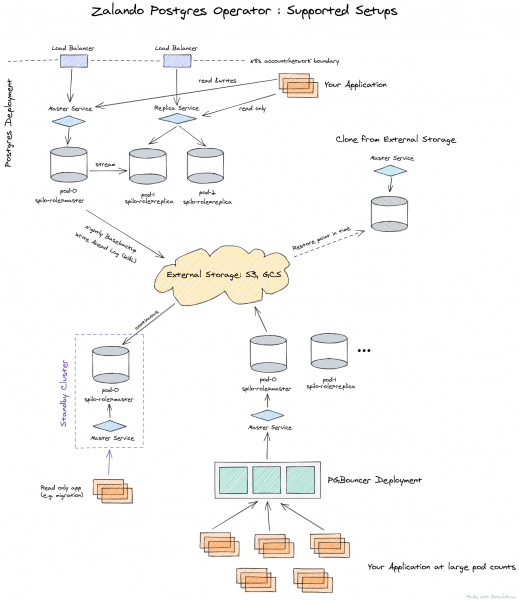
Operatori menaxhohet plotësisht përmes Burimeve të personalizuara, duke krijuar automatikisht një StatefulSet nga kontejnerët, të cilët më pas mund të përshtaten duke shtuar në pod ndryshme sidecar. E gjithë kjo është një avantazh i konsiderueshëm krahasuar me operatorin nga Crunchy Data.
Duke qenë se zgjidhja nga Zalando është përzgjedhur nga 3 mundësi të shqyrtuara, përshkrimi i mëtejshëm i mundësive të saj do të prezantohet më poshtë, së bashku me praktikat e aplikimit.
Praktika me Postgres Operator nga Zalando
Deployimi i operatorit ndodh shumë lehtë: mjafton të shkarkoni versionin aktual nga GitHub dhe të aplikoni skedarët YAML nga direktoria . Si një opsion, mund të shfrytëzoni gjithashtu .
Pas instalimit është e nevojshme të merremi me konfigurimin . Kjo bëhet përmes ConfigMap postgres-operator në hapësirën e emrave, ku keni instaluar operatorin. Kur vendndodhjet janë të konfigurara, mund të lançoni klasterin e parë PostgreSQL.
Për shembull, deployimi standard duket si më poshtë:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Ky manifest deployon një klaster nga 3 eksemplarë me sidecar në formë të , nga i cili ne marrim metrika të aplikacionit. Siç e shihni, gjithçka është shumë e thjeshtë, dhe nëse dëshironi, mund të krijoni një numër të pakufizuar klasteresh.
Duhet të vëmë re gjithashtu panelin web për administrimin — . Ai vjen së bashku me operatorin dhe lejon krijimin dhe fshirjen e klastereve, si dhe punën me backup-et që bën operatori.
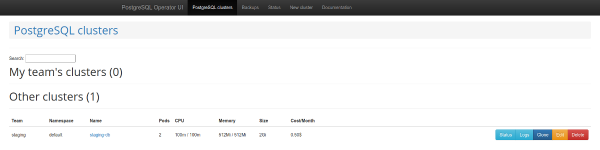
Lista e klastereve PostgreSQL
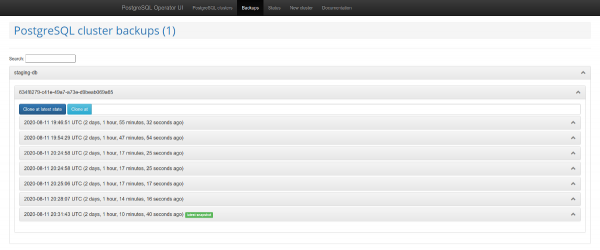
Menaxhimi i backup-eve
Një tipar tjetër interesant është mbështetje për . Ky mekanizëm krijon automatikisht rola në PostgreSQL, bazuar në listën e emrave të përdoruesve të marrë. Pas kësaj, API lejon kthimin e listës së përdoruesve, për të cilët krijohen automatikisht rola.
Problemet dhe zgjidhja e tyre
Megjithatë, përdorimi i operatorit shpërtheu disa disavantazhe të rëndësishme:
- mungesa e mbështetjes për nodeSelector;
- pamundësia për të çaktivizuar backup-et;
- kur përdoret funksioni i krijimit të bazave, privilegjet e paracaktuara nuk shfaqen;
- herë pas here mungon dokumentacioni ose ai është në një gjendje të pabesueshme.
Fatmirësisht, shumë prej tyre mund të zgjidhen. Le të fillojmë me fundin - problemet me dokumentacionin.
Mundësisht do të përballeni me faktin se nuk është gjithmonë e qartë si të shkruani backup dhe si ta lidhni bucket-in e backup-it në Operator UI. Kjo përmendet shkurt në dokumentacion, ndërsa përshkrimi i plotë gjendet në :
- duhet të krijoni një sekret;
- ta përcillni atij operatori si parametrin
pod_environment_secret_namenë CRD me konfigurimet e operatorit ose në ConfigMap (varet nga si e keni vendosur të instaloni operatorin).
Megjithatë, siç rezulton, aktualisht kjo është e pamundur. Për këtë arsye, ne grumbulluam me disa zhvillime shtesë nga palë të treta. Më shumë për të - shih më poshtë.
Nëse i dërgoni operatorit parametrat për backup, sidomos - wal_s3_bucket dhe çelësat e aksesit në AWS S3, atëherë ai do të bëjë backup të gjithçkaje: jo vetëm bazat në prodhim, por edhe staging. Kjo nuk na përshtatet.
Në përshkrimin e parametrave për Spilo, që është mbështjellësi bazë Docker për PgSQL kur përdoret operatori, doli se: mund të dërgohet parametrin WAL_S3_BUCKET i zbrazët, duke çaktivizuar kështu backup-et. Për më tepër, për gëzimin e madh u gjet dhe , të cilin e pranuam menjëherë në fork-un tonë. Tani mjafton të shtoni enableWALArchiving: false në burimin e klasterit PostgreSQL.
Po, kishte mundësi të veprohej ndryshe, duke aktivizuar 2 operatorë: një për staging (pa backup-e), dhe një tjetër - për prodhim. Por kështu arritëm ta menaxhojmë me një.
Mirë, mësuam të dërgojmë akses në bazat për S3 dhe backup-et filluan të kalojnë në shkarkim. Si ta bëjmë që faqet e backup-eve në Operator UI të funksionojnë?
Në Operator UI do të nevojitet të shtoni 3 variabla:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Pas kësaj, menaxhimi i backup-eve do të bëhet i aksesueshëm, gjë që në rastin tonë do të thjeshtësojë punën me staging, duke lejuar dorëzimin e kopjeve nga prodhimi pa skript të tjerë.
Si një avantazh tjetër u përmend puna me Teams API dhe mundësitë e gjera për krijimin e bazave dhe rolit përmes operatorit. Megjithatë, rolet e krijuara nuk kishin privilegje të paracaktuara.Si përfundim, përdoruesi me të drejtat e leximit nuk mund të lexonte tabelat e reja.
Pse kështu? Pavarësisht se në kod nevojitet GRANT, nuk nuk aplikohen gjithmonë. Ka dy metoda: syncPreparedDatabases dhe syncDatabases. Në syncPreparedDatabases — pavarësisht se në seksionin preparedDatabases ka një kusht defaultRoles dhe defaultUsers për krijimin e roleve, — të drejtat e paracaktuara nuk aplikohen. Ne jemi në procesin e përgatitjes së një patch për t’i aplikuar automatikisht këto të drejta.
Dhe momenti i fundit në përmirësimet e rëndësishme për ne — , duke shtuar Node Affinity në StatefulSet e krijuar. Klientët tanë shpesh preferojnë të reduktojnë shpenzimet duke përdorur instancat spot dhe në to nuk duhet të vendosen shërbime DB. Ky problem mund të zgjidhej edhe përmes tolerations, por prania e Node Affinity ofron më shumë siguri.
Çfarë arritëm?
Pas zgjidhjes së problemeve të përmendura, ne fork-uam Postgres Operator nga Zalando në , ku mbledh me patch-e kaq të dobishme. Dhe për një lehtësi të shtuar, përmbledhëm dhe .
Lista e PR-ve, të pranuara në fork:
- ;
- ;
- ;
- .
Do të ishte e shkëlqyer nëse komuniteti do ta mbështesë këto PR, në mënyrë që ato të shkojnë në upstream me versionin e ardhshëm të operatorit (1.6).
Bonus! Historia e suksesit me migrimin e prodhimit
Nëse përdorni Patroni, mund të migroni prodhimin aktiv në operator me një ndërprerje minimale.
Spilo lejon krijimin e klasterëve standby përmes kujtimeve S3 me , kur logu binar PgSQL e ruan fillimisht në S3 dhe më pas shkarkohet nga replika. Por çfarë të bëni nëse jo përdoret Wal-E në infrastrukturën e vjetër? Zgjidhja për këtë problem tashmë në Habré.
Vjen në ndihmë replikimi logjik i PostgreSQL. Megjithatë, nuk do të thellohemi në detaje, se si të krijojmë botimet dhe abonimet, sepse… plani ynë dështoi.
Problemi është që në DB kishte disa tabela të ngarkuara me miliona rreshta, të cilat gjithashtu, vazhdimisht plotsoseshin dhe fshiheshin. me copy_data, kur një replikë e re kopjon të gjithë përmbajtjen nga masteri, thjesht nuk arrinte të zhvillohej me masterin. Kopjimi i përmbajtjes funksionoi për një javë, por nuk e arriti kurrë masterin. Në fund, për të zgjidhur problemin ndihmoi koleget nga Avito: mund të transferohen të dhënat, duke përdorur pg_dump. Do ta përshkruaj versionin tonë (pak të përmirësuar) të këtij algoritmi.
Ideja është që mund të krijoni një regjistrim të ndalur të lidhur me një slot të caktuar replikimi dhe pastaj të korrigjoni numrin e transaksionit. Kishin qenë replika të gatshme për punën e production-it. Kjo është e rëndësishme, sepse replika do të ndihmojë në krijimin e një dump të konsistent dhe do të vazhdojë të marrë ndryshime nga masteri.
Në komandat e mëpasshme, që përshkruajnë procesin e migrimit, do të përdoren të следующие обозначения для хостов:
- master — serveri origjinal;
- replica1 — replika stream në production-in e vjetër;
- replica2 — replika logjike e re.
Plani i migrimit
1. Të krijojmë në master regjistrimin për të gjitha tabelat në skemën public të bazës dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Të krijojmë një slot replikimi në master:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Të ndalojmë replikimin në replikën e vjetër:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Të marrim numrin e transaksionit nga masteri:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Të shkarkojmë një dump nga replika e vjetër. Do ta bëjmë këtë në disa rrugë, çka do të ndihmojë përshpejtimin e procesit:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Të ngarkojmë dump-in në serverin e ri:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Pas ngarkimit të dump-it mund të fillojmë replikimin në replikën stream:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Të krijojmë një regjistrim në replikën logjike të re:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Të marrim oid regjistrimin:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Le të supozojmë se është marrë oid=1000. Të aplikojmë numrin e transaksionit në regjistrim:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Të fillojmë replikimin:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Të kontrollojmë statusin e regjistrimit, replikimi duhet të funksionojë:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Pas fillimit të replikimit dhe sinkronizimit të bazave, mund të kryen kalimi.
13. Pas ndërprerjes së replikimit, duhet të korrigjojmë sekuencat. Kjo është e përshkruar mirë .
Falë këtij plani, kalimi ka ndodhur me vonesa minimale.
Përfundim
Operatorët e Kubernetes lejojnë thjeshtimin e veprimeve të ndryshme duke i reduktuar në krijimin e burimeve K8s. Megjithatë, pas arritjes së një automatizimi të shkëlqyer me ndihmën e tyre, është e rëndësishme të mbani mend se kjo mund të sjellë edhe disa nuanca të papritura, prandaj zgjidhni operatorët me kujdes.
Pasi shqyrtuam tre operatorët më të njohur të Kubernetes për PostgreSQL, zgjodhëm projektin nga Zalando. E kemi pasur të nevojshme të përballojmë disa vështirësi, por rezultati na gëzoi vërtet, ndaj planifikojmë të zgjerojmë këtë përvojë edhe në disa instalime të tjera PgSQL. Nëse keni përvojë në përdorimin e zgjidhjeve të ngjashme — do të na pëlqente të shihnim detajet në komentet!
P.S.
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «».
Burimi: habr.com
