

Përshëndetje përsëri! Titulli i artikullit flet vetë. Para fillimit të kursit propozojmë të kuptojmë se kush janë inxhinierët e të dhënave. Në artikull ka shumë lidhje të dobishme. Lexim të këndshëm.
Një udhëzues i thjeshtë mbi atë se si të kapni valën e Inxhinierisë së Të Dhënave dhe të mos lejoni që ajo t'ju sjellë në puchin.
Duket se në ditët e sotme, çdo njeri dëshiron të bëhet një shkencëtar të dhënash (Data Scientist). Por çfarë bëhet me Inxhinierinë e Të Dhënave? Në thelb, ky është një hibrid midis analistit të të dhënave dhe shkencëtarit të të dhënave; inxhinieri i të dhënave zakonisht është përgjegjës për menaxhimin e proceseve, linjave të punës dhe proceseve ETL.Duke pasur parasysh rëndësinë e këtyre funksioneve, tani është një tjetër profesion në rritje që po merr përhapje.
Pagat e larta dhe kërkesa e madhe janë vetëm një pjesë e asaj që e bën këtë punë jashtëzakonisht tërheqëse! Nëse dëshironi të bëheni pjesë e heronjve, nuk është kurrë vonë të filloni të mësoni. Në këtë post, kam mbledhur të gjitha informacionet e nevojshme për t'ju ndihmuar të bëni hapat e parë.
Pra, le të fillojmë!
Çfarë është Inxhinieria e Të Dhënave?
Për të qenë të sinqertë, nuk ka një shpjegim më të mirë se ky:
«Një shkencëtar mund të zbulojë një yll të ri, por nuk mund ta krijojë atë. Ai do të duhet ta kërkojë inxhinierin që ta bëjë këtë për të.»
–Gordon Lindsay Glegg
Pra, roli i inxhinierit të të dhënave është mjaft i rëndësishëm.
Siç del në emër, inxhinieria e të dhënave ka të bëjë me të dhënat, në veçanti me dorëzimin, ruajtjen dhe përpunimin e tyre. Prandaj, detyra kryesore e inxhinierëve është të sigurojnë një infrastrukturë të besueshme për të dhënat. Nëse shikojmë në hierarkinë e nevojave të AI, inxhinieria e të dhënave zë 2-3 hapat e parë: mbledhja, lëvizja dhe ruajtja, përgatitja e të dhënave.
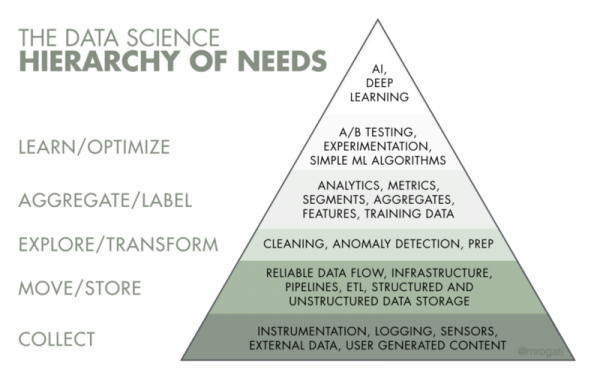
Çfarë bën inxhinieri i të dhënave?
Me ardhjen e të dhënave të mëdha, sfera e përgjegjësive është ndryshuar në mënyrë drastike. Nëse më parë këta ekspertë shkruanin kërkesa të mëdha SQL dhe transferonin të dhëna duke përdorur mjete si Informatica ETL, Pentaho ETL, Talend, tani kërkesat për inxhinierët e të dhënave janë rritur.
Shumica e kompanive që kanë pozita të hapura për inxhinierin e të dhënave kanë kërkesa të tilla:
- Njohuri të shkëlqyera të SQL dhe Python.
- Përvojë në punë me platforma cloud, në veçanti Amazon Web Services.
- Preferohet njohuria e Java/Scala.
- Njohuri të mira të bazave të të dhënave SQL dhe NoSQL (modelimi i të dhënave, ruajtja e të dhënave).
Kujdes, ky është vetëm thelbësor. Nga kjo listë mund të supozohet se inxhinierët e të dhënave janë specialistë në zhvillimin e programeve dhe backend.
Për shembull, nëse një kompani fillon të gjenerojë një sasi të madhe të dhënash nga burime të ndryshme, detyra juaj si inxhinier i të dhënave është të organizoni mbledhjen e informacionit, përpunimin dhe ruajtjen e tij.
Lista e mjeteve të përdorura në këtë rast mund të ndryshojë, gjithçka varet nga sasia e këtyre të dhënave, shpejtësia e mbërritjes së tyre dhe heterogjeniteti. Shumica e kompanive në të vërtetë nuk ballafaqohen me të dhëna të mëdha, prandaj si një depo e centralizuar, e ashtuquajtur depo e dhënash, mund të përdoret një bazë e të dhënave SQL (PostgreSQL, MySQL etj.) me një grup të vogël skriptesh që i drejtojnë të dhënat në depo.
Giantët e IT-së, si Google, Amazon, Facebook apo Dropbox, kërkojnë kërkesa më të larta: njohuri në Python, Java ose Scala.
- Përvoja me të dhënat e mëdha: Hadoop, Spark, Kafka.
- Njohuri mbi algoritmet dhe strukturat e të dhënave.
- Kuptimi i principeve të sistemeve të shpërndara.
- Përvoja me mjetet e vizualizimit të të dhënave, si Tableau ose ElasticSearch, do të ishte një avantazh i madh.
Pra, ka një prirje të dukshme drejt të dhënave të mëdha, sidomos në përpunimin e tyre nën ngarkesa të larta. Këto kompani kanë kërkesa më të larta për qëndrueshmërinë e sistemit.
Inxhinierët e të dhënave Vs. shkencëtarët e të dhënave
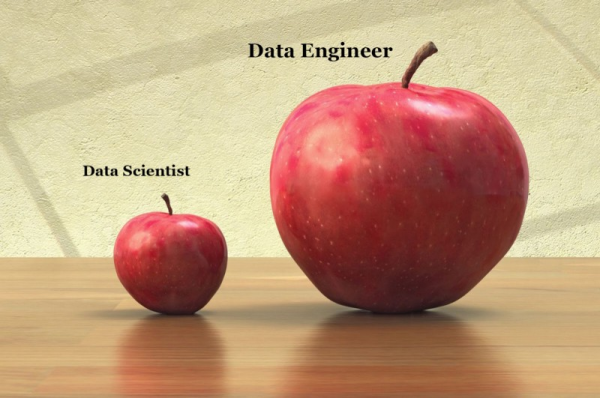
Epo, kjo ishte një krahasim i thjeshtë dhe argëtues (nuk është personale), por në të vërtetë, gjithçka është shumë më e komplikuar.
Së pari, duhet të dini se ekziston një sasi e konsiderueshme pasigurie në ndarjen e roleve dhe aftësive ndërmjet shkencëtarëve të të dhënave dhe inxhinierëve të të dhënave. Mënyra se si, mund të jeni lehtësisht të hutuar se cilat janë aftësitë e nevojshme për të qenë një inxhinier i suksesshëm i të dhënave. Sigurisht, ka disa aftësi që janë të përbashkëta për të dy rolet. Por gjithashtu ka një sërë aftësish diametralisht të kundërta.
Shkenca e të dhënave është një çështje serioze, por ne po shkojmë drejt një bote të shkencës funksionale të të dhënave, ku praktikantët janë të aftë të bëjnë analitikën e tyre. Për të angazhuar kanalet e të dhënave dhe strukturat e integruara të të dhënave, ju nevojiten inxhinierë të dhënash, jo shkencëtarë.
A është inxhinieri i të dhënave më i kërkuar se shkencëtari i të dhënave?
— Po, sepse para se të mund të përgatisni një tortë me karotë, së pari duhet të mbledhni, pastrohen dhe të siguroheni për karotat!
Inxhinieri i të dhënave ka njohuri më të thella në programim sesa çdo shkencëtar të dhënash, por kur vjen puna tek statistika, e gjithë situata është e kundërt.
Por ja përparësia e inxhinierit të të dhënave:
pa të, vlera e modelit prototip, më së shpeshti e përbërë nga një fragment kodi të cilësisë së mjerueshme në një skedë Python, e cila është marrë nga shkencëtari i të dhënave dhe në një farë mënyre jep rezultatin, priret drejt zeros.
Pa inxhinierin e të dhënave, ky kod kurrë nuk do të bëhet një projekt, dhe asnjë problem biznesi nuk do të zgjidhet në mënyrë efektive. Inxhinieri i të dhënave përpiqet ta kthejë të gjithë këtë në një produkt.
Të dhënat kryesore që një inxhinier i të dhënave duhet të dijë
Pra, nëse kjo punë zgjon në ju dritën dhe jeni të mbushur me entuziazëm — jeni të aftë të mësoni këtë, mund të zotëroni të gjitha aftësitë e nevojshme dhe të bëheni një yll rock në fushën e zhvillimit të të dhënave. Dhe, po, mund ta realizoni këtë edhe pa aftësi programimi ose njohuri të tjera teknike. Është e vështirë, por e mundshme!
Cilat janë hapat e parë?
Duhet të keni një kuptim të përgjithshëm të asaj që është çfarë.
Së pari, Inxhinieria e Të Dhënave lidhet me informatikën. Konkretisht — duhet të kuptoni algoritmet dhe strukturat e të dhënave efektive. Së dyti, pasi inxhinierët e të dhënave punojnë me të dhëna, duhet të kuptoni parimet e punës së bazave të të dhënave dhe strukturave që qëndrojnë pas tyre.
Për shembull, bazat e të dhënave të zakonshme B-tree SQL bazohen në strukturën e të dhënave B-Tree, si dhe, në depozitat moderne të shpërndara, LSM-Tree dhe modifikime të tjera të tabelave të hash.
* Këto hapa janë të bazuar në një artikull të shkëlqyer . Pra, nëse dini rusisht, mbështeteni këtë autor dhe lexoni .
1. Algoritmet dhe strukturat e të dhënave
Përdorimi i strukturës së duhur të të dhënave mund të përmirësojë ndjeshëm performancën e algoritmit. Idealisht, të gjithë ne duhet të mësojmë strukturat e të dhënave dhe algoritmet në shkollat tona, por kjo është e rrallë që përmendet. Megjithatë, nuk është kurrë vonë të njihemi.
Pra, këtu janë kurset e mia të preferuara falas për të mësuar strukturat e të dhënave dhe algoritmet:
Plus mos ju që të mos harroni punën klasike mbi algoritmet e Thomas Cormen - . Ky është një udhëzues ideal kur ju nevojitet të freskoni memorjen tuaj.
- Për të përmirësuar aftësitë tuaja, përdorni .
Ju gjithashtu mund të zhytni në botën e bazave të të dhënave me videokasetë fantastike nga Universitetei Carnegie Mellon në Youtube:
- .
- .
2. Mësimi i SQL
Gjithë jeta jonë është të dhëna. Dhe për të nxjerrë këto të dhëna nga një bazë të dhënash, duhet të 'flisni' me to në një gjuhë të përbashkët.
SQL (Gjuha e Kërkesave të Strukturuara) është gjuha e komunikimit në fushën e të dhënave. Pavarësisht se çfarë mund të thonë, SQL ka jetuar, jeton dhe do të jetojë për një kohë të gjatë.
Nëse keni qenë një zhvillues për një kohë të gjatë, ndoshta e keni vënë re se thashethemet për vdekjen e shpejtë të SQL-it dalin herë pas here. Gjuha u zhvillua në fillim të viteve '70 dhe ende është shumë e njohur midis analistëve, zhvilluesve dhe vetëm entuziastëve.
Pa njohuri të SQL në inxhinierinë e të dhënave, nuk do të bëni shumë, pasi patjetër do t'ju duhet të krijoni kërkesa për të nxjerrë të dhënat. Të gjitha depozitë moderne të të dhënave të mëdha mbështesin SQL-in:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… dhe shumë të tjera.
Për të analizuar një sërë të dhënash të ruajtura në sisteme të shpërndara si HDFS, janë shpikur mekanizmat SQL: Apache Hive, Impala etj. Shihni, ai nuk planifikon të shkojë askund.
Si të mësoni SQL? Thjesht praktikoni.
Për këtë, do të rekomandoja të njihni një udhëzues të shkëlqyer, i cili, për fat të mirë, është falas, nga .
Karakteristika dalluese e këtyre kurseve është prania e një mjedisi interaktiv ku mund të shkruani dhe ekzekutoni kërkesa SQL direkt në shfletues. Burimi nuk do të ishte i panevojshëm. Dhe ju mund të aplikoni këto njohuri në në seksionin e Bazave të të Dhënave.
3. Programimi në Python dhe Java/Scala
Pse ia vlen të mësoni gjuhën e programimit Python, unë kam shkruar tashmë në artikullin . Sa i përket Java dhe Scala, shumica e mjeteve për ruajtjen dhe përpunimin e volumit të madh të të dhënave janë shkruar në këto gjuhë. Për shembull:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Për të kuptuar se si funksionojnë këto mjete, ju duhet të njihni gjuhët në të cilat janë shkruar. Qasja funksionale e Scala-s lejon zgjidhjen efikase të problemeve të përpunimit paralel të të dhënave. Python, fatkeqësisht, nuk mund të krenojë me shpejtësinë dhe përpunimin paralel. Në përgjithësi, njohja e disa gjuhëve dhe paradigmat e programimit e ndihmojnë shumë në gjerësinë e qasjeve për zgjidhjen e problemeve.
Për të thelluar njohuritë në gjuhën Scala, mund të lexoni nga autori i gjuhës. Po ashtu, kompania Twitter ka publikuar një udhëzues të mirë hyrës — .
Sa i përket Python, mendoj që është libri më i mirë për nivelin mesatar.
4. Mjetet për punën me të dhëna të mëdha
Ja një listë e mjeteve më të popullarizuara në botën e të dhënave të mëdha:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Më shumë informacion në lidhje me ndërtimin e blokëve të mëdhenj të të dhënave mund të gjeni në këtë mjedis të jashtëzakonshëm Mjetet më popullore janë Spark dhe Kafka. Ato patjetër që duhet të studiohen, e preferueshme të kuptoni se si funksionojnë nga brenda. Jay Kreps (bashkautor i Kafka-s) në vitin 2013 publikoi një punim monumentale , përtej, idetë kryesore nga ky traktat u përdorën për krijimin e Apache Kafka.
- Një hyrje në Hadoop mund të sjellë .
- Udhëzuesi më i plotë për Apache Spark për mua është — .
5. Platformat në re
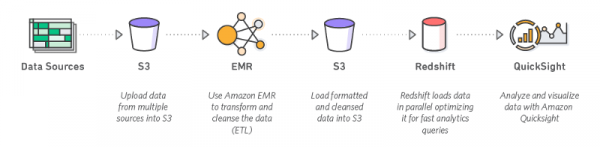
Njohja e të paktën një platforme në re është në listën e kërkesave bazë për ata që aplikojnë për pozita inxhinieri të dhënash. Punëdhënësit preferojnë Amazon Web Services, në vendin e dytë është platforma në re e Google, dhe në vendin e tretë Microsoft Azure.
Ju duhet të jeni të njohur mirë me Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Sistem të shpërndarë
Puna me të dhëna të mëdha nënkupton ekzistencën e klasterave të kompjuterëve që punojnë pavarësisht nga njëri-tjetri, me lidhje midis tyre që bëhet përmes rrjetit. Sa më i madh të jetë klasteri, aq më shumë rritet mundësia e dështimit të nyjeve të tij. Për t'u bërë një ekspert i shkëlqyer në fushën e të dhënave, ju nevojitet të thelloheni në problemet dhe zgjidhjet ekzistuese për sistemet e shpërndara. Ky fushë është e vjetër dhe komplekse.
Andrew Tanenbaum konsiderohet një pionier në këtë fushë. Për ata që nuk kanë frikë nga teoria, unë rekomandoj librin e tij , për fillestarët mund të duket e komplikuar, por kjo do t'ju ndihmojë për të përmirësuar aftësitë tuaja.
Unë mendoj është libri më i mirë hyrës. Për fat të mirë, Martin ka një . Vepra e tij do të ndihmojë të sistematizoni njohuritë mbi ndërtimin e infrastrukturës moderne për ruajtjen dhe përpunimin e të dhënave të mëdha.
Për ata që pëlqejnë të shohin video, në Youtube ka një kurs .
7. Tubacionet e të Dhënave
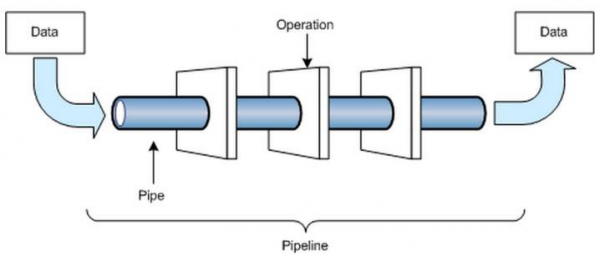
Tubacionet e të dhënave janë diçka pa të cilën nuk mund të jetoni si inxhinier të dhënash.
Pjesën më të madhe të kohës, inxhinieri i të dhënave ndalon në ndërtimin e asaj që quhet tubacion i dhënave, dmth krijon një proces për të dërguar të dhëna nga një vend në një tjetër. Këto mund të jenë skenarë përdoruesish që shkojnë në API-në e një shërbimi të jashtëm ose bëjnë një kërkesë SQL, plotësojnë të dhënat dhe i vendosin ato në një magazinë qendrore (magazina e të dhënave) ose në një magazinë të dhënash të pa strukturuara (lago të dhënash).
Për t'i bërë një përmbledhje: lista kryesore e kontrollit të inxhinierit të dhënave
Në përfundim — është e nevojshme një kuptim i mirë i gjërave në vijim:
- Sistemet e Informacionit;
- Zhvillimi i Softuerit (Agile, DevOps, Teknikat e Projektimit, SOA);
- Sistemet e Shpërndara dhe Programimi Paralel;
- Bazat e të Dhënave — planifikimi, projektimi, operimi dhe diagnostikimi i problemeve;
- Projektimi i Eksperimenteve — Testet A/B për të provuar konceptet, për të përcaktuar besueshmërinë, performancën e sistemeve, si dhe për të zhvilluar rrugë të besueshme për ofrimin e zgjidhjeve të mira.
Këto janë vetëm disa kërkesa për të qenë inxhinier të dhënash, prandaj studioni dhe kuptoni sistemet e të dhënave, sistemet e informacionit, dërgimin/tërheqjen/integrimin e vazhdueshëm, gjuhët e programimit dhe tema të tjera të informatikës (jo në të gjitha fushat akademike).
Dhe, në fund, e fundit, por shumë e rëndësishme, që dua të them.
Rruga për t'u bërë Inxhinier të të Dhënave nuk është aq e lehtë sa mund të duket. Ajo nuk fal, frustron, dhe ju duhet të jeni të gatshëm për këtë. Disa momente në këtë udhëtim mund t'ju shtyjnë ta braktisni gjithçka. Por kjo është një punë e vërtetë dhe një proces mësimi.
Thjesht mos e zbukuroni që në fillim. E gjithë kuptimi i udhëtimit është të mësoni sa më shumë dhe të jeni të gatshëm për sfida të reja.
Ja një imazh të shkëlqyer që kam gjetur, i cili ilustron mirë këtë moment:
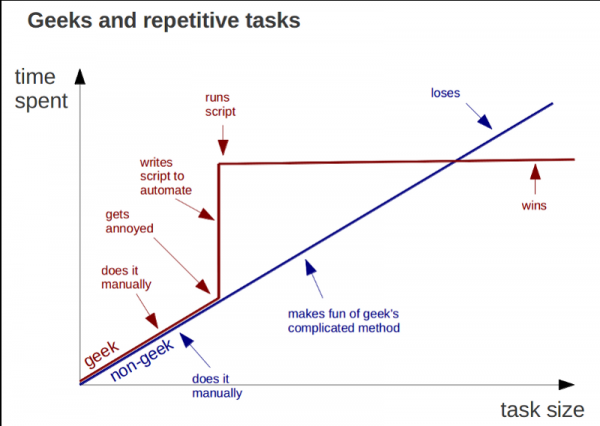
Dhe po, mos harxhoni energjinë tuaj dhe merrni pushime. Kjo është gjithashtu shumë e rëndësishme. Fat të mbarë!
Si ju duket artikulli, miq? Ju ftojmë në , i cili do të mbahet sot në ora 20:00. Gjatë webinarit do të diskutojmë se si të ndërtoni një sistem të efektshëm dhe të shkallëzueshëm për përpunimin e të dhënave për një kompani të vogël apo një startup me kosto minimale. Si pjesë e praktikës, do të njohim mjetet për përpunimin e të dhënave në Google Cloud. See you there!
Burimi: habr.com
