

Shën. përkth.: Ky artikull, i shkruar nga Galo Navarro, Principal Software Engineer në kompaninë evropiane Adevinta, është një “hetim” tërheqës dhe mjaft udhëzues në fushën e operimit të infrastrukturës. Titulli origjinal është plotësuar paksa në përkthim për një arsye që autori e shpjegon që në fillim.
Shënim nga autori: Me sa duket, ky publikim shumë më tepër vëmendje sesa pritej. Ende marr komente të zemëruara se titulli i artikullit është çorientues dhe se disa lexues janë zhgënjyer. E kuptoj pse po ndodh kjo, ndaj, edhe me rrezikun për t’ia prishur gjithë intrigën, dua ta sqaroj menjëherë se për çfarë flet ky artikull. Gjatë kalimit të ekipeve në Kubernetes, kam vërejtur një dukuri interesante: sa herë që shfaqet një problem, për shembull rritja e vonesës pas migrimit, faji i vihet menjëherë Kubernetes, por më pas del se orkestruesi, në thelb, nuk ka faj. Ky artikull tregon një rast të tillë. Titulli i tij përsërit thirrjen e njërit prej zhvilluesve tanë (më vonë do ta shihni se Kubernetes nuk ka aspak lidhje me këtë). Këtu nuk do të gjeni zbulime të papritura për Kubernetes, por mund të prisni disa mësime të vlefshme mbi sistemet komplekse.
Para disa javësh, ekipi im po merrej me migrimin e një mikroshërbimi në platformën kryesore, e cila përfshin CI/CD, një mjedis pune të bazuar në Kubernetes, metrika dhe mjete të tjera të dobishme. Ky transferim kishte karakter pilot: planifikonim ta përdornim si bazë dhe gjatë muajve në vijim të transferonim edhe rreth 150 shërbime të tjera. Të gjitha ato mbështesin funksionimin e disa prej platformave më të mëdha online në Spanjë (Infojobs, Fotocasa etj.).
Pasi e vendosëm aplikacionin në Kubernetes dhe ridrejtuam drejt tij një pjesë të trafikut, na priste një surprizë shqetësuese. Vonesa e (latency) kërkesave në Kubernetes ishte 10 herë më e lartë se në EC2. Pra, duhej ose të gjenim një zgjidhje për këtë problem, ose të hiqnim dorë nga migrimi i mikroshërbimit (dhe ndoshta nga i gjithë projekti).
Pse është vonesa në Kubernetes kaq shumë më e lartë se në EC2?
Për të gjetur ngushticën, mblodhëm metrika përgjatë gjithë rrugës së kërkesës. Arkitektura jonë është e thjeshtë: API gateway (Zuul) i prokson kërkesat te instancat e mikroshërbimit në EC2 ose Kubernetes. Në Kubernetes përdorim NGINX Ingress Controller, ndërsa backend-et janë objekte të zakonshme të llojit me një aplikacion JVM në platformën Spring.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Publik       |      |  |
      -------> ZUUL +--+
trafik      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Dukej se problemi lidhej me vonesën në fazën fillestare të përpunimit në backend (segmentin problematik në skemë e kam shënuar si «xx»). Në EC2, përgjigjja e aplikacionit merrte rreth 20 ms. Në Kubernetes, vonesa rritej në 100–200 ms.
Shpejt përjashtuam të dyshuarit më të mundshëm që lidhen me ndryshimin e mjedisit të ekzekutimit. Versioni i JVM mbeti i njëjtë. As kontejnerizimi nuk ishte shkaku: aplikacioni tashmë funksiononte me sukses në kontejnerë në EC2. Ngarkesa? Por vërenim vonesë të lartë edhe me 1 kërkesë në sekondë. Edhe pauzat e mbledhjes së mbeturinave mund të shpërfilleshin.
Njëri nga administratorët tanë të Kubernetes pyeti nëse aplikacioni kishte varësi të jashtme, pasi më parë kërkesat DNS kishin shkaktuar probleme të ngjashme.
Hipoteza 1: Zgjidhja e emrave DNS
Në çdo kërkesë, aplikacioni ynë kontakton nga një deri në tre herë një instancë AWS Elasticsearch në një domen si p.sh. elastic.spain.adevinta.com. Brenda kontejnerëve ne , prandaj mund të verifikojmë nëse kërkimi i domenit vërtet kërkon shumë kohë.
Kërkesa DNS nga kontejneri:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Kërkesa të ngjashme nga një prej instancave EC2 ku po ekzekutohet aplikacioni:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Duke qenë se kërkimi zgjat rreth 30 ms, u bë e qartë se zgjidhja DNS gjatë lidhjes me Elasticsearch vërtet kontribuonte në rritjen e vonesës.
Megjithatë, kjo ishte e çuditshme për dy arsye:
- Ne kemi tashmë shumë aplikacione në Kubernetes që ndërveprojnë me burimet e AWS, por nuk vuajnë nga vonesa të mëdha. Cilado qoftë arsyeja, ajo lidhet pikërisht me këtë rast.
- Ne e dimë që JVM kryen cache DNS në memorie. Në imazhet tona, vlera TTL është përcaktuar në
$JAVA_HOME/jre/lib/security/java.securitydhe është vendosur në 10 sekonda:networkaddress.cache.ttl = 10. Me fjalë të tjera, JVM duhet t’i ruajë në cache të gjitha kërkesat DNS për 10 sekonda.
Për të konfirmuar hipotezën e parë, vendosëm të heqim përkohësisht dorë nga thirrjet DNS dhe të shohim nëse problemi do të zhdukej. Fillimisht vendosëm ta rikonfiguronim aplikacionin që të lidhej me Elasticsearch drejtpërdrejt përmes adresës IP, dhe jo përmes emrit të domenit. Kjo do të kërkonte ndryshim të kodit dhe një deployment të ri, ndaj thjesht e mapuam domenin me adresën e tij IP në /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comTani kontejneri e merrte IP-në pothuajse menjëherë. Kjo solli një përmirësim të caktuar, por ne vetëm sa iu afruam pak nivelit të pritshëm të vonesës. Edhe pse zgjidhja DNS merrte shumë kohë, shkaku i vërtetë ende na shpëtonte.
Diagnostikimi përmes rrjetit
Vendosëm të analizonim trafikun nga kontejneri me ndihmën e tcpdump, për të ndjekur saktësisht se çfarë po ndodh në rrjet:
[root@be-851c76f696-alf8z /]# tcpdump -leni any -w capture.pcap Më pas dërguam disa kërkesa dhe shkarkuam capture-in e tyre (kubectl cp my-service:/capture.pcap capture.pcap) për analizë të mëtejshme në .
Në kërkesat DNS nuk kishte asgjë të dyshimtë (përveç një detaji të vogël, për të cilin do të flas më vonë). Por kishte disa çudi në mënyrën se si shërbimi ynë përpunonte çdo kërkesë. Më poshtë është një pamje nga capture-i, që tregon pranimin e kërkesës deri në fillimin e përgjigjes:
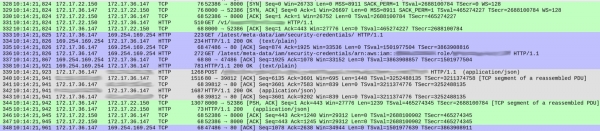
Numrat e paketave janë dhënë në kolonën e parë. Për qartësi, kam theksuar me ngjyra rrjedhat e ndryshme TCP.
Rrjedha e gjelbër, që fillon nga paketa 328, tregon se si klienti (172.17.22.150) krijoi një lidhje TCP me kontejnerin (172.17.36.147). Pas handshake-it fillestar (328-330), paketa 331 solli HTTP GET /v1/.. — kërkesën hyrëse drejt shërbimit tonë. I gjithë procesi zgjati 1 ms.
Rrjedha gri (nga paketa 339) tregon se shërbimi ynë dërgoi një kërkesë HTTP te instanca e Elasticsearch (nuk ka TCP handshake, sepse po përdoret një lidhje ekzistuese). Kjo mori 18 ms.
Deri këtu gjithçka është në rregull dhe kohët përafërsisht përputhen me vonesat e pritshme (20-30 ms në matjet nga klienti).
Megjithatë, seksioni blu zgjat 86 ms. Çfarë ndodh aty? Me paketën 333, shërbimi ynë dërgoi një kërkesë HTTP GET te /latest/meta-data/iam/security-credentials, dhe menjëherë pas saj, mbi të njëjtin lidhje TCP, edhe një kërkesë tjetër GET te /latest/meta-data/iam/security-credentials/arn:...
Zbuluam se kjo përsëritej me çdo kërkesë përgjatë gjithë gjurmimit. Zgjidhja e DNS është vërtet pak më e ngadaltë në kontejnerët tanë (shpjegimi i këtij fenomeni është mjaft interesant, por do ta ruaj për një artikull më vete). Doli se shkaku i vonesave të mëdha ishin thirrjet ndaj shërbimit AWS Instance Metadata në çdo kërkesë.
Hipoteza 2: thirrje të panevojshme drejt AWS
Të dy endpoint-et i përkasin . Mikrosherbimi ynë e përdor këtë shërbim gjatë punës me Elasticsearch. Të dyja thirrjet janë pjesë e procesit bazë të autorizimit. Endpoint-i që thirret nga kërkesa e parë kthen rolin IAM të lidhur me instancën.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
Kërkesa e dytë i drejtohet endpoint-it të dytë për të marrë kredenciale të përkohshme për këtë instancë:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
Klienti mund t’i përdorë ato për një periudhë të shkurtër kohe dhe periodikisht duhet të marrë kredenciale të reja (deri në Expiration). Modeli është i thjeshtë: AWS bën rotacion të shpeshtë të çelësave të përkohshëm për arsye sigurie, por klientët mund t’i ruajnë në cache për disa minuta, duke kompensuar uljen e performancës që lidhet me marrjen e kredencialeve të reja.
AWS Java SDK duhet të merret me organizimin e këtij procesi, por për ndonjë arsye kjo nuk po ndodh.
Duke kërkuar te issues në GitHub, hasëm problemin . Ai na ndihmoi të përcaktonim drejtimin ku duhej të "gërmonim" më tej.
AWS SDK i rifreskon kredencialet kur plotësohet një nga kushtet e mëposhtme:
- Afati i skadimit të tyre (
Expiration) hyn nëEXPIRATION_THRESHOLD, i vendosur në mënyrë të pandryshueshme në kod në 15 minuta. - Që nga përpjekja e fundit për të rifreskuar kredencialet ka kaluar më shumë kohë se
REFRESH_THRESHOLD, i hardcode-uar në 60 minuta.
Për të parë afatin real të skadimit të kredencialeve që merrnim, ekzekutuam komandat cURL të mësipërme nga kontejneri dhe nga instanca EC2. Kohëzgjatja e kredencialit të marrë nga kontejneri doli të ishte shumë më e shkurtër: saktësisht 15 minuta.
Tani gjithçka u bë e qartë: për kërkesën e parë, shërbimi ynë merrte certifikata të përkohshme. Meqenëse afati i tyre i vlefshmërisë nuk i kalonte 15 minuta, gjatë kërkesës pasuese AWS SDK vendoste t’i rinovonte. Dhe kjo ndodhte me çdo kërkesë.
Pse afati i vlefshmërisë së certifikatave u shkurtua?
Shërbimi AWS Instance Metadata është krijuar për të punuar me instancat EC2, jo me Kubernetes. Nga ana tjetër, ne nuk donim të ndryshonim ndërfaqen e aplikacioneve. Për këtë përdorëm — një mjet që, me ndihmën e agjentëve në çdo nyje Kubernetes, u lejon përdoruesve (inxhinierëve që vendosin aplikacionet në cluster) t’u caktojnë role IAM konteinerëve në pod-e, sikur të ishin instanca EC2. KIAM kap thirrjet drejt shërbimit AWS Instance Metadata dhe i përpunon ato nga cache-i i vet, pasi i merr paraprakisht nga AWS. Nga këndvështrimi i aplikacionit, asgjë nuk ndryshon.
KIAM u furnizon pod-eve certifikata afatshkurtra. Kjo është e arsyeshme, duke pasur parasysh se kohëzgjatja mesatare e jetës së një pod-i është më e shkurtër se ajo e një instance EC2. Si parazgjedhje, afati i vlefshmërisë së certifikatave .
Si përfundim, nëse i vendosim këto dy vlera të parazgjedhura njëra mbi tjetrën, lind problemi. Çdo certifikatë e dhënë aplikacionit skadon pas 15 minutash. Ndërkohë, AWS Java SDK rinovon me detyrim çdo certifikatë së cilës i kanë mbetur më pak se 15 minuta deri në skadim.
Si rezultat, certifikata e përkohshme rinovohet me detyrim në çdo kërkesë, gjë që sjell disa thirrje drejt API të AWS dhe çon në një rritje të ndjeshme të vonesës. Në AWS Java SDK gjetëm një , ku përmendet një problem i ngjashëm.
Zgjidhja doli të ishte e thjeshtë. Thjesht e rikonfiguruam KIAM që të kërkonte certifikata me afat vlefshmërie më të gjatë. Sapo ndodhi kjo, kërkesat filluan të kalonin pa përfshirjen e shërbimit AWS Metadata, dhe vonesa ra madje në një nivel edhe më të ulët se në EC2.
Përfundimet
Bazuar në përvojën tonë me migrimet, mund të themi se një nga burimet më të shpeshta të problemeve nuk janë gabimet në Kubernetes apo në elementë të tjerë të platformës. Po ashtu, ai nuk lidhet me ndonjë mangësi themelore të mikrosherbimeve që po migrojmë. Problemet shpesh lindin thjesht sepse po bashkojmë së bashku elementë të ndryshëm.
Ne po përziejmë sisteme komplekse që më parë nuk kanë ndërvepruar kurrë me njëri-tjetrin, duke pritur që së bashku të formojnë një sistem të vetëm, më të madh. Fatkeqësisht, sa më shumë elemente të ketë, aq më shumë hapësirë ka për gabime dhe aq më e lartë bëhet entropia.
Në rastin tonë, vonesa e lartë nuk ishte rezultat i gabimeve ose vendimeve të këqija në Kubernetes, KIAM, AWS Java SDK apo në mikroshërbimin tonë. Ajo ishte pasojë e bashkimit të dy parametrave të pavarur të vendosur si parazgjedhje: njëri në KIAM, tjetri në AWS Java SDK. Veçmas, të dy parametrat kanë kuptim: si politika aktive e rinovimit të certifikatave në AWS Java SDK, ashtu edhe afati i shkurtër i vlefshmërisë së certifikatave në KIAM. Por kur i kombinon, rezultatet bëhen të paparashikueshme. Dy zgjidhje të pavarura dhe logjike nuk do të thotë domosdoshmërisht se kanë kuptim kur bashkohen.
P.S. nga përkthyesi
Mësoni më shumë rreth arkitekturës së mjetit KIAM për integrimin e AWS IAM me Kubernetes në nga krijuesit e tij.
Ndërsa në blogun tonë lexoni edhe:
- «»;
- «»;
- «»;
- «».
Burimi: habr.com
