

Unë quhem Viktor Yagofarov dhe merrem me zhvillimin e platformës Kubernetes në kompaninë DomKlik si drejtori teknik i zhvillimit në ekipin Ops (operacionet). Do doja të flas për organizimin e proceseve tona Dev Ops, për karakteristikat e operimit të një prej klasterëve më të mëdhenj k8s në Rusi, si dhe për praktikat DevOps/SRE që ekipi ynë aplikon.
Ekipi Ops
Në ekipin Ops aktualisht punojnë 15 persona. Tre nga ata janë përgjegjës për zyrën, dy punojnë në një tjetër zonë kohore dhe janë të disponueshëm, përfshirë natën. Kështu, gjithmonë dikush nga Ops është pranë monitorit dhe i gatshëm të reagojë ndaj çdo incidenti. Nuk kemi ndërrime nate, çka ruan shëndetin tonë mendor dhe na jep mundësinë të flejmë dhe t’i kalojmë momentet e lira jo vetëm para kompjuterit.
Kompentencat e të gjithëve janë të ndryshme: specialistë të rrjetit, DBA, specialistë të stackut ELK, administrues/kodues Kubernetes, specialistë për monitorim, virtualizim, harduer etj. E vetmja gjë që i bashkon është se çdo njeri mund të zëvendësojë ndonjë nga ne: për shembull, të futë nodo të reja në klasterin k8s, të përditësojë PostgreSQL, të shkruajë pipeline CI/CD + Ansible, të automatizojë diçka në Python/Bash/Go, të lidhi ndonjë harduer në Qendrën e të Dhënave. Kompetencat e forta në ndonjë fushë nuk pengojnë kalimin në një drejtim tjetër dhe fillimin e zhvillimit në një fushë tjetër. Për shembull, unë u punësova në kompani si ekspert për PostgreSQL, dhe tani zona ime kryesore e përgjegjësisë janë klasterët Kubernetes. Në ekip, çdo rritje është e përshëndetur, dhe ndjenja e mbështetjes është shumë e zhvilluar.
Megjithatë, ne jemi në kërkim të talenteve. Kërkesat për kandidatë janë mjaft standarde. Personalisht, për mua është e rëndësishme që një person të integrohet në kolektiv, të jetë i pa konflikt dhe gjithashtu të jetë në gjendje të mbrojë pikëpamjet e tij, të dëshirojë të zhvillohet dhe të mos ketë frikë të bëjë diçka të re, duke propozuar idetë e veta. Gjithashtu, janë të nevojshme aftësi në programimin e gjuhëve të script-it, njohuri të bazave të Linux dhe gjuhës angleze. Anglishtja nevojitet thjesht për qëllim që personi, në rast problemi, të mund të kërkojë zgjidhje brenda 10 sekondave, e jo 10 minutave. Me specialistët që kanë njohuri të thella në Linux tani është shumë e vështirë: është qesharake, por dy kandidatë nga tre nuk mund të përgjigjen në pyetjen “Çfarë është Load Average? Nga çfarë përballet?”, ndërsa pyetjen “Si të mbledhim core dump nga një program në C” e konsiderojnë diçka nga bota e supernjerëzve… ose dinosaurëve. Kjo është diçka që duhet pranuar, pasi zakonisht njerëzit kanë kompetenca të tjera shumë të zhvilluara, dhe ne do t'i mësojmë ‘linux’-it. Përgjigjen e pyetjes “pse është e nevojshme të dihet kjo për një inxhinier DevOps në botën moderne të reve” do ta lëmë jashtë këtij artikulli, por nëse do të thoshim në tri fjalë: për çdo gjë është e nevojshme.
Ekipa e Tools
Një rol të konsiderueshëm në automatizim luan ekipa e Tools. Detyra e tyre kryesore është krijimi i mjeteve grafike dhe CLI të përshtatshme për zhvilluesit. Për shembull, zhvillimi ynë i brendshëm Confer lejon që përmes disa klikimeve të nxirren aplikacionet në Kubernetes, të konfigurohen burimet e saj, çelësat nga vault, etj. Më parë kishim Jenkins + Helm 2, por u desh të zhvillonim një mjet të veçantë për të eliminuar kopjimin dhe ngjitjen dhe për të sjellë një njësi në ciklin e jetës së softuerit.
Ekipa Ops nuk shkruan pipeline për zhvilluesit, por mund të këshillojë për çdo çështje në lidhje me shkresat e tyre (disa akoma kanë Helm 3).
DevOps
Për sa i përket DevOps, ne e shohim ashtu:
Ekipa Dev shkruan kod, e nxjerr atë përmes Confer në dev -> qa/stage -> prod. Përgjegjësia për të siguruar që kodi të mos ngadalësohet dhe të mos nxjerrë gabime, është në duar të ekipeve Dev dhe Ops. Gjatë ditës, reagimi ndaj incidentit me aplikacionin e tij duhet të bëhet, në radhë të parë, nga turni i ekipit Ops, ndërsa në orët e mbrëmjes dhe natës, administratori në turn (Ops) duhet të zgjojë zhvilluesin në turn, nëse e di me siguri që problemi nuk ndodhet në infrastrukturë. Të gjitha metrikat dhe alarmin në monitorim shfaqen automatikisht ose gjysmë automatikisht.
Zona e përgjegjësisë Ops fillon në momentin e lançimit të aplikacionit në prodhim, por përgjegjësia e Dev nuk mbaron këtu — ne po bëjmë një punë dhe jemi në të njëjtën kayak.
Zhvilluesit konsultojnë administratorët nëse kanë nevojë për ndihmë në shkruarjen e një mikroshërbimi administrativ (p.sh., Go backend + HTML5), ndërsa administratorët konsultojnë zhvilluesit për çdo çështje infrastrukturore ose pyetje të lidhura me k8s.
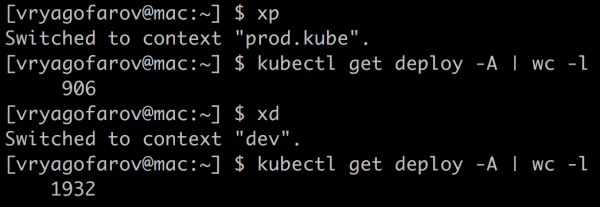
Për më tepër, ne nuk kemi asnjë monolit, vetëm mikroshërbime. Numri i tyre aktualisht varion midis 900 dhe 1000 në prodhimin e klasterit k8s, nëse matet sipas numrit të deployed. Numri i pod-ëve varion midis 1700 dhe 2000. Aktualisht ka rreth 2000 pod-e në klasterin prodhues.
Nuk mund të jap numra të saktë, pasi ne ndjekim mikroshërbimet e panevojshme dhe i eliminojmë ato në një mod të gjysmëautomatizuar. Ndihma për të monitoruar entitetet e panevojshme në k8s na jep , që ndihmon në ruajtjen e burimeve dhe parave.
Menaxhimi i burimeve
Monitorimi
Themel i rëndësishëm në eksploatimin e një klasteri të madh bëhet një monitorim i strukturuar dhe informues. Ne ende nuk kemi gjetur një zgjidhje universal që të mbulojë 100% të të gjitha "dëshirave" për monitorim, prandaj herë pas here krijojmë zgjidhje të ndryshme të personalizuara në këtë fushë.
- Zabbix. Monitorimi i vjetër i mirë, i cili është i destinuar, mbi të gjitha, për të ndjekur gjendjen e përgjithshme të infrastrukturës. Ai na tregon kur një nodë dështon në CPU, memorie, disqe, rrjet dhe kështu me radhë. Asgjë super natyrale, por gjithashtu kemi një DaemonSet të veçantë nga agjentët, me të cilët, për shembull, ne monitorojmë gjendjen e DNS në klaster: gjejmë pod-et që kanë ngadalësuar coredns, kontrollojmë aksesin e hosteve të jashtme. Mund të duket se përse të angazhohemi për këtë, por në volumin e madh të trafikut, ky komponent është një pikë e rëndësishme dështimi. Më parë kam folur , për mënyrën se si luftova me performancën e DNS në klaster.
- Prometheus Operator. Një grup i ndryshëm eksportuesish ofron një përmbledhje të gjerë të të gjithë komponentëve të klasterit. Më pas e vizualizojmë të gjithë këtë në tabela të mëdha në Grafana, dhe për njoftimet përdorim alertmanager.
Një tjetër mjet i dobishëm për ne është E shkruam atë pasi u përballëm disa herë me situatën kur një ekip mbulonte rrugët e Ingress-it të një ekipi tjetër, duke shkaktuar gabime 50x. Tani, para se të implementojnë në prodhim, zhvilluesit kontrollojnë se nuk do të prekin askënd, dhe për ekipin tim ky është një mjet i mirë për diagnostikimin fillestar të problemeve me Ingress. Është qesharake që fillimisht u shkrua për administratorët dhe dukej mjaft «tezgjuhë», por pasi mjeti u pëlqyer ekipet zhvillimore, u transformua shumë dhe nuk dukej si «administrator bëri një ndërfaqe për administratorët». së shpejti do të heqim dorë nga ky mjet dhe situata të tilla do të validohen edhe para se të implementohet pipeline.
Burimet e ekipeve në «Kube»
Para se të fillojmë me shembujt, është e rëndësishme të shpjegojmë se si funksionon ndarja e burimeve për mikroshërbimeve.
Për të kuptuar cilat ekipe dhe në cilat sasi përdorin burimet e tyre burimeve (procesori, memoria, SSD lokal), ne i ndarim çdo ekipi burimet e tij namespace në «Kube» dhe kufizojmë mundësitë maksimale të tij për procesorin, memorien dhe diskun, pas diskutimit të nevojave të ekipeve. Në përputhje me këtë, një ekip, në rregullin e përgjithshëm, nuk do të bllokojë gjithë klastern për implementimin, duke siguruar mijëra bërthama dhe terabajt memorie për vete. Aksesi në namespace jepet përmes AD (ne përdorim RBAC). Namespace-t dhe kufizimet e tyre shtohen përmes këtyre kërkesave në GIT-repozitorin, dhe më pas përmes pipeline-it Ansible, gjithçka implementohet automatikisht.
Shembull i ndarjes së burimeve për ekipin:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Kërkesat dhe kufizimet
Në «Kube» Request — është sasia e burimeve të garantuara të rezervuara për pod (një ose më shumë kontejnerë docker) në klaster. Limit është maksimumi i pa garantuar. Shpesh mund të shihni në grafikat se si një ekip ka vendosur shumë kërkesa për të gjitha aplikacionet e tij dhe nuk mund të implementojë aplikacionin në «Kube», pasi të gjitha kërkesat në namespace të tyre tashmë janë «shpenzuar».
Zgjidhja e duhur për një situatë të tillë: të shikoni konsumimin real të burimeve dhe ta krahasoni me sasinë e kërkuar (Request).
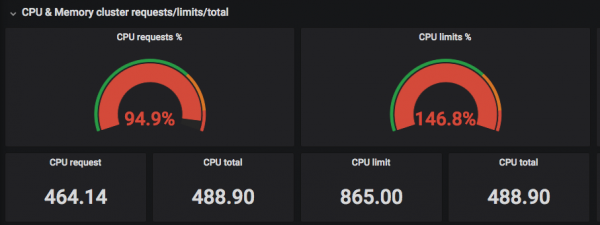
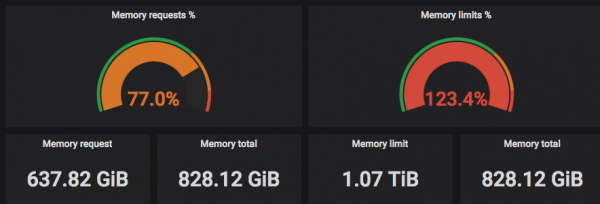
Në ekranet e mësipërme shihet se kërkesat (Requested) e CPU-së përshtaten me sasinë reale të fijeve, ndërsa kufijtë mund të tejkalojnë sasinë reale të fijeve të procesorëve =)
Tani do të shqyrtojmë në detaje ndonjë namespace (kam zgjedhur namespace kube-system — namespace sistemor për komponentët e "Kubit") dhe do të shohim marrëdhënien midis kohës së vërtetë të përdorur të procesorit dhe memories në lidhje me atë që është kërkuar:
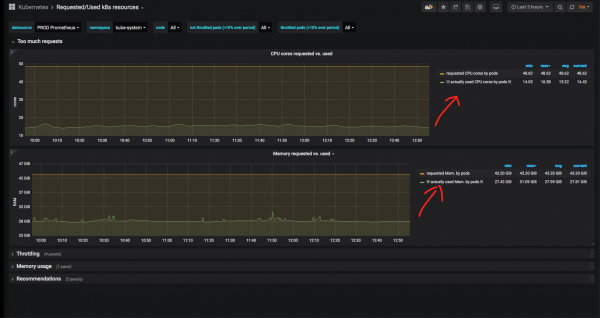
Është e qartë se për shërbimet sistemore është rezervuar shumë më tepër memorie dhe CPU sesa përdoret realisht. Në rastin e kube-system, kjo është e arsyeshme: ndodhi që kontrolluesi i nginx ingress ose nodelocaldns në pikat më të larta të kapacitetit përdorin shumë CPU dhe marrin shumë RAM, prandaj kjo rezerva është e arsyeshme. Për më tepër, nuk mund të mbështetemi në grafikat e tre orëve të fundit: është e dëshirueshme të shohim metrikat historike për një periudhë të gjatë kohe.
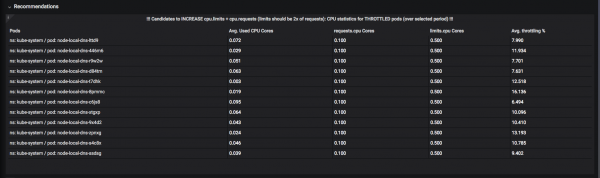
Është zhvilluar një sistem "rekomandimesh". Për shembull, këtu mund të shihni se cilët burime do të ishte më mirë të rriteshin "limitet" (franca më e lartë e lejuar), në mënyrë që të mos ndodhte "trotlling" (trotlling): momenti kur CPU ose memorie është e shpenzuar për kohën e caktuar dhe është në pritje, derisa të "rikthehet":
Dhe ja, pod-ët, të cilëve do të duhej të kufizoheshin apetitet:
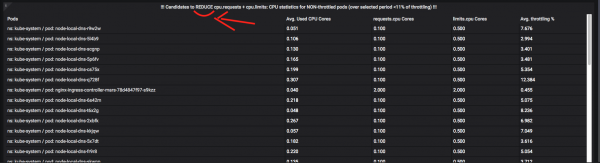
Për trotlling + monitorimi i burimeve mund të shkruajë më shumë se një artikull, prandaj bëni pyetje në komentet. Në disa fjalë, mund të them se detyra e automatizimit të metrikave të tilla është mjaft e vështirë dhe kërkon shumë kohë dhe ekvilibristikë me funksionet "windowed" dhe "CTE" të Prometheus / VictoriaMetrics (këto terma janë të kompletuar në thonjëza, pasi në PromQL pothuajse nuk ka asgjë të tillë, dhe duhet të bëjmë kërkesa të tmerrshme që zënë disa ekrane teksti dhe të merremi me optimizimin e tyre).
Si rezultat, zhvilluesit kanë mjete për të monitoruar namespace-t e tyre në "Kub", dhe ata janë në gjendje të zgjedhin vetë se ku dhe në cilën kohë të cilat aplikacione mund të "privojnë" burimet, dhe cilët pod-e mund të iu japin gjithë CPU-në për gjithë natën.
Metodologjitë
Në kompani, siç është tani në modë, ne ndjekim praktikat e DevOps- dhe SRE-ja. Kur në kompaninë ka 1000 mikrosherbime, rreth 350 zhvillues dhe 15 adminë për të gjithë infrastrukturën, duhet të "jemi modern": pas gjithë këtyre "buzzword-eve" fshihet një nevojë e fortë për automatizimin e gjithçkaje, dhe adminët nuk duhet të jenë një ngushticë në proceset.
Si Ops, ne ofrojmë metrika të ndryshme dhe dashboard-e për zhvilluesit, të lidhura me shpejtësinë e përgjigjeve të shërbimeve dhe gabimet e tyre.
Ne përdorim metodologji të tilla si: , dhe , duke i kombinojmë ato së bashku. Punohemi për të minimizuar numrin e tabelave, në mënyrë që me një shikim të vetëm të kuptohet se cilat shërbime tani janë në rënie (për shembull, kodet e përgjigjeve në sekondë, koha e përgjigjes në percentilin 99), dhe kështu me radhë. Sa herë që nevojiten ndonjë metrikë e re për tabelat e përbashkëta, ne menjëherë i vizatojmë dhe i shtojmë.
Nuk kam vizatuar grafikë për një muaj. Ndoshta, ky është një shenjë e mirë: do të thotë se shumica e 'dëshirave' tashmë janë realizuar. Ka pasur raste kur gjatë javës kam vizatuar ndonjë grafik të ri të paktën një herë në ditë.
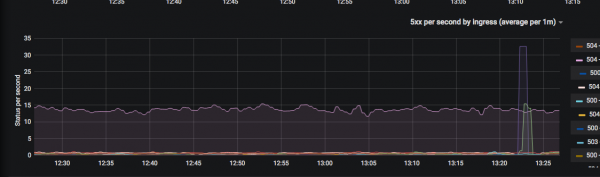
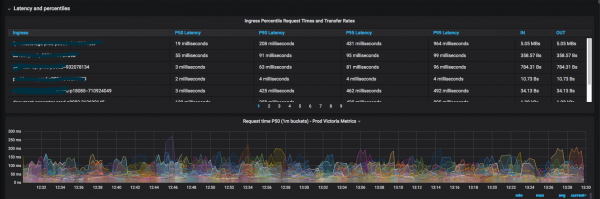
Rezultati i arritur është i çmuar sepse tani zhvilluesit rrallë shkojnë te administratorët me pyetje 'ku mund të shoh ndonjë metrikë'.
Zbatimi Service Mesh nuk është larg dhe do të bëjë shumë më të lehtë jetën e të gjithëve, kolegët nga Tools janë afër zbatimit të një 'Istio të shëndoshë': cikli i jetës së çdo kërkese HTTP(s) do të jetë i dukshëm në monitorim, dhe gjithmonë do të jetë e mundur të kuptohet 'në cilin hap gjithçka u prish' gjatë ndërveprimit ndër-shërbim (dhe jo vetëm). Regjistrohuni për njoftimet e qendrës së kompanisë DomKlik. =)
Mbështetje për infrastrukturën Kubernetes
Historikisht, ne kemi përdorur versionin e patch-uar Kubespray — Roli Ansible për vendosjen, zgjerimin dhe përditësimin e Kubernetes. Në një moment, mbështetja për instalimet non-kubeadm u hoq nga dega kryesore, dhe procesi i kalimit në kubeadm nuk u propozua. Si rezultat, kompania Southbridge bëri fork-un e saj (me mbështetje për kubeadm dhe një zgjidhje të shpejtë për problemet kritike).
Procesi i përditësimit të të gjithë klasterëve k8s duket kështu:
- Marrim Kubespray nga Southbridge, e kontrollojmë me degën tonë, dhe e bashkojmë.
- Nxjerrim përditësimin në Stress- 'Kub'.
- Nxjerrim përditësimin një nodë në një kohë (në Ansible, kjo është 'serial: 1') në Dev- 'Kub'.
- Përditësojmë Prod në mbrëmjen e së shtunës, një nodë në një kohë.
Në të ardhmen, ka plane për të zëvendësuar Kubespray me diçka më të shpejtë dhe për të kaluar në kubeadm.
Kemi gjithsej tre 'Kuba': Stress, Dev dhe Prod. Planifikojmë të lançojmë një tjetër ('hot standby') Prod-'Kubin' në Qendrën e Dytë të të Dhënave.jetojnë në 'virtualka' (oVirt për Stress dhe VMWare cloud për Dev).- 'Kubi' jeton në 'metal të zbrazët' (bare metal): këto janë nodë të njëjta me 32 CPU threads, 64-128 GB RAM dhe 300 GB SSD RAID 10 — gjithsej 50 copë. Tre nodë 'të holla' janë ndarë për 'masterat' Stress dhe Dev - 'Kubit': 16 GB RAM, 12 CPU threads. ProdPër prodhimin e preferuar, ne përdorim 'metal të zbrazët' dhe shmangim shtresa të tepërta si ProdOpenStack
: nuk na duhen 'fqinjë të zhurmshëm' dhe kohë të marrë nga CPU steal time: vjedh kohën. Po ashtu, kompleksiteti i administratës rritet përafërsisht dyfish në rastin e OpenStack in-house.
Për CI/CD të 'Kube' dhe komponenteve të tjera infrastrukturore përdorim një server të veçantë GIT, Helm 3 (kaluam mjaft dhimbshëm nga Helm 2, por jemi shumë të lumtur me opsionin atomic), Jenkins, Ansible dhe Docker. Na pëlqejnë feature-brancha dhe deploy në ambientet e ndryshme nga një depo.
Përfundim
Kështu, në përmbledhje, procesi DevOps në kompaninë DomKlik duket nga perspektiva e inxhinierit të operacioneve. Artikulli doli më pak teknik nga sa e prisja: ndaj, qëndroni të informuar për lajmet e DomKlik në Habr: do të ketë artikuj më 'hardcore' rreth Kubernetes dhe më shumë.
Burimi: habr.com
