

Burimi:
Regresioni linear është një nga algoritmet themelore për shumë fusha që lidhen me analizën e të dhënave. Arsyeja për këtë është e qartë. Është një algoritëm shumë i thjeshtë dhe i kuptueshëm, që kontribuon në përdorimin e tij të gjerë për shumë dekada, nëse jo për shekuj. Ideja është që ne supozojmë një varësi lineare të një variabli nga një grup variablash të tjerë, dhe më pas përpiqemi ta rikonstruktojmë këtë varësi.
Por në këtë artikull nuk do të flasim për përdorimin e regresionit linear për zgjidhjen e problemeve praktike. Këtu do të shqyrtohen karakteristikat interesante të implementimit të algoritmeve të shpërndara për rikonstruksionin e tij, me të cilat ne u përballëm gjatë shkruajtjes së modulit të mësimit të makinerive në . Pak matematikë themelore, bazat e mësimit të makinerive dhe të dhënat e shpërndara do të ndihmojnë të kuptojmë se si të rikonstruktojmë regresionin linear, edhe nëse të dhënat janë të shpërndara mes mijëra nyjash.
Çfarë është në bisedë?
Na pritet një detyrë për rikonstruktimin e varësisë lineare. Si të dhëna hyrëse jepen shumë vektorësh variablash të supozuar si të pavarur, të cilëve çdo prej tyre i korrespondon një vlerë e caktuar e variablit të varur. Këto të dhëna mund të paraqiten në formën e dy matricave:

Tani, pasi që supozohet një varësi, dhe madje edhe lineare, do ta shkruajmë supozimin tonë në formën e një producti matricash (për thjeshtësim, këtu dhe më tej supozohet që pjesa e lirë e ekuacionit fshihet pas  , dhe kolonë e fundit e matricës
 përmban njësi):

Shumë e ngjashme me një sistem ekuacionesh lineare, apo jo? Ngjan, por ka të ngjarë që ky sistem ekuacionesh të mos ketë zgjidhje. Arsyeja për këtë është zhurma, e cila është e pranishme praktikisht në të dhënat reale. Një tjetër arsye mund të jetë mungesa e varësisë lineare si e tillë, me të cilën mund të përpiqemi të përballojmë duke futur variablat shtesë, që varen në mënyrë jo lineare nga të dhënat fillestare. Le të shqyrtojmë shembullin e mëposhtëm:
Burimi:
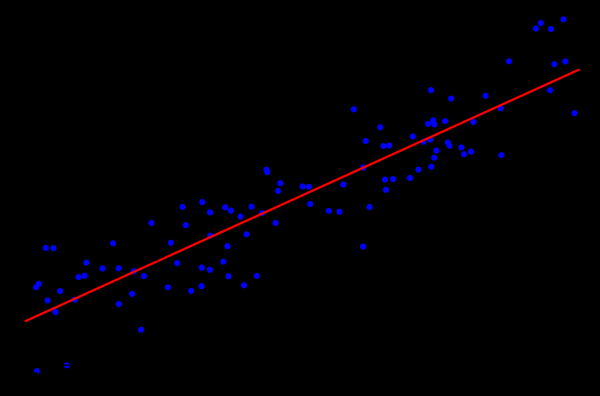
Ky është një shembull i thjeshtë i regresionit linear, i cili demonstruar varësinë e një variabli (në boshtin  ) nga variabli tjetër (në boshtin
 ). Për të pasur një sistem linjar ekuacionesh në përputhje me këtë shembull, të gjithë pikat duhet të bien saktësisht në një vijë. Por nuk është kështu. Ato nuk bien në një vijë pikërisht për shkak të zhurmës (apo për shkak se supozimi i pranishëm i varësisë linjare ishte i gabuar). Pra, për të rikuperuar varësinë linjare nga të dhënat reale zakonisht kërkohet të futet një supozim tjetër: të dhënat përmbajnë zhurmë dhe kjo zhurmë ka . Mund të bëhen supozime dhe për tipe të tjera shpërndarjesh zhurme, por në shumicën dërrmuese të rasteve shqyrtohet pikërisht shpërndarja normale, për të cilën do të flitet më tej.
Metoda e maksimumit të mundësive
Pra, ne supozuam prani të zhurmës rastësore me shpërndarje normale. Çfarë të bëjmë në një situatë të tillë? Për këtë rast, në matematikë ekziston dhe përdoret gjerësisht . Nëse e përmbledhim, thelbi i tij është zgjedhja dhe maksimizimi i saj të mëtejshëm.
Kthehemi në rikuperimin e varësisë linjare nga të dhënat me zhurmë normale. Vërejmë se varësia linjare e supozuar është një pr ожидание matematikore  e shpërndarjes normale të pranishme. Në të njëjtën kohë, probabiliteti që
 merr vlerën e caktuar, ndonjëherë në kushtet e pranisë së observimeve
 , duket si më poshtë:

Tani le të vendosim në vend të  dhe
 variablat që na duhen:

Vazhdon të mbetet vetëm të gjejmë vektorin  , për të cilin ky probabilitet është maksimal. Për të maksimizuar një funksion të tillë, është e përshtatshme së pari ta prologaritësh atë (logaritemi i funksionit do të arrijë maksimumin në të njëjtin pikë si vetë funksioni):

Çka, nga ana tjetër, reduktonet në minimizimin e funksionit të mëposhtëm:

Duket, kjo quhet metoda . Shpesh të gjitha këto konsiderata të mësipërme kalohen dhe përdoren thjesht kjo metodë.
QR dekompozimi
Minimalen e funksionit të mësipërm mund ta gjejmë, nëse gjejmë pikën ku gradienti i këtij funksioni është zero. Dhe gradienti do të regjistrohet në këtë mënyrë:

është një metodë matricore për zgjidhjen e problemit të minimizimit të përdorur në metodën e katrorëve të vegjël. Për këtë arsye, le të shkruajmë ekuacionin në formë matricore:

Pra, ne po ndajmë matricën  në matrica
 dhe
 dhe kryejmë një sërë transformimesh (algoritmi i QR dekompozitimit nuk do të diskutohet këtu, vetëm përdorimi i tij në lidhje me problemin e caktuar):

Matrica  është ortogonale. Kjo na lejon të heqim dorë nga produkti
 :

Dhe nëse zëvendësojmë  në
 , do të rezultojë në
 . Duke marrë parasysh se
 është një matricë e sipërme triangulare, kjo duket kështu:

Kjo mund të zgjidhet me metodën e zëvendësimit. Elementi  ndodhet si
 , elementi i mëparshëm
 ndodhet si
 dhe kështu me radhë.
Këtu duhet të theksojmë se kompleksiteti i algoritmit të fituar për shkak të përdorimit të QR dekompozitimit është i barabartë me  . Ndërkohë, pavarësisht se operacioni i shumzimit të matricave mund të paralelizohet mirë, nuk duket e mundur të shkruhen një version efektiv i distribuar i këtij algoritmi.
Zbritja gradiente
Duke folur për minimizimin e një funksioni të caktuar, gjithmonë ia vlen të përmendet metoda e (stohastik) gradienteve të zbritjes. Kjo është një metodë e thjeshtë dhe efektive e minimizimit, e bazuar në llogaritjen iteruese të gradientit të funksionit në një pikë dhe lëvizjen e mëpasshme në drejtimin e kundërt të gradientit. Çdo hap i tillë afrohet zgjidhjes në minimum. Gradienti në këtë rast duket ende kështu:

Gjithashtu, kjo metodë paralelizohet dhe shpërndahet mirë për shkak të pronave lineare të operatorit të gradientit. Vërejmë se në formulën e mësipërme nën shenjën e shumës janë terma të pavarur. Me fjalë të tjera, ne mund të llogarisim gradientin në mënyrë të pavarur për të gjitha indeksat  nga i pari deri te
 , ndërkohë që paralelisht llogarisim gradientin për indeksat nga
 në
 . Pastaj, do të mbledhim gradientët e marra. Rezultati i mbledhjes do të jetë i njëjtë me atë nëse do të llogarisnim menjëherë gradientin për indeksat nga i pari deri te
 . Kështu, nëse të dhënat janë të shpërndara midis disa pjesëve të dhënash, gradienti mund të llogaritet në mënyrë të pavarur në secilën pjesë, e më pas rezultatet e këtyre llogaritjeve mund të mbledhen për të marrë rezultatin përfundimtar:

Nga pikëpamja e implementimit, kjo përputhet me paradigmën Në çdo hap të gradientes së zbritjes, një detyrë për të llogaritur gradientin dërgohet në çdo nyje të dhënash, më pas gradientet e llogaritura mblidhen së bashku, dhe rezultati i mbledhjes së tyre përdoret për të përmirësuar rezultatin.
Pavarësisht thjeshtësisë së zbatimit dhe mundësisë së ekzekutimit në paradigmën MapReduce, gradient descent ka gjithashtu disavantazhet e tij. Në veçanti, numri i hapave të nevojshëm për të arritur konvergjencën është ndjeshëm më i lartë krahasuar me metodat e tjera më të specializuara.
LSQR
— një tjetër metodë zgjidhje e cila është e përshtatshme si për rikonstruktimin e regresionit linear, ashtu edhe për zgjidhjen e sistemeve të ekuacioneve lineare. Karakteristika e saj kryesore është se kombinon avantazhet e metodave matricore dhe të qasjes iteruese. Implementimet e kësaj metode mund të gjenden si në bibliotekat , ashtu edhe në . Përshkrimi i kësaj metode nuk do të jepet këtu (mund ta gjeni në artikullin ). Në vend të kësaj do të demonstrohet një qasje që lejon adaptimin e LSQR për të funksionuar në një ambient të shpërndarë.
Baza e metodës LSQR është . Kjo është një procedurë iteruese, ku çdo iteracion përbëhet nga hapat e mëposhtëm:
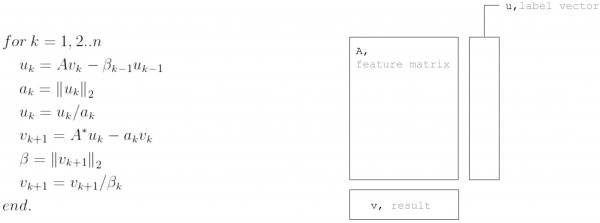
Por nëse merret parasysh se matrica  është e particionuar horizontalisht, çdo iteracion mund të paraqitet si dy hapa MapReduce. Në këtë mënyrë minimizohen dërgesat e të dhënave gjatë çdo iteracioni (vetëm vektorë me një gjatësi të barabartë me numrin e të panjohurave):
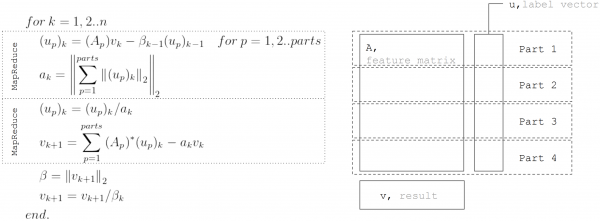
Kjo qasje përdoret për implementimin e regresionit linear në .
Përfundim
Ekzistojnë shumë algoritma për rikonstruktimin e regresionit linear, por jo të gjithë mund të aplikohen në çdo kushte. Kështu, decompozimi QR është shumë i përshtatshëm për zgjidhje të sakta në grupe të vogla të dhënash. Gradient descent është lehtësisht i implementueshëm dhe lejon të gjejmë shpejt një zgjidhje të përafërt. Ndërsa LSQR kombinon vetitë më të mira të dy algoritmeve të mëparshme, pasi mund të shpërndahet, konvergon më shpejt krahasuar me gradient descent, si dhe lejon ndalimin e hershëm të algoritmit në krahasim me decompozimin QR për të gjetur një zgjidhje të përafërt.
Burimi: habr.com
