

Dekodimi i raportit të vitit 2015 nga Ilya Kosmodemyansky "Tuning Linux për të përmirësuar performancën e PostgreSQL"
Shënim: Dua të theksoj se ky raport daton nga nëntori i vitit 2015 — ka kaluar më shumë se 4 vjet dhe janë zhvilluar shumë gjëra. Versioni i shqyrtuar në raportin 9.4 nuk mbështetet më. Gjatë këtyre 4 viteve janë lëshuar 5 versione të reja të PostgreSQL dhe 15 versione bërthamash Linux. Nëse do të rishkruaja këto pika, do të rezultonte një raport tjetër. Megjithatë, këtu është shqyrtuar tunimi themelor i Linux për PostgreSQL, i cili është aktual edhe tani.
Më quajnë Ilya Kosmodemyansky. Unë punoj në kompaninë PostgreSQL-Consulting. Tani do të flas pak për atë se çfarë të bëjmë me Linux në lidhje me bazat e të dhënave në përgjithësi dhe me PostgreSQL në veçanti, sepse parimet janë mjaft të ngjashme.
Për çfarë do flasim? Nëse komunikoni me PostgreSQL, atëherë në një farë mënyre duhet të jeni administrator UNIX-i. Çfarë do të thotë kjo? Nëse e krahasojmë Oracle dhe PostgreSQL, në Oracle duhet të jesh 80% DBA dhe 20% administrator Linux.
Me PostgreSQL është pak më e komplikuar. Me PostgreSQL duhet të keni një kuptim më të mirë se si funksionon Linux. Dhe për këtë, duhet të ndjekim zhvillimet, sepse kohët e fundit shumë gjëra përditësohen. Po lëshohen bërthama të reja, funksionalitet të ri, performanca përmirësohet etj.
Pse flasim për Linux? Jo për faktin se jemi në konferencën Linux në Piter, por sepse në kushtet moderne një nga sistemet operative më të justifikuara për eksploatimin e bazave të të dhënave në përgjithësi dhe për PostgreSQL në veçanti është Linux. Sepse FreeBSD, fatkeqësisht, po zhvillohet në një drejtim shumë të çuditshëm. Dhe do të ketë probleme me performancën, si dhe me shumë gjëra të tjera. Performanca e PostgreSQL në Windows është një temë totale e veçantë, që shqetëson faktin se Windows-i nuk ka të tillë memorie të përbashkët si UNIX, dhe e gjithë kjo tek PostgreSQL lidhet me këtë, sepse është një sistem me shumë procese.
Dhe ekstravaganca si Solaris, mendoj se intereson më pak të tjerët, ndaj le të vazhdojmë.
Një distribucion modern i Linux ka më shumë se 1,000 parametra syctl, varësisht nga mënyra se si përgatitet bërthama. Përveç kësaj, nëse shohim në ndryshime të tjera, ka pasoja të tjera që mund të rregullohen. Ekzistojnë parametra të sistemeve të skedarëve, si të montoni. Nëse ka pyetje, si të lansoni: çfarë të aktivizoni në BIOS, si të konfiguroni harduerin etj.
Ky është një sasi shumë e madhe informacioni, për të cilin mund të flitet për disa ditë, dhe jo për një prezantim të shkurtër, por tani do të ndalem te gjërat e rëndësishme, si të shmangim ato momente që në mënyrë të garantuar nuk do t'ju lejojnë të shfrytëzoni mirë bazën e të dhënave në Linux, nëse nuk i korrigjoni ato. Dhe një pikë e rëndësishme është se shumë parametra janë aktivizuar në konfigurime që nuk janë të duhura për bazën e të dhënave. Kështu, për sa kohë që është përparësi, do të funksionojë keq ose nuk do të funksionojë fare.
Cilat janë targetet tradicionale të tuning në Linux? Mendoj se, pasi që të gjithë merremi me administrimin e Linux, nuk ka nevojë të shpjegojmë veçanti rreth targeteve.
Mund të bëjmë tuning:
- CPU.
- Memoria.
- Ruajtja.
- Të tjera. Rreth kësaj do të flasim në fund si një larmi. Edhe, për shembull, parametrat si politika e kursimit të energjisë mund të ndikojnë në performancën në mënyrë shumë të papritur dhe jo të këndshme.
Cila është specifika e PostgreSQL dhe e bazës së të dhënave në përgjithësi? Problemi është se nuk mund të bëni tuning për një ndihmës të veçantë dhe të shihni se performanca ka përmirësuar ndjeshëm.
Po, ndihmës të tillë ka, por baza e të dhënave është një gjë komplekse. Ajo ndërvepron me të gjitha burimet që ka serveri dhe preferon të ndërveprojë në mënyrë të plotë. Nëse shikoni rekomandimet moderne të Oracle mbi përdorimin e sistemit operativ host, do të jetë si në anekdotën për astronautin mongol – ushqeja qenushin dhe mos e preku asgjë. Le të japim të gjitha burimet e bazës, ajo do ta menaxhojë vetë.
Në thelb, deri në njëfarë shkalle situata me PostgreSQL është e njëjtë. Diferenca është se baza nuk di të marrë vetë të gjitha burimet, dmth, disa gjëra duhet menaxhuar vetë në nivelin e Linux.
Ideja kryesore është të mos zgjidhni ndonjë target të vetëm dhe të filloni ta tunoni atë, për shembull, memorjen, CPU-në apo diçka të tillë, por të analizoni ngarkesën e punës dhe të përpiqeni të përmirësoni sa më shumë kapacitetin e kalimit, që ngarkesa që programuesit tanë të shkëlqyer dhe përdoruesit tanë e krijojnë të kalojë sa më efektivisht përmes bazës sonë të të dhënave.
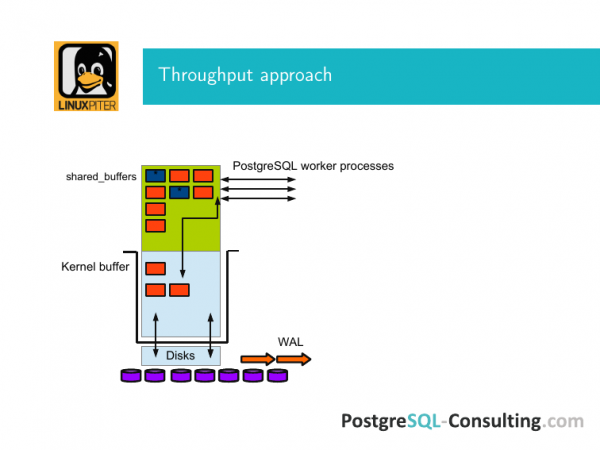
Kjo është një pamje për të shpjeguar se çfarë është. Ka një buffer të OS Linux, ka memorie të përbashkët dhe ka buffers të përbashkët të PostgreSQL. PostgreSQL, ndryshe nga Oracle, punon direkt vetëm me bufferin e kernelit, pra që një faqe nga disku të kalojë në memorien e tij të përbashkët, ajo duhet të kalojë përmes bufferit të kernelit dhe situata është saktësisht e njëjtë në anën tjetër.
Nën këtë sistem jetojnë diskët. Unë e kam vizatuar si diskë. Në të vërtetë, mund të ketë një kontrollor RAID etj.
Dhe ky input-output ndodh kështu ose ashtu përmes kësaj.
PostgreSQL është një bazë e dhënash klasike. Brenda saj ka faqe. Dhe gjithë input-output ndodh përmes faqeve. Ne ngremë blloqet në memorie me faqe. Dhe nëse nuk ka ndodhur asgjë, thjesht i lexojmë ato, gradualisht ato shpërndahen nga ky cache, nga buffers të përbashkët dhe kthehen përsëri në disk.
Nëse ne zëvendësojmë ndonjë gjë, gjithë faqeja shënohet si e ndotur. Unë i kam shënuar këtu me ngjyrë blu. Dhe kjo do të thotë se kjo faqe duhet të sinkronizohet me magazinën bllokuese. Pra, kur e bëjmë atë të ndotur, bëjmë një regjistrim në WAL. Dhe në një moment të bukur, ndodh një fenomen i quajtur checkpoint. Dhe në këtë log u regjistrua informata që ai erdhi. Kjo do të thotë se të gjitha faqet e ndotura, që ishin këtu në atë moment në këto buffers të përbashkët, u sinkronizuan me disku i magazinës përmes fsync përmes bufferit të kernelit.
Përse bëhet kjo? Nëse na humbet energjia, atëherë nuk kemi situatën që të gjithë të dhënat humbasin. Memoria persistente, për të cilën na treguan të gjithë, për momentin ekziston në teorinë e bazave të të dhënave – është një të ardhme e ndritshme, për të cilën sigurisht që synojmë dhe na pëlqen, por për momentin ata jetojnë ende në -20 vjet. Dhe, natyrisht, duhet të vigjilojmë për këtë.
Dhe detyra e maksimizimit të kapacitetit është të optimizojmë në të gjitha këto etapa, për ta bërë që gjithçka të ecë shpejt. Memoria e përbashkët është kryesisht cache faqe. Në PostgreSQL ne dërguam një kërkesë select diçka, ai e mori atë të dhënën nga disku. Ato arritën në buffers të përbashkët. Përshtatshmëria e tij për të punuar më mirë do të thotë se duhet të ketë shumë memorie.
Për të bërë që kjo të funksionojë mirë dhe shpejt, ju nevojitet të konfiguroni në mënyrë të duhur sistemin operativ në të gjitha fazat. Gjithashtu, duhet të zgjidhni një harduer të ekuilibruar, sepse nëse ka një disbalancë diku, mund të keni shumë memorie, por do të shërbehet me shpejtësi të pamjaftueshme.
Dhe do të shkojmë përmes secilës nga këto pika.
Për të bërë që këto faqe të udhëtojnë më shpejt, duhet të arrijmë të bëjmë të siguiente:
- Së pari, duhet të punojmë më efikas me memorien.
- Së dyti, duhet të jetë më efikase kjo kalim, kur faqet kalojnë nga memoria në disk.
- Dhe, së treti, duhet të kemi disqe të mira.
Nëse keni 512 GB memorie RAM në server dhe gjithë kjo përfundon në një hard disk SATA pa asnjë cache, atëherë gjithë serveri i bazës së të dhënave shndërrohet jo vetëm në një kungull, por në një kungull me ndërfaqe SATA. Ju do të përballeni drejtpërdrejt me këtë. Dhe asgjë nuk do t'ju shpëtojë.
Sa i përket pikës së parë me memorien, ka tri gjëra që mund ta komplikojnë shumë jetën.
E para nga ato është NUMA. NUMA është një koncept i bërë për të përmirësuar performancën. Sipas ngarkesës, mund të optimizoni gjëra të ndryshme. Në formën e saj aktuale, për aplikacione të tilla si baza e të dhënave që përdorin intensivisht cache-në e faqeve, nuk është shumë e mirë.
Me fjalë të tjera. Si të kuptoni që diçka nuk shkon me NUMA? Ju ndjeni një goditje të pakëndshme, papritmas ndonjë CPU del në ngarkesë. Duke analizuar kërkesat në PostgreSQL, shihni se nuk ka asgjë që ngjan me këtë. Këto kërkesa nuk duhet të konsumojnë kaq intensisht CPU-në. Mund ta kapni këtë për një kohë të gjatë. Është më lehtë të përdorni që nga fillimi rekomandimin e duhur, si të konfiguroheni NUMA për PostgreSQL.
Çfarë ndodh në fakt? NUMA është Non-Uniform Memory Access. Çfarë do të thotë? Keni një CPU, pranë tij është memoria e tij lokale. Dhe kjo memorie mund të tërheqë memorien nga CPU të tjerë.
Nëse ekzekutoni numactl --hardware, do të shihni një listë të madhe. Mes të tjerash, do të ketë një fushë distances. Do të jenë numra – 10-20, diçka e tillë. Këta numra janë asgjë tjetër veçse numri i hopave për të tërhequr këtë memorie të largët dhe për ta përdorur lokal. Në parim, një ide e mirë. Kjo ndihmon shumë në përmirësimin e performancës nën disa ngarkesa.
Tani, imagjinoni se keni një CPU që së pari përpiqet të përdorë memorjen e tij lokale, pastaj përpiqet të tërheqë memorje tjetër përmes interconnect për ndonjë gjë. Dhe në këtë CPU arrin e gjithë memoria juaj e cache të faqeve të PostgreSQL - të gjitha ato, ndonjëherë disa gigabajt. Ju gjithmonë merrni rastin më të keq, sepse zakonisht ka pak memory në këtë modul memorie. Dhe e gjithë memoria që shërbehet, kalon përmes këtyre interconnects. Kështu bëhet ngadalë dhe me trishtim. Dhe ju keni një procesor që shërben këtë nyje, gjithmonë tejet i ngarkuar. Dhe koha e qasjes në këtë memorie është e dobët, e ngadaltë. Kjo është situata që nuk doni, nëse e përdorni këtë gjë për një bazë të dhënash.
Prandaj, një variant më i saktë për një bazë të dhënash është që sistemi operativ Linux të mos dijë fare çfarë po ndodh atje. Që ajo të qaset në memorie siç duhet.
Pse kështu? Duke menduar se duhet të ishte njësoj. Kjo ndodh për një shkak të thjeshtë, që na nevojitet shumë memorie për cache-n e faqeve - dhjetëra, qindra gigabajt.
Dhe nëse ne e kemi gjithë atë të dedikuar dhe kemi cache-uar të dhënat tona aty, përfitimi nga përdorimi i caches do të jetë shumë më i madh se përfitimi nga një qasje e tillë në memorie. Dhe në këtë mënyrë ne do të fitojmë në mënyrë të paqenueshme krahasuar me atë që do të jemi më efikas në qasjen në memorie duke përdorur NUMA.
Prandaj, deri tani ka dy qasje, derisa e ardhmja e ndritur të ketë ardhur dhe baza e të dhënave të dijë vetë në cilin CPU po punon dhe nga ku i nevojitet diçka.
Prandaj, qasja e duhur është t'i fikim plotësisht NUMA-n., për shembull, gjatë rindezjes. Në shumicën e rasteve, fitimet janë të tilla që nuk ka fare pyetje se si është më mirë.
Ka një variant tjetër. Ne e përdorim atë më shpesh se variantin e parë, sepse kur një klient na vjen për mbështetje, për të rindezur serverin është një çështje e madhe. Ai ka biznesin e tij aty. Dhe ata përjetojnë probleme nga NUMA. Prandaj ne përpiqemi ta fikim në mënyra më pak invazive se rindezja, por këtu duhet të kontrolloni me kujdes që ajo të ketë qënë fikur. Sepse, siç tregon eksperienca, kur ne e fikim NUMA-n për procesin prind të PostgreSQL, kjo është mirë, por nuk është e domosdoshme që kjo të funksionojë. Duhet të kontrolloni dhe të shihni se ajo me të vërtetë është fikur.
Ka një post të shkëlqyer nga Robert Haas. Ai është një nga kontribuesit e PostgreSQL. Një nga zhvilluesit kyç të të gjitha brendësive të nivelit të ulët. Dhe nëse ndiheni të interesuar pas lidhjeve nga ky post, atje përshkruhen disa histori interesante për mënyrën se si NUMA i vështirëson jetën njerëzve. Shikoni, studioni listën kontroluese për administratorët e sistemeve, që duhet të konfiguroni në server për të siguruar që baza e të dhënave të funksionojë mirë. Këto konfigurations duhet të ruhen dhe të kontrollohen, sepse përndryshe do të jetë jo shumë mirë.
Dua të theksoj se kjo e bën fjalë për të gjitha konfigurimet, për të cilat do të flas. Por zakonisht, bazat e të dhënave organizohen në modin master-slave për qëllime qëndrueshmërie. Mos harroni të bëni këto konfigurime në slave, sepse në një moment të caktuar do të keni një katastrofë dhe do të kaloni te slave, i cili do të bëhet master.
Në një situatë emergjente, kur gjithçka është shumë keq, telefoni juaj bie vazhdimisht dhe shefi vjen me një shkop të madh, nuk do të keni kohë të mendoni për kontrollime. Dhe rezultatet mund të jenë shumë tronditëse.
Momenti tjetër është pagesat e mëdha (huge pages). Pagesat e mëdha janë të vështira për t'u testuar veçmas, dhe nuk ka shumë kuptim për ta bërë këtë, edhe pse ka benchmarking që di t'i bëjë këto. Ato janë të lehta për t'u gjetur në internet.
Cili është kuptimi? Keni një server jo shumë të shtrenjtë, ku ka shumë memorie RAM, për shembull, më shumë se 30 GB. Ju nuk po përdorni pagesat e mëdha. Kjo do të thotë se ju patjetër keni overhead në përdorimin e memories. Dhe ky overhead nuk është aspak i këndshëm.
Pse ndodh kështu? Çfarë po ndodh? Sistemi operativ ndan memorinë në copa të vogla. Kjo është e përshtatshme, kështu ka ndodhur historikisht. Dhe nëse shqyrtohet me hollësi, OS duhet të përkthejë adresat virtuale në ato fizike. Dhe ky proces nuk është aspak i thjeshtë, prandaj OS rezultatet e kësaj operacioni i ruan në Translation Lookaside Buffer (TLB).
Dhe ngase TLB është një cache, në një situatë të tillë lindin të gjitha problemet që lidhen me caching. Së pari, nëse keni shumë memorie RAM dhe ajo është e gjitha e ndarë në copa të vogla, atëherë ky buffer bëhet shumë i madh. Dhe nëse cache është i madh, kërkimi në të bëhet më i ngadalshëm. Overhead-i është i madh dhe ai vetë merr vend, dmth. memorizimi i fizikisht ndarë është diçka jo e saktë. Kjo është njëra nga arsyet.
Dy – sa më shumë që rritet cache në këtë situatë, aq më e madhe është probabiliteti i humbjeve të cache. Dhe efektiviteti i këtij cache bie shpejt me rritjen e madhësisë së tij. Prandaj, në sistemet operative u shpik një qasje e thjeshtë. Në Linux ajo tashmë përdoret prej kohësh. Në FreeBSD kjo u shfaq jo shumë kohë më parë. Por ne po flasim për Linux. Këto janë huge pages.
Dhe këtu duhet të theksohet se idea e huge pages fillimisht ishte promovuar nga komunitete që përfshinin Oracle dhe IBM, pra prodhuesit e bazave të të dhënave mendonin thellë se do t'u nevojiteshin, përfshirë për bazat e të dhënave.
Dhe si t'i lidhim ato me PostgreSQL? Së pari, në bërthamën e Linux duhet të aktivizohen huge pages.
Së dyti, ato duhet të specifikohen qartë me parametrin sysctl – sa shumë prej tyre. Numrat këtu vijnë nga një server i vjetër. Ju mund të llogaritni se sa ashpërsisht keni shared buffers, që huge pages të mund të hyjnë atje.
Dhe nëse tërë serveri është i dedikuar për PostgreSQL, një pikë e mirë fillestare është të jepni ose 25% të memories operuese për buffered ndarjen, ose 75%, nëse jeni të sigurt se në këto 75% baza juaj e dhënash me siguri do të përshtatet. Kjo është pika e parë fillestare. Dhe llogaritni, nëse keni 256 GB memorie operuese, atëherë përkatësisht, 64 GB do të jenë buffers të ndara. Llogaritni ndoshta me një rezervë – çfarë duhet të jetë kjo numër.
Para versionit 9.2 (nëse nuk gaboj, që nga versioni 8.2) kishte mundësi të lidhni PostgreSQL me huge pages përmes një bibliotekë të tretë. Dhe kjo gjithmonë duhet bërë. Së pari, ju nevojitet që bërthama të dijë si të alokojë huge pages në mënyrë të duhur. Dhe, së dyti, aplikacioni që punon me to duhet të mund të përfitojë nga ato. Thjesht ashtu nuk do të përfitojë. Sepse PostgreSQL alokonte memorie në stilin e sistemit 5, kështu që kjo mund të bëhej përmes libhugetlbfs – ky është emri i plotë i bibliotekës.
Në versionin 9.3, performanca e PostgreSQL për menaxhimin e memories u përmirësua dhe metodi i alokimit të memories system 5 u hoq. Të gjithë ishin shumë të kënaqur, sepse përndryshe, kur përpiqesh të lancosh dy instance të PostgreSQL në të njëjtin server, ai thotë se ka mungesë të memories së ndarë. Ai tregon se duhet të rregullohet sysctl. Dhe aty ka një sysctl që kërkon edhe një restart, etj. Pra, të gjithë u gëzuan. Megjithatë, alokimi i memories mmap prishi përdorimin e pages të mëdha. shumica e klientëve tanë përdorin buffers të mëdha të ndarë. Kemi rekomanduar me ngulm që të mos kaloni në 9.3, sepse atje overhead-i fillonte të llogaritej në përqindje të mira.
Megjithatë, komuniteti e vuri re këtë problem dhe në 9.4 e ristrukturuan shumë mirë këtë aspekt. Në 9.4 u shfaq një parametr në postgresql.conf, ku mund të aktivizoni try, on ose off.
Try – është parametri më i sigurt. Gjatë startit të PostgreSQL, kur ai alokon memory të ndarë, përpiqet të marrë atë memory nga pages të mëdha. Dhe nëse nuk ia del, kthehet në alokimin e zakonshëm. Po ashtu, nëse keni FreeBSD ose Solaris, mund ta vendosni try, gjithmonë është e sigurt.
Nëse është on, ai thjesht nuk starton nëse nuk arrin të alokojë nga pages të mëdha. Këtu tashmë varet nga preferencat tuaja. Por nëse keni vendosur try, sigurohuni se ajo çfarë nevojitet është vërtet alokuar, sepse ka shumë hapësirë për gabime. Aktualisht, ky funksionalitet punon vetëm në Linux.
Një shkëputje tjetër e vogël, para se të vazhdojmë më tej. Transparent huge pages – kjo nuk është akoma për PostgreSQL. Ai nuk mund ta shfrytëzojë normalisht. Dhe në rastin e Transparent huge pages për një ngarkesë pune, kur nevojitet një copë e madhe memories së ndarë, përfitimet ndodhin vetëm në volume shumë të mëdha. Nëse keni terabajtë memories, atëherë kjo mund të ketë rëndësi. Nëse flasim për aplikacione më të zakonshme, kur keni 32, 64, 128, 256 GB memories në server, atëherë pages të zakonshme të mëdha janë të mira, ndërsa Transparent thjesht fiket.
Dhe gjëja e fundit, që lidhet me memory-në, nuk është drejtpërdrejt e lidhur me fruputin, por mund të prishë shumë jetën. I gjithë kapaciteti i kalimit do të ndikohet rëndë nga fakti që serveri vazhdimisht swap-on.
Dhe do të jetë shumë e pakëndshme në disa momente. Dhe problemi kryesor është se në bërthamat moderne, sjellja është paksa ndryshe nga bërthamat më të vjetra Linux. Dhe kjo është diçka në të cilën është mjaft e pakëndshme të shkelësh, sepse kur flasim për ndonjë punë me swap, përfundon me vonesën e OOM-killer. Dhe OOM-killer, që nuk erdhi në kohë dhe hodhi PostgreSQL, është shumë e pakëndshme. Kjo do të merret vesh nga të gjithë, domethënë, deri te përdoruesi më i fundit.
Çfarë ndodh? Keni atje një sasi të madhe memorjeje, gjithçka funksionon mirë. Por për një arsye, serveri ngec në swap dhe ngadalëson për këtë arsye. Duke u dukur, ka shumë memorje, por kështu ndodh.
Më parë ne rekomandonim që vm.swappiness të vendoset në zero, domethënë, të çaktivizohet swap. Më parë dukej se 32 GB memorje dhe buferat përkatës të shpërndarë ishin një sasi e madhe. Qëllimi kryesor i swap-it është të ketë një vend ku të vendoset thelbi, nëse zhvillohemi. Dhe kjo tashmë nuk po realizohej. Dhe çfarë do të bësh me këtë thelb? Kjo është një detyrë, kur nuk është shumë e qartë pse ne kemi nevojë për swap, sidomos të tillë që janë të mëdhenj.
Por në bërthamat më moderne, domethënë në versionet e tretë, sjellja ka ndryshuar. Dhe nëse vendosni swap-in në zero, domethënë, ta çaktivizoni, herët a vonë, madje edhe kur ka ende një sasi të caktuar memorjeje, OOM-killer do t'ju vijë për të vrarë përdoruesit më intensivë. Sepse ai do të mendojë se me një ngarkesë të tillë, na ka mbetur pak dhe ne do të rrëzohemi, domethënë, jo të eliminojmë procesin sistemor, por të vrasim diçka më pak të rëndësishme. Kjo do të rezultojë të jetë përdoruesi intensiv i memorjes së shpërndarë, pra postmaster. Dhe pas kësaj, do të jetë mirë nëse nuk do të jetë e nevojshme të rikuperoni bazën.
Prandaj tani, sipas kujtimit tim, shumica e distribucioneve bazë janë diku rreth 6, domethënë, në cilin moment duhet të filloni të përdorni swap në varësi të sasisë së memorjes që ka mbetur. Tani ne rekomandojmë të vendoset vm.swappiness = 1, sepse kjo praktikisht e çaktivizon, por nuk ka efekte të tilla si me një OOM-killer që papritmas vjen dhe e eliminon të gjithë këtë.
Çfarë ndodh më pas? Kur flasim për performancën e bazave të të dhënave dhe gradualisht arrijmë te disqet, të gjithë fillojnë të kapin kokën. Sepse e vërteta që disku është i ngadalshëm dhe memoria e shpejtë është diçka që të gjithëve iu njoh që fëmijë. Të gjithë e dinë se në bazën e të dhënave do të ketë probleme me performancën e diskut.
Problemi kryesor me performancën e PostgreSQL, që lidhet me shpërthimet e checkpoints, nuk lind nga fakti se disku është i ngadalshëm. Ajo është më shumë për shkak të papajtueshmërisë midis kapacitetit të memorjes dhe diskut. Ndërsa, ato mund të jenë të papajtueshme në vende të ndryshme. PostgreSQL nuk është konfiguruar, sistemi operativ nuk është konfigurur, hardueri nuk është i saktë dhe hardueri është i gabuar. Ky problem ndodh vetëm në rast se gjithçka ndodh siç duhet, domethënë ose nuk ka ngarkesë, ose konfigurimet dhe hardueri janë mirësisht të përshtatura.
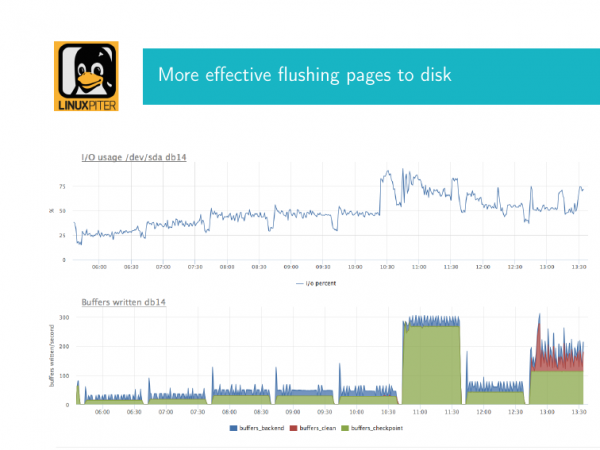
Çfarë është dhe si duket kjo? Zakonisht, njerëzit që punojnë me PostgreSQL e ndiejnë veten në këtë situatë shpesh. Do ta shpjegoj. Siç thashë, PostgreSQL herë pas here bën checkpoints për të kaluar faqet e ndotura nga memoria e ndarë në disk. Nëse kemi një volum të madh memorjeje të ndarë, atëherë checkpoint fillon të ngarkojë diskun me intensitet, sepse kalon këto faqe fsync. Ai arrin në buffer-in e kernel-it dhe shkruhet në disqe me anë të fsync. Dhe, nëse volumi i këtij procesi është i madh, mund të vërejmë një efekt të pakëndshëm, dmth. një shfrytëzim të madh të disqeve.
Këtu kam dy grafikë. Tani do ta shpjegoj se çfarë janë. Këto janë dy grafika të korrelacionuar në kohë. Grafikë i parë është shfrytëzimi i diskut. Këtu ai arrin pothuajse deri në 90% në këtë moment. Nëse ju keni një bazë të dhënash me disqe fizike, me një kontrollues RAID me shfrytëzim rreth 90%, atëherë kjo është një lajm i keq. Kjo tregon se pak më shumë dhe do të arrijë 100 dhe hyrja-dalja do të ndalojë.
Nëse keni një grumbull disqesh, atëherë aty është një histori pak më ndryshe. Ajo varet nga mënyra se si është konfiguruar, çfarë lloji grumbulli është etj.
Ndërkohë, këtu është konfiguruar një grafik nga pamja e brendshme e Postgres, e cila tregon se si ndodh checkpoint. Dhe me ngjyrë të gjelbër këtu është e shfaqur sasia e bufeve, këtyre faqeve të ndotura, që ka arritur në këtë moment në këtë checkpoint për sinkronizim. Dhe kjo është gjëja kryesore që duhet të dini. Ne shohim se kemi shumë faqe këtu dhe në një moment jemi bllokuar në disk, dmth. kemi shkruar-shkruar, këtu është e qartë që sistemi i diskut është shumë i angazhuar. Dhe checkpoint-i ynë ka një ndikim të madh në disk. Në mënyrë ideale, situata duhet të duket, më shumë kështu, dmth. kemi pasur më pak shkarkime. Dmth. utilitëzimi është i vogël, por ndonjëherë kemi shkarkime këtu.
Çfarë duhet të bëni për të zgjidhur këtë problem? Nëse IO-ja nën bazën e të dhënave është ndalur, atëherë kjo do të thotë se të gjithë përdoruesit që vijnë për të ekzekutuar kërkesat e tyre do të presin.
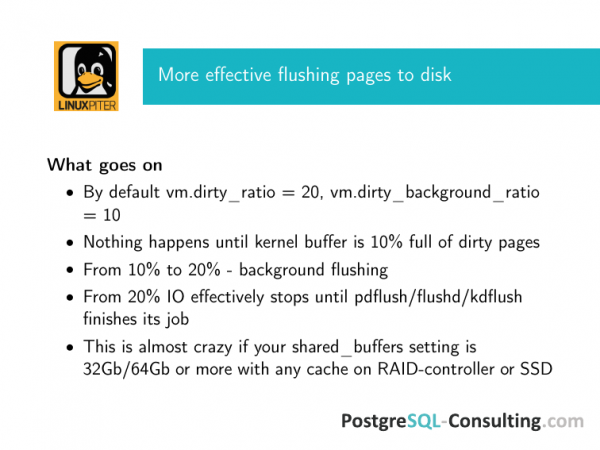
Nëse e shihni nga këndvështrimi i Linux-it, nëse keni marrë hardware të mirë, e keni konfiguruar saktë, keni konfiguruar PostgreSQL-në në mënyrë që të bëjë këto checkpoints më rrallë, të shpërndajë ato në kohë njëra pas tjetrës, atëherë ju arrini në parametrat default të Debian. Për shumicën e distribucioneve të Linux-it, kjo është pamja: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Çfarë do të thotë kjo? Me kernelin 2.6 u shfaq një demon për pastrimin. Pgflush, në varësi të atij që e përdor, merret me heqjen e faqeve të ndotura nga buffer-i i kernelit dhe heqjen, kur është e nevojshme, pa marrë parasysh, kur heqja e pasme nuk ndihmon më.
Kur ndodh heqja e pasme? Kur 10% e gjithë memories operativë që është në server është e zënë me faqe të ndotura në buffer-in e kernelit, atëherë thirret një funksion special që shkarkon në background. Pse është e pasme? Ajo merr si parametër sa faqe të heqë. Dhe, për shembull, heq N faqe. Dhe për një kohë të caktuar, ajo fle. Më pas ajo vjen përsëri dhe heq një sasi tjetër faqesh.
Kjo është një histori ekstremisht e thjeshtë. Këtu, detyra është si me një pishinë, kur në një tub derdhet, në tjetrin mbushet. Na erdhi checkpoint dhe nëse ai dërgoi pak faqe të ndotura për shkarkim, ngadalë nga buferi i kernelit pgflush do ta zgjidhë këtë situatë.
Nëse këto faqe të pista vazhdojnë të grumbullohen, ato do të grumbullohen deri në 20%, pas kësaj në prioritetin e OS është të shkruajë gjithçka në disk, sepse do të ketë një ndërprerje të energjisë dhe do të kemi probleme. Do të humbasim këto të dhëna, për shembull.
Çfarë është triku? Triku qëndron në atë se këta parametra në botën moderne, 20 dhe 10% e tërë memorjes operative që keni në makinën tuaj, janë krejtësisht të tmerrshëm nga këndvështrimi i kapacitetit të çdo sistemi disku që keni.
Imagjinoni se keni 128 GB memorie operative. 12,8 GB arrijnë në sistemin tuaj të diskut. Dhe cilido kesh që mund të keni atje, çfarëdo grupi që keni atje, ata nuk do ta mbajnë aq.
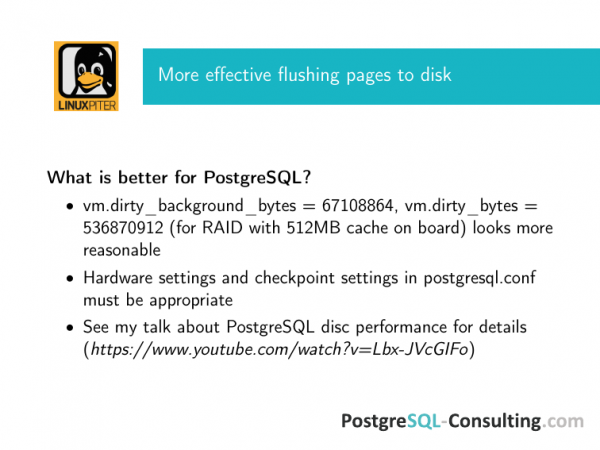
Prandaj ne rekomandojmë që këto numra të konfigurohen menjëherë në përputhje me mundësitë e kontrolluesit tuaj RAID. Këtu kam dhënë një rekomandim për një kontrollues që ka 512 MB kesh.
Kontrollohet gjithçka shumë thjeshtë. Mund të vendosni vm.dirty_background në byte. Dhe këto cilësime anullojnë dy të parat. Ose ratio bazë, ose ato që janë aktivizuar me byte do të funksionojnë. Por që për shkak se unë jam një konsulent DBA dhe punoj me klientë të ndryshëm, përpiqem të jem i kujdesshëm dhe prandaj, nëse është në byte, atëherë në byte. Askush nuk dha ndonjë garanci që një admin i mirë nuk do të shtojë memorie në server, nuk do ta rindezë atë, ndërsa numri do të mbetet i njëjtë. Thjesht llogaritni këto numra që gjithçka të hyjë me garanci.
Çfarë ndodh nëse nuk arrini? Kam shkruar se çdo flushing ndalet efektivisht, por në të vërtetë kjo është një figurë e fjalëve. Sistemi operativ ka një problem të madh - ka shumë faqe të pista, prandaj ndalet efektivisht IO që gjenerojnë klientët tuaj, dmth, aplikacioni që dërgon një kërkesë SQL në databazë, ai pret. Çdo hyrje-dali në të është në prioritetin më të ulët, sepse databaza është e angazhuar me checkpoint-in. Dhe kur do ta përfundojë atë është krejtësisht e paqartë. Dhe kur të arrini flushing jo në sfond, kjo do të thotë që të gjitha IO-të janë e angazhuar me të. Dhe derisa të përfundojë, nuk do të bëni asgjë.
Këtu ka edhe dy momente të rëndësishme që e kalojnë këtë raport. Këto cilësime duhet të përputhen me cilësimet në postgresql.conf, dmth, cilësimet e checkpoints. Dhe sistemi juaj disk duhet të jetë i konfiguruar në mënyrë adekuate. Nëse keni një RAID me cache, atëherë duhet të ketë një bateri mbi të. Njerëzit blejnë RAID me një cache të mirë pa bateri. Nëse keni SSD në RAID, ato duhet të jenë serverike, duhet të kenë kondensatorë. Këtu është një listë e detajuar kontrolli. Në këtë lidhje ka raportin tim mbi si të konfiguroni performancën e disqeve në PostgreSQL. Aty janë të gjitha këto lista kontrolli.
Çfarë tjetër mund ta komplikojë shumë jetën? Këto janë dy parametra. Ato janë relativisht të reja. Ato mund të jenë të aktivizuara si parazgjedhje në aplikacione të ndryshme. Dhe mund të komplikojnë jetën po aq, nëse aktivizohen gabimisht.
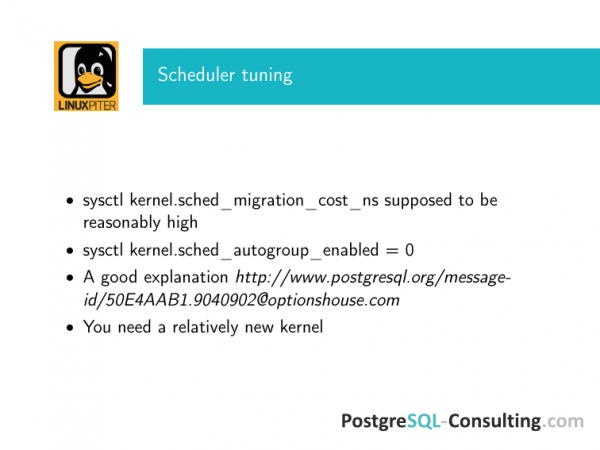
Ekzistojnë dy gjëra relativisht të reja. Ato tashmë janë paraqitur në bërthamën e tretë. Këto janë sched_migration_cost në nanosekonda dhe sched_autogroup_enabled, e cila është aktivizuar si parazgjedhje.
Dhe si i çrregullojnë ata jetën? Çfarë është sched_migration_cost? Në Linux scheduler mund të migrojë një proces nga një CPU në një tjetër. Dhe për PostgreSQL, i cili ekzekuton kërkesa, migrimi në një CPU tjetër nuk kuptohet aspak për çfarë duhej. Për bazën e të dhënave – kjo është shumë keq. Prandaj, një politikë e arsyeshme është të vendosësh migration_cost në një vlerë të madhe, të paktën disa mijëra nanosekonda.
Çfarë do të thotë kjo për scheduler? Do të mendohet se për një periudhë të caktuar koha, ky proces është ende i nxehtë. Kështu që, nëse keni një transaksion të gjatë që merret me diçka gjatë, scheduler do ta kuptojë këtë. Ai do të mendojë se derisa të kalojë ky timeout, nuk ka nevojë ta migrojë këtë proces askund. Nëse në atë moment procesi po bën diçka, ai nuk do të migrohet askund, ai do të përfundojë punën në atë CPU që iu është caktuar. Dhe rezultati është i shkëlqyer.
Momentin tjetër – është autogroup. Ka një ide të mirë për ngarkesa specifike, që nuk kanë të bëjnë me bazat moderne të të dhënave – kjo është grupimi i proceseve sipas terminalit virtual nga i cili janë nisur. Kjo është e përshtatshme për disa detyra. Në praktikë, PostgreSQL është një sistem me shumë procese me prefork, i cili aktivizohet nga një terminal. Keni një lock writer, një checkpoint dhe gjitha kërkesat tuaja nga klientët do të grumbullohen në një scheduler, në një CPU. Dhe atje do të presin së bashku përsa kohë që ai do të lirohet, duke penguar njëri-tjetrin dhe duke zënë rastin e tij për më gjatë. Kjo është një histori që nuk ka nevojë në një ngarkesë të tillë dhe prandaj duhet të çaktivizohet.
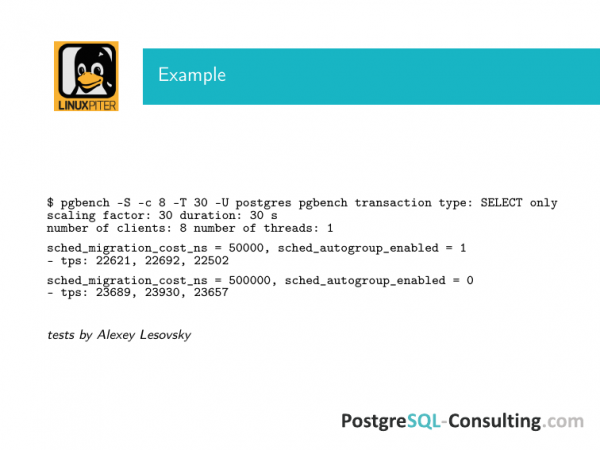
Kolegu im, Aleksej Lesovski, bëri teste me një pgbench të thjeshtë, ku rriti me një rend migrimin e kostos dhe çaktivizoi autogroup. Dallimi në një pajisje të keqe doli pothuajse 10%.. Ka një diskutim në listën e postave të postgres, ku njerëzit sjellin rezultate se si ndryshimet e tilla kanë ndikuar në shpejtësinë e kërkesës. kanë ndikuar në 50%.. Ka shumë histori të tillë.
Dhe përfundimisht, për politikën e kursimit të energjisë. Është mirë që tani Linux mund të përdoret në laptop. Dhe ai do të konsumohet dukshëm mirë energjinë e baterisë. Por papritur zbulon se kjo mund të ndodhë edhe në server.
Më tej, nëse merrni serverë me qira nga ndonjë ofrues hostimi, atëherë "mirësitë" hoste nuk kujdesen që ju të keni një performancë më të mirë. Objektivi i tyre është që të sigurojnë përdorimin maksimal të harduerit. Prandaj, ata mund të aktivizojnë automatikisht modin e kursimit të energjisë në sistemin operativ.
Nëse përdorni në serverin e bazës së të dhënave me ngarkesë intensive këtë mirësi, zgjedhja juaj është acpi_cpufreq + performance. Edhe me ondemand do të keni probleme.
Intel_pstate është një driver pak më ndryshe. Dhe tani preferohet ky, si më i fundit dhe më i mirë në funksionim.
Dhe, për pasojë, guvernatori vetëm performance. Ondemand, powersave dhe të gjitha të tjerat - nuk janë për ju.
Rezultatet nga explain analyze PostgreSQL mund të ndryshojnë në disa renditje, nëse aktivizoni powersave, sepse praktikisht CPU-ja do të planifikohet në një mënyrë krejtësisht të paparashikueshme nën bazën tuaj.
Këto gjëra mund të jenë të aktivizuara për defolt. Shikoni me kujdes - a i kanë aktivizuar ato për defolt. Kjo mund të jetë vërtet një problem i madh.
Dhe në fund, doja të falënderoja djemtë nga ekipi ynë DBA PosgreSQL-Consulting, veçanërisht Maksin Bogukun dhe Aleksein Lesovskin, të cilët çdo ditë përballen me sfida në këtë fushë. Ne përpiqemi të bëjmë gjithçka sa më mirë për klientët tanë, që gjithçka të funksionojë për ta. Këtu është si me udhëzimet për sigurinë ajrore. Çdo gjë është shkruar me gjak. Çdo njëra nga këto bolta është zbuluar gjatë një problemi të caktuar. Me kënaqësi i ndaj ato me ju.
Pyetje:
Faleminderit! Nëse, për shembull, një kompani dëshiron të kursejë dhe të vendosë bazën e të dhënave dhe logjikën e aplikacionit në një server të vetëm, ose nëse kompania ndjek tendencën moderne të arkitekturave mikroshërbimesh, ku PostgreSQL ekzekutohet në një kontejner. Cila është ideja? Sysctl ndikon globalisht në gjithë bërthamën. Nuk kam dëgjuar që sysctl të virtualizohej ndonjëherë, që të funksiononte veçmas në kontejner. Ka vetëm cgroup dhe atje ka kontroll vetëm për një pjesë. Si mund të jetoni me këtë? Ose nëse dëshironi performancë, atëherë ekzekutoni PostgreSQL në një server fizike të veçantë dhe optimizojeni atë?
Ne e kemi përgjigjur pyetjen tuaj në tre mënyra. Nëse flasim për një server fizik, që mund të optimizohet etj., atëherë relaksohuni, gjithçka do të funksionojë mirë pa këto konfigurime. Nëse keni një ngarkesë të tillë që kërkon këto konfigurime, atëherë do të shkoni te serveri fizik më shpejt se sa te këto konfigurime.
Cila është problemi? Nëse është një VM, atëherë me shumë mundësi do të keni shumë probleme, për shembull, me atë se në shumicën e VMs ka një latencë disku që është mjaft inconsistente. Edhe nëse kapaciteti i kalimit të të dhënave është i mirë, një transaksion i vetëm i dështuar në operacionin e hyrjes-daljes, që nuk ndikon shumë në kapacitetin mesatar të kalimit, që ndodhi në momentin e checkpoint-it ose në momentin e shkrimit në WAL, do t'i shkaktojë shumë problemet bazës së të dhënave. Dhe do ta vini re këtë përpara se të përballeni me këto probleme.
Nëse keni NGINX në të njëjtin server, do të keni të njëjtin problem. Ai do të garojë për memorien e ndarë. Dhe nuk do të arrini te ato probleme që përmenden këtu.
Por otro lado, algunos de estos parámetros seguirán siendo relevantes para usted. Por ejemplo, con sysctl establecer dirty_ratio para que no sea tan extremo; de todos modos, esto ayudará. De una forma u otra, tendrá interacción con el disco. Y será de una manera incorrecta. Estos son realmente los parámetros predeterminados que mostré. Y en cualquier caso, es mejor cambiarlos.
Con NUMA pueden surgir problemas. VmWare, por ejemplo, funciona bien con NUMA con configuraciones completamente opuestas. Y aquí hay que elegir: servidor físico o no físico.
Tengo una pregunta relacionada con Amazon AWS. Tienen imágenes preconfiguradas. Una de ellas se llama Amazon RDS. ¿Hay alguna configuración personalizada para su sistema operativo?
Hay configuraciones, pero son otras configuraciones. Aquí estamos configurando el sistema operativo en función de cómo la base de datos usará esto. Y allí hay parámetros que determinan hacia dónde ir en este momento, una especie de shaping. Es decir, necesitamos tantos recursos, y los utilizaremos ahora. Después de eso, Amazon RDS incorpora esos recursos, y ahí la productividad cae. Hay historias separadas sobre cómo algunas personas comienzan a experimentar con esto. A veces con bastante éxito. Pero esto no tiene relación con la configuración del sistema operativo. Es una especie de hackeo de nube. Es otra historia.
¿Por qué las Transparent huge pages no tienen efecto en comparación con Huge TLB?
No tienen. Se puede explicar de muchas maneras. Pero en realidad, simplemente no lo tienen. ¿Cuál es la historia de PostgreSQL? Al iniciar, asigna un gran bloque de memoria compartida. Transparent o no transparent, eso no importa en absoluto. El hecho de que se asignen al inicio lo explica todo. Y si hay mucha memoria y se necesita reconstruir el segmento shared_memory, entonces Transparent huge pages será relevante. En PostgreSQL, simplemente se asigna un gran bloque al inicio y ya está; no pasa nada especial después. Claro, se puede utilizar, pero hay un riesgo de corrupción en shared_memory cuando se vuelve a asignar algo. PostgreSQL no sabe nada de eso.
Burimi: habr.com
