

Ishte viti 2019 dhe ne ende nuk kishim një zgjidhje standarde për agregimin e logëve në Kubernetes. Në këtë artikull, dëshirojmë, duke përdorur shembuj nga praktika reale, të ndajmë kërkimet tona, problemet e hasura dhe zgjidhjet e tyre.
Megjithatë, përpara se të vazhdoj, dua të theksoj se klientët e ndryshëm e kuptojnë mbledhjen e logëve në mënyra të ndryshme:
- disa duan të shohin logët e sigurisë dhe auditimit;
- disa - logimin e përqendruar të tërë infrastrukturës;
- ndërsa disa janë të kënaqur me mbledhjen e logëve të aplikacionit, duke përjashtuar, për shembull, balancuesit.
Rreth asaj se si realizuam dëshirat e ndryshme dhe me çfarë vështirësish u përballëm, bëhet fjalë më poshtë.
Teoria: për mjetet për logët
Historia e komponenteve të sistemit të logimit
Logimi ka kaluar një rrugë të gjatë, gjatë së cilës janë zhvilluar metodologji për mbledhjen dhe analizën e logëve, që ne përdorim sot. Që nga vitet 1950, në Fortran u shfaq një analog i kanaleve standarde të hyrjes dhe daljes, që ndihmonin programuesit në debugimin e programeve të tyre. Këto ishin logët e para kompjuterike, që lehtësuan jetën e programuesve të asaj kohe. Sot në to shohim komponentin e parë të sistemit të logimit - burimi ose "prodhuesi" (producer) i logëve.
Shkenca kompjuterike nuk ka qëndruar, u shfaqën rrjetet kompjuterike, klasterët e parë... Sistemet komplekse filluan të funksiononin, duke përfshirë disa kompjuterë. Tani administratorët e sistemeve ishin të detyruar të mbledhin logë nga disa makina dhe në raste të veçanta mund të shtonin edhe mesazhe nga bërthama e OS-për rasti se kishte nevojë për të hetuar një dështim sistemik. Për të përshkruar sistemet e mbledhjes së logëve të përqendruar, në fillim të viteve 2000 u publikua , i cili standardizoi remote_syslog. Kështu u shfaq një komponent tjetër i rëndësishëm: kollektor (mbledhës) logësh dhe depoja e tyre.
Me rritjen e volumit të logëve dhe shpërthimin e teknologjive të uebit, u paraqit nevoja që logët të tregohej lehtësisht për përdoruesit. Në vend të mjeteve të thjeshta të konsolës (awk/sed/grep) erdhën shikues logësh — komponenti i tretë.
Me ndihmën e rritjes së volumit të logeve, është bërë e qartë se loget janë të nevojshme, por jo të gjitha. Gjithashtu, loget e ndryshme kërkojnë nivele të ndryshme ruajtjeje: disa mund të humben pas një dite, ndërsa të tjerët duhet të ruhen për 5 vjet. Pra, në sistemin e logimit u shtua një komponent filtrimi dhe rrugëzimi i fluxeve të të dhënave - le të quhet filtri.
Depozitat gjithashtu bënë një kërcim të rëndësishëm: nga skedarët e zakonshëm kaluan në bazat e të dhënave relacionale, e më pas edhe në depozitat orientuese për dokumente (p.sh., Elasticsearch). Kështu, depozita u ndan nga kolektori.
Në fund të fundit, vetë koncepti i logit u zgjerua në një lloj fluksi abstrakt ngjarjesh që dëshirojmë të ruajmë për histori. Ose më saktë - për atë rast kur do të nevojitet të bëhet një hetim ose të përgatitet një raport analitik…
Si rezultat, brenda një periudhe relativisht të shkurtër, mbledhja e logeve u zhvillua në një nën sistem të rëndësishëm, të cilin me të drejtë mund ta quajmë një nga nëndegët në Big Data.
Nëse dikur printimet e zakonshme mund të ishin mjaft për "sistemin e logimit", tani situata ka ndryshuar ndjeshëm.
Kubernetes dhe loget
Kur Kubernetes erdhi në infrastrukturë, problemi ekzistues i mbledhjes së logeve nuk e shmangu atë. Në një farë mënyre, qëndroi madje më shqetësues: menaxhimi i platformës infrastrukturore u thjeshtua, por njëkohësisht u komplikuar. Shumë shërbime të vjetra filluan migrimin në rrugët mikrosherbimeve. Në kontekstin e logeve, kjo u shpreh në një numër në rritje burimesh logu, ciklin e veçantë të jetësit të tyre, dhe nevojën për të ndjekur përmes logeve lidhjet e të gjitha komponenteve të sistemit…
Duke u hedhur përpara, mund të konstatonim se tani, fatkeqësisht, nuk ka një variant të standardizuar të logimit për Kubernetes, i cili do të dallonte ndjeshëm nga të tjerët. Schemat më të njohura në komunitet përfshijnë:
- disa vendosin një grumbull EFK (Elasticsearch, Fluentd, Kibana);
- disa - provojnë operatorin e logimit së fundmi të lëshuar apo përdorin ;
- ne (ndoshta edhe jo vetëm ne?..) në shumë mënyra jemi të kënaqur me zhvillimin tonë të brendshëm - …
Në përgjithësi, ne përdorim këto kombinime në klasterët K8s (për zgjidhjet e vetë-hostuara):
- ;
- .
Megjithatë, nuk do të ndalem në udhëzimet për instalimin dhe konfigurimin e tyre. Në vend të kësaj, do të përqendrohem te disavantazhet e tyre dhe përmbledhjet më globale mbi situatën me logat në tërësi.
Praktika me logat në K8s
«Logat e përditshme», sa jeni ju?..
Grumbullimi i centralizuar i logave nga një infrastrukturë mjaft të madhe kërkon burime të konsiderueshme, të cilat do të shpenzohen për grumbullimin, ruajtjen dhe përpunimin e logave. Gjatë përdorimit të projekteve të ndryshme ne u përballëm me kërkesa të ndryshme dhe problemet që nga to lindën gjatë përdorimit.
Le të provojmë ClickHouse
Le të shqyrtojmë një depo të centralizuar në një projekt me një aplikacion, i cili gjeneron loga mjaft aktivisht: më shumë se 5000 rreshta në sekondë. Të fillojmë punën me logat e tij, duke i ruajtur ato në ClickHouse.
Sa herë që kërkohet maksimumi i realtime, një server me 4 bërthama me ClickHouse do të jetë tashmë i ngarkuar në sistemin diskor:
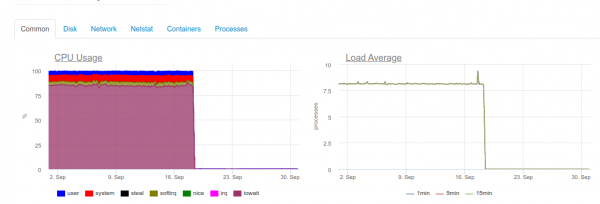
Ky lloj ngarkese është i lidhur me faktin që ne po përpiqemi të shkruajmë sa më shpejt në ClickHouse. Dhe për këtë DB reagon me ngarkesë të rritur në disk, e cila mund të prodhojë gabime të tilla:
DB::Exception: Too many parts (300). Merges are processing significantly slower than inserts
Çështja është se në ClickHouse (ku ndodhen të dhënat e logave) kanë vështirësi gjatë operacioneve të shkrimit. Të dhënat e vendosura në to gjenerojnë një pjesë përkohësore, e cila më pas bashkohet me tabelën kryesore. Si rezultat, shkrimi bëhet shumë kërkues për diskun, dhe mbi të rëndon kufizimi, lajmërimi për të cilin e morëm më sipër: në 1 sekondë mund të bashkohen jo më shumë se 300 subpartita (faktikisht, janë 300 insertë në sekondë).
Për të shmangur një sjellje të tillë, sa më shumë që të jetë e mundur dhe jo më shpesh se një herë në 2 sekonda. Megjithatë, shkrimi në grupe të mëdha nënkupton se ne duhet të shkruajmë më rrallë në ClickHouse. Kjo, nga ana tjetër, mund të çojë në mbushjen e tamponit dhe humbjen e logave. Zgjidhja është të rritet tamponi i Fluentd, por atëherë do të rritet gjithashtu dhe konsumimi i memories.
Shënim: Një anë tjetër problematike e zgjidhjes sonë me ClickHouse ishte e lidhur me faktin se pjesëtimi në rastin tonë (loghouse) realizohej përmes tabelave të jashtme, të lidhura . Kjo çon në atë që, kur përzgjidhen intervale të mëdha kohore, nevojiten memorje të tepërta operative, pasi tabela meta kontrollon të gjitha partitionet - edhe ato që nuk përmbajnë të dhëna të nevojshme. Sidoqoftë, tani ky qasje mund të shpallet pa kuptim për versionet e fundit të ClickHouse (c ).
Si përfundim, është e qartë se për të mbledhur log-e në kohë reale në ClickHouse, burimet nuk do të mjaftojnë për çdo projekt (saktësisht, shpërndarja e tyre nuk do të jetë e arsyeshme). Për më tepër, do të nevojitet të përdoren bateri, të cilin do të kthehemi. Rasti i përshkruar më sipër është real. Dhe në atë kohë ne nuk arritëm të ofronim një zgjidhje të besueshme dhe stabile që do të kënaqte klientin dhe do të lejonte mbledhjen e log-eve me një vonesë minimale…
Dhe Elasticsearch?
Dihet se Elasticsearch përballon ngarkesa të mëdha. Le të provojmë atë në të njëjtin projekt. Tani ngarkesa duket si më poshtë:
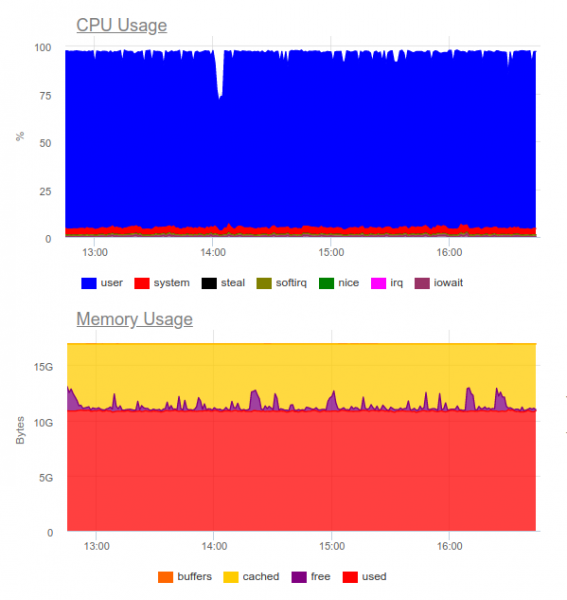
Elasticsearch arriti të përballojë fluksin e të dhënave, megjithatë regjistrimi i tillë në të e shfrytëzon ndjeshëm CPU-në. Kjo zgjidhet duke organizuar një klaster. Nga një këndvështrim teknik, kjo nuk është një problem, megjithatë do të rezultojë se vetëm për operimin e sistemit të mbledhjes së log-eve ne tashmë përdorim rreth 8 bërthama dhe kemi një komponent të ngarkuar ndjeshëm në sistem…
Përfundimi: ky variant mund të jetë i arsyeshëm, por vetëm në rastin kur projekti është i madh dhe drejtuesit e tij janë gati të shpenzojnë burime të konsiderueshme për sistemin e centralizuar të log-eve.
Atëherë lind një pyetje e kuptueshme:
Cilat log-e janë vërtet të nevojshme?
 Le të përpiqemi të ndryshojmë qasjen vetë: log-et duhet të jenë njëkohësisht informuese dhe të mos mbulojnë çdo ngjarje në sistem.
Supozoni se kemi një dyqan të suksesshëm online. Cilat log-e janë të rëndësishme? Të mbledhim maksimumin e informacionit, për shembull, nga portali i pagesave - një ide e shkëlqyer. Por nga shërbimi i prerjes së imazheve në katalogun e produkteve, nuk na interesojnë të gjitha log-et: mjafton vetëm gabimet dhe monitorimi i zgjeruar (për shembull, përqindja e gabimeve 500 që gjeneron ky komponent).
Këtu ardhëm në përfundimin se centralizimi i log-eve nuk është gjithmonë i arsyeshëm. Shumë shpesh klienti dëshiron të mbledhë të gjitha log-et në një vend, megjithatë në të vërtetë nga e gjithë log-u kërkohen vetëm 5% e mesazheve, të cilat janë kritike për biznesin:
- Ndonjëherë është e mjaftueshme të konfiguroni, të themi, vetëm madhësinë e logut të kontejnerëve dhe grumbulluesin e gabimeve (p.sh., Sentry).
- Për hetimin e incidenteve, shpesh mund të mjaftojë një njoftim për gabimin dhe, në fakt, një log të madh vendor.
- Kemi pasur projekte që kanë arritur të mblidhen ekskluzivisht me teste funksionale dhe sisteme mbledhjeje gabimesh. Programuesi nuk kishte nevojë për logje si të tilla - ata gjithçka e shihnin në gjurmët e gabimeve.
Ilustrim nga jeta
Një shembull i mirë mund të jetë historia tjetër. Na erdhi një kërkesë nga ekipi mbrojtës i njërit nga klientët tanë, që kishte përdorur një zgjidhje tregtare, e cila ishte zhvilluar shumë përpara se të implementohej Kubernetes.
Ishte e nevojshme të "bashkëpunonim" sistemin e mbledhjes qendrore të logjeve me sensorin korporativ të zbulimit të problemeve - QRadar. Ky sistem di të pranojë logje përmes protokollit syslog, të marrë nga FTP. Megjithatë, ta integrojmë atë me plug-in-in remote_syslog për fluentd nuk arritëm ta bëjmë menjëherë. (siç doli se ). Problemet me konfigurimin e QRadar dolën nga ekipi mbrojtës i klientit.
Si rezultat, një pjesë e logjeve, kritike për biznesin, u ngarkua në FTP të QRadar, ndërsa pjesa tjetër u redirektua përmes remote syslog direkt nga nodet. Për këtë shkak ne madje shkruam — ndoshta do të ndihmojë dikë të zgjidhë një problem të ngjashëm… Falë skemës që rezultoi, klienti merrte dhe analizonte logjet kritike (me mjete të preferuara), ndërsa ne arritëm të ulin kostot për sistemin e logimit, duke ruajtur vetëm muajin e fundit.
Një shembull tjetër është mjaft tregues se si nuk duhet vepruar. Një nga klientët tanë, për përpunimin e çdo ngjarjeve që vijnë nga përdoruesi, kishte bërë një dalje jo-strukturuar në shumë rreshta në log. Siç mund të mendohet lehtësisht, logjet e këtij lloji ishin shumë të vështira për t'u lexuar dhe për të ruajtur.
Kriteret për logjet
Shembuj të tillë na çojnë në përfundimin se, përveç zgjedhjes së sistemit të mbledhjes së logjeve, duhet të projektohen gjithashtu vetë logjet! Cilat janë kërkesat këtu?
- Logjet duhet të jenë në format që mund të lexojnë makinat (p.sh., JSON).
- Logjet duhet të jenë kompakte dhe me mundësi për të ndryshuar nivelin e logimit, për të debugger probleme të mundshme. Në këtë rast, në mjediset prodhuese duhet të aktivizohen sistemet me nivel logimi si Kujdes ose Gabim.
- Logs must be normalized, meaning all strings in the log object should have the same field type.
Unstructured logs can lead to issues with loading logs into storage and a complete halt in their processing. For illustration, here is an example of a 400 error that many have probably encountered in fluentd logs:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
The error means that you are sending a field to the index with a predefined mapping, the type of which is unstable. A simple example is a field in nginx logs with a variable $upstream_status. It can be either a number or a string. For example:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "\/staffs\/265.png", "protocol": "HTTP\/1.1", "status": "200", "body_size": "906", "referrer": "https:\/\/example.com\/staff", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "\/staff", "protocol": "HTTP\/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
The logs show that the server 10.100.0.10 responded with a 404 error, and the request went to another content storage. As a result, the log value became like this:
"upstream_response_time": "0.001, 0.007"
This situation is so common that it even deserves a separate .
And what about reliability?
There are cases when it is crucial to have all logs without exception. And the typical log collection schemes for K8s mentioned above have problems in this regard.
For instance, fluentd cannot collect logs from short-lived containers. In one of our projects, a container with database migration lived less than 4 seconds before being deleted — as per the relevant annotation:
"helm.sh/hook-delete-policy": hook-succeeded
Because of this, the migration execution log did not get into the storage. In this case, the before-hook-creation.
policy can help. Another example is log rotation in Docker. Let's say there is an application that actively writes logs. Under normal conditions, we manage to process all logs, but as soon as issues arise — for example, as described above with incorrect formatting — processing stops, and Docker rotates the file. The result is that critical business logs may be lost.
Pikërisht për këtë It's important to separate log streams, embedding the sending of the most valuable directly into the application to ensure their preservation. Additionally, it wouldn't hurt to create a kind of "log accumulator", which could survive a brief unavailability of storage while retaining critical messages.
Finally, one must not forget that it's vital to monitor any subsystem effectively. Otherwise, you may easily encounter a situation where fluentd is in a CrashLoopBackOff dhe nuk dërgon asgjë, dhe kjo ka rrezik për humbjen e informacionit të rëndësishëm.
Përfundimet
Në këtë artikull ne nuk shqyrtojmë zgjidhjet SaaS si Datadog. Shumica e problemeve të përshkruara këtu tashmë janë zgjidhur në një mënyrë ose tjetër nga kompani tregtare që specializohen në mbledhjen e logeve, por jo të gjithë mund të përdorin SaaS për arsye të ndryshme. (arsyet kryesore janë kostoja dhe përputhshmëria me 152-FZ).
Mbledhja e centralizuar e logeve në fillim duket si një detyrë e thjeshtë, por nuk është aspak e tillë. Është e rëndësishme të mbani mend se:
- Duhet të logoni në detaje vetëm komponentet kritike, ndërsa për sistemet e tjera mund të konfiguroni monitorimin dhe mbledhjen e gabimeve.
- Loget në production duhet të jenë minimale, për të mos ngarkuar shtesë.
- Loget duhet të jenë të lexueshme nga makineritë, të normalizuara, dhe të kenë një format të rreptë.
- Loget vërtet kritike duhet të dërgohen si një rrjedhë e veçantë, e cila duhet të ndahet nga ato kryesore.
- Duhet të mendoni për një akumulator logesh, i cili mund të shpëtojë nga shpërthimet e ngarkesës së lartë dhe ta bëjë ngarkesën në ruajtje më të barabartë.
Këto rregulla të thjeshta, nëse zbatohen në çdo vend, do të lejonin që skemat e përmendura më lart të funksionojnë — edhe pse u mungojnë komponente të rëndësishme (akumulatori). Nëse nuk ndiqni këto principe, detyra me lehtësi do t'ju çojë ju dhe infrastrukturën tuaj në një tjetër komponent me ngarkesë të lartë (dhe në të njëjtën kohë pak efektiv) të sistemit.
P.S.
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «».
Burimi: habr.com
