

Monitorimi është bërë një komponent shumë i rëndësishëm i zgjidhjeve të rritura cloud me rritjen e kompleksitetit të sistemeve të shpërndara. Ai është i nevojshëm për të kuptuar sjelljen e tyre. Nevojiten mjete të shkallëzueshme që mund të mbledhin të dhëna nga të gjitha shërbimet - dhe t'u ofrojnë specialistëve një ndërfaqe të vetme me analizë të performancës, demostrimin e gabimeve, disponueshmërinë dhe regjistrat.
Këto mjete gjithashtu duhet të jenë efikase dhe të shkallëzuara. Në këtë artikull ne do të shqyrtojmë dy stakët e njohura të teknologjisë: EFK (Elasticsearch) dhe PLG (Loki) dhe do t'i analizojmë arkitekturat dhe dallimet e tyre.
Staku EFK
Mund të keni dëgjuar tashmë për ELK ose EFK, të dyja janë staka popullore që përbëhen nga disa pjesë të veçanta: Elasticsearch (depo objektesh), Logstash ose FluentD (mbledhja dhe agregimi i regjistrave) dhe Kibana për vizualizimin.
Një skemë tipike e veprimit duket kështu:
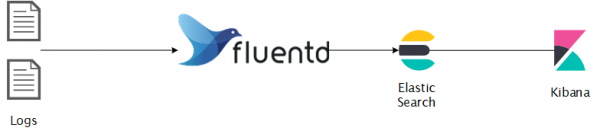
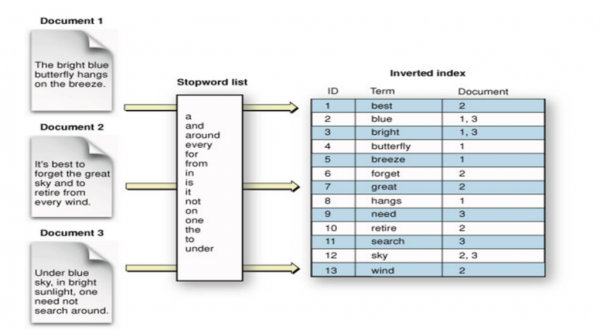
Elasticsearch — një depo objektesh e shpërndarë me kërkim dhe analytic në kohë reale. Një zgjidhje e shkëlqyer për të dhëna gjysmë të strukturuara, siç janë regjistrat. Informacioni ruhet në formën e dokumenteve JSON, indikohet në kohë reale dhe shpërndahet në nyjet e klasterit. Përdoret një indeks i kthyer që përmban të gjitha fjalët unike dhe dokumentet e lidhura me to për kërkimin me tekst të plotë, i cili bazohet në motorin e kërkimit Apache Lucene.
FluentD — është një mbledhës të dhënash që kryen unifikimin e të dhënave gjatë mbledhjes dhe konsumit. Ai përpiqet të renditë të dhënat në JSON sa më shumë që të jetë e mundur. Arkitektura e tij është e shkallëzueshme, ka më shumë se , të mbështetura nga komuniteti, për çdo rast.
Kibana — një mjet vizualizimi të dhënash për Elasticsearch me veçori të ndryshme shtesë, si analiza e serive temporale, grafikët, mësimi automat, dhe të tjera.
Arkitektura e Elasticsearch
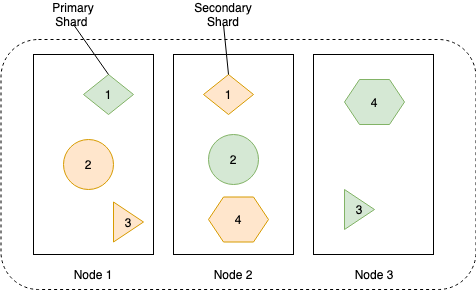
Të dhënat e klasterit Elasticsearch ruhen të shpërndara në të gjitha nyjet e tij. Klasteri përbëhet nga disa nyje për të përmirësuar disponueshmërinë dhe qëndrueshmërinë. Çdo nyje mund të kryejë të gjitha rolet e klasterit, por në shpërndarjet e mëdha të shkallëzuara, nyjeve zakonisht u caktohen detyra të veçanta.
Llojet e nyjeve të klasterit:
- nyja master — menaxhon klasterin, janë të nevojshme të paktën tre, njëra është gjithmonë aktive;
- nyja e dhënave — ruan të dhëna të indeksuara dhe kryen detyra të ndryshme me to;
- node i ngrënies - organizon kanalet për konvertimin e të dhënave para indeksimit;
- node koordinues - rute kërkesash, reduktim i fazës së përpunimit të kërkimeve, koordinimi i indeksimit masiv;
- node alarmimi - nisja e detyrave për njoftim;
- node mësimi makinerik - përpunimi i detyrave të mësimit makinerik.
Në diagramin më poshtë tregohet si ruhet dhe riprodhohet të dhënat në nodet për arritjen e një disponibiliteti më të lartë të të dhënave.
Të dhënat e çdo replike ruhen në indeksin e inverzituar, diagrami më poshtë tregon si ndodh kjo:
Instalimi
Detajet mund të shihen , do të përdor helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsSteka PLG
Nuk është e çuditshme nëse nuk e gjeni këtë akronim, pasi njihet më shumë si Grafana Loki. Në çdo rast, ky stek po fiton popullaritet, pasi aplikon zgjidhje teknike të matur. Mund të keni dëgjuar tashmë për Grafana, mjetin popullor për vizualizimin e të dhënave. Krijuesit e saj, duke u frymëzuar nga Prometheus, zhvilluan Loki, një sistem aggregimi logësh me performancë të lartë, të shkallëzueshëm horizontalisht. Loki indekson vetëm metadat, por jo logët vetë, kjo zgjidhje teknike e bëri atë të lehtë për t'u përdorur dhe ekonomik.
Promtail - agjent për dërgimin e logëve nga sistemi operativ në klasterin Loki. Nëse tashmë e dini se çfarë është analiza e grupeve dhe se si ta bëni në SQL, kaloni menjëherë në seksionin e fundit. - mjet vizualizimi bazuar në të dhënat nga Loki.
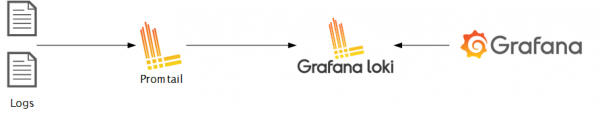
Loki është ndërtuar mbi të njëjtin parim si Prometheus, prandaj i përshtatet mirë ruajtjes dhe analizës së logëve Kubernetes.
Arkitektura e Loki
Loki mund të ekzekutohet si në mënyrën e një procesi, ashtu edhe në formën e disa proceseve, që siguron shkallëzim horizontal.
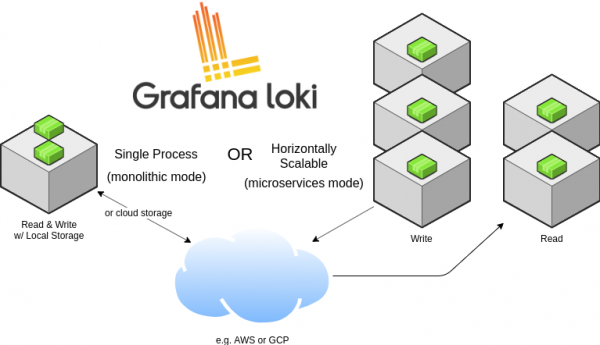
Ai gjithashtu mund të funksionojë, si një aplikacion monolit, ashtu edhe si një mikroshërbim. Ekzekutimi në formën e një procesi mund të jetë i dobishëm për zhvillimin lokal ose për monitorim të vogël. Për zbatimin industrial dhe ngarkesën e shkallëzueshme, rekomandohet të përdoret varianti i mikroshërbimit. Rrugët e regjistrimit dhe të leximit të të dhënave janë të ndara, kështu që mund të konfigurohet dhe të shkallëzohet mjaft saktë sipas nevojës.
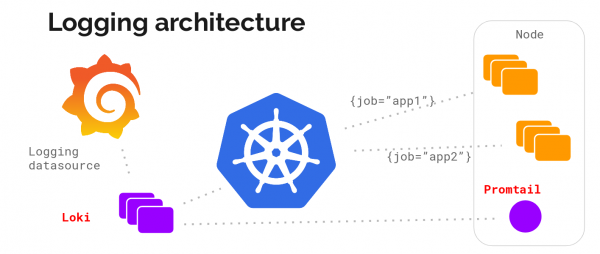
Le të shohim arkitekturën e sistemit të mbledhjes së logëve pa detaje:
Dhe këtu - përshkrimi (arkitektura mikroshërbimit):
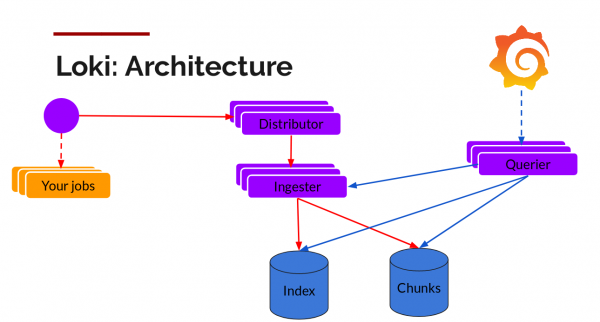
Komponentët:
Promtail — agent, i instaluar në nyje (si një grup shërbimesh), ai nxjerr loge nga detyrat dhe i drejtohet API-së Kubernetes për të marrë metadatat, me të cilat do të etiketohen loget. Më pas ai dërgon logun në shërbimin kryesor Loki. Për përputhjen e metadataset, mbahen të njëjtat rregulla për etiketimin si në Prometheus.
Distributor — shërbim shpërndarës që funksionon si një tampon. Për të përpunuar miliona regjistrime, ai paket loget e ardhshme, duke i ngjeshur ato në blloqe sipas radhës. Njëkohësisht punojnë disa marrës të të dhënave, por loget që i përkasin një rrjedhe të vetme të të dhënave duhet të gjenden vetëm në një prej tyre për të gjithë blloqet e tij. Kjo organizohet në formën e një unazë marrësish dhe heshitjes sekondare. Për qëndrueshmëri dhe tepërsi, bëhet n herë (3, nëse nuk konfigurohen ndryshe).
Ingester — shërbim marrës. Blloqet e të dhënave vijnë të ngjeshura me loget e shtuar. Sa herë që blloku arrin një madhësi të mjaftueshme, ai shkarkohet në bazën e të dhënave. Metadat mbajnë indekse, ndërsa të dhënat nga blloku me log mbërrijnë në Chunks (zakonisht kjo është një ruajtje objektuale). Pas shkarkimit, marrësi krijon një bllok të ri, ku do të shtohen regjistrimet e reja.
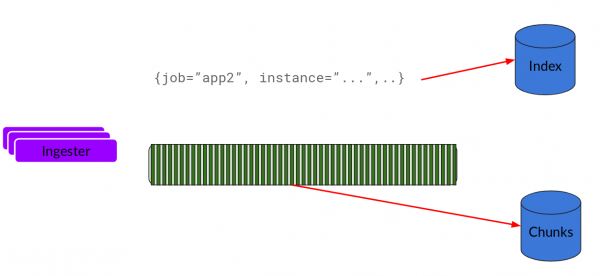
Index — bazë të dhënash, DynamoDB, Cassandra, Google BigTable dhe të tjera.
Chunks — blloqe logesh në formë të ngjeshur, zakonisht ruhen në ruajtje objektuale, për shembull, S3.
Querier — rruga e leximit që bën gjithë punën e zezë. Ai shqyrton intervalin e kohës dhe etiketat, më pas shqyrton indekset për të gjetur përputhje. Më pas lexon blloqet e të dhënave dhe i filtrojnë ato për të marrë një rezultat.
Tani le të shohim gjithçka në veprim.
Instalimi
Për të instaluar në Kubernetes, është më e lehtë të përdorim helm. Supozojmë se ju tashmë e keni vendosur dhe konfiguruar ( shën. e përkthyesit)
Shtojmë repozitorin dhe vendosim stek.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
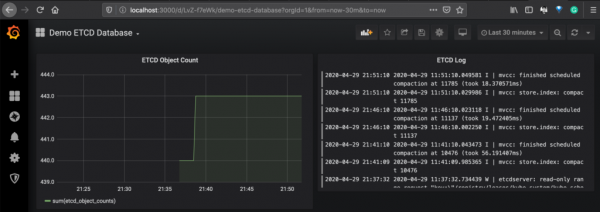
Më poshtë është një shembull i një paneli të instrumenteve, ku janë të dhënat nga Prometheus për metrikat Etcd dhe Loki për loget e podave Etcd.
Tani le të diskutojmë arkitekturën e të dyve, si dhe të krahasojmë mundësitë e tyre me njëra-tjetrën.
Krahasimi
Gjuha e pyetjeve
Në Elasticsearch përdoret Query DSL dhe Lucene query language, të cilat sigurojnë mundësinë e kërkimit me tekst të plotë. Ky është një motor kërkimi i fuqishëm i konsoliduar me mbështetje të gjerë për operatorë. Me ndihmën e tij, mund të kërkoni në kontekst dhe të renditni sipas relevancës.
Në anën tjetër të ringut është LogQL, i aplikuar në Loki, pasardhësi i PromQL (Prometheus query language). Ai përdor etiketat e log-eve për të filtruar dhe marrë të dhënat e log-eve. Ka mundësi të përdoren disa operatorë dhe aritmetikë, siç përshkruhet , por në mundësi ai mbetet pas gjuhës Elastic.
Duke qenë se kërkesat në Loki lidhen me etiketat, ato janë të lehta për t'u lidhur me metrikat, si rezultat është më e lehtë të organizoni monitorimin operativ me to.
Shkallëzueshmëria
Të dy stekët janë horizontalisht të shkallëzueshëm, por me Loki është më e thjeshtë, pasi ka rrugë të ndara për leximin dhe shkruan të dhënat, si dhe ka një arkitekturë mikroshërbimesh. Loki mund të konfigurohet sipas karakteristikave tuaja dhe mund të përdoret për volume shumë të mëdha të të dhënave të log-eve.
Multiaktorshmëria
Multiaktorshmëria e klasterit është një temë e zakonshme për uljen e OPEX, të dy stekët ofrojnë multiaktorshmëri. Për Elasticsearch ka disa për ndarjen e klientëve: një indeks të veçantë për çdo klient, rrugëzim bazuar në klientin, fusha unike të klientit, filtre kërkimi. Në Loki ka në formën e titullit HTTP X-Scope-OrgID.
Çmimi
Loki është shumë ekonomik për shkak se ai nuk bën indeksimin e të dhënave, por vetëm të metadatat. Në këtë mënyrë arrihet dhe memorje (cache), pasi ruajtja objektore është më e lirë se ajo blloku që përdoret në klasteret Elasticsearch.
Përfundim
Steka EFK mund të përdoret për qëllime të ndryshme, duke ofruar fleksibilitet maksimal dhe një ndërfaqe shumëfunksionale Kibana për analitikë, vizualizim dhe kërkesa. Ai mund të përmirësohet më tej me mundësitë e mësimit të makinerive.
Steka Loki është e dobishme në ekosistemin Kubernetes për shkak të mekanizmit të zbulimit të metadatat. Mund të lehtësojë përshtatjen e të dhënave për monitorimin e bazuar në seritë e kohës në Grafana dhe log-e.
Kur flitet për koston dhe ruajtjen afatgjatë të log-eve, Loki është një zgjedhje e shkëlqyer për hyrje në zgjidhjet në re.
Në treg ka më shumë alternativa — disa mund të jenë më të mira për ju. Për shembull, për GKE ekziston integrimi me Stackdriver, i cili ofron një zgjidhje të shkëlqyer për monitorimin. Ne nuk i përfshimë ata në analizën tonë në këtë artikull.
Lidhjet:
Artikulli është përkthyer dhe përgatitur për Habr nga punonjësit — intensiva, video-kurse dhe trajnime korporative nga specialistë praktikë (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Burimi: habr.com
