

Do të shqyrtojmë bazat e logimit në Docker dhe Kubernetes, dhe pastaj do të shqyrtojmë dy instrumente që mund t’i përdorim me besim në prodhim: Grafana Loki dhe staku EFK (Elasticsearch + Fluent Bit + Kibana).
Materiali i artikullit është një përmbledhje nga . Nëse keni dëshirë dhe veçanërisht nevojë prodhuese, mund të kaloni një trajnim të plotë — regjistrohuni për kursin mbi .
Logimi në Docker
Në nivelin Kubernetes, aplikacionet kryhen në kontejnerë, por në nivelin më të ulët ato zakonisht funksionojnë në Docker. Prandaj, duhet të konfigurojmë logimin në mënyrë që të mbledhim loget nga kontejnerët. Kontejnerët nisen nga Docker — kështu që duhet të kuptojmë se si funksionon logimi në nivelin Docker.
Shpresoj që çdo lexues ta dijë: loget e aplikacioneve duhet të shkruhen në stdout/stderr, dhe jo brenda kontejnerit. Loget mblidhen nga Docker Daemon, dhe ai punon saktësisht me ato loge që dërgohen në stdout/stderr. Për më tepër, regjistrimi i logeve brenda kontejnerit sjell probleme: kontejneri fryhet nga rritja e logut (sepse zakonisht nuk ka Logrotate në kontejner), dhe Docker Daemon nuk është në dijeni për këtë log.
Docker ka disa shoferë logu ose plugin për mbledhjen e logeve nga kontejnerët. Në versionin falas Docker Community Edition (CE), ka më pak shoferë logu se në Docker Enterprise Edition (EE) komercial.
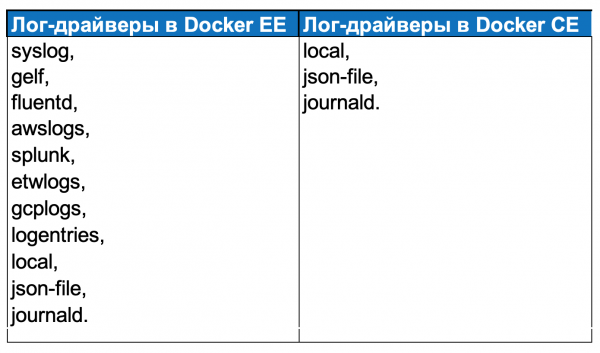
Nuk kam përdorur kurrë Docker EE në praktikë: në Southbridge përpiqemi të respektojmë zgjidhjet Open Source, dhe për klientët shumica e mundësive shtesë të Docker EE nuk janë të nevojshme.
Shoferët e logeve në Docker CE:
local — regjistrimi i logeve në skedarët e brendshëm të Docker Daemon;
json-file — krijimi i json-log në dosjen e çdo kontejneri;
journald — dërgimi i logeve në journald.
Caktimet e logimit në Docker ndodhen në skedarin daemon.json.
Në fushën “log-driver” tregohet plugin, dhe në fushën “log-opts” janë parametrat e tij. Në shembullin më sipër, është tregohet plugin “json-file”, kufizimi i madhësisë së logut është “max-size”: “10m”; kufizimi i numrit të skedarëve (caktimet e rotacionit) është “max-file”: “3”; si dhe vlerat që do të lidhen me loget.
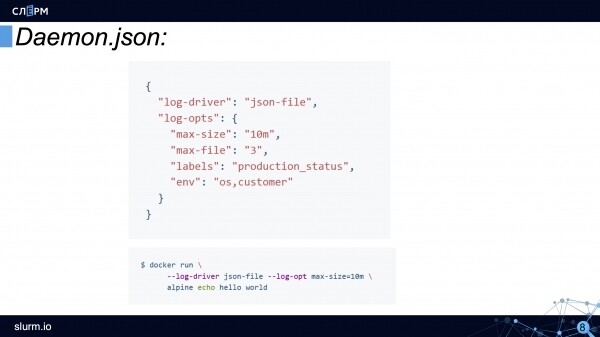
Disa caktime të shoferit të logut mund të përcaktohen përmes utilitarit komandor. Kjo është e përshtatshme, nëse një kontejner i veçantë duhet të fillohet me një shofer logu tjetër.
Ja si duket skema e logimit në Docker:
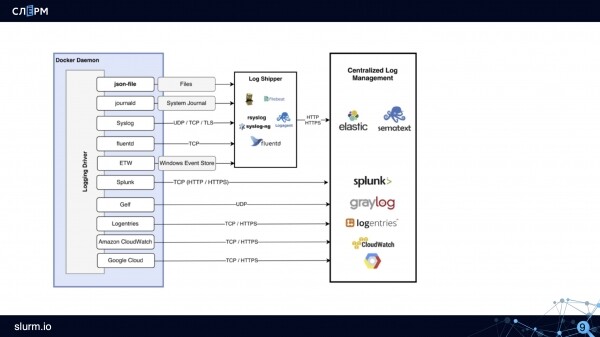
Si për funksionon skema: një log-driver, si p.sh. json-file, krijon skedarë. Mblodhësit e logve (Rsyslog, Fluentd, Logagent dhe të tjerë) mbledhin këta skedarë dhe i dërgojnë për ruajtje në Elastic, Sematext ose depove të tjera.
Veçoritë e regjistrimit në Kubernetes
Thjeshtësisht, skema e regjistrimit në Kubernetes duket kështu: ka një pod, brenda të cilit është një kontejner, ky kontejner dërgon loget në stdout/stderr. Pastaj Docker krijon një skedar dhe regjistron loget, të cilat mund të rrotullohen më pas.
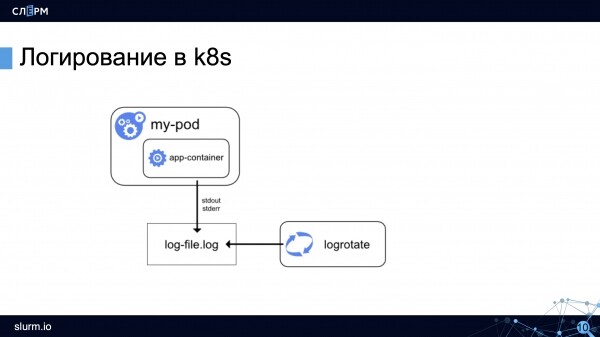
Le të shqyrtojmë veçoritë e regjistrimit në Kubernetes.
Të ruash loget mes përditësimeve. Kjo është një kusht i domosdoshëm për një konfigurim të saktë të regjistrimit. Nëse nuk ruhen loget mes përditësimeve, atëherë kur del një version i ri i aplikacionit, loget e mëparshme do të shuhen, gjithashtu rihapja e kontejnerit do të sjellë humbjen e logeve. Kubernetes ka një çelës —previous, i cili lejon të shikosh loget e aplikacionit para rivendosjes së fundit të Pod-it, por jo më thellë.
Të agregosh loget nga të gjitha instancat. Nëse mikroshërbimet strehohen në mjete cloud, atëherë për mbikëqyrjen e sistemit përgjigjet ofruesi i cloud. Nëse mikroshërbimet janë në pajisjet e veta, atëherë përveç logeve nga kontenierët duhet të mblidhen edhe loget e sistemit.
Deri më parë nuk kishte mjete të përshtatshme për mbledhjen e logeve si nga sistemi, ashtu edhe nga mikroshërbimet. Zakonisht një mjet mbante loget e sistemit (p.sh. Rsyslog), dhe një tjetër - loget nga Docker (p.sh. journal-bit me konfigurimin e log-driver-it të Docker për journald). U përpoqëm të përdornim journal-bit - për të mbledhur loget edhe nga kontenierët (në log-driver-in e Docker duhet të spesifikosh se duhet të shkruhen loget në journald), dhe nga sistemi (në CentOS 7 tashmë ka systemd dhe journald). Zgjidhja funksionuese, por jo ideale. Nëse ka shumë loge, journal-bit fillon të ngadalësohet, mesazhet humbasin.
Eksperimentet vazhduan - dhe u gjet një mënyrë tjetër. Në CentOS 7 loget kryesore sistemore (messages, audit, secure) përsëriten në var-log si skedarë. Edhe në Docker mund të konfigurohet ruajtja e logeve në skedarë json. Përkatësisht, këta skedarë nga CentOS 7 dhe Docker mund të mblidhen së bashku.
Me kalimin e kohës zgjidhja ELK Stack u bë e njohur. Kjo është një kombinim i disa veglave: Elasticsearch, Logstash dhe Kibana.
Elasticsearch ruan loget nga kontenierët, Logstash mbledh loget nga instancat, Kibana lejon përpunimin e logeve të marra dhe ndihmon në ndërtimin e grafimeve për to. Për një kohë, ELK Stack u përdor aktivisht, por, sipas mendimit tim, koha e tij po kalon. Më vonë do t'ju tregoj pse.
Shto metadatat. Podet, aplikacionet, kontejnerët mund të ekzekutohen kudo. Më shumë se kaq, një aplikacion mund të ketë disa instanca. Loget e regjistruara janë në një format të vetëm, dhe ne duhet të kuptojmë se cila saktësisht është replicimi, cili Pod e shkruan atë, në cilin namespace ndodhet. Kjo është arsyeja pse logeve u nevojiten metadatë.
Parsing loget. është interesant, por shpenzimet për mbështetje të sistemit të regjistrimit dhe monitorimit mund të tejkalojnë kostot e aplikacionit kryesor. Kur qarkullojnë dhjetëra dhe qindra mijëra loge në sekondë, kjo duket e arsyeshme, por prapëseprapë duhet ta dini kufirin. Një nga mënyrat për ta gjetur këtë kufi është parsing logeve.
Si zakonisht, nuk është e nevojshme të mblidhni dhe ruani të gjitha loget, duhet të dërgoni për ruajtje vetëm një pjesë — për shembull, loget me status 'warning' ose 'error'. Nëse flasim për loget nginx ose ingress-controller, atëherë mund të dërgoni për ruajtje vetëm ata që kanë një status të ndryshëm nga 200. Por kjo nuk është një këshillë universale: nëse po ndërtoni ndonjë lloj analize të logeve të Nginx, atëherë është e qartë se duhet t'i mbani ato.
Për të filtruar loget pa menduar nuk rekomandohet, sepse të dhënat e filtruar mund të mos mjaftojnë për një analizë të duhur. Nga ana tjetër, ndoshta analitika duhet të kryhet jo në nivelin e regjistrimit, por në nivelin e mbledhjes së metrikave. Atëherë nuk do të duhet të ruani qindra mijëra rreshta me kod 200. Një nga qasjet është të merrni informacion për trafikun dhe gabimet nga metrikat e ingress-controllerëve.
Në përgjithësi, këtu duhet të mendoni mirë: çfarë dëshironi të ruani dhe për sa kohë, sepse në të kundërt do të ketë një situatë ku sistemi i regjistrimit do t'ju marrë më shumë burime se projekti kryesor.
Për momentin nuk ka një zgjidhje standarde për regjistrimin. Ndryshe nga monitorimi, ku ka një zgjidhje më të përhapur si Prometheus, në regjistrim nuk ka standard.
Në kuadër të kësaj leksione ne do të shqyrtojmë dy instrumente: një të njohur dhe një tjetër në rritje popullariteti. Përveç këtyre ka edhe të tjera, por në këtë artikull ne nuk do t'i trajtojmë.
Duke marrë parasysh të gjitha këto karakteristika të diskutuar më lart, regjistrimi në Kubernetes tani mund të paraqitet me këtë skemë:
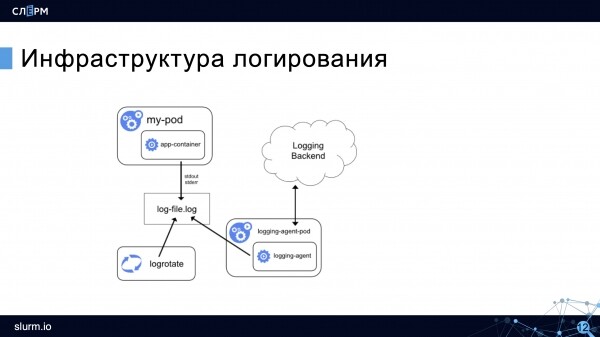
Mbete logu i kontejnerit, rotacioni, por shfaqet një agjent-mbledhës, i cili grumbullon loget dhe i dërgon për ruajtje (në skemë — në Logging Backend). Agjenti punon në çdo nod dhe, si zakonisht, është nisur në Kubernetes.
Tani të shqyrtojmë mjetet për regjistrimin e logeve.
Grafana Loki
ka dalë së fundmi, por tashmë ka fituar popullaritet. Avantazhet e tij: instalohet lehtë, konsumon pak burime, nuk kërkon instalimin e Elasticsearch, pasi mban të dhënat në TSDB (baza e të dhënave me seri kohore). Në artikullin e kaluar kam shkruar se në një bazë të tillë mban të dhënat Prometheus, dhe kjo është një nga shumë ngjashmëritë midis dy produkteve. Zhvilluesit madje deklarojnë se Loki është "Prometheus për botën e logeve".
Një shpjegim i vogël në lidhje me TSDB për ata që nuk lexuan : TSDB përshtatet shumë mirë me detyrën për të ruajtur një sasi të madhe të dhënash me seri kohore, por nuk është e destinuar për ruajtje të gjatë. Nëse për ndonjë arsye keni nevojë të ruani loget më shumë se dy javë, është më mirë të konfiguroni transmetimin e tyre në një tjetër DB.
Një tjetër avantazh i Loki është se për vizualizimin e të dhënave përdoret Grafana. Shumë e përshtatshme: në Grafana shikojmë të dhënat për monitorimin dhe po aty, duke e lidhur Loki, shohim loget. Nga loget mund të ndërtojmë grafikë.
Arkitektura e Loki duket përafërsisht kështu:
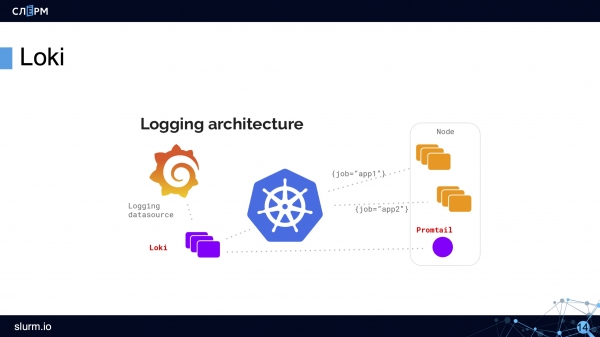
Me ndihmën e DaemonSet, në të gjitha serverat e klasterit shpërndahet agjenti — Promtail ose Fluent Bit. Agjenti mbledh loget. Loki i merr dhe i ruan në TSDB. Logeve i shtohen menjëherë të dhëna shtesë, që është e përshtatshme: mund të filtrohet sipas Pods, namespaces, emrave të kontejnerëve dhe madje edhe etiketave.
Loki punon në një ndërfaqe të njohur Grafana. Loki ka edhe një gjuhë të vet të pyetjeve, e cila quhet LogQL — emri dhe sintaksa e saj i ngjajnë PromQL në Prometheus. Në ndërfaqen e Loki ka sugjerime për pyetjet, prandaj nuk është e nevojshme t'i dini ato përmendsh.
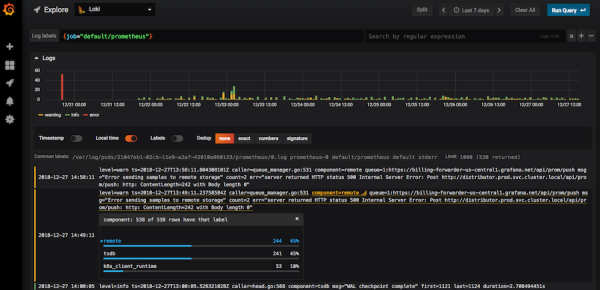
Loki në ndërfaqen Grafana
Duke përdorur filtre, në Loki mund të gjeni kodet ("400", "404" dhe çdo tjetër); shikoni loget nga i gjithë nodi; filtrojini të gjitha loget që kanë fjalën "error". Nëse klikoni mbi logun, do të shfaqet një kartë me të gjitha informacionet për ngjarjen.
Në Loki ka mjaft mjete që lejojnë nxjerrjen e logeve të nevojshme, megjithatë sinqerisht, teknikisht mund të ishin edhe më shumë. Tani Loki është duke u zhvilluar aktivisht dhe po fiton popullaritet.
Elastic + Fluent Bit + Kibana (EFK Stack)
Staku EFK është një mjet më klasik dhe gjithashtu po aq popullor për regjistrimin e logeve.
Në fillim të artikullit u përmend ELK (Elasticsearch + Logstash + Kibana), por ky stak është vjetruar për shkak të Logstash-it të pandjeshëm dhe të përdorur shumë burime. Në vend të tij është përdorur një agent më i lehtë dhe më efikas, Fluentd, dhe pas një kohe i është bashkuar — një agjent mbledhës edhe më i lehtë dhe edhe më efikas.
Nëse i besojmë zhvilluesve, atëherë Fluent Bit është më shumë se 100 herë më i shpejtë se Fluentd: «aty ku Fluentd konsumon 20 MB RAM, Fluent Bit do të konsumojë 150 KB» — një citim direkt nga dokumentacioni. Duke e marrë parasysh këtë, Fluent Bit është përdorur më shpesh.
Fluent Bit ka më pak mundësi se Fluentd, por plotëson nevojat kryesore, prandaj ne kryesisht përdorim Fluent Bit.
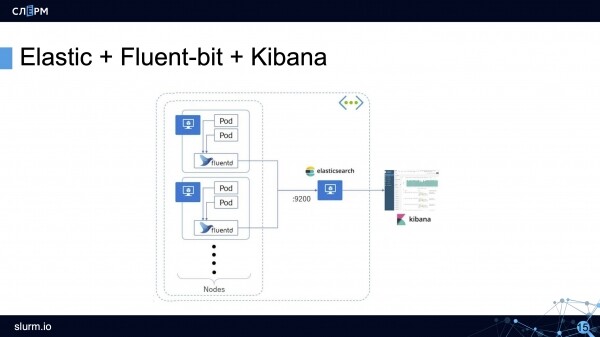
Skema e funksionimit të stakut EFK: agjenti mbledh log-et nga të gjitha pod-et (zakonisht, ky është një DaemonSet i aktivizuar në të gjitha serverët e klustrit) dhe i dërgon në depo (Elasticsearch, PostgreSQL ose Kafka). Kibana lidhet me depotin dhe nxjerr të gjitha informacionet e nevojshme nga aty.
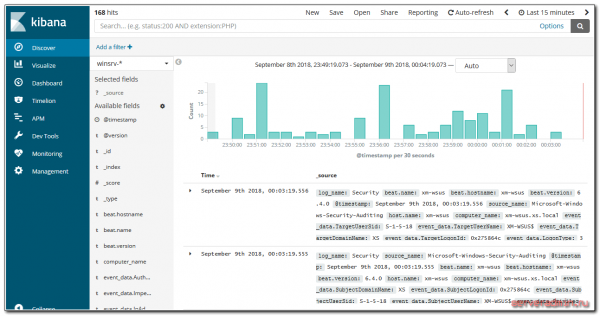
paraqet informacionin në një ndërfaqe të rehatshme në web. Ka grafikë, filtra dhe shumë gjëra të tjera.
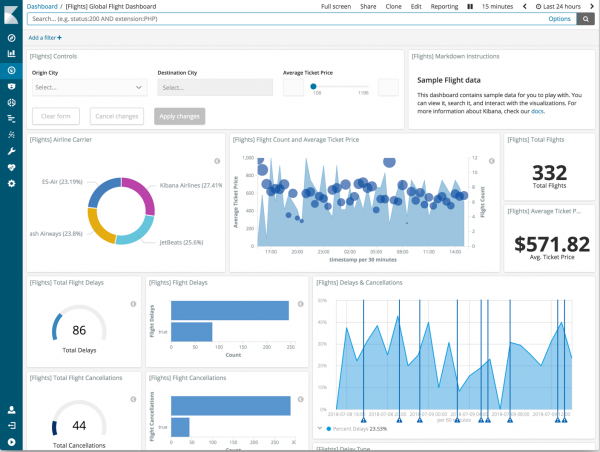
Nga log-et mund të krijohen dashboard-e të plota.
Mundësitë e Fluent Bit
Duke qenë se për Fluent Bit, zakonisht, është dëgjuar më pak se për Logstash, le të e shqyrtojmë atë pak më në detaje. Fluent Bit mund të ndahet logjikisht në 6 module, disa nga të cilat mund të kenë plugin-e që zgjasin mundësitë e Fluent Bit.
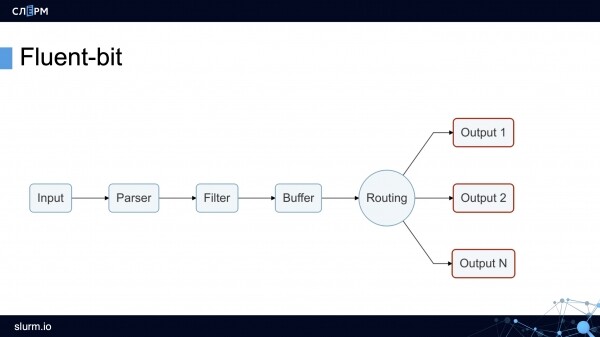
Moduli Input mbledh log-et nga skedarët, shërbimet systemd dhe madje edhe nga tcp-socket (duhet vetëm të tregoni endpoint-in, dhe Fluent Bit do të fillojë të shkojë atje). Këto mundësi janë të mjaftueshme për të mbledhur log-et si nga sistemi ashtu edhe nga konteinerët.
Në prodhim, ne zakonisht përdorim plugin-et (mund ta drejtoni mbi një dosje me log-e) dhe (mund t’i thoni se nga cilat shërbime të mbledh log-et).
Moduli Parser e bën log-un në një formë të njëjtë. Në mënyrë që log-et Nginx, sipas të dhënave të paracaktuara, përbëjnë një varg. Me ndihmën e plugin-it, ky varg mund të konvertohet në JSON: mund të përcaktoni fushat dhe vlerat e tyre. Duke punuar me JSON është shumë më e lehtë se me log-un me varg, sepse ka mundësi më fleksibile për renditjen.
Moduli Filter. Në këtë nivel, filtrohen log-et e panevojshme. Për shembull, për të ruajtur, dërgohen vetëm log-et që kanë vlerën “warning” ose me etiketa të caktuara. Log-et e zgjedhura kalojnë në buffer.
Moduli Buffer. Fluent Bit ka dy tipo buffer: buferri i memories dhe buferri në disk. Bufferi është një ruajtës temporar i logeve, e nevojshme në rast gabimesh ose defekteve. Të gjithë duan të kursejnë në RAM, prandaj zakonisht zgjidhet bufferi në disk. Mirëpo, duhet të merret parasysh se para se të transferohen në disk, loget sërish shkarkohen në memories.
Moduli Routing/Output përmban rregullat dhe adresat për dërgimin e logeve. Siç u tha më parë, loget mund të dërgohen në Elasticsearch, PostgreSQL ose, për shembull, Kafka.
E interesant është se nga Fluent Bit loget mund të dërgohen në Fluentd. Duke qenë se i pari është më i lehtë dhe më pak funksional, përmes tij mund të mblidhen loget dhe të dërgohen në Fluentd, dhe atje, me ndihmën e plugins shtesë, të përpunohen dhe dërgohen në ruajtje.
Nëse planifikoni të përdorni Elasticsearch…
Në fund, dy këshilla për ata që planifikojnë të përdorin Elasticsearch në prodhim si ruajtje logesh.
- Konfiguroni njoftimet me anë të . Ky program nxjerr nga rrjedha e përgjithshme e logeve mesazhe të rëndësishme dhe bën alarme për to në email ose në një kanal tjetër. Megjithatë, jo shumë kohë më parë doli .
- Rrotulloni loget me ndihmën e aplikacionit apo duke iu drejtuar API-t të Elasticsearch. Vetë Elastic, në fakt, tani po bën hapa të rëndësishëm në menaxhimin e jetës së indekseve pa përdorimin e mjeteve të jashtme. Në përgjithësi, nuk ka asnjë kuptim të ruhet loget për një kohë të gjatë: është e vështirë që ndonjë log të nevojitet pas dy javësh - nëse realmente është kritik, brenda dy javësh do të jetë sigurisht përpunuar. Në rastet më të skajshme, loget e vjetra mund të arkivohen dhe dërgohen diku për ruajtje afatgjatë. Kam dëgjuar për loge të veçanta, që sipas ligjit duhet të ruhen deri në 5 vjet. Personalish, nuk kam hasur në këtë, por nuk do ta barazoja këtë informacion me loget e zakonshme, dhe ndoshta do t'i ruaja ato veçmas.
To be continued...
Autor: Marsel Ibraev, administrator i certifikuar Kubernetes, inxhinier praktik në kompaninë , folës dhe zhvillues kursesh .
Burimi: habr.com
