

TL;DR
- Për të arritur një observabilitet të lartë të kontejnerëve dhe mikroshërbimeve, regjistrimeve dhe metrikeve fillestare, nuk mjafton.
- Për rikuperim më të shpejtë dhe rritje të qëndrueshmërisë, aplikacionet duhet të zbatojnë Parimin e Observabilitetit të Lartë (HOP, High Observability Principle).
- Në nivelin e aplikacionit për HOP, nevojiten: regjistrim i duhur, monitorim i kujdesshëm, verifikime të funksionimit dhe ndjekje e performancës / kalimeve.
- Si një element i HOP, përdorni verifikimet readinessProbe dhe livenessProbe Kubernetes.
Çfarë është Shablloni i Verifikimit të Funksionimit?
Kur dizenjoni një aplikacion kritik dhe me disponueshmëri të lartë, është shumë e rëndësishme të mendoni për një aspekt si qëndrueshmëria. Një aplikacion konsiderohet i qëndrueshëm nëse rikuperohet shpejt pas një defekti. Një aplikacion tipik në re përdor arkitekturën e mikroshërbimeve – kur çdo komponent vendoset në një kontejner të veçantë. Dhe për t'u siguruar që aplikacioni në k8s është me disponueshmëri të lartë, kur dizenjoni një grumbull, duhet të ndiqni disa shabllone. Një nga këto është Shablloni i Verifikimit të Funksionimit. Ai përcakton si aplikacioni e informon k8s për funksionimin e tij. Kjo nuk është vetëm informacion nëse pod-i po punon, por gjithashtu se si ai pranon dhe përgjigjet ndaj kërkesave. Sa më shumë që Kubernetes të dijë për funksionimin e pod-it, aq më të mençura do të jenë vendimet e tij për rrugëzimin e trafikut dhe balancimin e ngarkesës. Në këtë mënyrë, Parimi i Observabilitetit të Lartë i mundëson aplikacionit të përgjigjet në kohë ndaj kërkesave.
Parimi i Observabilitetit të Lartë (HOP)
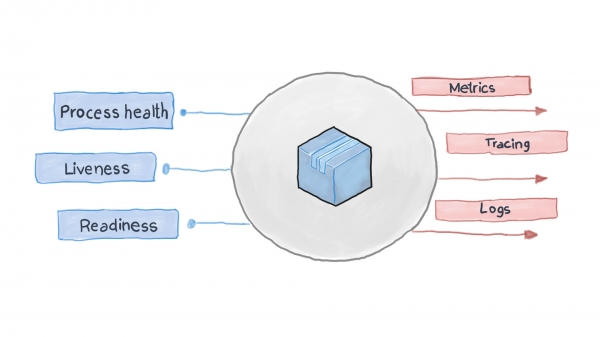
Parimi i Observabilitetit të Lartë është një nga . Në arkitekturën mikrosherbore, shërbimet janë të pakujdesshëm për mënyrën si trajtohet kërkesa e tyre (dhe kjo është në rregull), por është e rëndësishme se si të marrin përgjigjet nga shërbimet e pranimit. Për shembull, për autentikimin e përdoruesit, një kontejner dërgon një kërkesë HTTP tek tjetri, duke pritur një përgjigje në një format të caktuar – dhe kjo është gjithë historia. Kërkesën mund ta trajtojë PythonJS, ndërsa përgjigjen mund ta japë Python Flask. Konteinerët janë për njëri-tjetrin – si kuti të errëta me përmbajtje të fshehur. Megjithatë, principi i NOR kërkon që çdo shërbim të zbulojë disa pika përfundimi API, duke treguar se sa funksional është, si dhe gjendjen e gatishmërisë dhe qëndrueshmërisë së tij. Këto tregues kërkon Kubernetes për të menduar për hapet e ardhshme në rrugëtimin dhe balansimin e ngarkesës.
Një aplikacion cloud i dizajnuar mirë regjistron ngjarjet e tij kryesore duke përdorur rrjedhat standarde të hyrjeve dhe daljeve STDERR dhe STDOUT. Në vijim punon një shërbim ndihmës, për shembull filebeat, logstash ose fluentd, që dërgojnë logjet në një sistem të centralizuar monitorimi (p.sh. Prometheus) dhe një sistem mbledhjeje logjesh (grupi i softuerit ELK). Në diagramin më poshtë tregohet se si funksionon një aplikacion cloud në përputhje me Shablonin e Kontrollit të Funksionalitetit dhe Prinsipin e Vëzhgueshmërisë së Lartë.
Si të aplikoni Shablonin e Kontrollit të Funksionalitetit në Kubernetes?
Nga kutia k8s monitoron gjendjen e pod-eve përmes një nga kontrollorët (, , , dhe të tjera, etj.). Nëse gjen se një pod për një arsye të caktuar ka rënë, kontrollori përpiqet ta rindezë ose ta kalojë në një nyjë tjetër. Megjithatë, pod mund të raportojë se është aktiv dhe i funksionon, por vetë nuk funksionon. Një shembull: aplikacioni juaj përdor Apache si server web, e keni vendosur komponentin në disa pod-e të klasit. Pasi biblioteka është konfiguruar gabim – të gjitha kërkesat për aplikacionin kthejnë kodin 500 (gabim i brendshëm i serverit). Gjatë verifikimit të dërgesës, verifikimi i gjendjes së pod-eve jep një rezultat të suksesshëm, megjithatë klientët mendojnë ndryshe. Këtë situatë të pa dëshiruar do ta përshkruajmë si vijon:
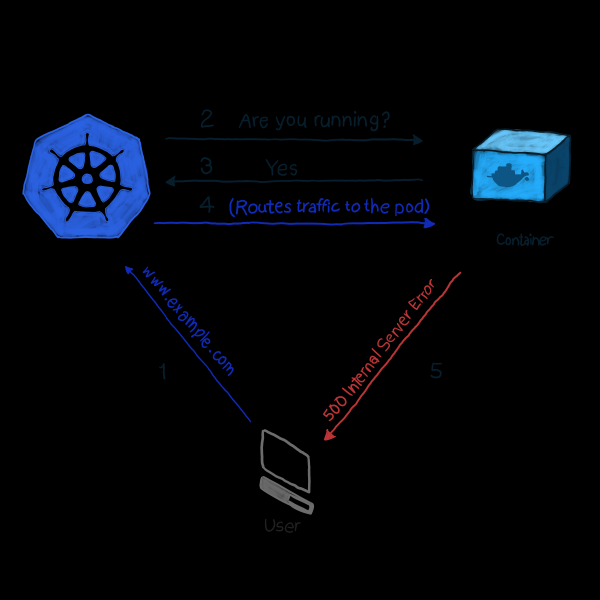
Në shembullin tonë, k8s kryen verifikimin e funksionalitetitMe këtjām kontrolleve, kubelet vazhdimisht kontrollon gjendjen e procesit brenda kontejnerit. Sa më shpejt ta kuptojë që procesi është ndalur, ai do ta riaktivizojë atë. Nëse një gabim largohet me një ripostim të thjeshtë të aplikacionit, dhe programi është projektuar që të ndalet për çdo gabim, atëherë për të përmbushur NËR dhe Shablonët e kontrollit të funksionimit mjafton të kontrolloni funksionimin e procesit. Mbetet për të thënë se jo të gjitha gabimet mund të largohen me një ripostim. Për këtë rast, k8s ofron dy metoda më të thella për të zbulimit të problemeve në funksionimin e pod-ëve: dhe .
LivenessProbe
Gjatë livenessProbe kubelet kryen tre lloje kontrollesh: jo vetëm që e kupton nëse pod-i është duke funksionuar, por gjithashtu nëse është i gatshëm për të marrë dhe për t'u përgjigjur në mënyrë adekuate kërkesave:
- Vendosni një kërkesë HTTP ndaj pod-it. Përgjigja duhet të ketë një kod përgjigje HTTP në intervalin nga 200 deri në 399. Pra, kodet 5xx dhe 4xx sinjalizojnë se pod-i ka probleme, edhe pse procesi po funksionon.
- Për të kontrolluar pod-et me shërbime jo-HTTP (për shembull, serverin e postës Postfix), duhet vendosur një lidhje TCP.
- Ekzekutimi i një komande të rastësishme për pod-in (brenda). Kontrolli konsiderohet i suksesshëm nëse kodi i përfundimit të komandës është 0.
Shembulli se si funksionon. Përcaktimi i mëposhtëm të pod-it përmban një aplikacion NodeJS, i cili jep një gabim 500 në përgjigje të kërkesave HTTP. Për të siguruar që kontejneri riaktivizohet pas një gabimi të tillë, përdorim parametrin livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Kjo nuk ndryshon nga çdo përcaktim tjetër pod-i, por ne shtojmë objektin .spec.containers.livenessProbe. Parametri httpGet pranon një rrugë nga e cila dërgon një kërkesë HTTP GET (në shembullin tonë kjo është /, por në scenario reale mund të jetë diçka si /api/v1/status). Përveç kësaj, livenessProbe pranon parametrin initialDelaySeconds, i cili urdhëron operacionet e kontrollit të presin një numër të caktuar sekondash. Kjo vonesë është e nevojshme, sepse kontejnerit i duhet kohë për t'u ndezur, dhe gjatë ripostimit ai do të jetë i paarritshëm për një kohë.
Për të aplikuar këtë konfigurim në kluster, përdorni:
kubectl apply -f pod.yamlPasi të kalojnë disa sekonda, mund të kontrolloni përmbajtjen e pod-it me komandën e mëposhtme:
kubectl describe pods node500Në fund të output-it, kërkoni .
Si e shihni, livenessProbe aktivizoi një kërkesë HTTP GET, duke dhënë një gabim 500 nga konteineri (siç ishte programuar), kubelet e rinisi atë.
Nëse jeni kurioz se si ishte programuar aplikacioni NideJS, ja skedari app.js dhe Dockerfile që u përdorën:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Ne kemi hasur një gabim\n");
});

server.listen(3000, function() {
    console.log('Serveri po punon në 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node", "\/app.js" ]
Është e rëndësishme të vëmë re se: livenessProbe do të rinisi konteinerin vetëm në rast dështimi. Nëse rinisja nuk e zgjidh gabimin që pengon funksionimin e konteinerit, kubelet nuk do të ketë mundësi të ndërmarrë masa për të riparuar dështimin.
readinessProbe
readinessProbe funksionon në mënyrë të ngjashme me livenessProbes (kërkesa GET, lidhje TCP dhe ekzekutimin e komandave), përveç veprimeve për zgjidhjen e problemeve. Konteineri që është regjistruar me dështim nuk riniset, por izolohet nga trafiku hyrës. Imagjinoni, një nga konteinerët po kryen shumë llogaritje ose po përjeton një ngarkesë të madhe, duke rritur kështu kohën e përgjigjes për kërkesat. Në rastin e livenessProbe, kontrollohet disponueshmëria e përgjigjes (përmes parametrave të kontrollit timeoutSeconds), pas së cilës kubelet e rinisi konteinerin. Në fillim, konteineri fillon të kryejë detyra me kërkesë të madhe, dhe ai riniset sërish. Kjo mund të jetë kritike për aplikacionet që kërkojnë shpejtësi përgjigje. Për shembull, një makinë në rrugë pret një përgjigje nga serveri, përgjigja vonohet – dhe makina ka një aksident.
Le të shkruajmë një përcaktim të redinessProbe, i cili do të vendosë kohën e përgjigjes për kërkesën GET të mos jetë më shumë se dy sekonda, ndërsa aplikacioni do të përgjigjet në kërkesën GET pas 5 sekondash. Skedari pod.yaml duhet të duket si më poshtë:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany\/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: \/
         port: 3000
       timeoutSeconds: 2
Do të zhvillojmë pod me kubectl:
kubectl apply -f pod.yamlDo të presim disa sekonda, pastaj do të shohim se si ka funksionuar readinessProbe:
kubectl describe pods nodedelayedNë fund të daljes, mund të shihni se një pjesë e ngjarjeve është e ngjashme me .
Si e shihni, kubectl nuk e rinisi pod-in kur koha e kontrollit tejkaloi 2 sekonda. Në vend të kësaj, anuloi kërkesën. Lidhjet hyrëse redirectionohen në pod-et e tjera funksionuese.
Vini rethoni: tani që ngarkesa e tepërt është hequr nga pod'i, kubectl përsëri dërgon kërkesa atij: përgjigjet ndaj kërkesave GET nuk vonohen më.
Për krahasim: më poshtë është një version i ndryshuar të skedarit app.js:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Server is running at 3000')
})
TL;DR
Para se të shfaqeshin aplikacionet cloud, mediumi kryesor për monitorimin dhe verifikimin e gjendjes së aplikacioneve ishin logët. Megjithatë, nuk kishte mjete për të ndërmarrë masa për të zgjidhur problemet. Logët janë akoma të dobishëm, duhet të mblidhen dhe dërgohen në sistemin e mbledhjes së logëve për analizë të situatave emergjente dhe marrjen e vendimeve. [këto gjëra mund të ishin bërë edhe pa aplikacione cloud duke përdorur monit, për shembull, por me k8s është bërë shumë më e lehtë 🙂 – shënim red. ]
Sot, korrigjimet shpesh duhet të bëhen thuajse në kohë reale, kështu që aplikacionet nuk duhet më të jenë kutia të zeza. Jo, ato duhet të tregojnë fundet, duke lejuar sistemet e monitorimit të kërkojnë dhe mbledhin të dhëna të vlefshme mbi gjendjen e proceseve, në mënyrë që në rast nevoje të reagojnë menjëherë. Kjo quhet Modeli i projektimit të kontrollit të gjendjes, i cili ndjek Parimin e Observabilitetit të Lartë (HOP).
Kubernetes ofron në mënyrë default 2 lloje kontrollesh të gjendjes: readinessProbe dhe livenessProbe. Të dy përdorin lloje të njëjta kontrollesh (HTTP GET kërkesa, TCP lidhje dhe ekzekutime komandash). Ato dallohen në vendimet që marrin në përgjigje të problemeve në pod'e. livenessProbe ri-starton konteinerin me shpresën se problemi nuk do të përsëritet, ndërsa readinessProbe izolon pod'in nga trafiku hyrës – deri sa të zgjidhet shkaku i problemit.
Dizajni i duhur i aplikacionit duhet të përfshijë të dyja llojet e kontrolleve dhe të sigurojë mbledhjen e mjaftueshme të të dhënave, veçanërisht kur krijohet një situatë emergjente. Ai gjithashtu duhet të tregojë fundet e nevojshme të API-së, duke transmetuar sistemit të monitorimit (të njëjtit Prometheus) metrika të rëndësishme të gjendjes së funksionimit.
Burimi: habr.com
