

Përshëndetje, Habr! Ftojmë Data Engineerë dhe specialistë të Machine Learning për një Demo-tregim falas . Dhe ne gjithashtu publikojmë një artikull nga Luca Monno — Shefi i Analitikës Financiare në CDP SpA.
Një nga metodat më të dobishme dhe më të thjeshta të mësimit të makinerive është Ensemble Learning. Ensemble Learning është një metodë në themel të XGBoost, Bagging, Pyllit të Rastësishëm dhe shumë algoritmave të tjerë.
Në Towards Data Science ka shumë artikuj interesantë, por unë zgjodha dy histori ( dhe ), që më pëlqyen më shumë. Pra, përse të shkruaj një tjetër artikull rreth EL? Sepse dua t'ju tregoj se si funksionon me një shembull të thjeshtë, i cili më bëri të kuptoj se këtu nuk ka asnjë magji.
Kur e pashë për herë të parë EL në veprim (në punën me disa modele regresionuese shumë të thjeshta) nuk mund të besoja sytë e mi, dhe ende e mbaj mend profesorin që më mësoi këtë metodë.
Kisha dy modele të ndryshme (dy algoritma të dobët të mësimit) me tregues out-of-sample R² të barabarta me 0,90 dhe 0,93 përkatësisht. Para se të shihja rezultatin, mendova se do të merrja një R² diku midis dy vlerave fillestare. Në fjalë të tjera, mendoja se EL mund të përdorej për të bërë që modeli të punonte jo aq mirë sa më i keqi, por as aq mirë sa do të mund të punonte modeli më i mirë.
Për habinë time të madhe, rezultatet e thjeshta të mesatares së parashikimeve dhanë një R² prej 0,95.
Fillimisht nisa të kërkoja gabimin, por pastaj mendova se këtu mund të fshihej ndonjë magji!
Çfarë është Ensemble Learning
Me EL mund të bashkohen parashikimet e dy ose më shumë modeleve për të marrë një model më të besueshëm dhe më produktiv. Ekzistojnë shumë metodologji për të punuar me ansamble modelesh. Këtu do të përmend dy më të dobishmet, për t'ju dhënë një përmbledhje.
Me ndihmën e regresioni mund të mesatarizojnë treguesit e modeleve ekzistuese.
Me ndihmën e klasifikimi mund t'u japë modeleve mundësinë për të zgjedhur etiketat. Etiketa që u zgjodh më shpesh – ajo do të zgjidhet nga modeli i ri.
Pse EL punon më mirë
Arsyeja kryesore pse EL funksionon më mirë është se çdo parashikim ka një gabim (e dimë këtë nga teoria e probabilitetit); bashkimi i dy parashikimeve mund të ndihmojë për të zvogëluar gabimin dhe, për pasojë, përmirësuar rezultatin e performancës (RMSE, R², etj.).
Në diagramin e mëposhtëm, shihet si dy algoritme të dobët funksionojnë me një set të dhënash. Algoritmi i parë ka një koeficient këndor më të madh se sa është e nevojshme, ndërsa i dyti është pothuajse zero (ndoshta për shkak të mbisikurimit). Por ensemble tregon rezultate shumë më të mira.
Nëse shikojmë indikatorin R², atëherë për algoritmët e parë dhe të dytë të të mësuarit, ai do të jetë -0.01¹ dhe 0.22, përkatësisht, ndërsa për ansamblin do të jetë 0.73.
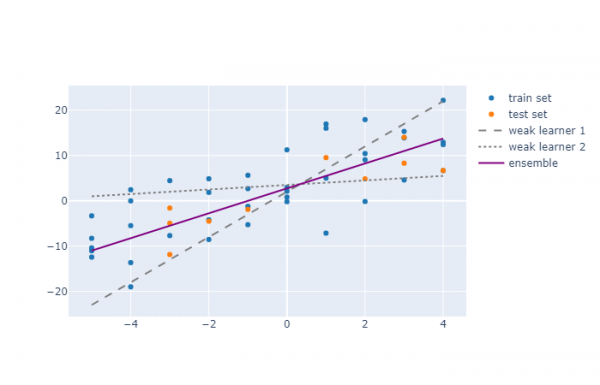
Ka shumë arsye pse një algoritëm mund të rezultojë një model i dobët, edhe në një shembull kaq të thjeshtë si ky: ndoshta keni vendosur të përdorni mbisikurim për të shmangur mbërritjen e modelit, ose keni vendosur të mos përjashtoni disa anomalitë, ose ndoshta keni përdorur regresion polinomial dhe keni zgjedhur gradën e gabuar (p.sh., përdorët polinom të gradës së dytë, ndërsa në të dhënat testuese ka një asimetrikë të dukshme, për të cilën do t'i përshtatej më mirë gradës së tretë).
Kur EL funksionon më mirë
Le të shqyrtojmë dy algoritme të të mësuarit që funksionojnë me të dhëna të njëjta.
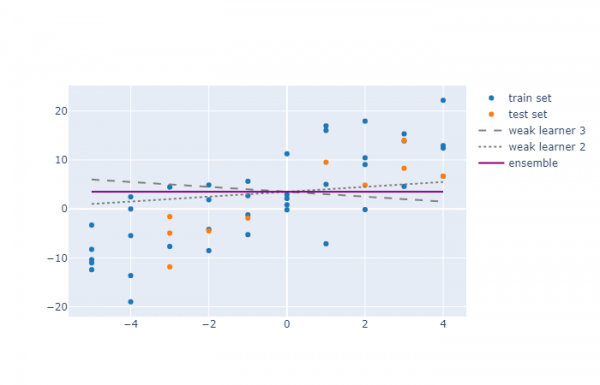
Këtu shihet se bashkimi i dy modeleve nuk e përmirësoi shumë performancën. Fillimisht për dy algoritmët e të mësuarit, indikatorët R² ishin -0.37 dhe 0.22, përkatësisht, ndërsa për ansamblin doli -0.04. Kjo do të thotë se modeli EL mori një mesatare të treguesve.
Megjithatë, ka një ndryshim të madh midis këtyre dy shembujve: në shembullin e parë, gabimet e modeleve ishin negativisht të korrelacionuara, ndërsa në të dytin ishin pozitivisht (koeficientët e tre modeleve nuk u vlerësuan dhe thjesht u ndoqën si shembuj nga autori).
Prandaj, Mësimi me Ansambël mund të përdoret për të përmirësuar balancimin e devijimeve/dispersive në çdo rast, por kur gabimet e modeleve nuk janë pozitivisht të korrelacionuara, përdorimi i EL mund të çojë në përmirësimin e performancës.
Modelet homogjene dhe heterogjene
Shumë shpesh EL përdoret në modele homogjene (siç është këtu ose në pyjet rastësore), por në të vërtetë ju mund të kombinoni modele të ndryshme (regresioni linear + rrjeti neural + XGBoost) me grupe të ndryshme variablash shpjegues. Pothuajse përfundimisht kjo do të sjellë gabime të pa korrelacionuara dhe një rritje të performancës.
Krahasimi me diversifikimin e portofolit
EL funksionon në mënyrë analogjike me diversifikimin në teorinë e portofolit, por sa më shumë informacion, aq më mirë për ne.
Me diversifikimin, ju përpiqeni të zvogëloni dispersinë e treguesve tuaj duke investuar në aksione të pa korrelacionuara. Një portofol aksionesh i mirë diversifikuar do të japë një tregues më të mirë se aksioni më i keq, por kurrë nuk do të jetë më i mirë se ai më i miri.
Duke cituar Warren Buffett:
“Diversifikimi është mbrojtje nga injoranca, për atë që nuk di çfarë po bën, ajo [diversifikimi] ka shumë pak kuptim.”
Në mësimin e makinave, EL ndihmon për të reduktuar dispersinë e modelit tuaj, por kjo mund të çojë në krijimin e një modeli me performancë të përgjithshme më të mirë se modeli më i mirë origjinal.
Le të përmbledhim
Kombinimi i disa modeleve në një është një metodë relativisht e thjeshtë që mund të çojë në zgjidhjen e problemit të qëndrueshmërisë dhe një rritje të performancës.
Nëse keni dy ose më shumë modele që funksionojnë mirë, mos zgjidhni midis tyre: përdoreni të gjitha (por me kujdes)!
A është interesante të zhvilloheni në këtë drejtim? Regjistrohuni për një mësim Provë falas dhe merrni pjesë në — Inxhinier i Mësimit të Makinave në Mail.ru Group.
Burimi: habr.com
